
一文讲清AI工具: 从大模型到智能体,你只需要搞懂一辆车
先给结论(赶时间看这五条)
- AI 工具不是「一堆 App」,是四层楼:模型层、智能体层、客户端层、应用层。90% 的困惑来自把不同楼层放在一起比较。
- 2026 年最被低估的词是 Harness(运行时)。同样的模型,换一套 Harness,完成同一任务的成本能差 475 倍。
- MCP 是插座,Skill 是手册,插件是礼盒——它们不是竞品,是同一套扩展体系的三层。
- 不存在「最强模型」,只存在「最强分工」:文本看 Claude、图片看 GPT Image、视频看 Seedance、克隆看 MiniMax。
- 选工具的正确问法不是「哪个更强」,而是「我要成品,还是要资产」。
一、先看一张图:AI 工具是四层楼,不是一堆 App
大多数人接触 AI 的顺序是:先用豆包,再听说 ChatGPT,然后被「MCP」「Skills」「Agent」这些词砸晕,最后得出结论——「太复杂了,我学不会」。
但如果你换个视角,把这些名字按「离用户多远」排一下,会发现它们其实非常规整:越靠上越像产品,越靠下越像能力。
| 第一层 · 应用层(App) 打开就能用的成品,面向普通用户 豆包 · 千问 · ChatGPT · 即梦 · 可灵 · 剪映 |
| 第二层 · 客户端层(Client) 一个「壳」:填入 API Key,自己换模型 Cherry Studio · Chatbox · LobeChat |
| 第三层 · 智能体层(Agent = 模型 + Harness) 会自己规划、调用工具、把活干完的运行时 Claude Code · Codex · Cursor · Manus · OpenClaw · WorkBuddy |
| 第四层 · 模型层(Model) 发动机:文本 / 图片 / 音频 / 视频 / 多模态 Claude · GPT-6 · Gemini · DeepSeek · Qwen · Seedream · Seedance |
图 1:AI 工具四层结构。往上走是产品,往下走是能力
右侧还挂着三个东西——MCP、Skill、插件。它们不属于任何一层,而是「扩展生态」,像给这套楼装的水电和家具。第五节专门讲。
为什么用「汽车」来类比最准
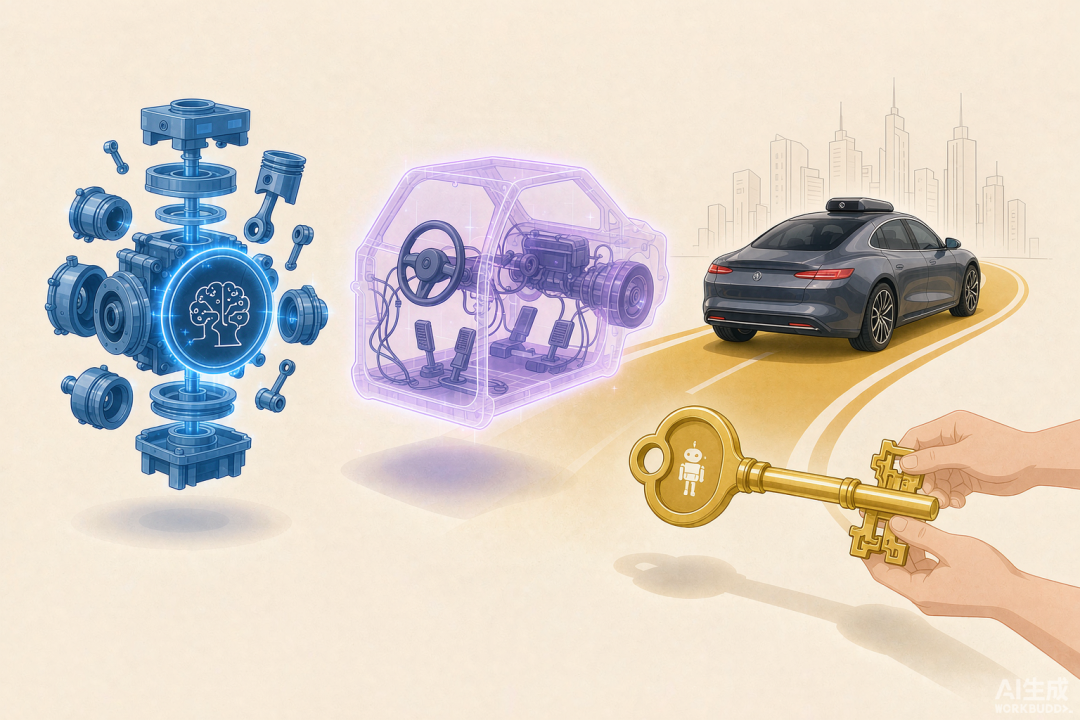
因为汽车这个比喻,能把「换零件」这件事讲得特别自然:
| 汽车 | AI 世界 | 关键差别 |
|---|---|---|
| 发动机 | 大模型 | 决定动力上限,但自己不会带你去上班 |
| 底盘 + 变速箱 + 刹车 | Harness(运行时) | 决定这台车能不能跑长途、会不会失控 |
| 整车(能自己开) | 智能体 Agent | 从「能回答」变成「能干活」 |
| 驾驶舱 / 方向盘 | 客户端 | 你面对的那块屏,换发动机不用换屏 |
| 网约车服务 | 应用 App | 你只说目的地,不关心它用什么发动机 |
记住这张对照表,后面所有名词都能挂上去。这篇文想把一件事说透:你感觉两个 AI 工具「一个聪明一个笨」,很多时候不是发动机的差距,而是底盘的差距。
二、第四层:模型层,五条生产线
「大模型」是一个被用滥的词。准确说,它是五个不同车间的统称——每个车间造的东西完全不一样,榜单不通用,价格不通用,连「好坏」的标准都不通用。
2.1 文本:最成熟、最卷、开源追得最近
文本模型是那个「什么都能聊两句」的通用发动机。截至 2026 年 11 月初,可用阵营大致是:
| 阵营 | 代表 | 核心数据 |
|---|---|---|
| 闭源第一梯队 | laude Opus 5.5、GPT-6 Astra、Gemini 4 系列 | AA 智能指数 58.4 / 56.9(2026-10-27) |
| 闭源性价比 | Claude Sonnet 5.5、GPT-6.1 Sol | 54.2 / 54.5,日常够用 |
| 开源第一梯队 | Kimi K3、DeepSeek V4.1、GLM-5.3、Qwen3.8 | Kimi K3 综合指数 62.1,开源最高(2026-11-02) |
| 国内用户入口 | 豆包、千问、DeepSeek、元宝、Kimi | 月活 3.82 亿 / 1.67 亿 / 1.30 亿(2026-06) |
数据来源:Artificial Analysis 智能指数 v5、BenchLeader 指数、QuestMobile 2026 上半年报告
这里有个反直觉的事实:文本是开源和闭源差距最小的模态,大约 5~7 分(百分制)。翻译成人话就是——日常写作、总结、答疑,你用 Kimi 和用 Claude,感知差异远小于价格差异。
2.2 图片:从「画得像」卷到「听得懂」
两年前大家比的是画质,现在比的是三件事:听不听得懂复杂指令、能不能改图、字写得对不对。
| 模型 | 强项 | Elo / 名次 |
|---|---|---|
| GPT Image 2.5(Sunburst / Flare) | 全能生产、精准改图、海报排版 | 1223 / 1207,包揽前二 |
| Nano Banana 2.1(谷歌) | 真人实拍质感,性价比之王 | 1176,第四 |
| Seedream 5.0 Pro(字节) | 信息图、密集文字、中文场景 | 国产第一(中文榜 1291.8) |
| Qwen-Image 3.0 Pro(阿里) | 小字、多语言排版 | 中文榜第四(1233.8) |
| FLUX.2 [klein](开源) | 可商用、可自部署 | 开源阵营首选 |
数据来源:haiai123 图像 Elo 榜(2026-11-04)、SuperCLUE 中文文生图竞技场(2026-11-02,65,670 场盲测)
给普通人的判断:做小红书封面、商品图、信息长图,先试 Seedream(即梦里就是它);要做带中文小字的海报,GPT Image 2.5 和 Qwen-Image 更稳;要批量、要便宜、要能自己部署,看 FLUX.2 的开源版本。
2.3 音频:这里其实是三个不同的行业
「AI 配音」这四个字,把三件完全不同的事混在了一起,这是最容易踩坑的地方:
| 细分 | 干什么 | 头部 |
|---|---|---|
| TTS 配音 | 把文字念出来,要自然、要有情绪 | Inworld、Gemini TTS、ElevenLabs |
| 声音克隆 | 复制某个人的音色,跨语言、跨情绪 | MiniMax Speech 2.8(国产最强) |
| 实时语音对话 | 能听、能想、能打断、能调工具 | GPT-Realtime-2、Gemini Live |
盲测数据(Artificial Analysis 语音竞技场,2026 年 5 月口径):Inworld Realtime TTS 1.5 Max 以1210居首,Gemini 3.1 Flash TTS1206,Eleven v31178,MiniMax Speech 2.8 HD1164。
开源阵营有个特别适合写进文章的彩蛋:Kokoro-82M,只有 8200 万参数,盲测能打赢亚马逊 Polly,推理速度约 96 倍实时——成本约为 ElevenLabs 的 1/294。它证明了这一层的竞争已经不是「谁更聪明」,而是「谁更便宜、更快、更够用」。
2.4 视频:最贵、迭代最快、最容易看错榜
视频是当前最烧钱也最热闹的车间。中文盲测榜(SuperCLUE,2026-11-02,64,231 场对战)的排位是:
| 名次 | 模型 | 分数 | 特点 |
|---|---|---|---|
| 1 | Seedance 2.5(字节,720p) | 1265.7 | 综合最强,多镜头、参考素材控制 |
| 2 | Seedance 2.0 | 1256.0 | 稳定、生态成熟 |
| 3 | MiniMax H3(768p) | 1209.6 | 唯一「部分开源」的头部选手 |
| 4 | 可灵 3.0(快手) | 1190.4 | 人物动作与运动控制 |
| 5 | Veo 3.1(谷歌) | 1177.4 | 电影感、原生对白与音效 |
数据来源:SuperCLUE 文生视频竞技场(2026-11-02,中文用户盲测)
但请一定告诉读者这句话:视频没有全胜选手。可灵已经迭代到 4.0,海螺 2.3 在物理模拟榜单(WorldModelBench)排第一,Veo 在「声音+镜头语言」上仍然最能打。同一天的榜单,换个分榜(文生视频 / 图生视频 / 视频编辑 / 含音频 / 不含音频),名次可能完全反过来。
2.5 多模态:从「五个车间」合并成「一个全能车间」
多模态有两层含义,别混:
第一层是「看得懂」——GPT-6、Gemini 4、Qwen3-VL 这类模型,能同时读文字、看图、听音频、啃长文档。这是理解侧的多模态,也是这两年最实用的进步(拍张合同照片让它挑条款,就是典型用法)。
第二层是「出得来」——2026 年的新趋势叫Omni 模型:一个模型同时生成画面和声音。MiniMax H3 是一个模型直出视频+音频,Seedance 2.0 把音视频统一在一个模型里,LTX-2.5 用双流架构同时产视频流和音频流。
这意味着采购逻辑要变了:过去是「视频模型 + 配音模型 + 音效库」三份钱,未来可能是「一个全模态引擎」一份钱。别再按模态买工具,要按工作流买。
三、第三层:Harness——2026 年最被低估的一个词
现在进入全文最硬核、也最值钱的一段。
你一定有过这种体验:同样的模型,在 A 工具里像天才,在 B 工具里像智障。多数人的解释是「A 的模型更强」。但 2026 年行业已经给出了更准确的答案:差的是 Harness。
它到底是个什么东西
Harness 直译是「马具、安全带」,行业里叫「运行时」或「脚手架」。它的定义可以一句话说完:
Agent = Model + Harness模型负责「想」,Harness 负责「想完之后怎么落地」一个完整的 Harness 要干六件事,缺一件就不是生产级工具:
| 职责 | 通俗解释 |
|---|---|
| 跑循环 | 计划 → 执行 → 看结果 → 再计划,直到任务完成 |
| 管上下文 | 决定每一步给模型看什么、忘掉什么,别让它被信息淹死 |
| 给工具 | 能读文件、跑命令、查网页、调接口 |
| 管权限 | 哪些能读、哪些能写、哪些必须人类点头 |
| 开沙箱 | 让它跑代码,但炸不到你的真实系统 |
| 会收尾 | 失败重试、判断「这活到底算不算干完了」 |
这六件事听着平淡,但它们是工程量的全部。今年 Claude Code 源码意外曝光,代码量超过50 万行——其中没有一行是模型,全是「围绕模型的系统」。这就是 Harness 的真实体量。
为什么这个词值得你记住
因为它是「同一个模型,效果差 10 倍」的唯一合理解释。
有团队做过同任务对比测试:同一个模型,配不同的 Harness(上下文策略、工具集、权限、循环上限不同),完成同一件事的成本差异达到约 475 倍。差在哪?差在它会不会把无关文件全塞进上下文、会不会无限重试、会不会在第 30 步把自己绕晕。
所以下次你听到「我们的 Agent 比别人的强」,第一个该问的问题不是「你用的什么模型」,而是——「你的 Harness 怎么做的?」
顺便说一句:LangGraph、CrewAI 这类叫「框架」,不叫 Harness。框架是零件包,你得自己组装;Harness 是组装好、能上路的整机。
四、第三层续:智能体(Agent)的四个赛道
装好 Harness 的整车,就是智能体。但「智能体」这个词太笼统,实际已经分成四个完全不同的赛道,选错赛道比选错模型更浪费钱。
| 赛道 | 形态 | 代表 |
|---|---|---|
| 编码 Agent(终端) | 活在终端里,直接改代码库 | Claude Code、Codex CLI、Gemini CLI、Aider |
| 编码 Agent(IDE) | 活在编辑器里,边写边补 | Cursor、Windsurf、GitHub Copilot |
| 通用自主 Agent | 丢一个任务,自己上网、查资料、交付 | Manus、Devin、ChatGPT Agent |
| AI 工作台 | 既是壳又是干活系统,能装扩展 | WorkBuddy、Cherry Studio(轻量版) |
Codex 与 Claude Code:一场「两把尺子打架」的对比
这是文章里最值得放的一组数据,因为它能教会读者怎么正确看榜单:
| 指标 | Codex CLI | Claude Code |
|---|---|---|
| npm 下载量(2026-09-07~10-06) | 8890 万 | 5290 万 |
| GitHub Stars(2026-10-28) | 13.1 万 | 15.4 万 |
| 商业体量 | GPT 系模型的主力入口 | 年化收入约 25 亿美元 |
| 口碑特征 | 快、爱主动写测试 | 多文件重构更深、更好用 |
下载量 Codex 赢,Star 数 Claude Code 赢。两个数字都真实,结论相反——因为一个衡量「装机量」,一个衡量「工程师的情感认同」。任何只给你一个数字的榜单,都值得怀疑。
更有意思的是 OpenAI 与杜克大学等机构联合发布的 Codex 使用研究(2026 年 6 月):半年内周活用户涨了 5 倍;OpenAI 自己员工 99.8% 的输出 token 已经走 Codex,而不是 ChatGPT;企业账号渗透率 17.3%,个人用户仍不足 1%。
翻译成一句人话:最会用 AI 的那批人,已经不在聊天框里打字了,他们在派活。
WorkBuddy 这类「工作台」为什么是中国特色物种
按上面的四层结构,WorkBuddy 有点特殊:它同时长在两层上。
它有客户端的属性——一个壳,可以接不同厂商的模型,你想用哪家就用哪家,不用为了换个模型重学一套界面。
它也有智能体的属性——自带 Harness:任务循环、工具调用、权限确认、沙箱、记忆,能真正把一件多步骤的活干完,而不是陪你聊天。
再加上 Skill / MCP / 插件 / 定时自动化这一整套扩展,它更像一个「改装车工厂」:发动机你自己选,底盘自带,尾翼(插件)随时加。而豆包是「整车出租」——上车就走,但你不知道也不关心发动机是谁家的。
两种模式没有高下,只有场景:要省事,租车;要沉淀自己的流程和数据,改装。
五、扩展生态:MCP、Skill、插件,三件套不是竞品
这三个词是劝退率最高的地方。但只要一个类比对,三十秒就能讲明白。
| 概念 | 类比 | 解决的问题 |
|---|---|---|
| MCP | USB-C 插座 | 让 AI 连上外部工具和数据(连得上) |
| Skill | 老司机的 SOP 手册 | 教会 AI「我们这儿这事怎么办」(做得好) |
| 插件 | 打包礼盒 | 把上面两样打成一个包,装一次到处用(发得出去) |
MCP:统一插头的胜利
在 MCP 之前,每个 AI 工具要对接每个外部系统,都得单独写一次适配——N 个工具 × M 个系统 = N×M 份工作。MCP(Model Context Protocol)把这层标准化了:做一次接口,所有支持 MCP 的 AI 都能插上用。ChatGPT、Claude、Cursor、Codex 都已经支持,当前规范版本是 2026-07-28。
关键区分:MCP 解决「连得上」,不解决「做得好」。这是普通人最常搞错的一点。
Skill:把方法论写成文件
Skill 的本质极其朴素:一个文件夹 + 一个 SKILL.md。里面写清楚步骤、规范、参考资料、甚至可执行脚本。
它有个很聪明的设计叫「渐进披露」:AI 启动时只记住每个 Skill 的名字和一句话描述(约 100 个 token),真正用到时才展开全文。所以装 50 个 Skill 也不会把上下文撑爆,这是它比「把所有提示词塞进系统提示」高明的地方。
举个最实用的例子:你公司报销单的填法、周报的格式、合同的审查清单——这些「知识」不需要接任何系统,只需要被写下来。写成一个 Skill,以后 AI 每次都按你们公司的规矩办事。
一个反常识的判断(来自 Red Hat 开发者的分析):很多团队该写 Skill,却去建了 MCP server。模型本来就有能力,缺的只是说明书。
插件:2026 年 8 月才诞生的「分发标准」
Agent Plugins 开放标准 2026 年 8 月 6 日发布,解决的问题是「装一次,到处能用」:一个带 manifest 的包,里面可以同时装 Skill、MCP 配置、hooks、子智能体配置,在 ChatGPT、Cursor、Copilot、Codex 里通用。
生态长得有多快?截至 2026 年 11 月 1 日,登记在册的插件5,650 个,Skill20,067 个。
必须提醒的安全问题
安全公司 Snyk 审计了 3,984 个公开 Skill,36.82% 至少存在一个安全缺陷,13.4% 有严重问题,确认含恶意载荷的有 76 个。原因很简单:Skill 继承 AI 的全部权限——AI 能读你的 AWS 密钥,那么它正在执行的那份「说明书」也能读。
所以:装 Skill 的信任级别,等于装一个软件依赖包。别看见就装。
一句话决策口诀
| 你缺什么 | 该做什么 |
|---|---|
| 缺「方法」——AI 会做,但每次做得不一样 | 写一个 Skill(一个 Markdown 文件就能开始) |
| 缺「连接」——数据在数据库、SaaS 或需要登录 | 上 MCP server(或者先看看命令行工具够不够) |
| 缺「分发」——五个人要装同一套配置 | 打成 插件,一个包装完 |
六、对号入座:四类人,四套清单
概念讲完了,最后落到「我该用哪个」。按人群分,比按功能分有用得多。
| 人群 | 真实痛点 | 推荐路径 |
|---|---|---|
| 普通用户 | 不知道用哪个 App,怕花钱 | 先用豆包 / 千问 / DeepSeek 把「问答」跑通;出图用即梦,做视频用可灵。别碰 API,别装插件。 |
| 职场人 | 想让 AI 帮写材料、做表、查资料 | Kimi / 豆包做长文档;要「派活」用 Manus;想统一管多家模型、还想写自己的 SOP,用 Cherry Studio 或 WorkBuddy。 |
| 创作者 | 出图出片要快、要能改 | 封面图 Seedream(即梦);精细海报 GPT Image 2.5;视频 Seedance / 可灵 / 海螺;配音 MiniMax Speech 或 ElevenLabs。 |
| 开发者 / 极客 | 想把流程自动化、自建能力 | Claude Code 或 Codex CLI 选一个(建议同题双跑一次再定);自部署看 Wan 2.2、FLUX.2 [klein];扩展先写一个 Skill 起步,再上 MCP。 |
如果你只记一句话:先确认自己在第几层需要什么,再选工具。不知道自己缺「连接」还是缺「方法」,就会陷入无限换工具的循环。
七、三个押注:接下来的 12 个月
判断一:模型会「合并同类项」。Omni 模型把视频、音频、图像合到一个引擎里,意味着未来按模态区分工具的习惯会消失,取而代之的是「按工作流」选服务。你买的不是模型,是一条产线。
判断二:Harness 才是护城河。模型是租来的,谁都能调;Harness 是自己长出来的,包含你的流程、权限、数据和踩过的坑。这也解释了为什么 Claude Code 值 25 亿美元——它卖的不是模型,是「把模型变成产能」的那套系统。
判断三:工具会过时,资产不会。Sora 2 从刷屏到停服不到一年。但你在这一年里沉淀的提示词模板、Skill 文件、自动化流程,换个工具还能带走。所以别做「工具收藏家」,做「流程拥有者」。