
HuggingFace博客 3小时前 · 2026-11-06 19:45:51 · 9 阅读
埃及与尼日利亚口音英语数据集加入 Open ASR Leaderboard
几个月前,我们为 Open ASR Leaderboard加入了私有数据:来自 Appen 和 DataOceanAI 的 11 个数据集切分,涵盖五种口音的朗读与对话语音(博客)。社区反响热烈,许多人强调了留出集对可信评估的重要性。此后,我们又通过与 Voice Arena 合作,新增了一个印度口音英语的私有切分(博客)。
我们很高兴地宣布与 Liva AI 达成新合作,带来更多私有数据和两种新口音:埃及 🇪🇬 和尼日利亚 🇳🇬。
| 数据集 | 口音 | 时长 [小时] | 风格 | 转写 |
|---|---|---|---|---|
| Liva AI Conversational EG | 埃及 | 1.34 | 对话、即兴 | 含标点、区分大小写、含不流畅之处。 |
| Liva AI Conversational NG | 尼日利亚 | 1.55 | 对话、即兴 | 含标点、区分大小写、含不流畅之处。 |
这是我们持续改进 ASR 评估(覆盖更多口音和语言)与提升可信度(新增私有数据以减少刷榜,引入新的数据提供方)努力的一部分。期待社区继续推动 ASR 在全球范围内的性能提升 🤗
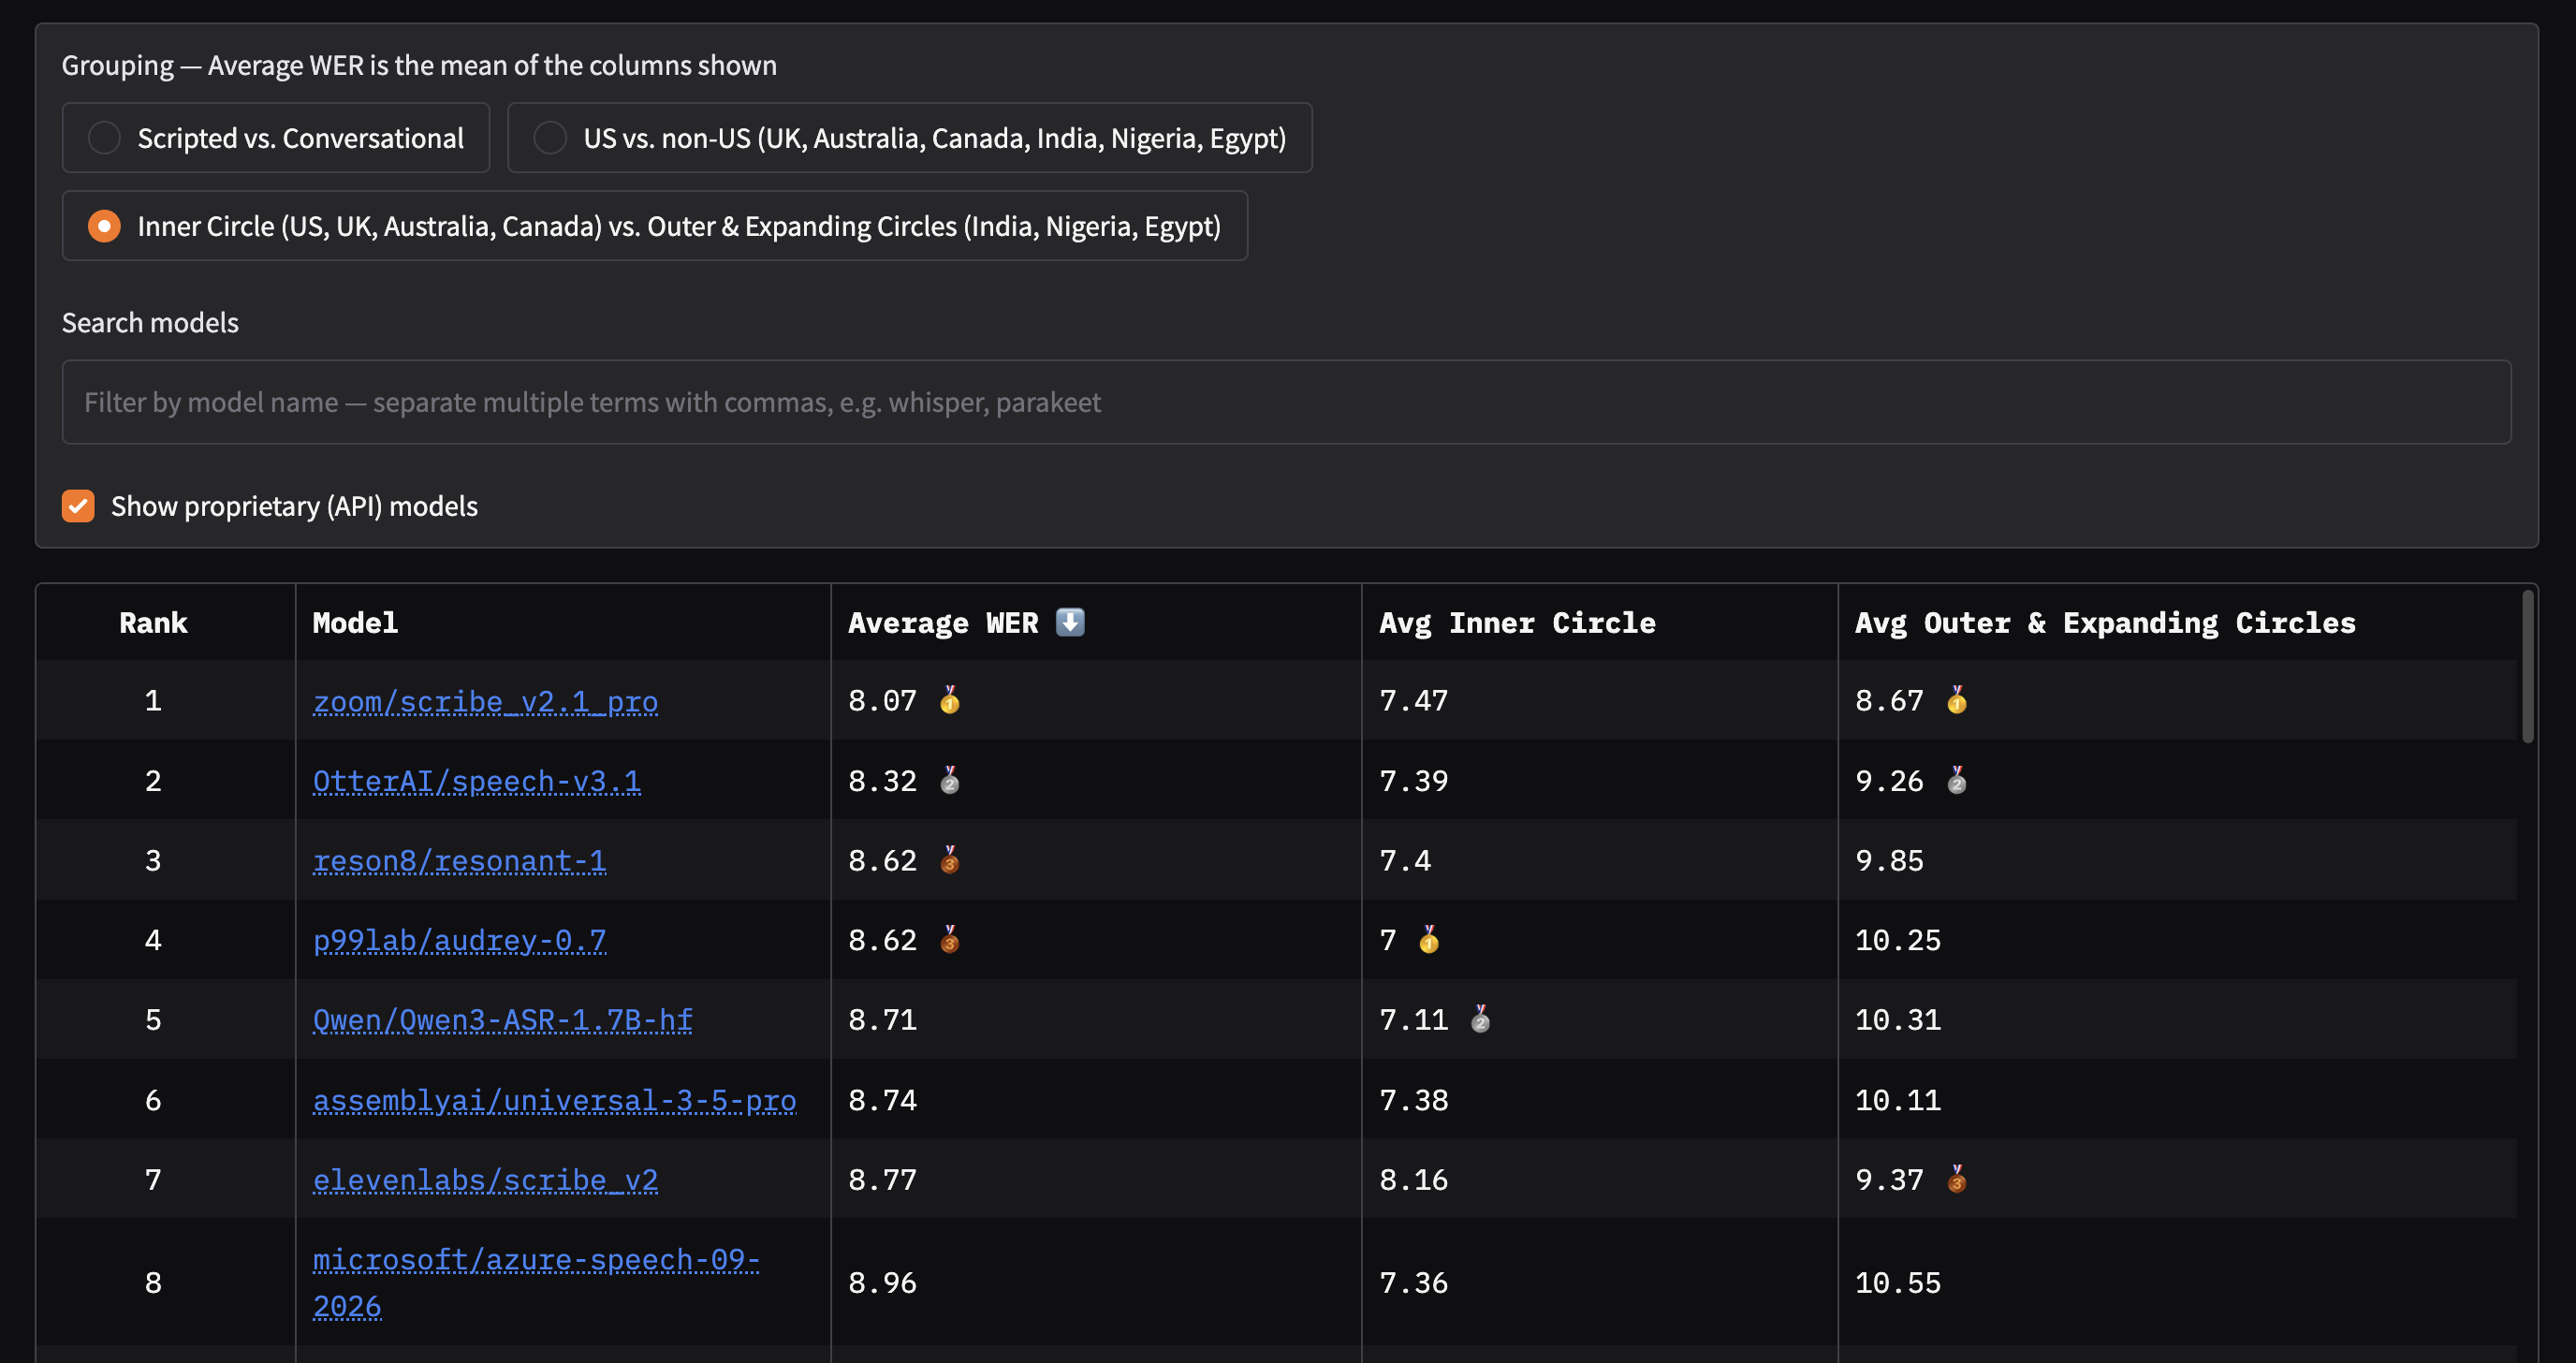
Private 标签页提供更丰富的口音细分
有了这些新口音,我们可以基于 Kachru 三圈理论提供更丰富的口音细分(感谢 Hume AI 在其排行榜中提出的这一思路)。Open ASR Leaderboard 现在将报告:
- 美国 vs. 非美国(英国、澳大利亚、加拿大、印度、尼日利亚、埃及)
- 内圈(美国、英国、澳大利亚、加拿大)vs. 外圈与扩展圈(印度、尼日利亚、埃及)
随着更多口音的加入,我们还会进一步拆分外圈与扩展圈。
关于 Liva AI
Liva AI 通过真实用户使用的消费级产品来收集多模态交互数据。由于 Liva 同时掌控数据采集环境和分发渠道,能够围绕模型在领域、行业、语言、模态和交互类型等方面的具体短板来设计产品。这让它获得了在真实产品使用中自然产生的高语境行为数据,而非人为诱导或基于任务设计的交互数据。
原始来源: HuggingFace博客