
NVIDIA CUDA 13.5 正式发布:新增 Vera Rubin GA 支持
随着人工智能和加速计算不断突破可能性的边界,最新版 NVIDIA CUDA 发布,带来了前所未有的性能和规模。
NVIDIA CUDA 13.5 在多个重要新平台上正式发布(GA)。NVIDIA Vera Rubin 支持从早期开发者预览升级为正式可用,可以进入企业生产环境。Windows on Arm 支持自 CUDA 13.4 起正式发布,如今进一步扩展到 NVIDIA DGX Station for Windows。
CUDA 13.5 还通过 locality domain 和 NVIDIA Multi-Process Service(MPS)提供了更灵活的 GPU 任务调度定制能力,并在库、编译器、NVIDIA CUDA Tile 和开发者工具等方面带来了多项创新。
本文将介绍 CUDA 13.5 的主要亮点。
CUDA 13.5 的增强特性
CUDA 13.5 带来了一些值得关注的增强:
Locality domain 增强
CUDA 13.5 让应用可以在 locality domain 之间选择统一的流式多处理器(SM)分区,或者包含所有可用 SM 的分区。默认情况下,本地化的 green-context 分区在每个 domain 中保证相同的 SM 数量,剩余的 SM 则不包含在这些分区中。
新增的 cudaDevSmResourceGroupLocalityDomainSupplementalSms 标志可与 cudaDevSmResourceGroupLocalityDomainId 配合使用,将这些额外的 SM 纳入所选的各个 domain。这样,应用在跨 locality domain 分区时就能使用设备的全部 SM,只是各分区的大小可能不同。
应用可以在 cudaDevSmResourceSplit() API 中使用发现模式获取每个分区的 SM 数量,并据此分配工作。这样你既可以选择为每个 locality domain 分配统一 SM 数量,保证一致性和可预测性,也可以选择每个 locality domain 的最大 SM 数量,尽可能充分利用 GPU 硬件。更多信息参见 CUDA Runtime API。
NVIDIA MPS
MPS v3 让你更好地控制工作负载如何共享 GPU,从调度单个服务器到为客户端组分配资源,都更加灵活。
加权时间片
加权时间片让你可以为承载有需要的工作负载的服务器分配更长的计算时间。先设置一个基准时间片,再按 MPS 服务器分别调整,还可以独立调优 GPU 在工作负载之间切换的频率。
SM 分区负载均衡
SM 分区负载均衡让工作负载在资源空闲时使用超出其基础分区的容量。通过 --max-chunks 启用资源借用,通过 --shareable=true 允许分区在没有挂载客户端时出借自己的 SM。这两个设置相互独立,因此分区可以借用、出借,或两者兼有。MPS 会先回收借出的资源再重新分配,而应用看到的基础分区大小保持不变。
基于 Cgroup 的路由
基于 Cgroup 的路由将工作负载启动器的进程分组与 MPS 资源策略关联起来。把一个 cgroup v2 子树映射到某个 MPS namespace 后,通过守护进程主 socket 连接的客户端会自动路由到该 namespace。
SM 分区分配
按 namespace 划分的 SM 分区配置允许你为每台设备一次性选定分区,然后自动应用到路由至该 namespace 的所有客户端。这些客户端不再需要分别设置 CUDA_MPS_SM_PARTITION。Namespace 配置优先,未配置的设备仍沿用环境变量的回退机制。
基于轮询的显存统计回退机制
基于轮询的显存统计在 cgroup 阈值通知缺失或不可靠时提供回退方案。在执行驱逐决策时,MPS 可以直接读取当前用量和上限,而不依赖缓存的通知状态。要在显存统计启动前强制开启轮询,可运行 nvidia-cuda-mps-control memacct set force_polling=true。这会增加每次驱逐决策的开销,但摆脱了对通知机制的依赖。
CUDA graphs 中的批量 1D 拷贝
CUDA 13.5 为批量 1D 显存拷贝增加了 CUDA Graph 支持。应用现在可以在 stream capture 中包含现有的 cudaMemcpyBatchAsync 调用,而无需更改批量拷贝的调用语法,从而将多个传输捕获并重放进可复用的 graph 工作流中。应用也可以显式添加批量拷贝节点,并在不改变批量结构的前提下更新兼容的拷贝地址和大小。
NVIDIA Rubin 上的 Windows 驱动模式
从 NVIDIA Rubin 架构开始,CUDA 同时支持 Windows Driver Display Model(WDDM)和 Microsoft Compute Driver Model(MCDM),其中 MCDM 提供纯计算驱动模型。Rubin 及之后的 GPU 不再支持 Tesla Compute Cluster(TCC)。假定 TCC 模式的应用和部署工具应改用目标系统所支持的 WDDM 或 MCDM 配置。
CUDA Tile 更新
CUDA Tile 中的多 GPU 通信
CUDA 13.5 支持在 CUDA Tile kernel 内部直接进行多 GPU 通信。单播(unicast)指针让 kernel 可以访问另一块通过 NVLink 连接的 GPU 上的内存;多播(multicast)指针和专用的 multimem 操作则支持在配备 NVIDIA NVLink SHARP 的 NVIDIA NVSwitch 互连架构上跨多块 GPU 执行归约和存储。应用在启动前准备好共享内存映射,然后在 kernel 内部将通信与计算融合在一起,可用于融合矩阵乘法加跨 GPU 归约等工作负载。
Tile 与 SIMT 互操作(公开预览)
CUDA 13.5 允许 CUDA Tile kernel 直接调用 SIMT 库的 device 函数。在此版本之前,Tile 代码和 SIMT 库代码只能跨 kernel 边界组合,数据需要经由全局内存传递。借助这一预览特性,用 cuTile Python 或 CUDA Tile C++ 编写的 kernel 可以在自己的代码中间调用 SIMT 库的 device 函数,且数据已经在寄存器或共享内存中。这些库包括 NVIDIA NVSHMEM、NVIDIA CCCL Coop、NVIDIA Warp 和 NVIDIA MathDx(后者涵盖 NVIDIA cuFFTDx、NVIDIA cuBLASDx、NVIDIA cuSolverDx 和 NVIDIA nvCOMPDx),各库将很快陆续启用这一互操作支持。
Tile 库文件(.tilelib)打包了 SIMT 库函数的接口和实现信息。编译器会按照库的预期将 tile 划分到各线程,传递共享内存和同步需求,并生成单个 kernel。要在 C++ 中启用该预览特性,需使用 nvcc --tile-preview simt 编译,并将 tilelib 传给 tile 编译器。在 cuTile Python 中,使用 cuda.tile_preview 包提供的 cuda.tile_preview.foreign_call。
在 13.5 中,Tile-SIMT 互操作预览仅覆盖库函数。在 tile 代码中调用自定义 __device__ 函数的功能将在未来版本中提供。详情请参阅文档。
NVIDIA CUDA Python
NVIDIA CUDA Python 持续拓展以 Python 风格访问 CUDA 编程的能力。CUDA Python 核心库 cuda.core 1.2 引入了批量内存拷贝、Programmatic Dependent Launch(PDL)、更简洁的运行时编译,以及更灵活的 CUDA Graph 更新。
批量内存拷贝
新增的 cuda.core.utils.copy_batch() 可以通过单次 CUDA driver 调用提交多个缓冲区拷贝。CopyOptions 提供对源访问顺序、内存位置提示和重叠行为的控制,让应用能更精细地管理数据搬运。
下面的示例使用现有的源和目标缓冲区提交两个独立拷贝:
from cuda.core.utils import copy_batch

# Each source and destination pair must have matching sizes.
# Copies within the batch must not alias.
copy_batch(
    stream,
    srcs=[src_a, src_b],
    dsts=[dst_a, dst_b],
)

stream.sync()
在 Python 中使用 PDL
LaunchConfig 现在通过 programmatic_stream_serialization 选项暴露 PDL。在计算能力 9.0 及以上的 GPU 上,协作 kernel 可以在同一个 CUDA stream 内重叠执行,让依赖它的 kernel 在前一个 kernel 完成前就开始处理独立的工作。这使 Python 应用也能享受 kernel 间重叠执行的优势,同时保留对启动配置的显式控制。详见 LaunchConfig 文档。
from cuda.core import LaunchConfig, launch

config = LaunchConfig(
    grid=num_blocks,
    block=256,
    programmatic_stream_serialization=True,
)

# The kernel must implement the PDL synchronization protocol.
launch(stream, config, dependent_kernel, *kernel_args)
更灵活的 CUDA Graph 更新
应用程序可以在未来的实例化之前更新图定义节点,也可以通过 graph[node] 视图直接修改可执行图的节点,而无需重新实例化图。支持的更新包括 kernel 参数、内存拷贝、内存填充、子图、事件和主机回调。这些能力让应用程序参数变化时的图复用变得更简单。
from cuda.core import LaunchConfig
from cuda.core.graph import GraphDefinition

# Define a graph with one kernel node.
graph_def = GraphDefinition()
node = graph_def.launch(
    LaunchConfig(grid=1, block=256),
    kernel,
    output_a,
)

# Instantiate once and run with the original output buffer.
graph = graph_def.instantiate()
graph.launch(stream)
stream.sync()

# Update the executable node's arguments without reinstantiating.
graph[node].update(args=(output_b,))

# The same graph now launches the kernel with output_b.
graph.launch(stream)
stream.sync()
CCCL
CUDA Toolkit 13.5 带来了 CCCL 3.5,新增了 CUB 的公开调优 API、可复现的浮点 scan、全新的批量 Top-K 选择,以及能直接从 GPU 内存读取问题规模的 reductions。这些新特性让开发者对算法执行有更多控制,也简化了包含数据依赖工作负载的流水线。
通过公开调优 API 定制 CUB 性能
CCCL 3.5 为 CUB 的 device 级算法引入了公开的调优策略。开发者可以通过执行环境中的 cuda::execution::tune(...) 来自定义每 block 线程数、每线程元素数、向量化程度和算法选择等参数。
下面的例子展示了策略选择器如何针对 GPU 的计算能力挑选调优参数。该选择器为 device 级 reduction 返回 cub::ReducePolicy;scan 的选择器则返回 cub::ScanPolicy。未提供自定义策略的应用程序将继续使用 CUB 的默认调优。示例详见 CUB 调优文档。
struct ReduceTuning
{
    __host__ __device__
    constexpr cub::ReducePolicy
    operator()(cuda::compute_capability cc) const
    {
        auto pass = cub::ReducePassPolicy{
            .threads_per_block = 256,

            // 计算能力 10.0 及以上每线程处理 20 个元素,
            // 更老的 GPU 则处理 16 个。
            .items_per_thread =
                cc >= cuda::compute_capability{10, 0} ? 20 : 16,

            .vec_size = 4,
            .reduce_algorithm = cub::BLOCK_REDUCE_WARP_REDUCTIONS,
            .load_modifier = cub::LOAD_LDG
        };

        // 为多 tile 和单 tile 归约同时提供调优配置。
        return {.multi_tile = pass, .single_tile = pass};
    }
};

// 通过公开的调优 API 把选择器挂载到执行环境中。
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::tune(ReduceTuning{})
};

// 继续使用公开的设备级 API,CUB 会应用环境中传入的自定义策略。
auto status = cub::DeviceReduce::Sum(d_input, d_output, num_items, env);
批量 Top-K 选择
Top-K 选择是 AI 工作负载中的一项重要操作,比如文本生成时的 token 选择,以及为稀疏注意力挑选相关 token。新的 cub::DeviceBatchedTopK 可以在多个段中独立地选出最小或最大的 K 个元素,支持仅键和键值对两种模式、可变的段大小,以及各段不同的 K 值。NVIDIA 在设计该算法时充分考虑了 AI 工作负载的需求,CUB 的批量 Top-K 已集成到面向 LLM 推理的 GPU kernel 库 FlashInfer 中。
constexpr int segment_size = 4;
constexpr int k = 2;

auto segments_in = cuda::make_strided_iterator(
    cuda::make_counting_iterator(d_input), segment_size);
auto segments_out = cuda::make_strided_iterator(
    cuda::make_counting_iterator(d_output), k);

auto env = cuda::std::execution::env{
    ...
};

auto status = cub::DeviceBatchedTopK::MaxKeys(
    segments_in,
    segments_out,
    cuda::args::constant<segment_size>{},
    cuda::args::constant<k>{},
    num_segments,
    env);
可复现的浮点扫描
cub::DeviceScan 新增了对浮点求和的逐次运行可复现性支持。现在可以通过执行环境指定固定的归约顺序,在相同 GPU、相同输入和构建配置下获得可重复的结果。
下面的示例请求一个包含性求和的可复现结果。详情请参阅 cub::DeviceScan 文档。
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
让依赖数据量的归约留在 GPU 上
CUB 归约现在可以通过 cuda::args::deferred 读取存放在设备可访问内存中的元素数量。前一个 kernel 或选择操作可以生成该数量,归约按流顺序直接读取,无需传输到主机。这也让被捕获的归约在每次 CUDA Graph 重放时能处理不同的元素数量,而无需更新或重新捕获 graph。
例如,选择操作将输出数量写入 d_count 后,归约可以直接使用它:
auto env = cuda::std::execution::env{
    cuda::stream_ref{stream},
    cuda::execution::require(
        cuda::execution::determinism::run_to_run)
};

auto status = cub::DeviceScan::InclusiveSum(
    d_input, d_output, num_items, env);
详情请参阅 cub::DeviceReduce 文档。
全新开发者工具
NVIDIA Nsight Perf SDK for AI——公开预览
CUDA Toolkit 13.5 推出了 NVIDIA Nsight Perf SDK for AI 的公开预览版,为长时间运行的训练和推理工作负载带来持续性能分析能力。该 SDK 会保留原始运行中选定的 GPU 和 CPU 性能指标及执行上下文,帮助开发者排查那些难以复现的间歇性性能问题。开发者可以在 Perfetto 中查看收集到的数据。了解更多。
更多功能
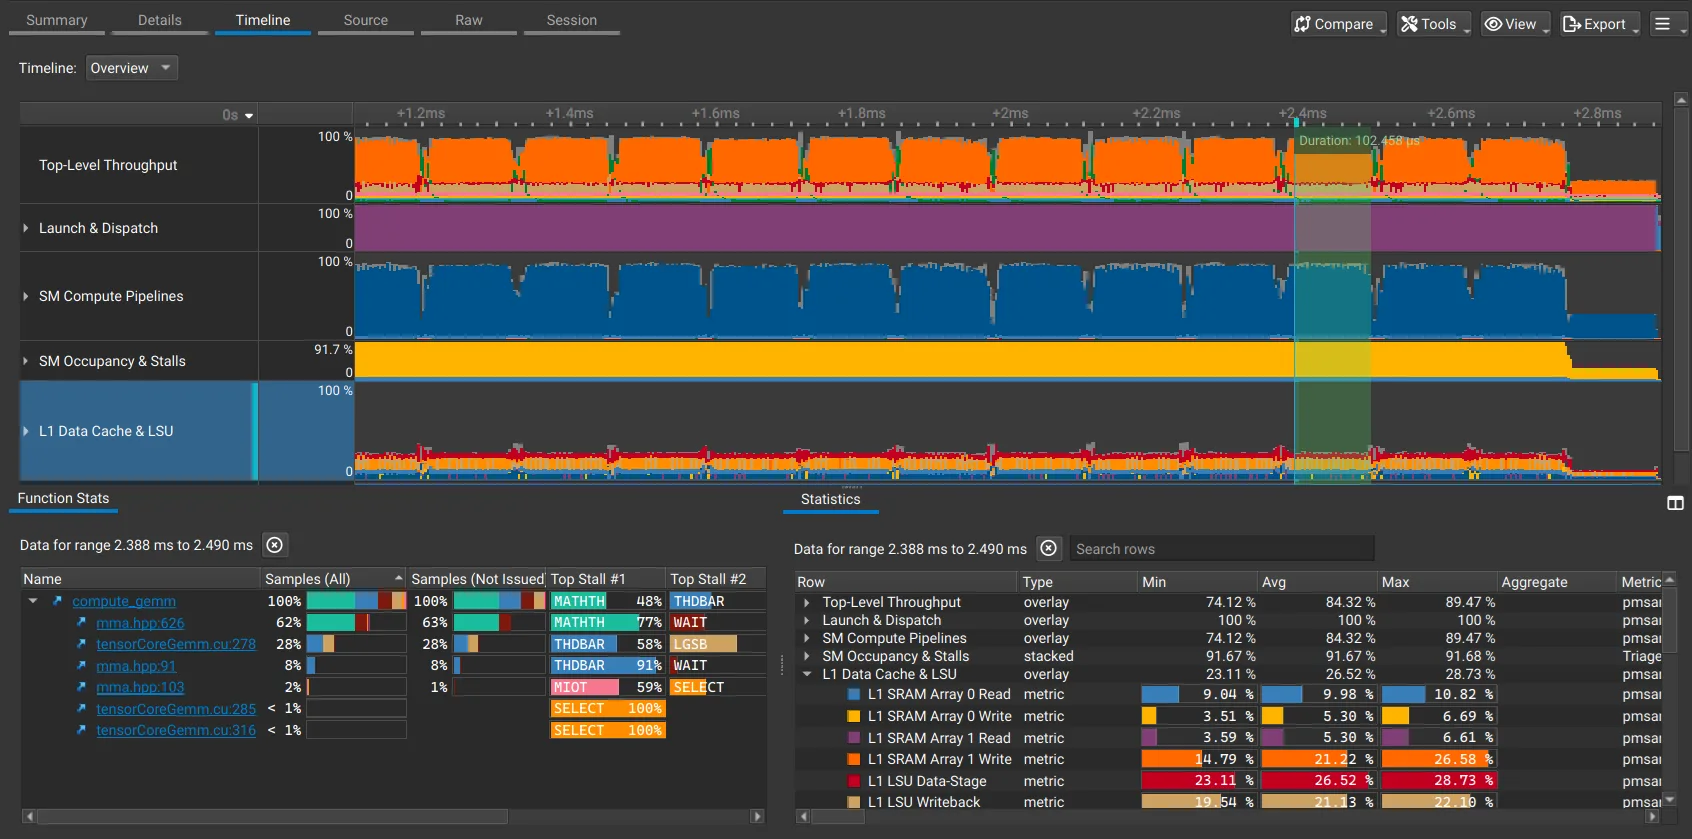
NVIDIA Nsight Compute 2026.4 在 Nsight Compute 中新增了一个专属的 Timeline 页面,让开发者能够更方便地查看 GPU 工作负载随时间的性能变化。该页面将时间维度的分析数据集中呈现,帮助开发者识别工作负载的阶段划分、瞬时停滞,以及聚合指标容易掩盖的硬件利用率波动。开发者可以在不同时间线之间切换,并在页面内直接调用集成的函数统计分析,相关的性能洞察始终集中在一处。详情页还提供了直达相应时间线的链接,简化导航;若报告中没有时间线数据,内置的引导会帮助用户快速上手。
CUDA Toolkit 13.5 为 CUDA-GDB 增加了在 CUDA Driver 日志事件发生时暂停执行的功能,帮助开发者在错误发生的当下进行排查。可通过可配置的规则按线程、严重级别或消息模式过滤事件,让开发者聚焦于相关的诊断信息。当匹配的事件触发暂停时,开发者可以查看 host 端的调用栈,追溯触发代码并定位根本原因。
本次发布还支持在启用 CUPTI 追踪的同时生成 GPU core dump。开发者可以在异常发生时捕获 GPU 状态,之后用支持的调试器检查该转储文件,无需为了复现故障而关闭追踪。
全新的 NVIDIA Compute Sanitizer agent skill 可以帮助 AI 编程智能体选择合适的诊断工具,并正确理解 CUDA 的内存错误、竞态条件和同步问题。
NVIDIA Nsight Cloud 现在通过 Nsight Operator 支持 OpenTelemetry 追踪集成以及 NVIDIA Dynamo 部署的性能分析配置,帮助开发者大规模排查 AI 工作负载的性能问题。
数学库
CUDA 13.5 的核心 CUDA 数学库在 Vera Rubin 上实现了性能提升。cuBLAS 将 Ozaki-II 方案扩展到 FP64 对称 rank-k 更新。其他新特性和值得关注的性能提升包括:
NVIDIA cuBLAS
- NVIDIA Vera Rubin 上更快的 GEMM:通过更新启发式算法和内核调优,Vera Rubin 上开箱即用的 NVFP4 和 MXFP8 矩阵乘性能得到提升,包括混合专家(MoE)LLM 训练的典型形状。训练和推理工作负载无需针对具体形状做自动调优即可获得更高吞吐量。
- FP64 对称 rank-k 更新的 Ozaki-II 支持:Ozaki-II 方案现已在 NVIDIA Ampere 及更新的 GPU 上支持 {D,Z}SYR{K,2K,KX} 和 ZHER{K,2K,KX}。因此,基于 cuSOLVER 构建 Cholesky 分解和最小二乘求解器的应用也能为这些例程获得 Tensor Core 加速。
- NVIDIA Blackwell 上更快的原生 FP64 对称更新:双精度和双复数精度的 SYR2K、HER2K、SYRKX 和 HERKX 在 NVIDIA B200 上最高提速 1.5 倍。使用原生 FP64 对称更新的科学计算代码(如特征值求解器和矩阵分解)无需修改代码即可加速。
- 针对非对齐形状优化的 BF16 内核:维度不是 8 的倍数的 BF16 矩阵乘,现可在 NVIDIA Hopper 及更新的 GPU 上使用与 FP16 相同的优化内核。层尺寸不规则的模型(包括通过 NVIDIA cuDNN 调度的卷积)不再因选用 BF16 而非 FP16 而付出性能代价。
- Blackwell GPU 的 Windows on Arm 支持:cuBLAS 在 Windows on Arm 上为 Blackwell GPU(包括 GB300 工作站)提供功能支持。基于 Arm 的 Windows 系统开发者无需切换平台即可运行 cuBLAS 加速的应用。
NVIDIA cuSPARSE
- ALG3 带来更快的 FP32 和 FP64 CSR SpMM:在数据中心 GPU 上实现 1.65 倍至 2.27 倍的性能提升,加速稀疏矩阵与稠密矩阵的乘法运算。
- 全新 SpSV ALG2 算法:按几何平均值计算,求解速度比 ALG1 快 2.7 倍,加速需要反复求解稀疏三角系统的工作负载。
- 更快的 SpSV 分析:分析阶段实现 2.79 倍的几何平均加速,缩短稀疏三角求解的预处理时间。
- 更低的 SpSV 内存占用:减少稀疏三角求解的内存消耗,为应用数据腾出更多 GPU 显存。
- 扩展的混合索引支持:在 SpMV(CSR、SELL)、SpMM(CSR)、SpSV(SELL)以及稀疏转稠密/稠密转稀疏转换(CSR、CSC)中,支持 64 位偏移量搭配 32 位索引,从而处理更大的稀疏矩阵,同时索引内存占用低于全 64 位索引方案。
- 混合精度 CSR SpMV:在
cusparseSpMV中将 FP16 或 BF16 矩阵值与 FP32 输入/输出向量结合,并以 FP32 计算,在保留 FP32 累加的同时降低矩阵存储需求。 - 全新实验性
cusparseSpMVGenericAPI:对对称矩阵执行 SpMV 时只存储上三角或下三角,避免重复存储非对角元素,从而降低存储需求。 - 全新实验性
cusparseSpMatConvertAPI:支持 CSR 与 CSC 格式之间的相互转换,更方便地让稀疏矩阵布局适配不同运算。 csrcolor图着色提速:按几何平均值计算,性能提升约 3 倍,缩短稀疏矩阵着色所需时间。
nvJPEG
- GPU 混合解码吞吐量提升:
NVJPEG_BACKEND_GPU_HYBRID后端的解码吞吐量提升 10% 至 600%,具体取决于图像尺寸以及是否使用标准 Huffman 表。 - 自动后端选择:使用
nvjpegDecodeAPI 时,自动后端选择现在也会考虑NVJPEG_BACKEND_GPU_HYBRID(此前仅考虑NVJPEG_BACKEND_HYBRID和NVJPEG_BACKEND_HARDWARE)
编译器更新
用 nvprune 在打包阶段预编译设备代码
CUDA 13.5 在 nvprune 中新增了 --precompile 选项,开发者可以在 prune 步骤中把中间设备代码(PTX、TileIR)编译为原生 SASS/ELF。
对于向已知目标架构部署 fat binary 的下游用户(如云服务商、软件包分发方),这可以省去运行时的 JIT 开销。
建议选择与部署环境匹配的目标架构,并在打算支持的各 GPU 架构上验证生成的产物。
扩展 CompileIQ 支持范围
CUDA 13.5 将高级控制文件(ACF)支持扩展到了 PTX Compiler 和 NVVM 库,基于这些库构建的编译流程因此也能应用 CompileIQ 生成的编译器控制配置。
更灵活的 TMA 寻址控制和更快的基于周期的三角函数运算
CUDA 13.5 增强了 PTX 和设备内建函数的能力,帮助开发者优化数据搬运和数学运算。
在 kernel 内配置 TMA 越界寻址
分块计算经常遇到张量边界问题,即部分 tile 落在张量维度之外。高效处理这些不完整的 tile 对 MoE、矩阵乘法、卷积等工作负载非常重要。
CUDA 13.5 扩展了 PTX 的 tensormap.replace 指令,使 kernel 能够直接更新 tensor map 中 Tensor Memory Accelerator(TMA)的越界寻址模式。这让开发者在复用 tensor map 描述符时可以控制寻址行为,并免除了相关工作负载中应对非法地址错误的性能开销高昂的变通方案。
基于周期输入的快速近似单精度三角函数运算
CUDA 13.5 新增了 __sin2pif、__cos2pif 和 __sincos2pif 设备内建函数,支持以周期为输入的快速近似单精度三角函数计算。
这一能力对基于相位的计算很有用,可以利用快速的近似三角函数结果。
sin 和 cos 指令对应的 PTX .2pi 变体可以省去额外的角度转换操作,非常适合已经使用周期相位的负载。
用 cuobjdump 更轻松地读取 CUDA 二进制符号
CUDA 13.5 改进了 cuobjdump 的 ELF 符号表输出,让开发者更容易理解 CUDA 二进制文件中包含的函数和变量。
| 列 | 描述 |
| Type | 标识符号类型,例如函数或对象 |
| Bind | 显示符号的绑定方式,例如 local 或 global |
| Vis | 显示符号的可见性 |
| Other | 标识 CUDA 特有属性,例如 kernel 入口点和内存空间属性 |
此前,符号信息和 CUDA 特有属性都以原始十六进制字段呈现,开发者需要手动解码。更新后的输出会按 readelf -s 用户熟悉的惯例,在四列中显示描述性的值。
这样一来,区分 kernel 入口点和 device 函数、查看 global、constant、shared 和 managed 变量的相关属性都变得更容易。当多个 CUDA 属性同时生效时,输出会将它们的名称一起列出。无法识别的属性值仍会以 UNKNOWN(0xNN) 的形式显示。
该增强适用于现有的 --dump-elf 和 --dump-elf-symbols 选项。例如,开发者可以用以下命令查看 CUDA 二进制文件:
cuobjdump --dump-elf-symbols application.cubin
无需额外选项即可获得描述性输出。原有信息——包括符号名称、值、大小和节索引——依然可用。
如果你使用脚本解析这些符号表输出,请更新脚本解析器以适配新的列和命名属性值。
开始使用 CUDA Toolkit 13.5
CUDA Toolkit 13.5 为 NVIDIA Vera Rubin GPU 架构提供了 GA 支持,更新了 GPU 资源管理和通信能力,并在 CUDA Python、CCCL、CUDA Tile、NVIDIA Nsight 开发者工具以及核心数学库方面带来了多项增强。
下载 CUDA Toolkit 13.5,并查阅 CUDA Toolkit 13.5 发行说明,了解完整的功能列表、支持平台和兼容性信息。
Jackson Marusarz、Mahender Hari、Mridula Prakash、Daniel Rodriguez 和 Sandeep Hiremath 为本篇博客的工作做出了贡献。