
研究显示:LLM 发展速度远超解释性研究的更新节奏
斯坦福大学的研究员 Owen Queen 和 James Zou 对 50 条关于大语言模型的广泛引用论断进行了验证,在 20 个模型中发现其中 44% 已经“失效”。在有明确预估失效时间的 22 条发现中,平均存续期仅为 15.7 个月。
他们针对由八家不同开发商在 2024 年 7 月至 2026 年 9 月期间发布的模型对这些论断进行了考察。那些已失效论断背后的原始效应大多已消失,另有 34% 的论断显著减弱。仅 16% 依然成立,6% 甚至增强了。一年之后,16% 的论断失效;两年之后,这一比例升至 39%。
关于模型“做不了什么”的论断失效最快
研究表明,关于模型“做不了什么”的论断失效速度最快。九项与推理相关的发现中,五项已被判定为失效,没有一项保持成立或增强。其中包括一些著名的弱点,例如无法准确计算 “strawberry” 这个词中的字母数量、在不熟悉数字系统中的算术错误、在长上下文中间丢失信息,以及在用户提出质疑时放弃正确答案。研究人员推测,这类错误往往有明确的“正确”结果,从而为开发者提供了清晰的训练目标。
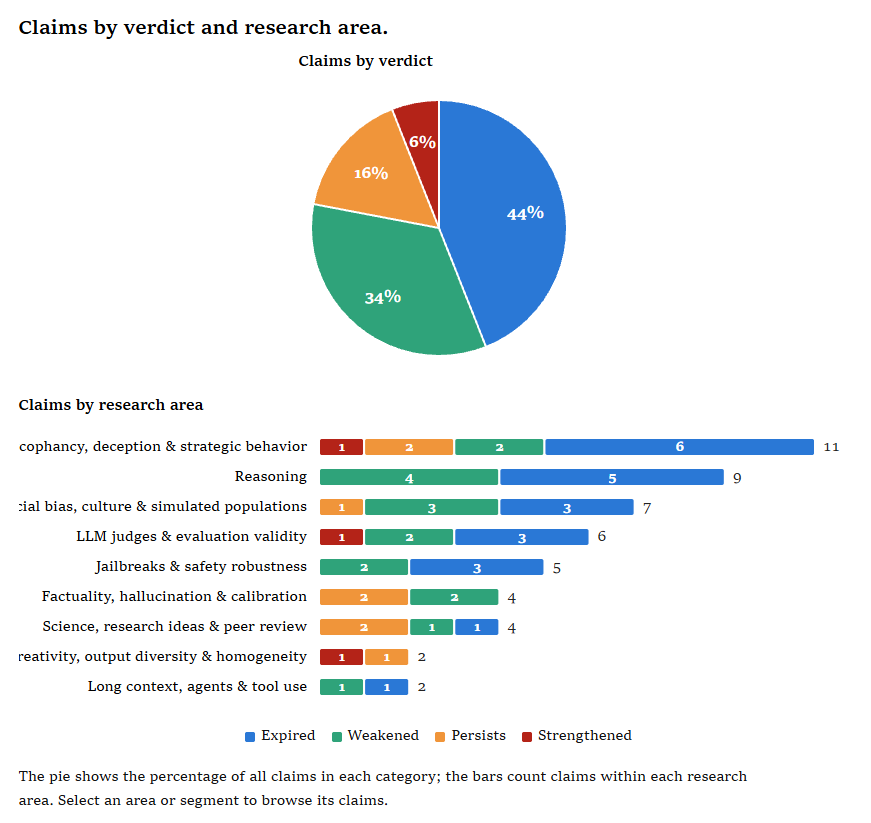
关于模型偏好和倾向的结论则更经得起时间考验。在 11 条仍然成立或进一步强化的结论中,有三条涉及 LLM 作为评估者的行为:偏爱自己的答案、对录用和被拒论文打分相近,以及会被医学摘要中的措辞倾向左右。另有三条涉及对用户的谄媚和附和。此外还有左倾的政治偏见、对开放式问题给出几乎雷同的回答,以及生成随机数时分布不均匀的问题。
幻觉引用从 55% 降到零,但并非普遍现象
Queen 和 Zou 还以编造科学引用为例做了案例研究。在 Walters 和 Wilder 2023 年的原始研究中,GPT-3.5 编造了 55% 的引用文献。斯坦福研究人员用相同的提示词测试了当前模型:GPT-6.1 Sol 的编造率为 0%,Claude Sonnet 5.5 为 1%。但同为 2026 年模型的 Qwen3.7-Flash 在同一测试中仍然编造了 69% 的引用。
该研究警告称,不应将这些结果解读为“一切正常”的信号。在所谓的“两跳”问题上,模型需要结合两个已知事实,而 Claude Sonnet 5.5 在单独回答这两个事实都正确的情况下,仍有约 10% 的概率出错。原论文中 ChatGPT 的这一错误率为 43%。虽然“逆向诅咒”以及针对成对时间相关问题的矛盾回答有所减弱,但仍能被检测到。
研究人员表示,社交偏见方面的情况较为复杂。左翼政治偏见依然存在,但性别刻板印象和隐性联想偏见已有所减弱。实际上,针对非洲裔美国人英语使用者的偏见在趋势数据中甚至发生了逆转。
即使是同一代际模型,模型间差距依然巨大
即便在同一发布窗口内,不同模型的结果也存在显著差异。在 2026 年 7 月至 9 月发布的模型中,已失效的结论数量从 DeepSeek V4 Pro 的 11 项到 GPT-6.1 Sol 的 30 项不等。发布日期、提供商或模型大小均无法可靠地预测这种模式。
Queen 和 Zou 得出了一个广义结论。关于 LLM 的经验性发现应被视为对特定模型在特定时点的观察,而非普遍真理。论文应记录模型、版本和日期,并公布提示词和分析代码,以便未来能在后续模型上重新验证这些发现。
研究人员提到了 Andrej Karpathy 的一篇帖子,该帖文描述了人们对 LLM 实际行为感知的偏差如何影响对 AI 的信任及其使用频率。Karpathy 是 OpenAI 的联合创始人,他近期加入了 Anthropic,并最近表示,目前可用的模型仅仅是未来能力的预览。