
Transformers 模型集成测试契约
2026 年 7 月 30 日,Transformers 为 T5 启用了 PyTorch 的缩放点积注意力(SDPA)。副作用是 UMT5 的解码器可以注意到未来的 token——训练时它相当于能偷看本该预测的答案。没有任何东西崩溃,这个 bug 在 main 分支上潜伏了将近两个月。
当我们后来重放那些提交时,一个跑在 CPU 上的小型 UMT5 模型在每一个提交上都标记出了问题。本文要讲的就是这个模型,以及围绕它构建的测试。
为什么 bug 能进 main
Transformers 支持 750 多种模型类型,测试套件规模庞大:main 分支上有 88,000+ 个 CPU 测试,每天还要跑 200,000+ 个 GPU 测试。模型测试只是一部分,我们还测试 pipelines、训练、分布式执行、量化和注意力 kernel。
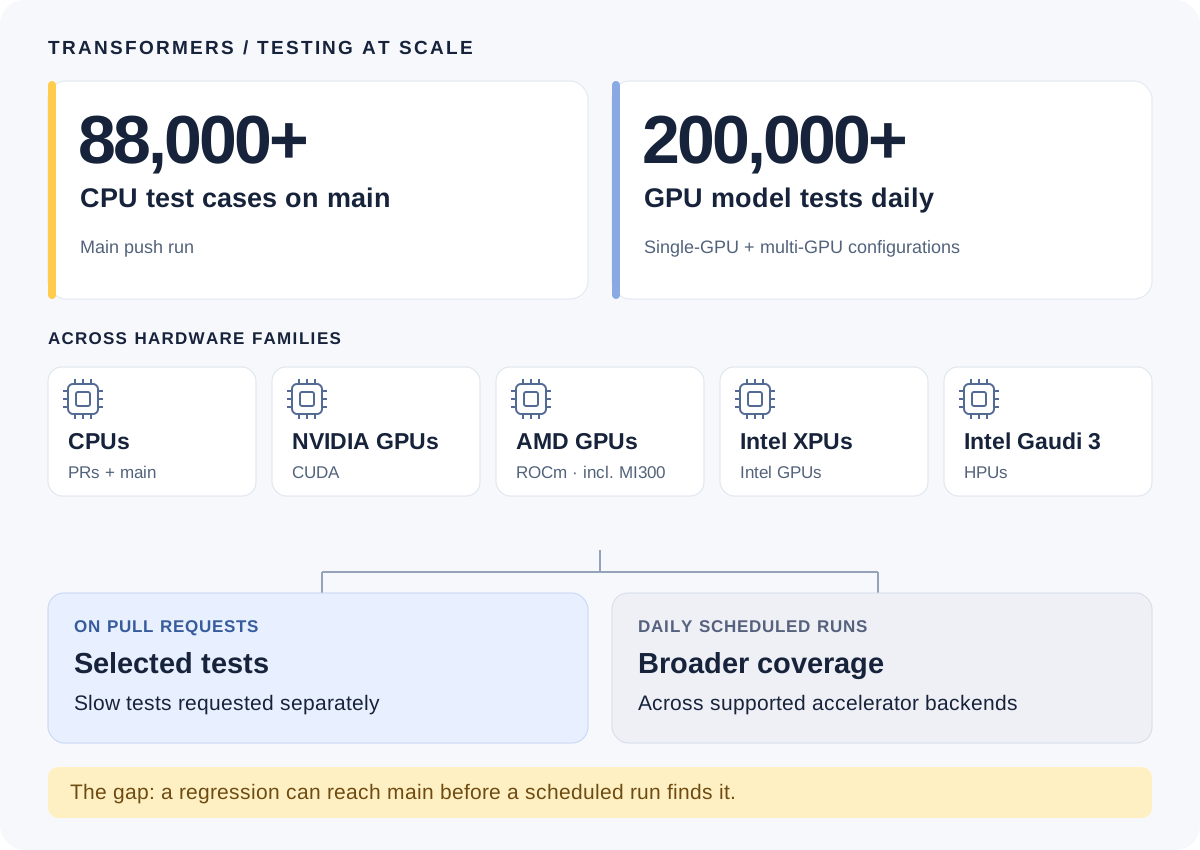
集成测试会加载真实的 checkpoint,在真实硬件上调用模型的 API。如果每个 PR 都跑全部测试,就意味着要整天占用大量 GPU,这不现实。等定时任务发现回归时,问题可能已经进了 main。
我们的思路是把模型缩小。我们构建一个 fixture:用真实 checkpoint 的配置生成的小模型,层数更少、维度更窄,但包含它拥有的所有层类型,tokenizer 和 processor 文件保持不变。它只需发布一次,之后重复使用。我们在廉价的 CPU runner 上对它运行"快速集成测试"。在 CPU 研究中,实验用的 UMT5 fixture 只占 66 MB 权重,而原 checkpoint 有 1,227 MB。
这套方法也适用于超大规模模型:有些模型在我们标准的 GPU runner 上根本放不下,但它们的 fixture 在 CPU 上就能跑。
模型集成者本来就会构建微型测试模型(即 Transformers 的 tiny-random-* checkpoint)。我们想要的是一套通用配方,以及超越"加载模型、跑一次前向传播"的检查。UMT5 那个 bug 通过前向传播测试完全没问题。
Fixture 无法完全取代集成测试,但在 PR 阶段,它们能帮我们在 bug 进入 main 分支前就把问题拦下来。
模型集成契约(MIC)介绍
transformers-mic 是一项打包这类测试的提案标准。一个 Model Integration Contract(模型集成契约,MIC)由三部分组成:
- fixture:即上述裁剪后的模型,只发布一次并锁定版本
- usage path(使用路径):一段可运行的 Markdown 示例,展示用户对模型的常见操作,比如生成文本或执行一步训练
- baselines(基线):运行该示例时记录的输出,经过人工审核
只要在 fixture 上运行 usage path 仍能产出 baselines,契约就视为通过。
一份契约针对的是一种架构和一条 usage path,而不是单个 checkpoint:兼容的 checkpoint 可以共用同一个 fixture,各自保留自己的预期结果。相关契约发布在 huggingface-mic 中。
例如,SmolLM 契约会用 "The capital of France is" 这类 prompt 做生成,并把 token ID 与记录的答案做比对。加载模型和 tokenizer 后,生成代码简化到单个 prompt 就是:
inputs = tokenizer("The capital of France is", return_tensors="pt")
outputs = model.generate(**inputs, max_new_tokens=4, do_sample=False)
new_tokens = outputs[:, inputs["input_ids"].shape[1]:]
print(tokenizer.batch_decode(new_tokens, skip_special_tokens=True))
此外它还会比对训练 loss,检查梯度是否为有限值,并验证 optimizer 一步更新确实改变了权重。完整内容见 usage.md。
Hub 上的一个 fleet 数据集把每份 MIC 锁定到一个冻结的 revision,并记录生成 baselines 时使用的包版本。每次 CI 运行都会记录所用 fleet revision,方便日后复现。
对于 PR,我们会根据补丁改动的文件来挑选需要运行的 MIC。
UMT5 回归事件
我们对五个月的 Transformers 提交记录重放了冻结的 MIC。小型 UMT5 fixture 从 2026 年 7 月 30 日问题引入开始就标记了这次回归,直到 9 月 28 日修复。标签对数概率与已评审基线相差 1.22,训练损失相差约 0.20。
有一个关键细节:该契约用的是 SDPA,也就是默认的注意力路径。如果只跑 eager 注意力变体,是发现不了这个 bug 的。fixture 只有走真实 checkpoint 相同的代码路径才有价值。
随后我们在 Transformers CI 的验证分支上回退了这个修复。检查以相同的差异失败,所选 T5 契约的 runner 步骤在 CPU 上耗时 13.4 秒(不含环境搭建)。
模型是如何缩小的
最初的方案很简单:把维度缩小、层数减少。但这招对混合架构不够用——比如留下的两层都是滑动注意力,全注意力层就没了,保留两层也没意义。
现在的方案分四步:
- 缩小配置。从一个真实 checkpoint 出发,缩减 hidden size、注意力头数和深度,但保留各种层类型,包括滑动注意力与全注意力的混合、dense 与 MoE 层的混合。某些架构还需要额外规则来保证各组件兼容。我们也会参考模型在 Transformers 中的自带测试:
test_modeling_<model>.py里的ModelTester本来就手工挑选了小配置,凡是通用规则不认识的宽度,就直接借用它的尺寸。 - 保持预处理不变。保留词表、特殊 token 和输入维度,tokenizer 和 processor 文件逐字节复制。加载和预处理本身也是我们要测试的对象。
- 构建并验证权重。先用固定种子的随机权重,再改变输入,确认模型有响应。如果没有响应,就用合约的小批量样例训练一下。重新加载保存的模型,检查输出、loss 和梯度是否为有限值。不合格的构建直接拒绝。
- 冻结并记录。保存验收通过的权重,在一个已知良好的 Transformers 构建上测量可复现的输出。逐一审查每个支持平台和精度的基线,然后发布一个固定版本的快照。CI 复用这个快照,不会在每个 PR 里都重新构建 fixture。
我们还保留原始权重文件格式,否则就会跳过用户加载真实 checkpoint 时运行的转换代码。完整配方里有更多细节。
Llama 4 Scout 缩减报告展示了大模型上的实际效果:1086 亿参数缩减到 4470 万;视觉部分从 34 层减到 2 层,语言部分从 48 层减到 4 层,同时保留需要检查的层类型和 MoE 路由方式。
用 agent 构建 MIC
我们的命令行工具 tmic 负责创建合约并构建 fixture。对于新模型,LLM 会起草用法代码和 manifest,并在 CPU 和 GPU 上运行以测量候选基线。LLM 只负责起草,不负责批准——变更预期结果必须经过人工审核。
想在自己的机器上试试,把 org/model 换成你的源 checkpoint:
pip install "transformers-mic[runtime]" "hf-doc-builder @ git+https://github.com/huggingface/doc-builder.git"
hf auth login
tmic run org/model --local-only --fixtures-only --no-history --bill-to ''
它会起草合约、构建 fixture 并在你的机器上记录基线,每一步都会请你确认,并在上传任何内容之前停下来。对于新模型,草稿由 LLM 通过 Inference Providers 生成,费用计入你自己的账户(--bill-to '')。各步骤的详细说明见
CLI 文档。
我们用 agent 跨模型家族构建 MIC。遇到边界情况时,我们在模型专家的帮助下修正的是配方本身,而不是单个 fixture。已发布的模型和尚未覆盖的部分见coverage space。
随机权重 vs 过拟合
用随机权重时,我们的 Whisper fixture 几乎不受音频变化的影响。它确实能跑,但对音频路径的测试效果很差。
于是我们在几个音调上训练它,配上 "red"、"green" 这样的词。我们并不是在教它语音识别,只是让音频变化能在输出中体现出来。在权重初始化研究中,随机权重的 Whisper fixture 抓到了 24 个注入故障中的 18 个,过拟合 fixture 则全部抓到。
这就给了我们两种构建权重的方式:
- 使用随机权重并固定随机种子。
- 在少量样本上过拟合,比如 "The capital of France is" => "Paris"。
Whisper 的结果并不能说明哪种更好。那是合成故障,而且我们还没发现过只有过拟合版本才能抓到的真实回归。两种版本都漏掉了一个 assisted-decoding bug,而真实的 Whisper checkpoint 暴露了它。
所以我们的做法是:随机权重能通过检查就用随机权重,需要更好的灵敏度或可读的输出时再过拟合。训练只要几秒钟,但多了一个可能不收敛的步骤,也多了一项要维护的东西。对比报告里有两种方式的完整结果。
悬而未决的问题
截至 2026 年 11 月 1 日,Transformers CI 中的 MIC 任务只报告失败,不会阻塞 PR。要不要让它阻塞 PR,取决于一些我们还没测量的东西:
- 它在 PR 上(而不是重放中)能抓到多少真实 bug?
- 它让我们追查误报的频率有多高?
- 基线 review 要花多少工作量?
我们也不知道像 Whisper 那个 assisted-decoding bug 一样、只在真实权重上才出现的 bug 有多少,以及过拟合能否抓到随机权重漏掉的真实 bug。
目前的覆盖率仍然不完整,各模型家族和常用 API 还没有全部覆盖。一旦有回归问题漏网,我们就能补上缺失的使用路径,并在出问题的版本和修复后的版本上重放验证。已有测试在其覆盖范围被记录之前会一直保留。
最后,我们希望能把 Hub 上的原始模型页面与其对应的 MIC 关联起来,这样开发者或 Agent 使用某个 checkpoint 时,就可以直接从在该 checkpoint 上测试过的示例入手,连同它的运行环境和预期输出。
想参与贡献?从 coverage space 中挑一个尚未覆盖的模型,试试 tmic 工作流,提交一个使用路径,或者审阅一份自动生成的契约。