
Palette:用你的设计语言教会小模型制作幻灯片
让前沿模型做一份幻灯片,效果通常不错。但让它做十份,就开始千篇一律:同样得体的默认风格、同样的“官方腔调”,隐隐透着一股“AI 生成感”。这本来没什么,直到你希望幻灯片长得像你自己的模板。前沿模型有自己固有的风格,再多的 prompt 也拦不住它往回飘。更何况有时内容涉密,根本不能离开你的系统。
这两个问题都指向同一个答案:一个属于你自己的模型——开源权重、跑在你自己的基础设施上、用你自己的设计语言训练。问题在于,真正能自托管的那类小型开源模型,恰恰很不擅长这件事。它们生成的幻灯片常常是坏的:标题隐进背景里、文字跑出画面、图形层层叠在一起。
Palette 验证了一个判断:一个小型开源模型,只要用你的设计语言的合成数据训练、再配上一个校验 harness,就能与前沿系统一较高下,同时让你保有对产出的完全掌控。我们微调了一个 20B 模型,让它像人类一样制作幻灯片:设计师负责规划,程序员负责逐页绘制。它的训练数据遵循 IBM Design Language,在 PresentBench 上,它在我们测量的三个领域中两个排名第一。本文介绍我们如何合成数据、训练模型,以及如何围绕它搭建 harness。
为什么幻灯片对小模型很难
幻灯片看起来简单,但要做一份,模型得同时完成三件小模型不擅长的事。
盲排版。模型并不真的“画”幻灯片,它写代码,把每个元素按 x、y 坐标、宽度和字号放好。一个 75 字符的标题用 56pt 字号能不能排进两行,全靠模型在脑内做算术,而且只有等代码渲染出来才知道算错了没。小模型经常算错,这就是图形重叠、文字出界这类问题的来源。
同时做两类决策。决定每页写什么、怎么呈现(用图表还是表格?砍掉哪些内容?)是编辑判断;而精确摆放则是几何问题。一次生成要在 10–20 页里同时兼顾两者,还要保持配色、字体和版式的一致性。
目前没有任何数据能展示 PPT 是怎么被做出来的。现成的成品很多,但设计决策背后的思路,以及生成它们的代码,都没有留存。
像人一样干活:设计师加程序员
没有人能一口气做完一份 PPT。人会先定故事线(多少页、每页讲什么、哪页放图表、哪页放表格),然后再逐页制作。Palette 用同样的思路拆分工作,交给一个 LoRA adapter 驱动的两个角色:
- 设计师读取规划,输出一份结构化的 JSON brief:包括配色、字体体系,以及每页的版式、具体内容和简短的设计理由。
- 程序员从 brief 中拿到某一页的规格,先写出推理过程,再生成用 pptxgenjs 绘制该页的 JavaScript 代码。
现在每个角色只做一类决策:设计师负责内容编排上的判断,程序员负责排版布局。两者之间的 brief 可读、可编辑,人或 agent 都能只改某一页的版式,而不必重新生成整份 PPT。另外,每一页的上下文在写代码前就已确定,所以程序员的调用可以并行执行——每页一次调用,让编码阶段快了约 6–7 倍。
我们用 LoRA 而不是全量微调来训练 adapter:它只教格式和技能,不动底层模型的既有能力,而且每次实验成本都很低。一个教训是:程序员样本的长度约为设计师样本的 5 倍,简单混合训练会让设计师欠拟合,我们把设计师样本过采样 5 倍后才解决。
合成 PPT 及其设计推理
公开数据里没有现成的规划、设计决策和幻灯片代码语料,所以我们用一个大型的开源教师模型生成了一份。每份 PPT 都从一个 recipe 出发,规定其类型、页数、版式以及用户指令,从而控制数据覆盖的范围。规划有的整理得井井有条,有的就是一堆原始素材,让模型学会裁剪和精炼。我们一共生成了约 1000 份 PPT、约 10000 页幻灯片。
每条样本还带有背后的推理,以反事实的方式呈现:推理过程会权衡另一个选项,并说明为什么否决它,让模型学到选择背后的规则,而不只是选择本身。设计师会对内容和形式进行推理。例如:
“四个季度的营收数据,一条清晰的增长曲线。我考虑过用表格,但这张幻灯片要表达的是趋势,不是具体数字,所以用柱状图能让人一眼看懂。”
coder 还会考虑排版几何:
“标题有 62 个字符。用 44pt 会折成三行,挤到下方的图表,所以我设成 36pt,两行放得下,也给图表上方留出了空间。”
光靠 teacher 并不能让数据变好,起作用的是围绕它的整个循环。每一份合成的 deck 都会被渲染,并用推理阶段 harness 所用的同一个 checker 检查重叠和溢出问题。有问题的幻灯片会被修复,其推理过程也会重写成同样的反事实形式,说明原来的布局哪里出了问题、为什么这样修就行。checker 抓到的每个错误,都会变成一个更好的训练样本。
最难的问题是忠实度。最糟糕的失败是幻灯片里出现了输入中没有的事实,而我们发现靠 prompt 规则根本防不住。如果一份 brief 要求一张六行五列的表格,但只有三条要点,coder 就不得不编造其余内容。
真正解决问题的是参考 deck,而不是规则:修改参考 deck 能稳定改变 teacher 的输出,而添加规则几乎没用。teacher 在 prompt 里能看到几份参考 deck,它模仿参考的程度远高于遵循指令。
用大白话控制 deck
用户常常想对具体的设计选择做更细粒度的控制:用图表而不是表格、指定某个颜色、封面更暗一些。Palette 允许用户通过 directives 提出这些要求——写在 plan 里的简短指令,用 [[ ]] 包裹:
## Rollout plan
- March: pilot with two teams
- May: security review complete
- July: rollout to all of engineering
- September: company-wide launch
- November: first adoption review
[[make this a timeline]]
designer 会把每条 directive 写进 brief,coder 画幻灯片时照着执行。没有这条 directive,模型合理的选择是把这些里程碑做成表格;有了它,模型就会改画时间线。
模型之所以遵循 directive,是因为它就是这样训练出来的。数据配方里包含了来自 12 个类别的 directive(下面展示了其中几个),每条都有多种不同的表述方式,这样模型学到的是意图,而不是某个固定短语。
| 类别 | 指令示例 |
|---|---|
| 布局 | [[做成时间线]] |
| 语气 | [[直说,不加修饰]] |
| 受众 | [[这是给董事会的]] |
| 顺序 | [[先说诉求]] |
| 省略 | [[不提定价]] |
| 强调 | [[突出核心数字]] |
 图 1:同一份方案在未加(左)与加上
[[做成时间线]] 指令后的效果对比。
构建检查与修复机制
再好的模型偶尔也会生成有问题的幻灯片:比如标题颜色和背景一样,或者两个文本框叠在一起。所以 Palette 不会直接返回模型的输出,每份演示文稿都要先经过一套检查修复流程。
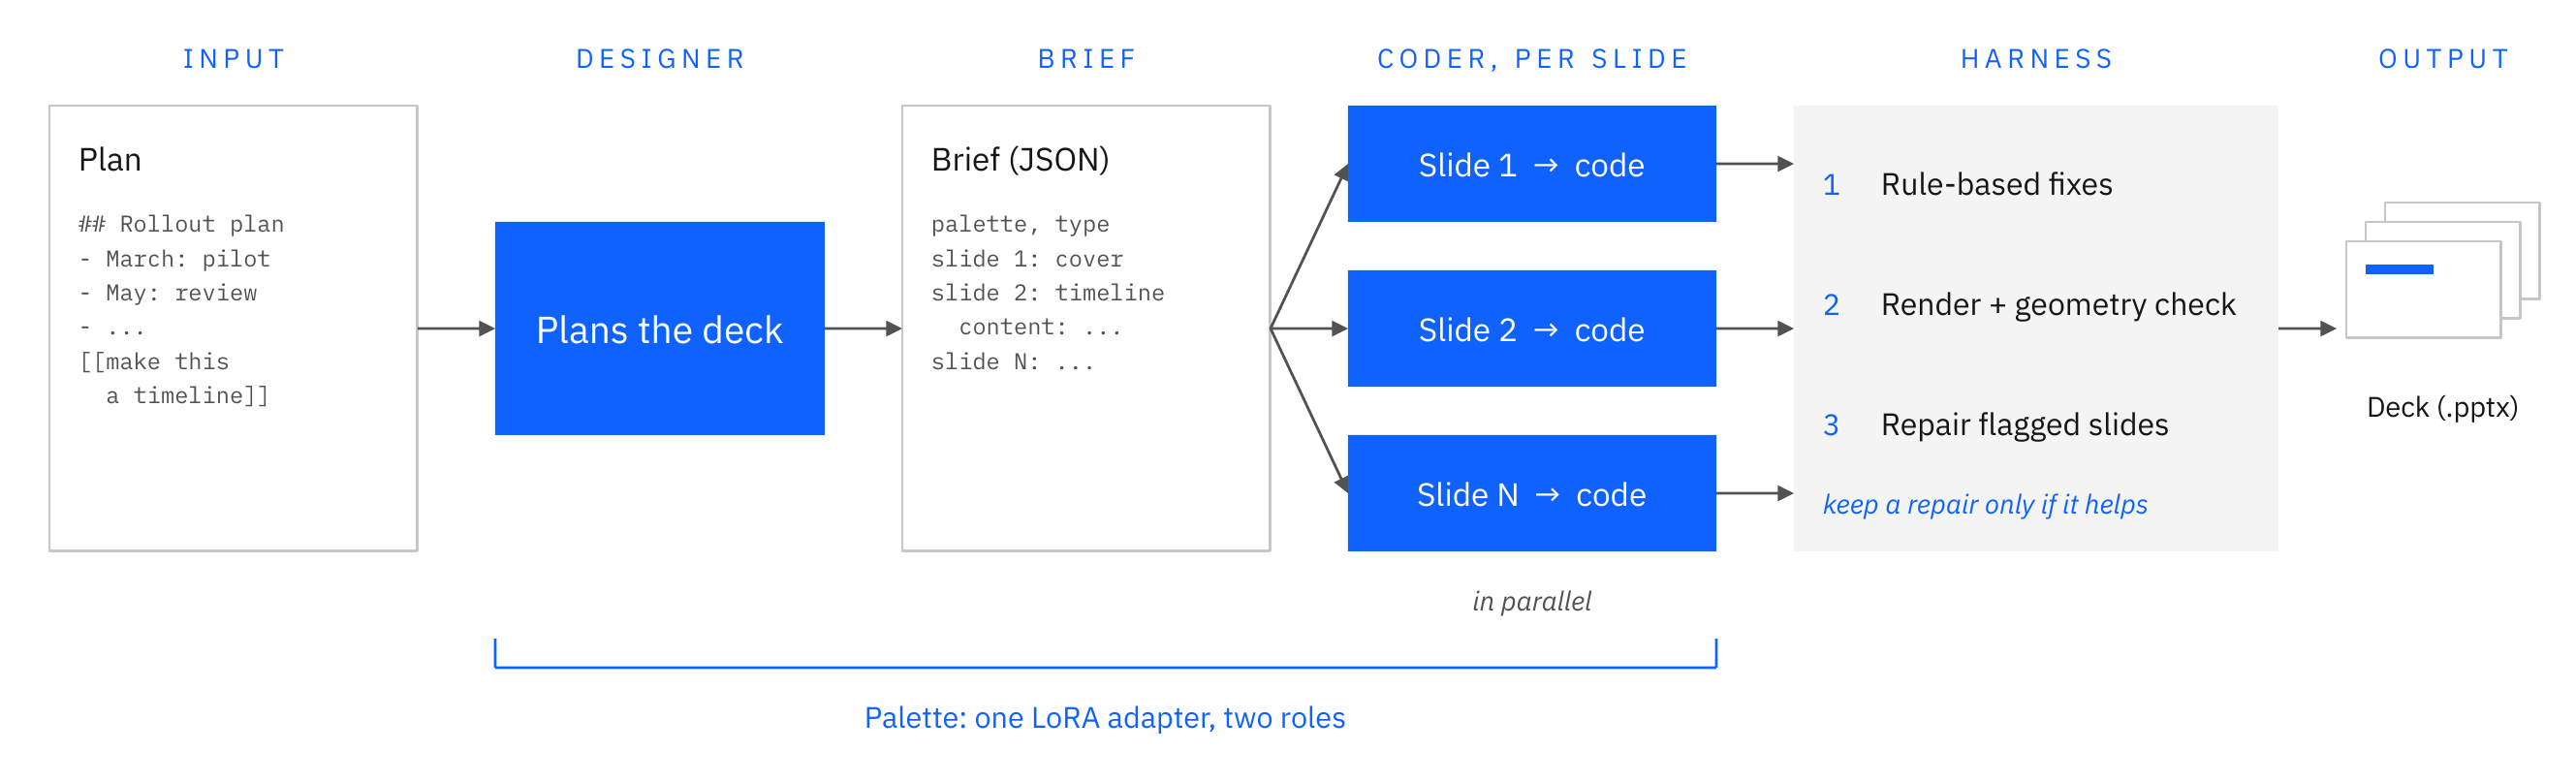 图 2:designer 负责起草简报,coder 并行编写每张幻灯片的代码,harness 在返回文稿前对每张幻灯片进行检查和修复。
首先用简单的规则修复已知的错误,比如格式错误导致整张幻灯片变黑的颜色代码。然后渲染每张幻灯片并进行测量:几何检查器会标记出文字重叠、被裁切或超出幻灯片范围的问题。有问题的幻灯片会交给一个独立的 editor 模型,重写该页的代码。
关键规则是:只有检查器确认幻灯片确实改善了,重写结果才会被采纳,否则保留原始版本。这让这套流程可以放心地用在每份文稿上——它能修复问题,但不会让情况变得更糟。
 图 3:修复过程示例。生成结果(左)中,每张卡片的标题叠在了描述文字上;框架检测到重叠后,将卡片重新排列成 2×2 网格(右)。
为了衡量它的效果,我们对每个 PresentBench 演示文稿各生成一次,分别在有框架和无框架的情况下打分。在 131 个演示文稿上,该框架平均带来 3.5 分的提升。
评估
我们在 PresentBench 上进行评估,该基准从五个维度为生成的演示文稿打分:基础知识、视觉设计、完整性、正确性和忠实度。由于 PresentBench 提供的是源文档而非计划,在这些测试中,我们让另一个前沿模型根据文档起草计划,再由 Palette 依据计划生成演示文稿。我们报告了三个领域的成绩;基线数据来自 PresentBench 论文。
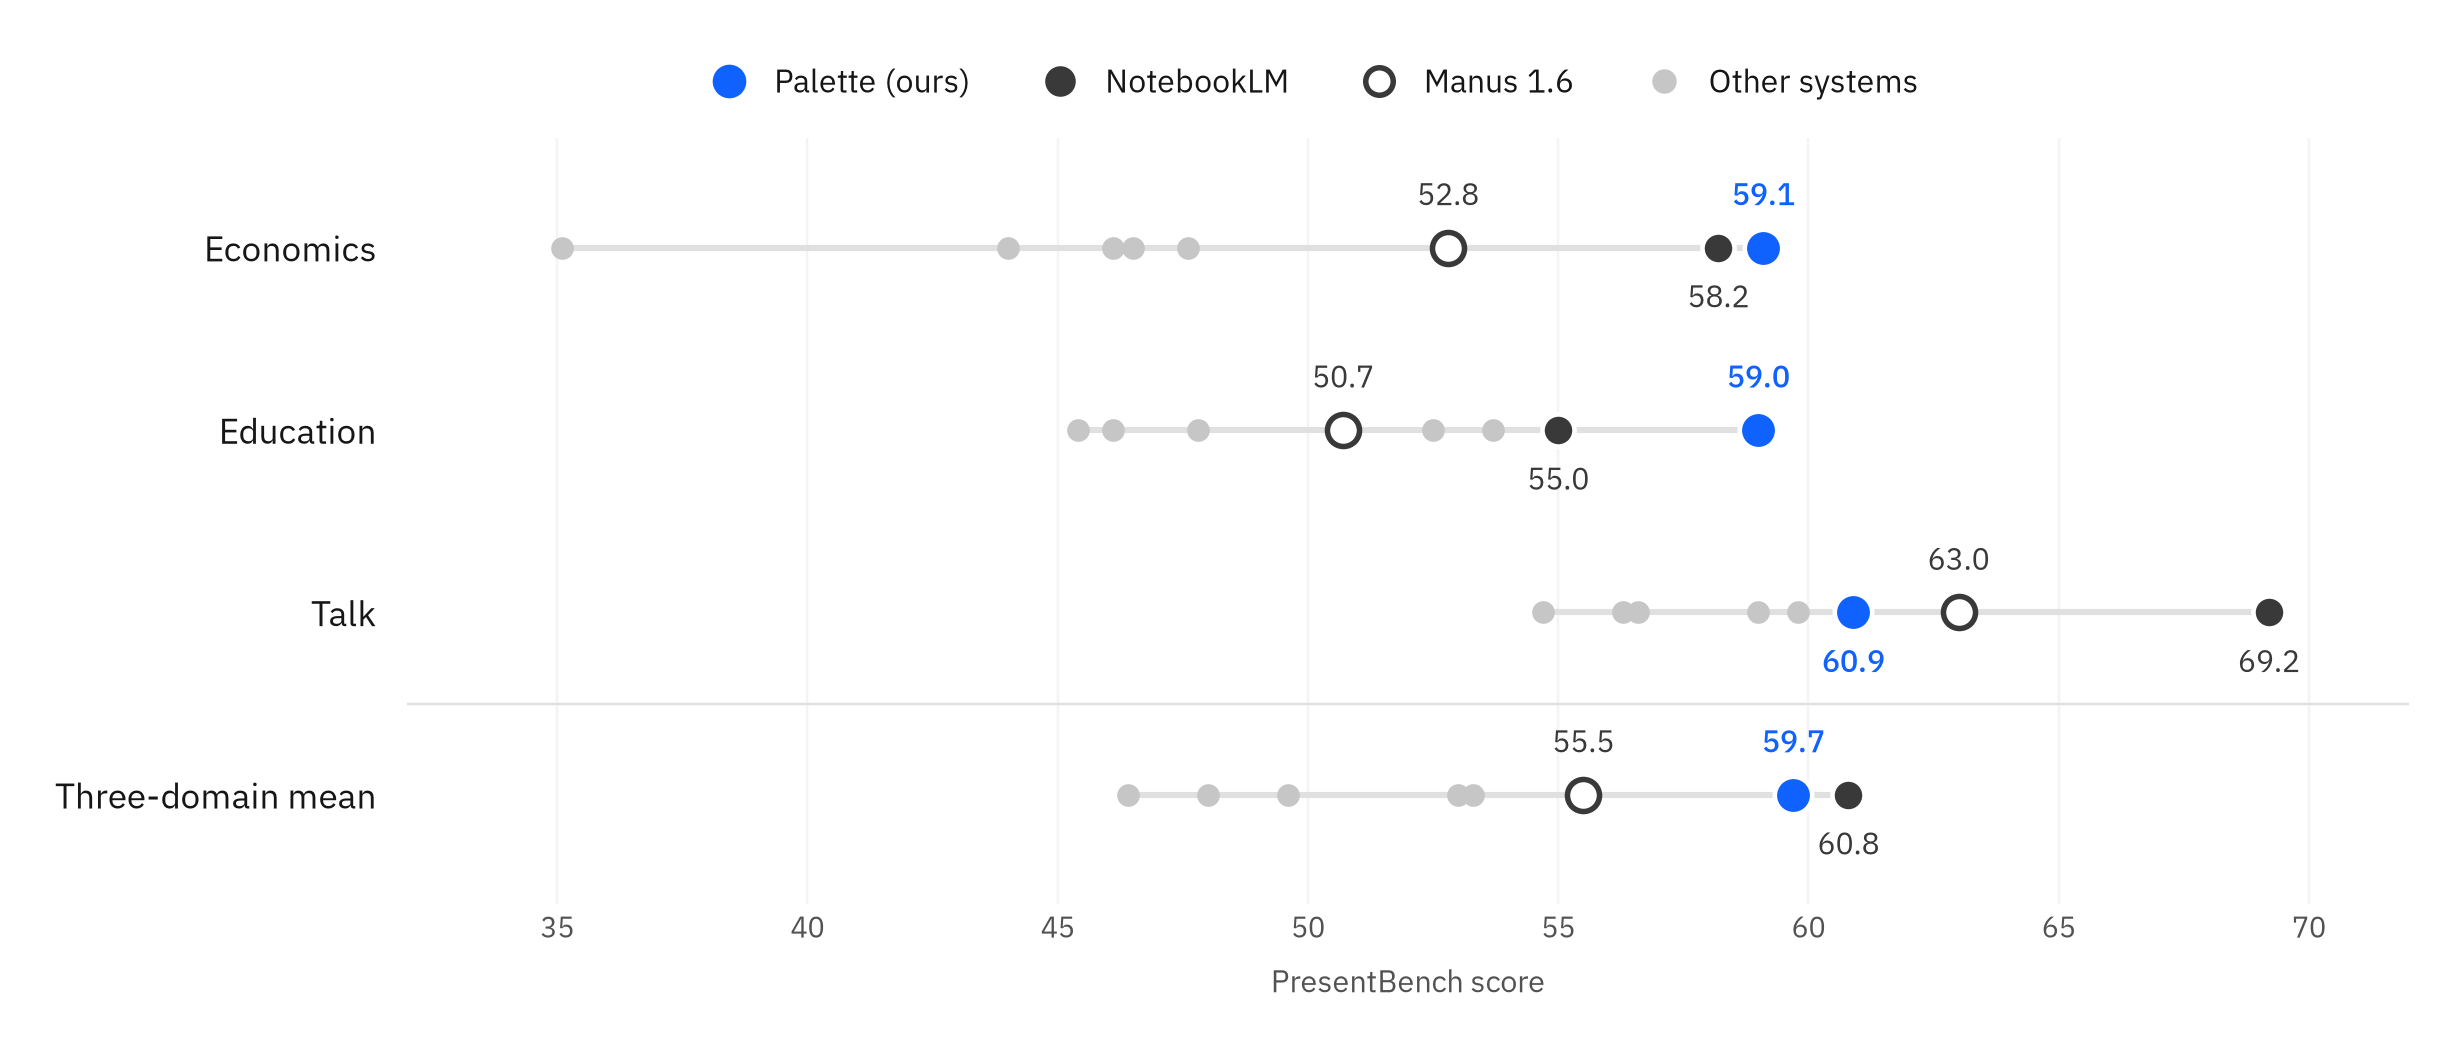 图 4:PresentBench 各领域得分。Palette(蓝色)对阵 NotebookLM、Manus 1.6 及另外五个系统(灰色)。Palette 在 Economics 和 Education 两个领域排名第一,在 Talk 排名第三,三领域均值排名第二。
Palette 在结构化内容和数字准确性起决定作用的领域表现最好,在 Economics 和 Education 上均排名第一。而在以叙述和演讲驱动的 Talk 领域,两个闭源系统得分更高,Palette 位列第三。综合三个领域,它以一个 20B 参数的开源权重模型取得第二名,落后 NotebookLM 1.1 分(59.7 对 60.8),领先其他所有系统。
PresentBench 衡量的是演示文稿本身的质量,而不是它是否遵循特定的设计语言。我们尚未发现有基准能衡量这一点,也希望尽一份力填补这个空白。
下一步计划
评测框架已经在计算一些低成本、可验证的信号:幻灯片能否正常渲染、有没有元素重叠或溢出、每条事实是否都能追溯到需求文档。目前我们用这些信号在生成后修复输出。接下来,我们希望把同样的检查项作为强化学习的奖励,让模型从一开始就不犯这些错误。由于 coder 每次只处理一张幻灯片,每张幻灯片就是一段简短、可独立验证的 rollout,天然适合 GRPO 风格的训练。
我们还希望通过从源文档中提取图表(比如用 Docling)并交给评测框架来排版,弥补图表密集型幻灯片上的不足。另外,我们正在探索一种更轻量的自定义模板方案:从你已有的一两个 .pptx 文件中提取样式来重新换肤,无需重新训练。
我们的心得
构建 Palette 的过程让我们总结出几条有效方法,可以自然推广到其他输出结构能用代码校验的任务上,从图表到 UI 布局都适用:
- 把推理过程放进数据里。训练时包含“为什么这么选”(包括拒绝了哪些方案),比只给最终选择更能教好模型。
- 先修好示例,再加规则。当 teacher 模型出错时,我们的第一反应是往它的 prompt 里加规则,但几乎没用。teacher 更多是在照抄参考幻灯片,而不是遵循指令,所以修好参考材料才真正改变了它的输出。
- 让修复默认安全。只有当修复在指标上确有提升时才保留,这样的修复机制可以放心地跑在每一条输出上。
- 先构建校验器。它既保证了数据的可信,也让输出可以安全上线。