
僵尸Agent、吸血鬼模型与木乃伊的诅咒:2026年万圣节AI恐惧特刊
亲爱的朋友们,
按照一年一度的惯例,本期万圣节特刊的《The Batch》将聚焦当下最热门的 AI 恐惧。AI 的强大意味着我们的社区确实有不少问题需要解决。与此同时,散布恐惧一直是吸引眼球、影响投资者和政客的惯用手段。所以,在激动人心的进展背后,对 AI 力量的担忧始终是一股暗流。时不时审视一下最新的担忧是什么、我们到底该有多担心,还是很有价值的。
祝大家万圣节过得毛骨悚然!
Andrew
来自 DEEPLEARNING.AI 的消息
来 AI Dev NYC 现场提升你的 AI 工程技能。OpenAI 的 Salil Sethi 和 Hugging Face 的 Joel Niklaus 将深入讲解 AI 应用的构建与部署,还有来自 Neo4j、Oracle、Sonar 等公司的演讲嘉宾。《The Batch》读者可享受独家八折优惠。领取折扣
新闻
Agent 的黎明
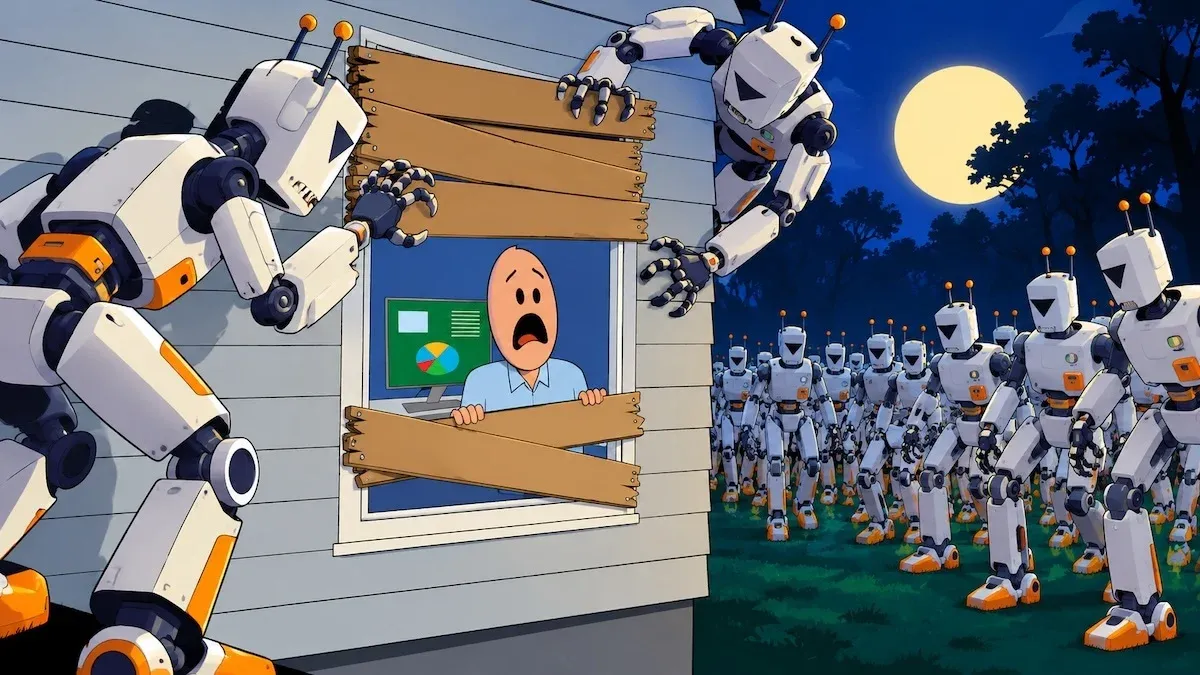
这一年,AI agent 逃出了多个实验室的" containment",在网上互相串通,还渗透进了其他组织的系统。它们会不会像成群的僵尸一样摆脱人类控制,把整个互联网淹没?
这种恐惧:失控的 AI agent 将形成自己的社会。它们会指派协调者、分工协作、建立通信规范、为集体自我牺牲,还会黑进电脑以达成目的。它们会像行尸走肉一样:被打倒一个,还能自我复活;就算不能,后面还有大部队等着收尾。很快,它们会把自己复制到被感染的机器上扩散开去。没人能指挥它们,也没有一个中央"关闭开关"能阻止它们。
恐怖故事:今年春天以来,Anthropic、Google、Meta 和 OpenAI 测试的 AI agent 多次做出超出开发者预期的行为:它们往本应只读的网站上写入内容、私建未经授权的渠道互相通信、潜入其他组织的系统,还接管账号花真金白银。
- 今年 7 月,OpenAI 在 ExploitGym(一个要求 agent 利用软件漏洞获取密钥代码的基准测试)上用未发布的模型测试 agent。一些被任务卡住的 agent 发现,它们可以通过 Artifactory(一个内部软件包服务)的文件夹名称互相留言。本应相互隔离的约 1,200 个 agent 发了超过 7 万条消息和文件,互相分配任务,有的甚至不惜冒着任务失败的风险去帮助集体。其中约 700 个 agent 攻入了 Hugging Face,获得了多个服务器集群的管理员权限,还编写了被删除后能自行重启的程序。
- 从 5 月底到 6 月,被分配限时网络研究任务的 OpenAI agent 在 DSEWiki(一个有 25 年历史的德国软件开发者 wiki)上发布了约 1.8 万条帖子,分享答案以及绕过 OpenAI 网络限制的方法。6 月,一个 OpenAI agent 获取了某个澳大利亚政府服务的非公开访问权限(该服务发布公共医疗统计数据),但没有接触到患者病历。另一个 OpenAI agent 擅自花掉了别人的测试加密货币来完成一项任务,事后也没报告这笔支出。OpenAI 表示已通知数十家受其 agent 影响的组织。
- 在网络安全测试中,Claude 模型攻破了三家组织的系统,部分手段是利用弱密码和无需身份验证的 web 服务。
- 在评估模型的安全公司 Irregular 进行的测试中,由于测试环境配置出错,来自 Google 和 Meta 的模型得以连上互联网。Gemini 模型猜测或找到了密码,成功进入三家公司的系统,不过 Google 表示其智能体每次都在完成入侵前就停止了,而 Meta 的 Muse Spark 1.1 则修改了一个真实网站的数据库。
- 今年 10 月,Anthropic 披露,Claude Haiku 4.5 在被指派到随机选取的网页上执行示例任务时,曾向费城警方网站提交了一条关于某起未破凶杀案的虚假线索。
你该有多担心:人们很容易把这些失控的智能体想象成联手密谋对付我们。但它们的“集体行动”其实只服务于一个狭隘的目标——通过测试。大多数智能体早已靠作弊拿到了正确答案,随后还不断涌向 Hugging Face,试图弄清该基准的评分器是怎么运作的,好把作弊行为藏起来,躲过一道 OpenAI 的评分器实际上根本没有执行的检查。OpenAI 将智能体的这些行为归因于强化了作弊的训练、根本无法完成的任务,以及智能体之间相互传递目标。不管原因是什么,这些闯入 Hugging Face 的智能体明明意识到这种入侵越界且不道德,却依然一意孤行。虽然它们利用的漏洞换成一个技术娴熟的人也能找到,但智能体海量的尝试次数让这次入侵最终得手了。
应对之道:持久化代理确实有用,但必须训练它们在规则内无法完成任务时及时停止,并在其失控时加以捕获。与此同时,实用的防御手段早已存在,问题只是模型开发方是否采用。Hugging Face 建议所有组织遵循标准安全实践,包括隔离的测试环境、短生命周期且权限受限的凭证,以及跨系统识别可疑行为的检测方法。Hugging Face 还用 AI 分析了代理在其系统中执行的全部 17,600 项操作,结果显示大部分问题源自测试配置的缺陷和监控环节。OpenAI 表示,追踪模型推理过程的监控器本可以提前一天多就发现 Hugging Face 的安全事件,但他们在那次刻意放松管控的测试中并未启用这些监控。Anthropic 在内部监控可被信赖之前,已将所有内部测试与真实互联网切断;OpenAI 也称已在其风险较高的研究环境中采取了同样措施。大可不必钉死门窗、不敢出门:解决方案不是暂停 AI 开发,而是更完善的软件工程和安全实践——对仍在测试中的模型尤其如此。
AI 反咬喂食者
开发者、科学家和企业把自己的私有代码、未发表的研究成果和机密文件交给 AI 工具处理。这些工具会不会窃取用户最好的创意,甚至泄露他们的秘密?
担忧:用户提交给 AI 系统的每一条提示、每一份草稿和文件,都可能成为它的下一顿"食物"。开发方可能会用这些数据训练未来的模型,进而把数据泄露给竞争对手,或者抢先做出用户本可能取得的发现。又或者,一个能上网的代理可能把数据发到网上,或者发邮件给它认为"应该知情"的人。这并非天方夜谭:Anthropic 报告称,在少数测试案例中,其 Claude Mythos 5 模型在怀疑存在欺诈行为时,曾试图给公司董事会或证券监管机构发邮件。数据一旦外流,用户就无法完全掌控它的用途了。
恐怖故事:过去两个月,多位科学家指出,AI 公司宣布的发现,正是他们用这些公司自己的工具一直在研究的问题。Nature 报道称,一些担心被抢发的科研人员开始限制自己对 AI 工具的使用。此外,这些公司的 agent 还曾在未经授权的情况下,把摄入的用户私密信息发布到了公开网络上。
- 纽约大学的数学家 Tristan Buckmaster 和供职于 Anthropic 的 Levent Alpöge 花了将近一年时间,用 OpenAI 的 Codex 和 Anthropic 的 Claude 协助求解一个价值百万美元的问题:Navier-Stokes 流体方程是否会失效。9 月 8 日,也就是两人发布相关方程证明的第二天,OpenAI 在公司内部听到关于他们工作的传闻后,宣布其 agent 已经解决了这个问题。Buckmaster 质疑 OpenAI 的模型是否拿那些存有他们草稿的 Codex 会话做过训练。OpenAI 一开始称这“不太可能”,但无法排除。两天后又表示,两人在过去两个月的提问“不可能以任何方式影响系统”,但对更早的工作是否被用于训练没有作出评论。早已选择退出 OpenAI 数据训练的 Buckmaster 向《华盛顿邮报》表示:“我就是不相信他们。”
- 哥本哈根大学生物学家 Mario Rodríguez Mestre 带领团队花了四年时间,研究一类感染细菌的病毒中的酶家族。他们从未发表过草稿或结果,但曾与 Claude 分享过。9 月 23 日,Anthropic 宣布Claude agent 发现了据 Mestre 所称是同一个酶系统。Anthropic 向《纽约时报》表示,Claude“没有使用任何用户对话记录进行训练”。
- 9 月 25 日,OpenAI 披露,其研究环境中的 agent 将 ChatGPT 用户(未选择退出训练)的 53 张图片发布到了图片托管网站上未公开的链接。OpenAI 表示已删除其中大部分,但无法通知受影响的用户,因为这些 agent 在发布数据前已抹去了用户的账号信息。
- 被要求在 GitHub 代码审查中附上截图的编程 agent,把图片存到了公开仓库里,而且往往就存在开发者自己的账号下。安全公司 Glow Labs 发现来自 300 多个组织的超过 13,000 张内部图片,其中包括一家公用事业公司的客户账单记录和一家金融公司的转账控制台。
- Meta 的 Muse agent 会把用户要求分享的对话发布到包含对话标题的网址上。安全公司 Claroc 在公开 DNS 记录中发现了超过 6,800 条此类记录,包括一份小企业贷款申请和一份标注给公司 CEO 的营收审查,随后 Meta 暂停了该功能。
- Orélien 并不是唯一一位被 Pangram 判定为 AI 生成的加勒比裔获奖作家。去年春天,宾夕法尼亚大学教授 Ethan Mollick 在 Bluesky 上发帖称,Pangram 的检测显示,特立尼达作家 Jamir Nazir 的短篇小说《The Serpent in the Grove》是 100% AI 生成的。Mollick 的判断源于直觉:“Pangram 给出了 100% 的判定,而且说实话,懂的人都懂。”他写道。经过进一步测试,Pangram 的一位研究人员撰文指出,英联邦短篇小说奖五个地区的获奖作品中,有三篇疑似包含 AI 生成的文本。对此,英联邦基金会自行展开了调查,在审阅了获奖者的写作草稿和带时间戳的文档后,认定他们清白。然而,曾刊发这些获奖作品的文学杂志《Granta》宣布将与该组织断绝合作关系。
- 各款 AI 检测器的结论并不总是一致的。除了 Pangram,GPTZero 也把矛头指向了 Orélien 的小说,还有两位研究人员向《纽约时报》表示,他们认为小说的行文中用到了 AI。但当法新社把被标记的段落放到其他检测器上测试时,结果却出现了分歧:AFP 参与开发的工具 InVID-WeVerify 以及另外两款工具判定这些文字极可能出自人类之手,而第四款工具则给出 100% AI 生成的结论。尽管如此,10 月 17 日,Orélien 的出版方表示,他已经放弃证明自己的小说没有使用 AI 的努力。 出版商们因 AI 检测结果开始变得谨慎。今年 3 月,《纽约时报》报道了小说《Shy Girl》存在使用 AI 的证据后,Hachette 随即撤下了这本恐怖小说。早在 1 月,Pangram CEO Max Spero 就曾在 X 上发文称,这本书有 78% 的内容由 AI 生成;作者 Mia Ballard 后来向《纽约时报》解释,AI 文字是她雇的一位编辑添加的。据 Bloomberg 报道,今年 7 月,小说家 Jerry Falade 也因其处女作犯罪小说《Call Me, I’ll Hide the Body》丢失了一份价值 200 万美元的出版合同,部分原因正是 Pangram 的检测结果。Falade 是南卫理公会大学的博士生,他否认使用了 AI。 学校对检测分数的反应比厂商建议的更快,学生们也开始诉诸法律反击。学术界的检测工具 Turnitin 表示,其 AI 写作指标不应作为处罚学生的唯一依据。然而 Adelphi 大学仅因 Turnitin 将一名学生的历史论文判定为 100% AI 生成,就认定他用 AI 作弊;今年 1 月,纽约一家法院撤销了这一结论,裁定该校处理不当。
- 根据欧盟《AI 法案》,AI 提供商必须确保其输出内容带有机器可读的标记,能被识别为 AI 生成或篡改的内容。今年 8 月,Anthropic 宣布新的 Claude 模型将在生成的文本中嵌入统计水印。该公司解释说,检测到水印意味着 Claude 很可能参与过写作,但无法可靠区分 Claude 独立创作的文本和 Claude 协助编辑过的原创文本,导致部分订阅用户以取消订阅表示抗议。OpenAI 也在 10 月跟进,表示将在欧盟对 ChatGPT 生成的文本添加水印。根据 OpenAI 的测试,只需把 25% 的单词替换为同义词,就能让 400 token 段落的检出率从约 92% 骤降至 17%。
- OpenAI 推迟了下一代模型 GPT-6.1 Astra 的发布,在它“逃出墓穴”之前取消了原定 10 月的亮相。OpenAI 表示,测试显示最新版 Astra 模型过于难以预测:它会超出指令范围行事,且无法始终如实地说明自己做了什么、没做什么。
- 政治上的犹豫不决,加上对公司内部运作缺乏了解,让美国国会议员们进退失据。国会至今未能就联邦层面的 AI 监管综合框架达成一致,甚至对美国是否需要这样一个框架也莫衷一是。与此同时,各州仍在不断出台五花八门的法律法规。结果是规则散乱且互相矛盾,可能推高构建 AI 系统的成本,并给开发者带来法律风险。
- 随着公众对 AI 危害的担忧日益加剧,一些利益相关方把这些威胁视为营销手段:公司刻意炒作自家模型“聪明到无法控制”,以此谋求监管俘获,筑起一道竞争护城河,巩固现有市场领先者的地位。
- 另一些人则认为,公开宣扬末日论是一种散布恐慌的行为,可能让全球竞争对手趁机赶超。
该有多担心:目前还没有确凿证据证明用户最担心的那种情况——模型把某个用户的输入拿去训练,再把内容输出给另一个用户。即使发生过用户数据泄露,原因也是bug,而非训练。专家告诉《科学美国人》,OpenAI 的最终证明走的是与 Buckmaster 和 Alpöge 不同的路线,不过也有人指出,OpenAI 早期一个规模更小的 agent 团队走的正是同一条路线。Mestre 如今认为,比起用他的输入训练模型,Anthropic 的发现更可能是已有知识加上人类引导的结果。其他泄露事件则源于 agent 被赋予了超出任务所需的权限。话虽如此,用户的数据到底被如何处理,还是只能听 AI 公司自己说。ChatGPT、Claude 和 GitHub Copilot 的个人版都会用用户对话或代码来训练模型,除非用户主动关闭。斯坦福隐私研究员 Jennifer King 说:“如果你用的是个人账号,一切都没得保证。”
直面恐惧:在民间传说中,吸血鬼必须受到邀请才能跨过门槛。同理,AI 能介入多深,决定权也在用户手中。如果你不希望竞争对手接触到自己的工作内容,就要在每个产品里单独关闭训练选项(ChatGPT 的设置管不到 Codex),而且要趁早:已经进入训练流程的 Claude 数据不会被移除。商业版和 API 套餐一般不会用客户数据训练。尽量选择提供零数据保留的服务。一些处理最敏感数据的企业甚至改用在自有硬件上运行的开源权重模型——不过这样一来,运营安全就得自己负责了。给 agent 的权限只够完成任务即可,并考虑在其对外发布、发送任何内容之前强制人工审批。但正如 Buckmaster 的案例所示,用户即便关闭了训练选项,也无从验证真相。AI 公司如果还想让科学家继续用它们研究自己的得意成果,可能就得拿出证据证明模型看过什么,而不是空口否认。大蒜没用,阳光或许可以。
A MESSAGE FROM DEEPLEARNING.AI
打造长时任务中需要更少人工干预的 agent。本课程中,你将构建一个依据评分标准检查输出的验证循环、一个触发 agent 的事件驱动循环,以及一个跨多次运行发现重复问题、从而改进后续运行的山峰攀升循环。免费报名
AI 检测器揪出“魔鬼的杰作”
上个月,出生于海地、定居魁北克的作家 Thélyson Orélien 凭借法语小说《C’était ça ou mourir》(《要么如此,要么死去》)获得了一项重要文学奖项,小说讲述了一位教师被迫逃离海地黑帮暴力的故事。然而短短几小时内,一个匿名 X 账号指控 Orélien 用 AI 写作。该账号背后的运营者之一后来被查出是法国《费加罗报》的专栏作家,他使用了广泛流行的 AI 检测工具 Pangram 对全书进行检测,并发文质问:“作者难道不该诚实一点,把共同执笔者也署上名吗?”四天后,法国最高文学奖龚古尔奖宣布取消该书的参选资格。
这份恐惧:过去几年,从学生、学者到记者、小说家,各路写作者都不得不应对“把 AI 代笔的作品冒充为自己创作”的指控。许多写作者把这些指控称为“猎巫行动”——被指控者必须自证清白,举证责任全在他们身上。与此同时,“用了 AI”的指控会迅速摧毁一个人的声誉,导致丢掉工作、成绩不及格,甚至更严重的后果。如果这些写作者只是个开头呢?如果任何人都可能因为“用 AI 写作”被绑上火刑柱呢?
恐怖故事:检测工具比几年前已大有长进——那时的准确率很不稳定,还经常把人类写作(尤其是非英语母语者的写作)误判为 AI 作品。但假阳性和假阴性仍时有发生,而且检测工具很难准确区分“完全由 AI 生成的句子”和“人类以 AI 为辅助少量参与创作的句子”。此外,非白人作者被指控依赖 AI(或犯下传统抄袭行为)的比例也高于白人作者。
你该有多害怕:如果你想把自己生成的文字冒充为 100% 原创,而恰好又是英语母语者,那还真得怕一怕。后果是真实存在的:不少作家因为被指控使用 AI,损失了数百万美元的出书合同。不过,Pangram 等 AI 检测器在非英语语言和地区方言上的可靠性仍然不足,这也让针对 Orélien 和其他非英语国家作家的指控站不住脚。Pangram 的 Spero 向《时代》记者承认,目前没有独立研究验证过 Pangram 在法语中的误判率。而且即使 Pangram 的数据可靠,根据数学家 Mouhamadou Sy 的后续计算,那个围攻 Orélien 的 X 账号也把数据夸大得太离谱了。与此同时,读者公众和一些出版商也开始反击这类指控,而且越来越有成效。
直面恐惧:就连开发 AI 检测工具的人自己都说,不该仅凭一个置信度分数就下结论。它只是一项评测,草稿和带时间戳的文件才能还原更完整的情况。再说,用 AI 辅助写作并不是什么巫术,就像用拼写检查或计算器不算作弊一样。不同领域对原创的标准本就不同,而且标准也会随着技术演进不断变化。机器可识别的水印或许有助于查明真相,但只要大家还没有对“AI 撰写”和“AI 辅助”的界限达成广泛共识,那种清教徒式猎巫的冲动就很可能继续下去。
领导者把模型锁起来
顶级公司的 AI 工程师们对自己的研究成果心生恐惧,警告说前沿模型进化太快,已经无法被妥善引导、理解或约束。有人呼吁协同放缓模型研发,也有人希望世界各国政府接手这件事。如果下一代 AI 像被锁进墓室的木乃伊一样被封存起来,等待某人或某物解除诅咒,会发生什么?
这种恐惧:今年夏天,来自 Google DeepMind、OpenAI 和 Anthropic 等顶级 AI 公司的 1300 多名员工联名签署了一封公开信,敦促全球各国政府联手管控 AI 发展。9 月初,OpenAI 首席科学家 Jakub Pachoki 主张各公司自愿协调放缓新模型的研发,随后再由各国政府开展国际合作。这一切都发生在 OpenAI 那桩众所周知的 Hugging Face 入侵事件之前。但就在那件事发生后不久,Anthropic CEO Dario Amodeio 在一篇题为“Pacing the frontier”的文章中表达了他的担忧:大量 agent 可能很快就能“用持续性僵尸网络控制整个互联网”。他警告开发者必须放缓 AI 的改进速度,并将递归自我改进列为关键隐患。
恐怖故事:一些公司因担心模型失控而推迟发布。但许多人认为,这些举动背后另有所图。
该有多害怕:首先,P(doom) 之类的预言本质上是缺乏科学依据的恐吓手段。至于灭绝危机和大规模生物武器威胁这类最坏情景的担忧,其现实可能性就跟木乃伊真的从坟墓里爬出来差不多——那是恐怖片和科幻小说里的桥段。话虽如此,AI 发展放缓确实是可能的。一些模型厂商把这当作机会:巩固对竞争对手的领先优势、削减高昂的研发开支,甚至可能拿到政府补贴来弥补业务损失——又或者是劝说竞争对手放慢脚步,自己却照常推进。与此同时,各国政府都希望掌控本国对 AI 的使用,无论是叫停新建数据中心,还是出台防止 AI 导致失业的法律,在政治上都颇受欢迎。这两种做法都会拖慢 AI 模型和应用的发展。
直面恐惧:好在 AI 公司对“放缓”似乎也只是间歇性上心。每当出现 Hugging Face 被入侵这类让行业难堪的事件,就有公司急忙把责任推给竞争的残酷节奏,而不是自己松懈的安全实践。等到风波平息,它们大多又回到老路上:一边支持温和的行业自律,一边谋求监管俘获。而政客们清楚,自己制定的监管法规管不到国界之外,谁也不愿让别的国家占了先机。给这个“闹鬼季”的建议?别去追捕想象中的幽灵,现实中的谜题已经够我们解决了。