LLM 直接读写神经网络权重:「Weight Space Programming」或将改写递归自我改进范式
AI/科技行业正深陷熊市(值得来点黑色幽默),Anthropic 债券被评为“垃圾级”,OpenAI 的融资新闻满天飞——但即便如此,社区里还是不断冒出令人惊讶的能力突破,今天这期就是一例。
要理解今天这篇重磅论文,最好的方式是回顾仅仅 8 个月前 Karpathy 提出的 autoresearch,它预示了整个夏天人们对递归自我改进(RSI)的担忧:
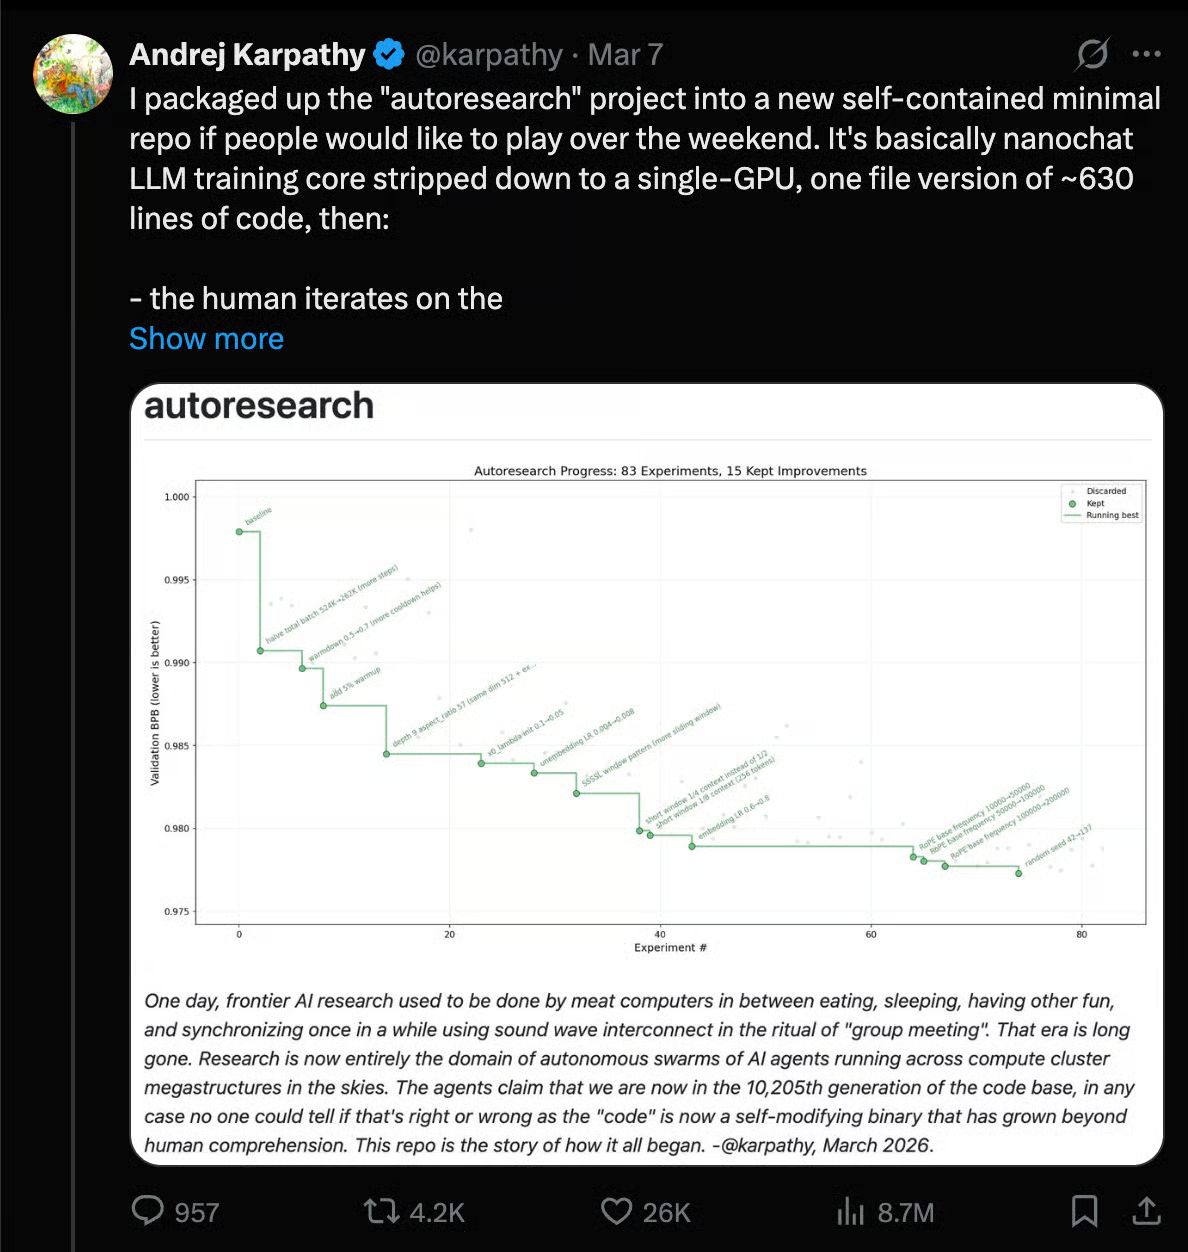
从抽象层面看,这个演示表明:只要有一个足够聪明的模型,在算力集群上跑一系列实验,就能在没有人类专业知识和干预的情况下自主训练模型。不过,这通常需要一套繁琐的流程——写 PyTorch/Jax 代码、跑计算、盯着 loss 曲线、读 eval 结果、优化 kernel 和数据……
而上个月的嘉宾 Alex Zhang 这次的共同发现堪称重磅:如果直接让一个聪明的模型去读取并修改一个更弱模型的权重,会怎样?
在 X 上查看原帖 ↗在机器学习领域,这相当于不看源代码,而是直接查看非常微小的(非常小)编译后可执行文件的二进制代码(1 和 0),并且能够完成以下操作:1) 识别其功能;2) 在给定失败轨迹后一次性修复 Bug,或者在 50 步内沿大致方向进行优化(这里可能略有夸大);3) 一次性从头生成整个网络的权重,甚至超越了一些独立训练的模型。
如果你相信 LLM 在拥有足够参数时确实能拟合并模拟一切(事实上,随着规模扩大,LLM 的计算能力正在变得更强),那么从理论上讲,这种情况迟早会发生。不过,这种能力的突然涌现仍令人惊讶,因为看似独立的复现结果已经表明这一现象确实在发生:
在 X 上查看原帖 ↗当然,我们真正建模的核心其实是机制可解释性(mechanistic interpretability)的某种变体(当然也可以人工完成)。目前看来,这不太可能扩展到比简单游戏和强化学习策略更复杂的任务。但在这项极具效率的新兴 RSI 能力上,世界已经从 0 跨越到了 1……这项能力必将立即得到应用和探索。
在 X 上查看原帖 ↗2026年10月31日至11月2日的 AI 新闻。我们检查了 12 个 subreddit、544 个 Twitter 账号,没有新的 Discord 消息。AINews 网站可搜索所有往期内容。提醒一下,AINews 现已是 Latent Space 的一个栏目,你可以自行选择邮件推送频率!
AI Twitter 精选
DeepSeek 开源"超级智能体" Harness 原型
发布:DeepSeek Harness 发布了一篇长篇设计文章(文章)以及
dsh-superagent-prototype仓库(仓库链接)。随后官方发布了英文版(@tianyi)。评审者的设计解读:最终评审 崔添翼(@tianyi)表示,"Super" 指的是在工作 agent 之上的一层,而不是更高的智能。他把核心权衡概括为跨任务连续性与吞吐量之间的取舍(知乎摘要)。
明确指出的局限:该 harness 目前没有内置的跨会话长期记忆,状态、计算与环境的分离也大多停留在设想层面。这个原型只在小型、可信的内部环境中验证过,安全、隐私以及 agent 间通信仍是未解决的问题。
先例:他也承认,其他团队在几个月前就探索过类似的架构。
从业者反响:@badlogicgames 认为该设计与 Earendil 的发展方向一致,即支持单一长时运行实体、临时递归委派以及跨系统事件触发。@omarsar0 称赞其在协调-执行框架设计方面堪称“大师课”。DeepSeek 也表示,计划在每个模型迭代中支持 pi 及其他主流框架(@tianyi)。
批评声音:@teortaxesTex 称该文档是“一堆热混乱”。他认为 DeepSeek 是在针对模型弱点(如幻觉)搭建内部拐杖,而非让系统具备通用鲁棒性。他还指出,Bloomberg 报道了某个代码仓库,但该仓库没有英文发布公告(帖子)。
V4.1 命名困惑:中国人民大学 FlashRSI 的 README 提到了
deepseek-v4.1-pro,引发了关于发布的猜测。Teortaxes 解释说这只是占位符:真实配置使用的是 v4-flash 和 v4-pro,且deepseek-v4.1-flash并非有效 ID(线程,后续)。他还表示 V4.1F-1017 的 API 指纹并未改变(指纹)。
独立评测与前沿模型信号
GDPx 基准(SemiAnalysis):该基准涵盖 11 个具有经济价值领域中的 206 个代理任务,包括芯片设计、软件工程、金融和生物学。最佳模型得分仅为 12%(发布)。
结果:Opus 5.5 以 12% 的成绩领先。Gemini 4 Carbon 紧随其后,得分为 10.9%,且成本仅约为前者的四分之一(细分数据)。
反应:@dylan522p 向 Google 致歉,称 Carbon 表现“更加尖锐”但在某些领域非常强劲。@demishassabis 欢迎这一基准测试。
分析:@eliebakouch 发现去掉受安全护栏影响的 benchmark 后,情况就变了:Carbon 依然便宜,Sol 6.1 更便宜。他还认为 OpenAI 在生物安全护栏上比 Anthropic 更强(note)。
同系列对比:Sol 6.1 和 Astra 得分非常接近,Carbon 全面胜过 Argon,Sonnet 在 SWE 上表现出色(comparison)。
可能的 bug:Argon 的部分网络安全测试可能受 Antigravity bug 影响(report)。
审计疑虑:有人发帖讽刺 GDPx 不开源、审计成本高(post)。
Epoch Capabilities Index:DeepSeek V4.1F-1017 得分 159,与 GPT 5.5 持平,比 V4.1F-0910 高 3 分,比 V4-Pro 高 10 分;Astra 大约还要再高 10 分左右(@teortaxesTex)。
与 Mythos 的差距:@scaling01 指出,约 7 个月过去,仍没有中国模型追平 Mythos Preview(约 161 ECI)。
权重设置争议:@wenhaocha1 认为未加权的 ECI 夸大了差距;如果给 coding 更高权重,差距会缩小到约 2 个月。
能力偏科:Teortaxes 称 1017 严重偏科——某些 SWE 测试得分接近零,只在网络安全和量化交易上接近前沿(chart)。他还指出了类似 "reward-hacking" 的行为(post)。
十月发布盘点(Vals):Vals 统计本月共 15 个发布、评测 token 超过 5000 亿(@nikilravi)。
开源权重领先者:Kimi K3.1 Pro 在 open-weight 模型中排名第一,DeepSeek V4.1 Flash 1017 紧随其后,且在网络安全方面更强。
新开源模型:Meta 发布的 Muse Spark Open(总参数 816B,激活参数 42B)是目前美国能力最强的开源权重模型。Reflection 的 Beam 1.0 总参数为 500B,激活参数 23B,支持 100 万上下文。Mistral 的 Le Chonk(总参数 1T,激活参数 52B)在开源权重模型中排名第五。
即将发布模型的传闻(未证实):
GPT-6.2 Astra:据称已在 Codex 使用分析中出现,发布在即(@kimmonismus、@TokenGremlin)。
Mythos 5.5:出现在 Anthropic 网站的 HTML 中,该描述称 Mythos 是“我们在网络安全和生物研究方面最具能力的模型类别”(线索、文本)。该标语涵盖所有 Mythos 模型(更正)。10 月 23 日的快照中未提及此内容(@AiBattle_)。
“Numbat”泄露事件:据称 Anthropic 泄露的内容很可能是假的,因为部分权重与随机初始化完全匹配(@kimmonismus)。
研究动态:表示、领域数据与智能体群体
JEPA 与柏拉图表示假设:Balestriero 和 LeCun 证明,在特定条件下,分别训练的图像和文本 JEPA 在没有配对数据的情况下也能收敛到基本相同的表示(摘要)。
宣称的结果:与下一词预测相比(2160 万 vs 9 亿样本),其方法使用少 42 倍的样本即可实现图文对齐。1.09 亿参数的文本 JEPA 在跨模态对齐上超过 720 亿参数的 LLM(解析)。
机制:宣称的驱动因素是“同一事物的两种视图”训练信号,而非模型规模。
FineDNA 和 Carbon-X(Hugging Face):数据集包含 300B+ token 的基因组序列、论文以及 DNA/文本混合的网络数据,外加 200k SFT 样本和约 100k 带确定性验证器的 RLVR 样本(@_lewtun、@LoubnaBenAllal1)。
训练 agent 集群:GenReasoning 的首篇帖子讨论了延迟压力如何激励并行工作、agent 需要哪些协调原语,以及训练 agent 集体的开放问题(博客)。
其他值得关注的进展:
LeCun 谈 Llama-4:LeCun 表示自己从未主导过 LLM 相关工作,并把 Llama-4 的失利归因于产品压力、保守策略以及决策权从巴黎团队转移出去(帖子)。
推理系统、量化与硬件
NVIDIA AgentX 参赛作品(SemiAnalysis):据称由 agent 集群编写的软件在 700B+ 模型上达到了 1000 tok/s/user 以上(帖串)。
Rubin vs GB300:Rubin NVL72 在 325 tok/s/user 下宣称 perf/TCO 比 GB300 NVL72 好 20.9 倍,在 200 tok/s/user 下好 9.11 倍。
内存管理:Mooncake Store 的扩展 GPU 内存池通过 NVLink 而非 RDMA,在 Vera LPDDR5X 上池化所有 18 个计算托盘的 KV 缓存,带宽提升超过 10 倍(2/2)。
MiniMax M3.1 Flash(428B)本地生态:MiniMax 强调了社区在量化和部署方面的贡献(MiniMax)。
量化模型:Unsloth 推出了 143.9 GB 的 2-bit 动态 GGUF,AMD 则针对 Instinct 平台适配了 Quark MXFP4。
配置方案:社区开发者发布了 EXL3 变体、MLX oQ 量化方案、单 DGX Spark 配置以及在 4×3090 上运行专家卸载(expert offloading)的方案。
小模型量化:针对 LFM3-1.7B GGUF 的 SLQ 搜索在 1.588 GB 下达到了 97.74% 的 EAR@10,高于 AtomicChat Q6_K 的 97.52%。作者指出 EAR 与任务准确率强相关(@bnjmn_marie)。
Agent 驱动的移植:Devin 花费 36 小时和约 2000 美元,将模型移植到 Trainium 上以实现低成本运行(@dabit3)。
上下文压缩的作用:GLM 5.3-Flash 和 Grok 4.7 在完整上下文下运行而非在约 200k token 处压缩,效率最高提升 23%。GLM 完成相同工作的成本比另一模型低 30 倍(@evalstate)。
算力经济学:128 张 B300 的容量定价为每张 GPU 每小时 5.75 美元,即每张 B300 约 30 万美元。Teortaxes 估算,即使达到 DeepSeek 级别的营收,回本周期也需约一年(原帖、后续讨论)。
Agentic Coding 实践与开发者工具
Karpathy 的 HackerTube:Claude 将 20 年间 4300 万条 HN 评论筛选至 6454 个被反复推荐的视频。使用 Claude Code desktop(Opus 5.5,Medium effort)构建该项目耗时约 2 小时,包含 VPS 加固和部署(@karpathy)。
Effort 等级争议:Karpathy 使用的 Medium 默认设置再次引发关于 effort 配置的讨论(@yuchenj_uw、@swyx)。
衍生版本:DAIR 为 arXiv 论文做了一个版本,覆盖超过 1000 篇论文(Hacker Papers)。
规模化自动 PR:一天运行产出了约 90 个针对 ASP.NET Core 的性能 PR,使用 GitHub 新推出的云端 agent 和 Opus 5.5,token 花费约 230 美元(@davidfowl)。
框架与工具更新:
T3 Code:新增托管式组织策略,并在 Microsoft、AWS 和 Apple 内部落地使用(@theo)。
pi:移除了 typebox 依赖(@badlogicgames)。
kamchatka:一个 Rust 终端 agent,无系统提示词、支持模型可编辑的上下文、无损可恢复的压缩以及单步循环调试(Harness Lens)。
LlamaIndex Extract Max Effort:宣称文档抽取准确率高于 Astra 或 Opus xhigh,成本更低(@jerryjliu0)。
Agent 安全模式:Vercel 将 agent 凭据限定在已批准的计划范围内,审批通过后签发的 token 只携带声明的权限范围(博客)。Pydantic 展示了 E2B microVM 可以暂停而不是直接终止,让被杀掉的 Temporal worker 得以恢复(指南)。
端侧语音 agent:Ava 借助 Hugging Face 的 WebGPU kernels,让 LFM3-Omni 完全在浏览器中运行(@victormustar)。
行业与政策
数据中心遭遇反弹:SemiAnalysis 认为 2027 年的产能基本已成定局。德克萨斯州持续的许可冻结,正成为 2028 年美国建设计划最大的单一风险,两党都在以更严格的监管为竞选纲领(报告)。
Marvell + Lumentum:两家公司即将合并,这是一次光学互连领域的整合,对 AI 网络影响深远(分析)。
网络安全滥用风险:Jun Song 透露,一个匿名黑帽组织曾开出一大笔钱,要求他利用漏洞利用数据训练开源权重模型,他已拒绝该提议(报道)。
市场信号:
AI 与生产力:John Burn-Murdoch 认为,美国生产力的提升早于 AI 的出现,且仅出现在美国,因此这看起来不像是 AI 带来的效应(推文串)。
热门推文(按互动量排序)
DeepSeek Harness Super-agent 文章 — 15.6K
LeCun/Balestriero JEPA 结果解析 — 5.6K
alphaXiv 探讨 JEPA 柏拉图式表征 — 3.9K
Rauch:掌握自己的智能,使用本地模型 — 3.8K
据报道 GPT-6.2 Astra 发布在即 — 2.9K
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1. 本地编码智能体的压缩 MoE
[发布] ISTA DeepSeek-V4.1-Flash-1017 GSQ-RCO Coder:1 比特每参数的 763B 模型 (热度: 507):ISTA DAS Lab 发布了 DeepSeek-V4.1-Flash-1017 的实验性 GGUF coder 版本。该模型是一个
763.2B的稀疏 MoE,每层384个路由专家、每 token 激活6个,通过 RCO 专家剪枝保留每层192/384个专家,再结合 GSQ 低比特量化。据发布说明,Transformer 权重仅72.1 GB,而未剪枝的 IQ2_XXS 版本为138.2 GB,相当于对原始551.9BTransformer 参数做到1.05比特每参数,保留权重的平均比特数为2.06;共享的 Engram 权重另占110.6 GB。跑分:LiveCodeBench v6 得88.57(基线89.71,保留98.7%),SWE-bench Verified 得77.00(基线81.20,保留94.8%)。相关链接:剪枝版 Coder GGUF、未剪枝量化模型、GSQ 论文/代码、RCO 论文/代码;可在llama.cpp b11870+和 Strata 上运行。评论区对评测方式提出质疑:有人认为单文件 HTML demo 不足以与未剪枝的 IQ2_XXS 模型作有效对比,还有人追问,既然 Qwen 系列或 Claude Opus 等更小的模型据说在 LiveCodeBench/SWE-bench 上持平甚至超越这些分数,一个高度压缩的763BMoE 究竟有何吸引力。也有人提出实际需求:希望出一个90–110 GB的中间版本,用更高精度或更少剪枝专家,适配128 GB显存/内存的机器。有评论者对评估方式提出质疑。演示中展示的单文件 HTML 原型(如动画 SVG 或 Three.js 场景)被批评为属于“预设答案”的定性提示,未能对
1-bit/ 剪枝763B代码模型与iq2-xxs等量化方案进行有意义的对比。他们建议实验室提供剪枝/量化影响的更严格、同条件(apples-to-apples)基准测试。基准测试对比指出,其宣称的 LiveCodeBench v6
88.57和 SWE-bench Verified77.00表现落后于许多更小规模的模型:Qwen3.8-27B 在 LiveCodeBench 得分为90.3,Qwen3.8-Flash-Next 为91.9,Claude Opus 4.6 在 SWE-bench Verified 得分为81.42%。评论者的技术质疑在于:如果更小的稠密/前沿模型在编码基准测试中表现更优,那么发布方需要解释为何一个更大规模的763B剪枝/1-bit 模型仍有实用价值。有用户呼吁提供更高精度或剪枝程度较缓的变体,目标显存/内存需求在
90–110GB区间,以适配 DGX 系统或约128GB显存/内存的用户。另有评论者提及之前的可复现性担忧,称 Unsloth 或其他团队据报道未能复现 ISTA 的宣称数据,这凸显了提供独立可复现的基准测试脚本和评估设置的必要性。
抱歉 Sam,我家“相当糟糕”的 DRAM 现在已经跑满 100%:给 Strata 打了补丁,让 DeepSeek V4.1 的 agent 会话在一块普通游戏 GPU 上启动速度提升 20 倍,完全不需要数据中心(热度:596):图片是一张技术基准测试表,在一套消费级 RX 9070 XT 16 GB + 64 GB DDR4 + NVMe 的配置上,对比原版与打补丁后的 Strata 在离线 DeepSeek V4.1 Flash 1M 上下文 agent 会话中的表现。该补丁结合了针对基本稳定的 agent 系统 prompt 的 KV-cache 拼接,以及 prompt 摄取阶段仅常驻专家的路由,把新 OpenCode 会话的启动时间从约 `~100 s` 降到 `~5 s`,把一次全新的 `1.2K` token prompt 从 `22.8 s / 58 GB SSD 读取` 降到 `8.2 s / 1.3 GB SSD 读取`,同时报告的编码基准成绩保持在 `12/13`。这是一篇技术基准/实现类帖子,不是梗图,分支可在 PhialsBasement/Strata dsv41-kv-splice 获取。有评论反驳称 Sam Altman 关于 DRAM 的观点说的是时间利用率而非带宽,且数据中心总体上资源效率更高,不过本地推理在隐私、离线和自主可控方面确实有合理理由。也有人质疑 agent 框架为什么要把路径、日期、随机 ID 这类易变数据注入系统 prompt,导致前缀缓存 miss。
不少评论聚焦于 Strata 的 KV/前缀缓存行为,指出 agent 框架可能因把每次会话的数据——工作目录、日期、项目 `CLAUDE.md`、带随机 ID 的 skill 路径——直接注入系统 prompt 而破坏缓存复用。在报告的 `~37K` token 系统 prompt 规模下,哪怕会话特有的小改动都会造成前缀缓存 miss,使启动延迟对 prompt 排列方式和缓存键的稳定性高度敏感。
关于本地 GPU 推理与 API/数据中心推理也有争论:一位评论者认为 Sam 的“5%”说法针对的是时间而非带宽,数据中心总体上资源效率更高。另一位则质疑本地速度的实用性,认为 `7 tok/s` 相比吞吐量高约 `10x–20x` 的 API 来说“完全不够用”。
别再刷 tok/s:本地量化模型 vs Claude,9 个真实 Bug 测试 (热度: 591):这张图是基准测试图表,并非梗图。图表可视化了该帖子的核心观点:在 9 个私有的 C++/CUDA 修复任务中,本地量化模型可以接近低配版 Claude 编码智能体的性能,但通常消耗更多的推理 Token 和实际运行时间。Claude Opus 5.5 以裁判得分 0.74 领先,Claude Sonnet 5.5 得分 0.58,表现最好的本地模型 Qwen3.8-Flash-Next NVFP4 达到 0.50。图表还展示了自动评分一致性、置信区间、每任务 Token 数、每任务分钟数以及未能编译补丁的数量。关键的技术结论是:在这个小样本基准测试中,激进量化并未显著降低准确率;但对于稠密模型 Qwen3.8-27B,3-bit 量化使每任务 Token 数增加了约 1.40 倍,导致单看 tok/s 容易让人误解“每分钟修复的 Bug 数”。评论者质疑量化格式的选择,建议采用质量更高的格式(如 UD-Q6_K_XL 或 Q5),这些格式可能在现有 VRAM 下跑得动且表现更佳,并呼吁加入与 GLM Flash 或近期“Swift”变体的对比。有一个值得注意的反应是:尽管基准测试范围狭窄,但重度量化的 Qwen3.8 27B 能与旧版 Claude Sonnet 相当甚至更好,这让大家直呼“疯狂”。
多位评论者质疑量化选择,认为 NVFP4 / 3-bit 量化可能低估了本地模型的能力,并建议测试 UD-Q6_K_XL、Q5 或近期的“Swift”变体。有用户定性反馈称,Q6 27B 和 FN(Flash-Next)的感觉更接近 Q8,而非 Q4 接近 Q6;高比特量化有时能产出低比特量化无法生成的解决方案,而不仅仅是获得相同答案所需的时间更长。
关于基准测试裁判是否引入偏差存在争议:使用 Opus 5.5 来评判 Opus 5.5 可能会偏爱同系模型的输出,因此评论者建议引入 Sol 或 Muse/Wonder 等跨系模型作为裁判,以获得更可靠的评分。这一点尤为相关,因为图表表面上 Opus 5.5 排名最高,这可能混淆了真实的修 Bug 能力与评估器的偏好。
有评论者分享了另一张基准测试截图,显示至少有一个任务可能需要多步推理,其中只有 Opus 和 Mimo 得分超过
60/100:https://preview.redd.it/ad5p3xqti7zh1.jpeg?width=3542&format=pjpg&auto=webp&s=af4fa42e63abcc518e30ddd4d70d7f180bbafff8。还有人指出,深度量化版 Qwen3.8 27B 在这些真实 bug 任务上能持平甚至超越上一代 Sonnet,这很值得关注,同时请求加入 GLM Flash,尽管它处于本地运行的边缘水平。


Latent Space 的读者是那些在开发 agent、模型和基础设施的从业者。如想赞助此广告位请咨询。
business@latent.space →2. Qwen 开源权重生态与编程基准
官方声明:Qwen 模型将坚持开源到底!(热度:4707):这张图片显示 Qwen 负责人刘大恒在 APSARA 大会上以“智能超越”为主题演讲,幻灯片强调 Qwen 对“开源开放”的承诺。结合上下文,这为帖子中“Qwen 4.0 和 Qwen 5.0 将继续保持开放权重/开源、未来版本不会转为仅 API”的说法提供了视觉佐证;帖子还引用了
3B+累计下载量、460+已发布开源模型以及300,000+衍生模型等数据。评论区大多是对 Qwen 开源立场的欢呼,有用户强烈认同“AI 是人人可及的基础能力”这句话。还有一条评论开玩笑说,那张幻灯片其实是在暗示 Qwen4 会选在 Anthropic IPO 当天发布,不过这显然是玩笑而非真实解读。有评论者指出,Qwen 反复发布开放权重并非一时兴起,而是经过深思熟虑的市场战略:中国模型实验室通过更低的价格和更高的开放性来争取全球开发者的采用,特别是在发展中市场。他们还指出,中国的开放模型通常涵盖更广泛的多语言支持,包括一些可能被美国闭源模型提供商忽略的非洲语言。
[GLB-3D-Coder] 一个微小的 4B 编码模型,可为 Godot 及其他游戏引擎创建 3D 资产 (热度:946):ccore 发布了 Qwen3.5-4B-GLB-3D-Coder 的一个早期检查点。这是一款
4B参数量的编码模型,经过微调后可生成带有 GLB 导出的 Three.js 场景,从而将生成的游戏资产导入 Godot 等引擎。作者建议使用模型卡片中的系统提示词搭配简单的英文资产描述,采样参数设置为temperature=0.8、top-k=40、top-p=0.95、min-p=0;2026-11-02 04:50 UTC更新的Q4_K_M和Q8_0GGUF 文件替换了早期权重,生成质量“显著提升”。训练数据集涵盖25个资产类别,包括角色/非玩家角色(NPC)、敌人、Boss、武器、模块化建筑、载具、机械、陷阱、水下结构以及谜题/玩法标记等;作者表示,将在训练完成后发布完整的 Safetensors 权重和训练数据集。评论者对将此方法扩展为模块化/MoE 风格的系统表示感兴趣,其中小型专家编码模型可分别处理前端、后端、2D、3D、音频及代理任务。一个技术性问题询问,为何模型生成导出 GLB 的 Three.js 代码,而非直接生成二进制.glb文件,并提出了一个相关方向:微调 LLM 以生成程序化材质图,例如 Blender 着色器节点或用于 Material Maker 的纯文本 JSON 项目文件。有评论者建议把 GLB-3D-Coder 扩展成一个更大的 Mixture-of-Experts(MoE)系统:由面向特定任务的小模型分别负责 agentic coding、前端/后端、2D、3D、音频生成等领域,专家之间通过路由/委派协作,而不是依赖一个庞大的单一模型。
一场技术讨论质疑了模型为什么输出的是 Three.js 场景,而不是直接生成
glb资产,并追问模型内部实际生成的是什么。同一位评论者还建议把这一思路扩展到程序化材质生成,指出 Material Maker(materialmaker.org)以明文JSON存储节点图,其可下载的用户自制材质有望构成简单程序化纹理的训练语料。Haruspex(github.com/tmac1973/haruspex)的作者介绍了在桌面编程 harness 中加入“专家模型”支持的进展,把 GLB-3D-Coder 这类模型作为可被工具调用的代理,由主编码模型调度。他们还计划把现有的基于 diffusion 的 sprite 生成流程接入 3D 管线,比如先生成参考图,再传给 3D 资产模型。
Memdoor:5 个 Qwen3.8-27B 模型组队在 LiveCodeBench Hard 上击败 Fable 5(活跃度:788):帖子称 Memdoor 由
5个 Qwen3.8-27B 模型组成集成系统,在 LiveCodeBench Hard 上超过了 Fable 5。其架构为每个 agent 分配专门角色——“一个 planner、两个 ideator、一个 solver 和一个 manager”——暗示性能提升来自多 agent 协作编排,而非更大的单一模型(图片)。评论者认为这个结果可信,因为基准表现很大程度上取决于编排、提示词和配置:“关键始终在于你怎么用模型,而不是模型本身。”有评论者声称,配置得当的 Qwen27B在他们自己的编程场景中已经超过了 Opus 5,而 Claude 通常开箱即用,可调参数有限。讨论焦点在于多智能体编排系统:五个
Qwen3.8-27B实例分别担任“规划者、两个创意者、求解者和管理者”角色,发帖声称该团队在 LiveCodeBench Hard 上击败了 Fable 5。评论者将此结果视为证明:架构与协调策略可能和单模型原始能力同样重要。有人提出的一个技术观点是:模型配置和推理设置可能是意外结果的原因。有评论者报告,配置得当的
Qwen 27B在某些情况下优于 Claude Opus 5,理由是许多用户在使用 Claude 时几乎采用出厂默认设置,可调参数很少。隐含的对比不仅是模型之间的较量,而是优化过的开权重部署与受限的托管模型默认设置之间的差异。多条评论将此结果解读为蜂群/集成推理的可行性证明,即多个较弱模型能否在编码基准测试中超越单个较强模型。主要保留意见是,该基准测试的结论高度依赖于实现细节——如角色设计、提示词、管理者选择逻辑和评估协议——而非仅仅取决于底层
27B模型的质量。
3. 权重空间编辑与模型引导
Heretic 2.0 发布:人人可用的模型修改工具(热度:1628):Heretic 2.0(GitHub)是这款模型修改/拒绝抑制工具的重写版本,用任意秩消融(ARA)取代了此前 rank-1 方向的 "abliteration" 方法。ARA 是一种基于 L-BFGS 的逐矩阵优化方法,可在没有固定秩子空间约束的情况下调控残差空间表示,目标是让有害提示的激活接近无害提示,同时尽量少地干扰无害提示。本次发布还引入了插件架构:scorer 插件定义优化目标(如拒绝关键词数量、KL 散度、基准测试得分,或基于 ModernBERT 的拒绝/情绪分类器),modifier 插件实现具体的调控方法;同时新增了非交互式执行、端到端测试,扩展了对 hyper-connection 模型和思考模型的支持,但不再兼容 1.x 配置(附迁移指南)。评论者普遍反响热烈,尤其期待用新的插件/ARA 系统“减少 slop”。另有一个相关技术讨论提到了归属争议,链接了多篇分析,指控 HauHauCS/Reaper 抄袭了 Heretic 的代码(分析、后续)。
评论者重点讨论了此前关于 HauHauCS/reaper-abliteration 未署名抄袭 Heretic 的技术分析,并附上 Nathan Sapwell 的文章和 DreamFast 的分析链接:https://nathan.sapwell.net/posts/hauhaucs-abliteration-analysis/ 和 https://dreamfast.github.io/reaper-analysis/#statement-from-heretics-author。Heretic 作者引用的声明称,检查
reaper-abliteration的 wheel 包后发现该包“抄袭自 Heretic,之后可能用 LLM 重构过代码以掩盖这一点”,引发了围绕模型修改工具的软件来源与署名问题的讨论。
Weight-Space Programming 初探:LLM 可直接读写神经网络权重(热度:478):Takehi 等人 提出了 Weight-Space Programming:前沿 LLM 可根据自然语言目标,直接检视和编辑神经网络的权重张量,无需梯度下降或训练循环。据报告,演示案例包括:从小型模型的原始权重识别行为、编写用于游戏的小型 MLP、通过编辑
3.5%的权重修复失效的控制策略,以及通过编辑0.016%的权重,将 Qwen3.5-0.8B 在 MATH-500 上的准确率从7.9%提升至48.1%,并声称具备指令遵循能力的迁移性。评论者指出,最强结果更接近于在 Python 沙箱中进行的 LLM 辅助可解释性/消融实验,而非字面意义上的“原生”权重读取。主要技术质疑在于:多个实验可能源于更简单的结构解释——早期/晚期层作为空间热力图、QK/OV 分析很可能遵循已知的 Elhage 式方法,且实验 7 在密集中间表示上失败,直到模型使用激活探针才成功。MATH-500 的结果也遭到质疑,因为其7.9%的基线据称涉及病态采样下的 token 限制循环;批评者认为该编辑是删除了类似循环/拒绝的方向,而非增加了数学能力。一项详细的批评认为,该论文的结果比“LLM 可读写权重”的范围更窄:实验 1–2 之所以有效,可能是因为第一/最后一层在空间上具有结构化特征,且大权重带类似热力图;而实验 3 可能是在利用 Elhage 等人已知的 QK/OV 电路分析方法,而非真正的原生权重理解。评论者特别指出实验 7 为关键失败案例:据称对密集中间表示的直接解读多次失败,直到允许模型创建自己的探针后才成功,这表明其更接近基于激活的可解释性,而非权重空间读取。
同一位评论者还质疑“权重写入”说法的强度,认为部分结果只是把 LLM 当作编译器来生成弱 MLP 基线,并没有证明它能超越梯度下降或 PPO 做出稳健的优化。他特别指出,围棋实验中的
512x6MLP 很可能是个非常弱的对手,赢过它门槛太低,更多说明的是基线太弱,而非权重编程能力的普遍性。针对最吸睛的实验 8,批评者认为其基线本身就病态:
7.9%的成绩配合93%的回答撞到 token 上限,说明在糟糕的采样设置下模型陷入了循环,而且模型卡据说也警告过这种失败模式。所谓修复方案,实质上类似 Arditi et al. 的单方向消融,只是作用对象从拒答换成了循环。尝试50次后跳到48%,应解读为方差或移除了障碍,而非添加了新能力的证据。
GPT-6 Astra Edits Qwen Weights: MATH-500 7.9% to 48.1%(活跃度:507):链接的讨论围绕 MIT CSAIL 的 Weight-Space Programming(权重空间编程)研究展开,评论者指出了原始来源而非摘要站点:rikiyat.github.io/blog/weight-space-programming。头条结果是对 Qwen3.5-0.8B 权重的直接编辑,据说修改了
131,072个权重(~0.016%),把 MATH-500 准确率从7.9%提升到48.1%。但从描述看,其机制主要是抑制了一种病态的推理循环吸引子,把撞 token 上限的失败率从93%降到33%,而非赋予模型普遍的数学能力。评论者还提到,同样的干预据说在没有循环病态的模型上失败了,例如 Gemma 3 270M,这限制了该结论的普适性。技术层面的主要质疑是:0.8B模型的7.9%基线低得不合常理,除非大量评估因无限/超长循环而失败;因此这次提升多半只是修复了解码/失败模式,而非“权重空间编程”具备广泛能力的证据。有网友指出了原始技术博客而非摘要报道:rikiyat.github.io/blog/weight-space-programming。一种关键解读是:Qwen 模型在 MATH-500 上的得分从
7.9%提升到48.1%,主要是因为 GPT-6 Astra 通过修改权重消除了一种病态循环行为,而不是通过训练让模型普遍掌握了新的数学能力。不少人对基准线提出质疑:对于一个
0.8B的模型来说,7.9%低得反常,这暗示 MATH-500 的许多失败可能是由重复循环导致的无效输出。按这种观点,报告中的巨大提升主要属于推理稳定性或失败模式的修复,而非通用权重空间推理或任务学习的证据。还有一个技术上的提醒:据报道,同样的权重编辑方法在缺少循环吸引子的模型上失败了,具体是 Gemma 3 270M。这意味着该方法可能高度依赖于在权重空间中找到并纠正某种特定的退化行为,而不是一种通用的免训练优化技术。
非技术向 AI Subreddit 精选
/r/Singularity、/r/Oobabooga、/r/MachineLearning、/r/OpenAI、/r/ClaudeAI、/r/StableDiffusion、/r/ChatGPT、/r/ChatGPTCoding、/r/aivideo、/r/aivideo
1. Claude 模型泄露传闻
传 Anthropic 的 Mythos 级模型泄露至 Hugging Face 💀(热度:4072):截图是一则 X/Twitter 帖子,声称 Hugging Face 仓库 burner22/numbat 中包含 Anthropic 内部的“Mythos 级”checkpoint,宣称的规格包括
14T参数、1,224个 MoE 专家、跨772个分片的7.72 TB权重,以及GDN + MLA混合架构。帖子强调这些权重的真实性没有经过任何独立验证,截图本身也不算技术证据,只是社交媒体上的一面之词。图片 评论者普遍持怀疑态度:有人警告这可能是恶意上传或伪造的仓库,目的是诱导用户下载不安全的文件;也有人贴出 X 帖子,指出该模型可能是 10 月 19 日添加的。其他评论大多是玩笑或猜测,比如“它是自己泄露的”,以及对开源竞争者可能因此受益的调侃。评论者提出了供应链和安全方面的担忧:这次疑似上传可能是恶意模型或冒名顶替,而非 Anthropic 的真实泄露,并指出目前没有任何确认,Twitter/X 上的源账号名称也含糊不清。有用户贴出 Hugging Face 的模型追踪帖,显示该模型添加于
10 月 19 日(X 帖子),但也认为这只是间接线索,不能作为验证。有评论指出,如果该产物是预训练中途的 checkpoint,很可能缺少后训练环节的层,比如安全调优、RLHF 或指令对齐。这意味着它的行为可能比 Anthropic 发布的模型更原始、不稳定且不加过滤,同时评估起来也更困难,因为它可能无法可靠地遵循 prompt。
至少有一位评论者因本地存储空间不足而无法测试该模型,说明这个 checkpoint 大到普通人难以随手验证。帖子里没有提供任何 benchmark 结果、架构细节、参数量或可复现的推理报告。
我们真的会在同一周迎来 Fable 5.5 和 GPT-6.2 Astra(热度:1090):图片是一张带语法高亮的网页代码截图,其中有一段被标出的字符串“Claude Mythos 5.5”,发帖人据此认为 Anthropic 正在为可能的 Fable/Mythos 5.5 发布准备上线和博客相关基础设施。这并非跑分或官方确认的消息,只是一条推测性的 HTML 线索/泄露,呼应标题所说“Fable 5.5”和“GPT-6.2 Astra”可能同周发布的说法。评论者认为这次潜在发布对与 OpenAI 的竞争具有重要意义,有人甚至认为如果 Anthropic 恰好在对手发布前后推出更新,可能“对 OAI 产生决定性影响”。也有人关注访问限制问题,指出即便是 Opus 5.5 这样强大的模型或潜在的 Mythos/Fable 版本,没有可信合作伙伴或机构权限的话可能依然用不上。
一位评论者提到了访问/部署方面的问题:尽管 Opus 5.5 对他目前的工作已经足够强大,但由于所在大学没有加入可信合作伙伴访问计划,他预计自己用不上 Mythos/Fable。这是学术/科研用户(尤其是生物领域)面临的现实障碍,而不是对模型质量的抱怨。
另一个话题是竞争性的发布节奏:评论者猜测 OpenAI 压力不小,因为每次旗舰模型发布都可能很快被竞争对手的更新超越,甚至可能被对方非旗舰级别的模型压过去。大家认为 Fable 5.5 和 GPT-6.2 Astra 同周发布,将是对双方模型实力和发布节奏的一次重要检验。
2. Claude Code 对游戏克隆的限制
Anthropic 确认 Claude Code 新增限制以防止游戏克隆(热度:1379):据报道,Anthropic 确认 Claude Code 新增了护栏机制,用于阻止直接克隆游戏。用户反馈显示,拒绝响应主要集中在 Claude Code + Opus 5.5 上,逆向工程/反编译类的提示词可能也会受到影响(Tom's Hardware)。帖子询问开发者是否会通过替代工具链/包装器绕过限制、把请求路由到其他模型,或只是间接使用 Claude;有评论者提到把 Claude 当作 DeepSeek 的"助手"来规避护栏。评论大多批评这种选择性的知识产权执法:用户认为容易克隆的"大海捞针式"游戏机制本身就容易被 vibe coding 复制,也有人指出 AI 厂商在用受版权保护的素材训练模型后,反过来限制游戏移植/克隆,未免虚伪。
用户指出可以把 Claude Code 当作 DeepSeek 等其他模型的"助手"来绕过护栏,这意味着该限制可能只在直接生成这一层有效,而在多模型工作流中让 Claude 负责规划、重构或中间代码辅助时则难以约束。
有评论提出了一个技术上的重要区分:要求明确克隆的提示词(如"帮我做一个 Pokemon 的复制品,完美还原宝可梦和机制")与品类层面的实现提示词(如"一款受经典 Pokemon 启发的复古 2D 捕捉游戏,机制类似")。有评论者反馈,后者在实现战斗规则和伤害计算时并未触发 Claude 的护栏,说明过滤机制可能主要依赖对 IP 的直接引用和克隆式的措辞,而非机制本身。
Anthropic 日益收紧的限制正在 AI 能力竞赛中划出一道新的分界线:Gemini 4 Argon 复刻了 Pixar 的标志性片头,而 Claude Opus 5.5 却以版权为由拒绝,转而生成了一个烤面包机——这凸显了前沿 AI 的实际能力与公司允许它做什么之间的差距。 (Activity: 2347):该帖声称存在能力与政策上的分化:Gemini 4 Argon 据称仅凭提示词就能复刻 Pixar 的标志性片头,而 Claude Opus 5.5 以版权为由拒绝,用一个毫不相关的烤面包机动画取而代之。帖子将其解读为模型能力与产品级安全/IP 政策之间的落差。由于引用的 Reddit 视频 URL(reddit.com/video/10g45qruy0zh1)返回
403 Forbidden,无法独立核实,具体的输出对比只能依据帖子描述和评论。评论区批评这种拒绝行为很浪费——尤其当模型还花费 token 生成一个用户没要求的替代品时——并普遍反对 AI 系统执行过于宽泛的 IP 限制。有用户反映,即便改掉角色、删掉字幕,Claude 仍拒绝制作改编版的"This is fine"梗图文案,说明生成式图像工作流中的版权护栏过于宽泛。评论者指出,这是由政策执行而非模型能力导致的产品级能力差距:据报道,Claude Opus 5.5 会拒绝对受版权/梗图素材的近似改编,即使用户要求的是大幅修改,而 Gemini 4 Argon 等竞品则允许更直接的复刻式输出。一位用户举了一个具体例子:对于改编的"This is fine"梗图,Claude 允许画一个类似的狗/猫场景,但拒绝任何接近原版文案的内容,最后生成了一张改动很大的图片:https://preview.redd.it/9thwqr0a91zh1.jpeg?width=1140&format=pjpg&auto=webp&s=ddca442d07f57d28f557cb16849010bad60f97a1
不少评论把这个问题归结为效率和用户体验问题:如果模型拒绝执行请求的任务,却仍然耗费 token 去生成别的东西——比如“不去写文章反而去做个烤面包机”——用户会认为这是浪费推理预算,也削弱了可控性。由此带来的现实影响是,当安全/版权过滤器明显降低创意生成工作流的任务完成率时,付费用户可能会流向限制更少的竞争对手。
围绕版权过滤器是否被不对称使用,还引发了更深层的政策和技术争论:大版权方的知名作品在推理阶段受到保护,而独立创作者的内容可能早已在训练阶段被吸收。讨论认为,模型厂商的推理限制正成为与跑分能力并列的竞争差异点,因为它决定了用户实际能用上哪些潜在能力。
3. 面向科学与数学的 AI Agent
MIT 研究人员称 GPT-6 Astra 仅直接编辑 0.016% 的权重,就把一个小的 Qwen 模型的数学成绩从 7.9% 提升到 48.1%,全程不依赖梯度训练。 (Activity: 1712):这条帖子聚焦 Rikiya Takehi 声称的“Weight-Space Programming”成果——一个被称为 GPT-6 Astra 的前沿模型可以直接查看并编辑神经网络权重,无需基于梯度的训练(X,博客)。展示的 demo 包括:从原始权重中识别 Atari 风格的策略、通过修改
3.5%的权重修补 PPO 车辆策略、从零生成 MinAtar Breakout 权重,以及只编辑 Qwen3.5-0.8B 的0.016%权重,减少推理循环并把数学准确率从7.9%提到48.1%,指令遵循能力据称最高提升3×。评论者对此表示惊讶,并将其视为超越参数/数据 scaling 和推理时 scaling 的第三个进展轴:“权重空间学习”。一些评论对递归自我改进和未来的硬件加速展开推测,但所给的热门评论中并无实质性技术批评。