英伟达全新 Nemotron 模型的运作原理
有些集成属于整个公司:比如共享的 Slack 机器人、团队级分析 API key、服务器到服务器的凭证。如果要求每个用户都绑定自己的账号,就会导致 token 重复、配置烂尾,而且每来一个新人都得提交一次支持工单。
WorkOS Pipes 帮你搞定 OAuth 和 token 存储,让产品轻松接入 300+ 种集成。借助 Connection Sharing,组织管理员只需在开箱即用的 Pipes Admin 组件里连接一次服务提供商,所有活跃成员就能立即使用。凭证保存在组织级别,绝不会发送到浏览器。
Nemotron 是 Nvidia 推出的一系列大语言模型(LLM)。
Nvidia 工程团队在构建 Nemotron 时有一个核心设计理念:打造一个容量出色但计算和内存开销更低的优秀语言模型。为此,他们将多种类型的神经网络层组合在一起,让每个 token 只激活部分参数,并对模型的答案生成过程做了优化。
本文将介绍 Nemotron 的工作原理,以及 Nvidia 在构建过程中使用的各种技术。内容涵盖:
Nemotron 如何生成文本
Transformer 模型的资源消耗在哪里
Nvidia 的 Nemotron 如何降低成本
Nemotron 如何使用 Mamba 和 MoE
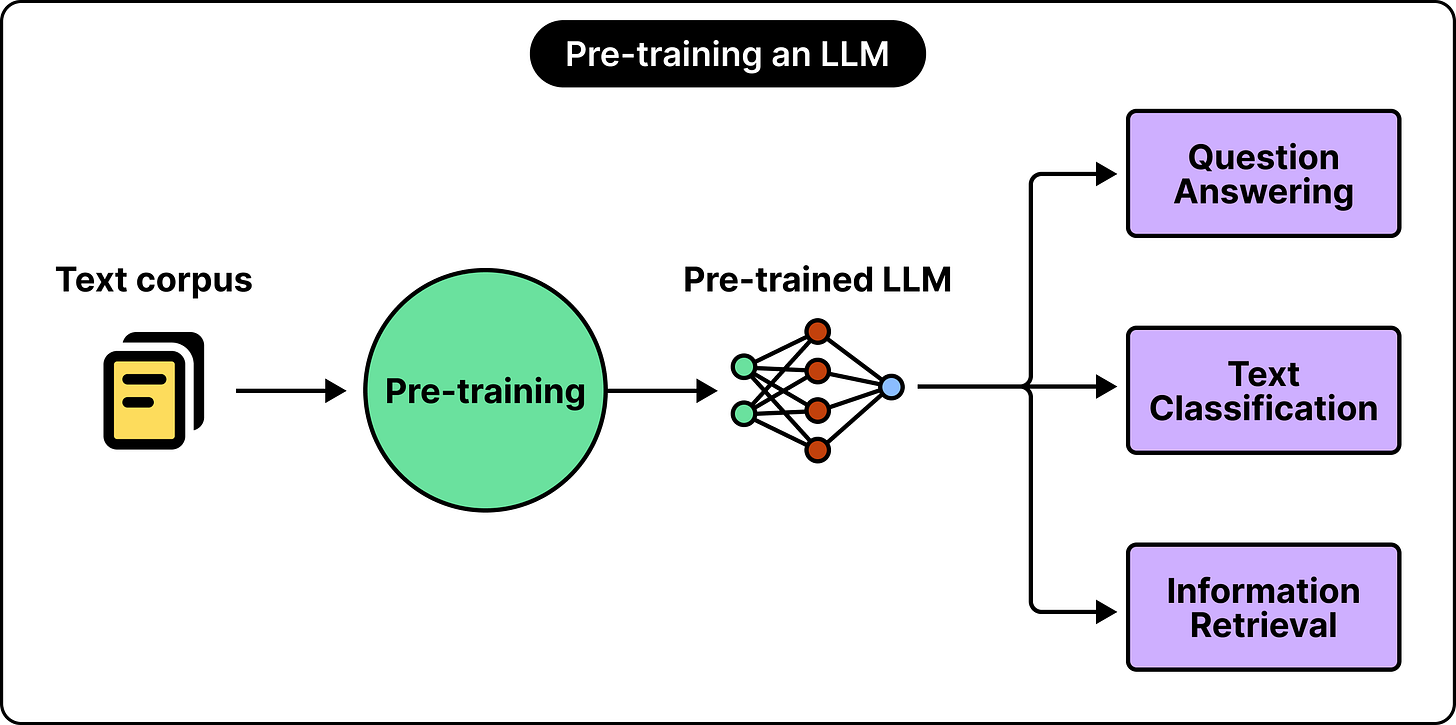
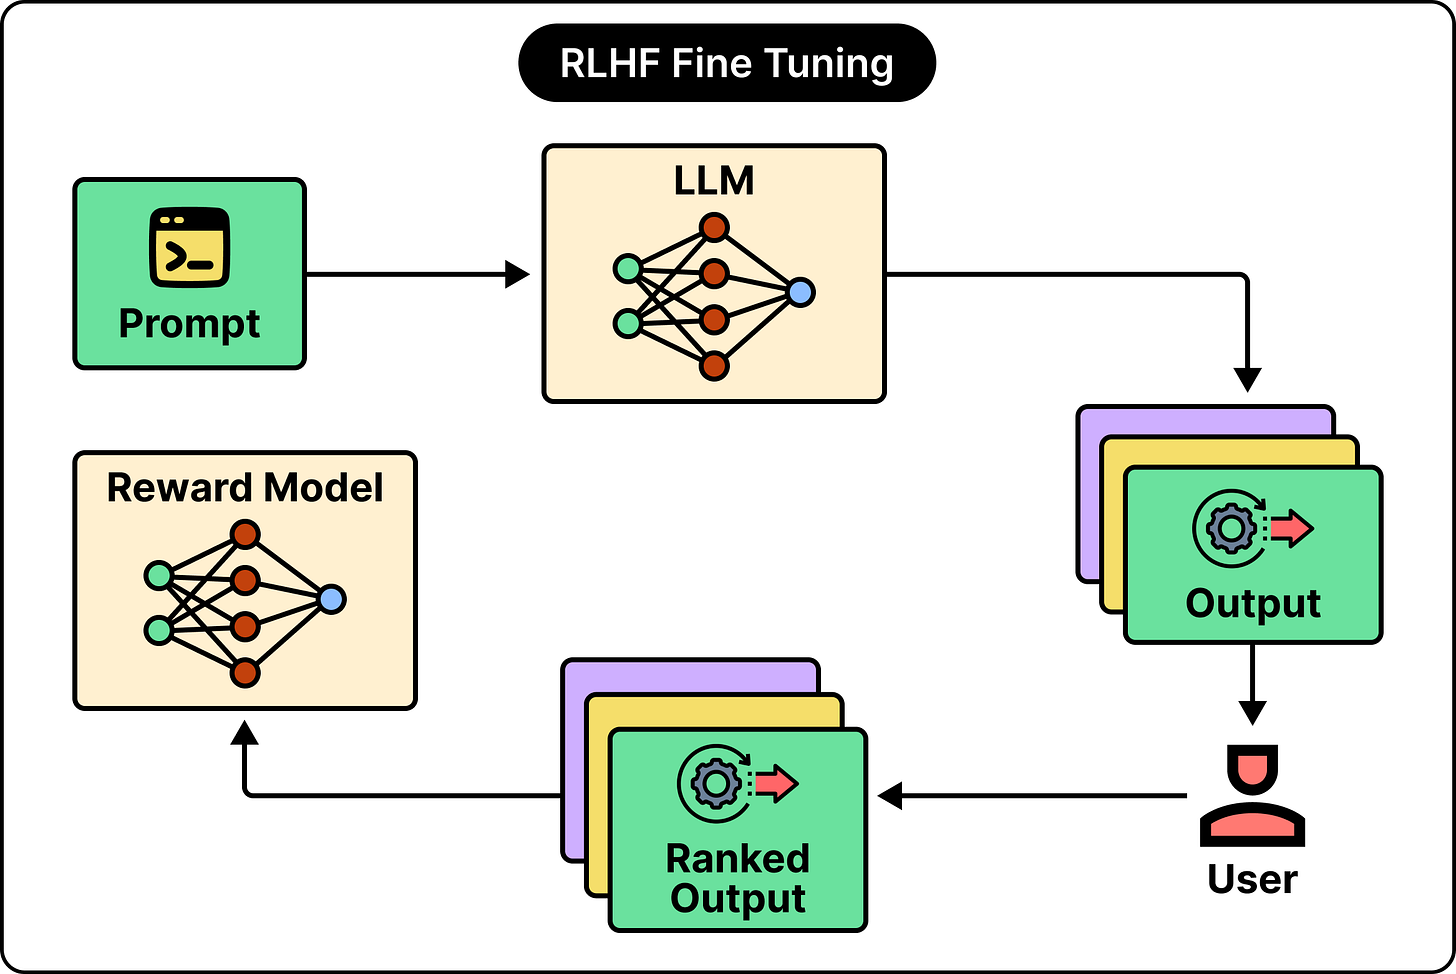
Nvidia 如何训练模型
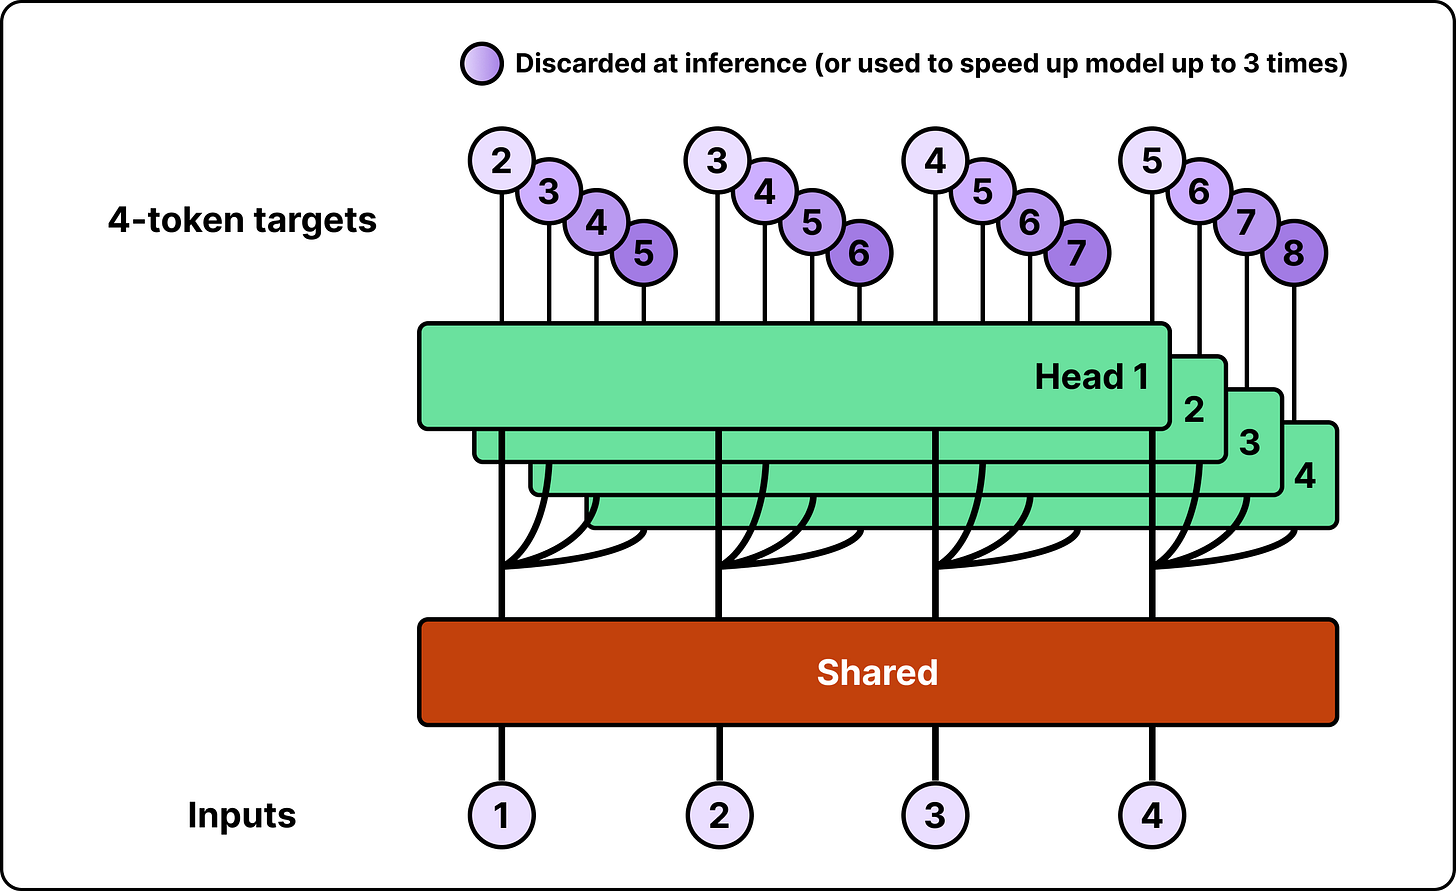
Nvidia 如何运用多 token 预测
Nvidia 如何压缩模型存储
免责声明:本文基于公开资料整理,参考资料见文末。如有不准确之处,欢迎留言指正。
Nemotron 如何生成文本
Nemotron 是一个基于 Transformer 的 LLM,所以它的工作方式与其他 LLM 基本相同。
在典型的 LLM 中,用户向模型发送一段输入文本,文本会被切分成 token——可以是单词、词的一部分、标点或其他文本片段。处理时,模型把每个 token 转换成称为 embedding 的数值表示,然后让这些 embedding 依次通过一连串的层进行处理。
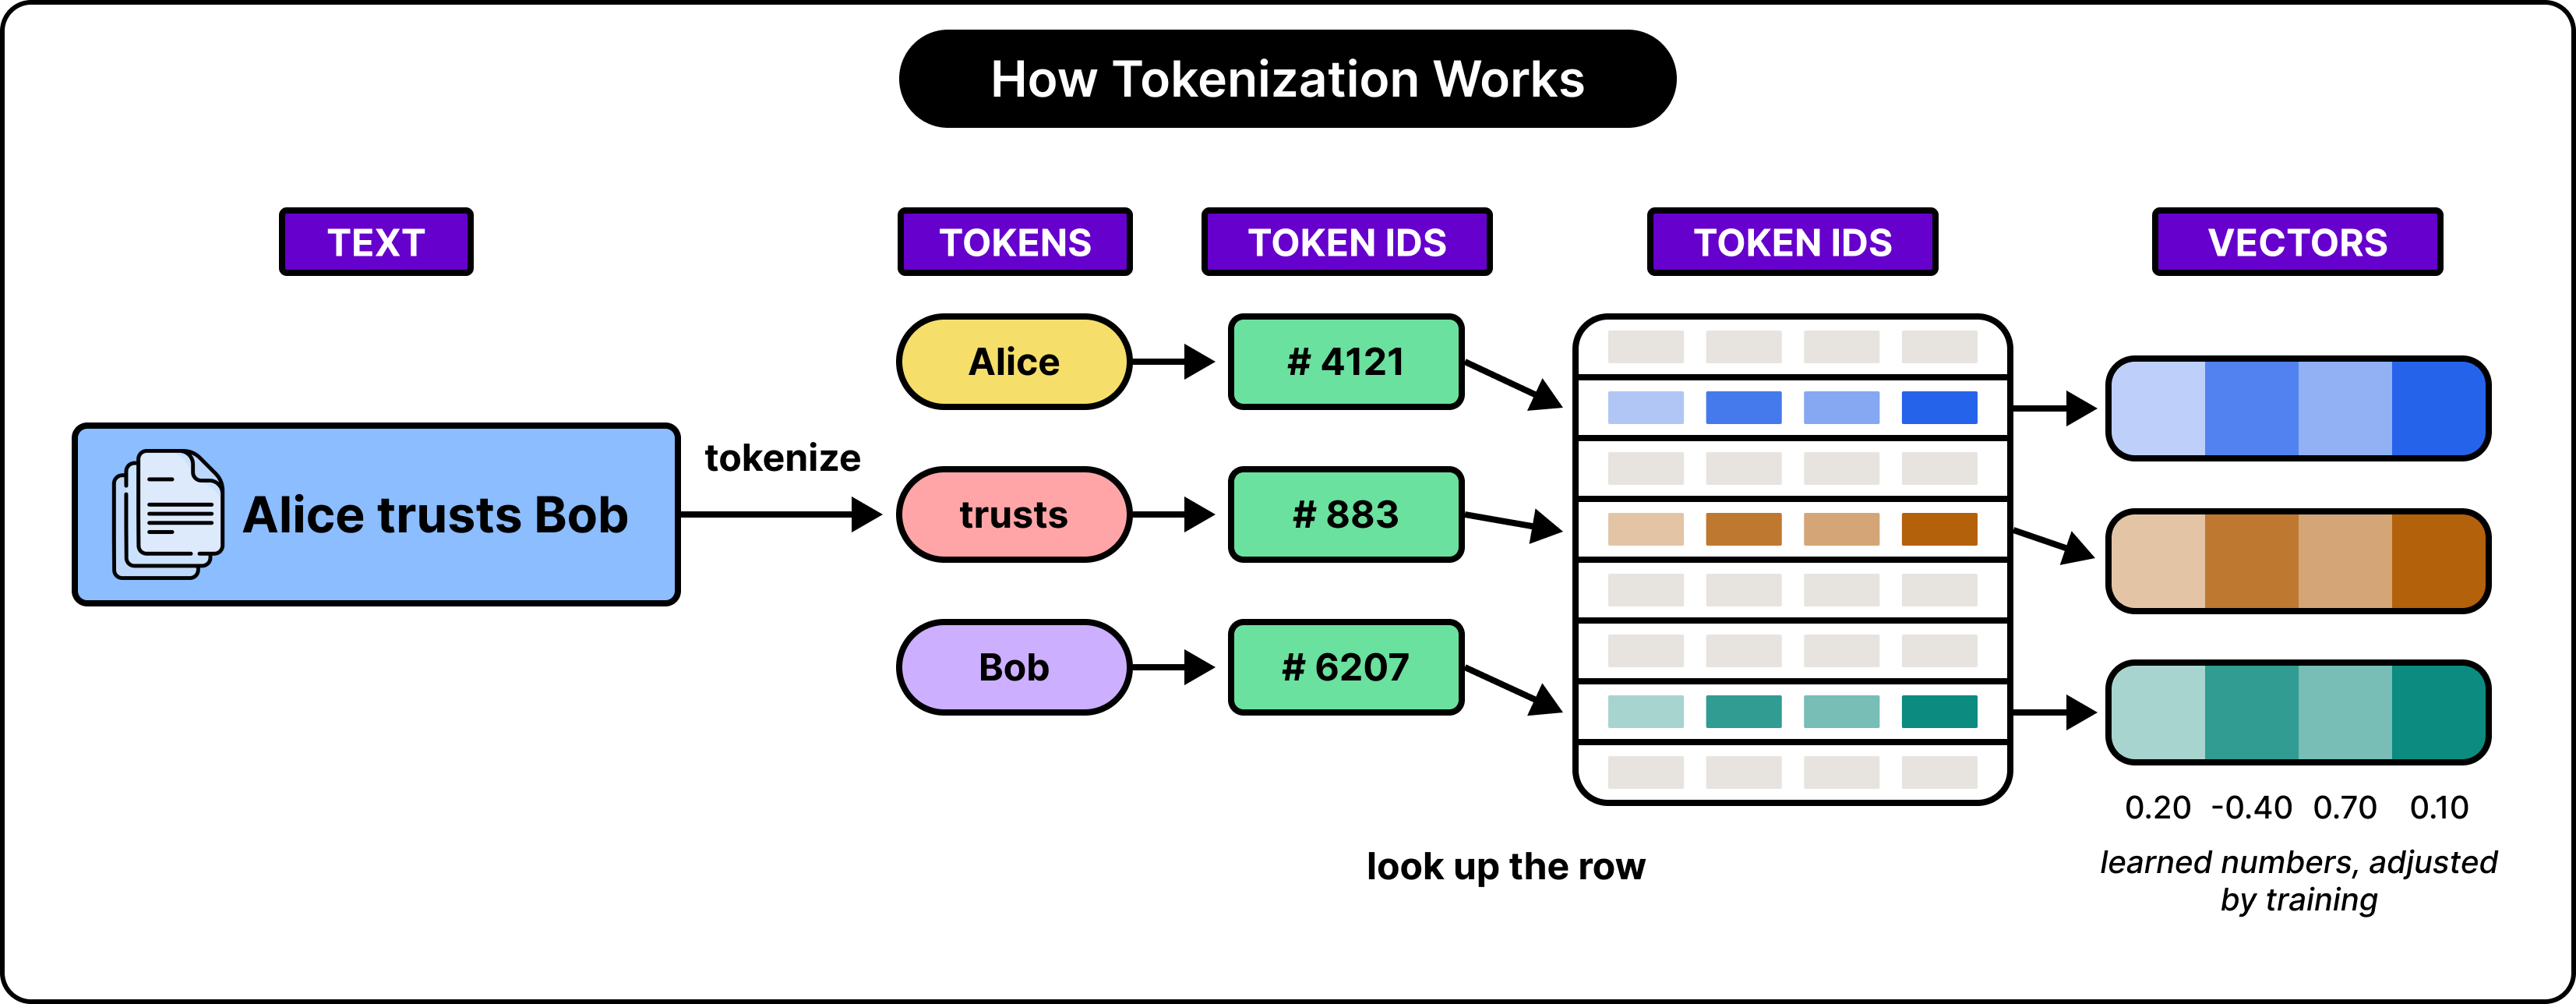
在输出阶段,模型会在解码过程中为各个可能的下一个 token 计算分数。解码步骤选出一个 token,追加到序列中,然后继续生成后续 token。这些计算依赖模型的参数(权重),也就是模型在训练阶段学到的那些参数。
Nemotron 的核心目标是让文本生成过程尽可能高效。这种高效对 AI agent 来说至关重要——因为 agent 需要反复读取指令、调用工具、获取工具返回的结果,再决定下一步做什么。可以想象,一个编程 agent 在解决问题时可能要进行几十次模型调用,此时高效率的价值不言而喻。
总参数量达 300 亿的 Nemotron Lightning 模型,就是为了优化这种反复执行的计算。
Transformer 模型的资源消耗在哪里
基于 Transformer 的语言模型,资源主要花在注意力机制和前馈计算这两块。
如你所知,模型会把文本拆成一个个小块,也就是 token,再把每个 token 转换成一串数字。你可以把这串数字理解为 token 的表示。随着模型不断处理文本,这些数字也会变化——模型对 token 及其上下文的理解越来越深,token 的表示也随之更新。
注意力机制的作用是在 token 之间传递信息。举个例子,有这样一句话:“Adam 把冰淇淋放进冰箱,因为它正在融化。”要理解“它”,模型必须知道句子前面提到的“冰淇淋”。注意力机制就提供了一种途径,把前面的信息融入“它”这个词的表示之中。
要理解这种信息收集是如何实现的,需要先了解三个概念:query、key 和 value。
query 是你想查询的信息;key 描述某条笔记大致是关于什么的;value 则是这条笔记真正能提供的内容。模型会用 query 与各个 key 进行比对,然后把 value 加权组合,匹配度越高的权重越大。这一切都是数值计算。
多个注意力头会并行执行多组这样的计算,每个头学到的信息匹配和组合方式各不相同。最后,前馈网络会对每个位置上的信息进行处理,通过矩阵运算和非线性函数,生成新的表示。比如,注意力机制把“冰淇淋”的信息融入“它”的表示后,前馈计算就可以利用训练中学到的模式进一步打磨这个表示。
你可以把注意力机制理解为从各处收集有用的笔记,而前馈计算则是对收集来的笔记进行加工。
接下来看看成本问题。
你可能已经知道,模型是逐个 token 生成答案的:先产出一个 token,再把它作为下一步输入的一部分,如此循环往复。这就是所谓的自回归生成。在这些步骤中,大部分文本内容是重复不变的,但如果每次都重新计算 key 和 value,就会重复做大量工作。KV cache 的作用就是把这部分重复工作存下来,供模型复用。不过缓存本身也占内存:在 full attention 下,历史越长,需要存储的 key 和 value 就越多,而且每一步需要核对的信息量也随之增加。
处理初始 prompt 和继续生成答案,两者的成本也不一样。比如处理完整 prompt 时,模型要计算大量 token 位置之间的关系。在一个向后看的模型里,第一个 token 只需考虑一个位置,第二个考虑两个,第三个考虑三个,以此类推——这些比较会随着 prompt 变长不断累积。
由此不难推出:prompt 长度翻倍,attention 比较的工作量会变成四倍,即二次增长。而有了 KV cache,先前的信息已经准备好了,历史翻倍只需让 attention 工作量翻倍,也就是线性增长。
Nvidia 的 Nemotron 如何降低成本
Nvidia 的 Nemotron 3 模型通过 Mamba 层和混合专家来降低成本。
Mamba 层维护一个紧凑的数值状态,随 token 到来不断更新。你可以把它想象成一份关于已读内容的滚动笔记。这个状态由训练中学到的数值特征构成,可以用来在长序列中传递信息。关键在于,它不会为每个历史 token 单独存储一份 key-value 记录,所以状态本身不会随之膨胀。
在生成过程中,Mamba 层的状态大小和逐 token 更新的开销都是固定的。模型可以持续更新,而不用让每一层去搜索一个不断膨胀的缓存。不过状态固定也带来了一个权衡:把漫长的历史压缩进一个有界的表示,可能会让精确检索内容变得困难。
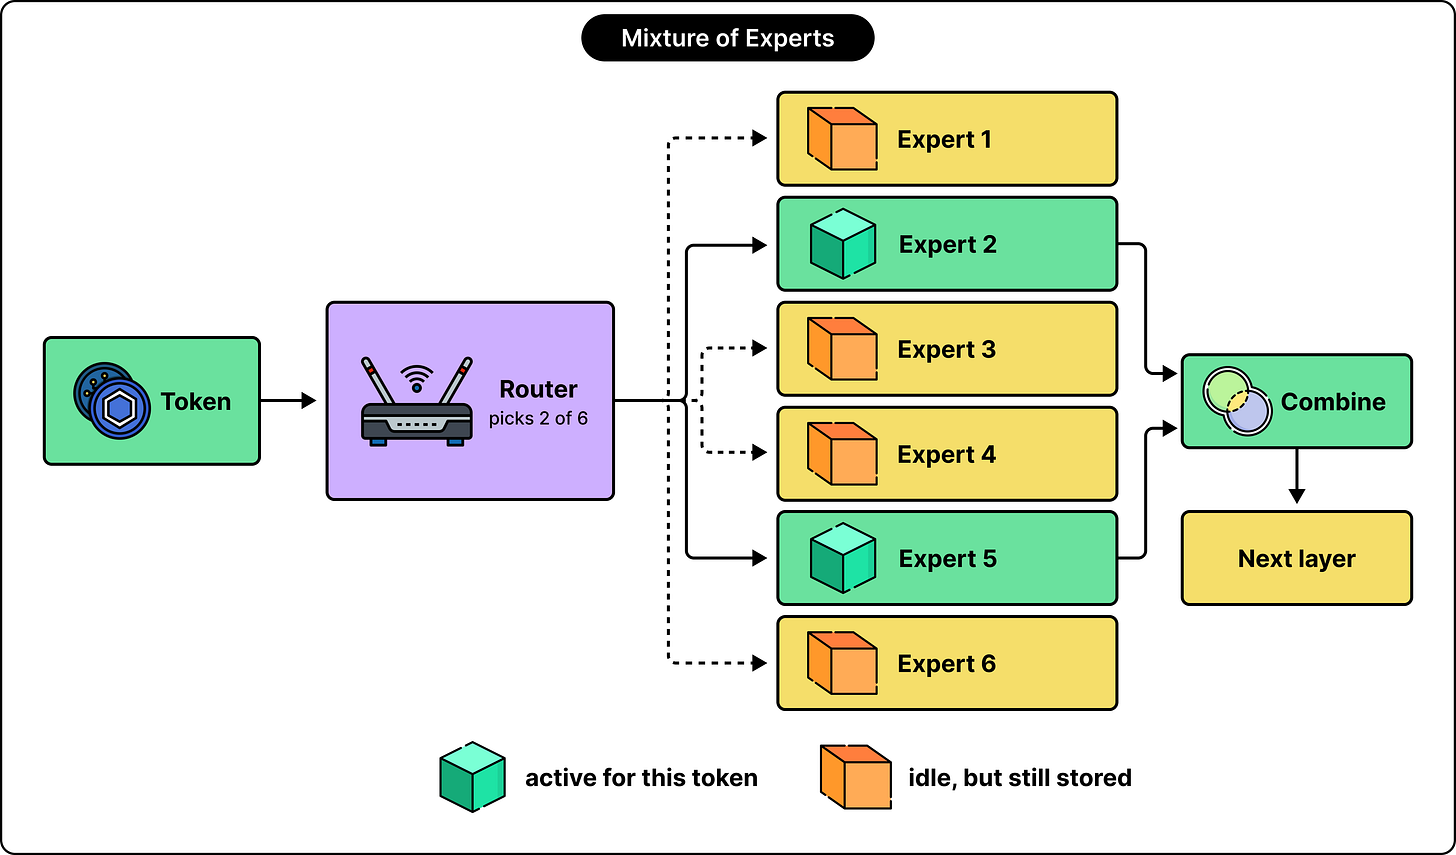
MoE 架构则改变了前馈计算方式。在这种结构下,模型包含许多前馈网络,称为“专家”。由一个路由器为每个 token 挑选一组专家来处理。模型的总容量可以很大,但每个 token 实际只用到了其中一部分。
Nemotron 如何结合 Mamba 与 MoE
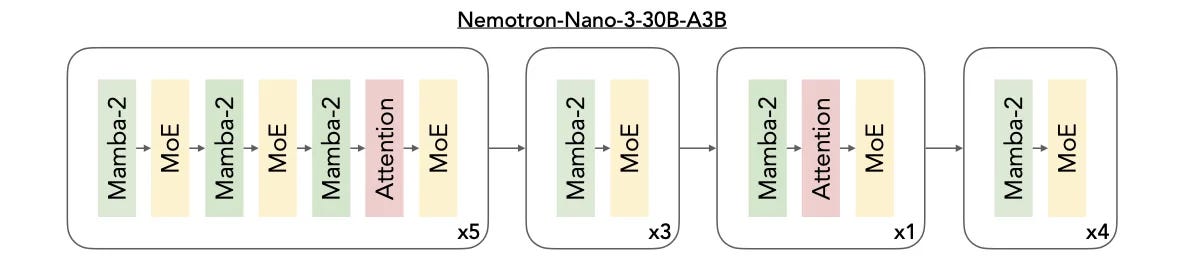
Nemotron 把 Mamba 和 attention 融合在同一个网络中。
Mamba 能高效处理序列,attention 则可以直接访问与早期位置相关的表示。Nemotron 将这两种机制交错排列,让信息在网络中流动时依次经过两者。
层的排列顺序由架构决定。每个 token 表示都按这个顺序流动,在特定位置依次经过 Mamba、attention 和专家变换。因此,attention 层处理的是前面各层已经加工过的表示。这样一来,大部分序列处理都可以用紧凑状态完成,而选定的部分层则保留了 attention 连接远距离位置的能力,这些 attention 层需要维护 KV 缓存。
混合专家(MoE)让模型在不必激活所有专家的情况下获得大容量。在稠密模型中,每一层的所有 token 都通过同一个前馈网络;而在 MoE 中,一层包含多个可替换的前馈网络,由路由器决定使用哪一组。被选中的专家处理表示后,其输出再按路由权重合并。
Nvidia 的 Lightning 配置中,每个 MoE 层有 128 个路由专家,每个 token 会选中其中 6 个。这样一来,模型总参数量约 300 亿,但处理某个具体 token 时实际只用大约 30 亿参数。
当然,没被选中的专家仍然是模型的一部分,它们必须保留下来供后续 token 使用。稀疏激活能减少每个 token 的计算量,但总