
【AI+DevOps实战-12】让大模型连上MCP_Spring-AI接入外部工具生态实战
大家好,我是质量架构师东哥,专注软件研发过程中的质量和效率改进。
讲清原理,打通实战,拒绝空谈欢迎关注。
本文承接 【AI+DevOps实战-11】Spring-AI工具调用实战。上一篇我们让模型"动手"了——给它 @Tool 标注的天气查询和 Shell 命令执行工具,让它自己决定调哪个、拿到结果再答复。
但上一篇有个隐隐的痛点:每个工具都得自己写一遍。天气工具我得自己写 RestClient 调 open-meteo,Shell 工具我得自己写 ProcessBuilder 加护栏。那 Claude Desktop 里能用的浏览器自动化、GitHub 操作、数据库查询……难道每一个我都要在 Java 里重新实现一遍?想想就头大。
MCP(Model Context Protocol)就是解药——Anthropic 2024 年推出的开放协议,让"工具"像 USB 一样即插即用:别人写好一个 MCP server(Python/Node/Java 都行),我们这些 client(Claude Desktop、Cursor、自己的 Spring AI 应用)连上就能用它提供的工具。一次编写,到处调用。
本篇我们就把自己的 Java 应用连到外部 MCP 生态上——用 Playwright MCP(浏览器自动化)和钉钉云文档 MCP 两个实战场景,循序渐进讲透 MCP 客户端接入。还是前两篇的老套路:先用 main 方法跑通链路,再改造成 HTTP 接口。
读完这篇我们能做到:搞懂 MCP 协议是啥、和 CLI 啥区别、stdio 和 HTTP 两种传输怎么选、用 Spring AI 2.0.1 连外部 MCP server、本地工具和 MCP 工具并存注册让模型自主路由、跑通 main 方法看模型自己调 Playwright 打开网页截图、把 MCP 接入做成多模型可切换的 HTTP 接口。
一、MCP 是什么:工具的 USB
1.1 协议不是框架
MCP 是 Anthropic 2024 年 11 月推出的开放协议,不是某个框架。它基于 JSON-RPC 2.0,定义了"工具怎么暴露、怎么发现、怎么调用"的对话规范。
类比 USB:USB 是协议不是设备,任何厂商按 USB 协议造的设备(鼠标、键盘、硬盘),任何电脑都能用。MCP 同理——任何语言按 MCP 协议写的 server(暴露工具),任何 client(Claude Desktop、Cursor、我们的 Spring AI 应用)都能连上用。Python/Node/Java 都有 MCP SDK,跨语言复用。
1.2 三要素
MCP 三个角色:
| 角色 | 职责 | 本篇例子 |
|---|---|---|
| Server | 暴露工具的一方,负责真正执行 | Playwright MCP server(跑浏览器)、钉钉 MCP server(操作文档) |
| Client | 连 server 调工具的一方 | 我们的 Spring AI 应用 |
| Protocol | 双方对话的协议(JSON-RPC 2.0) | list_tools(发现工具)/ call_tool(调工具)/ 结果回传 |
1.3 两种传输方式:stdio vs HTTP
client 怎么和 server 通信?MCP 定义了两种传输方式:
stdio(标准输入输出)——client 起 server 子进程,靠管道通信:
我们的 Java 应用 (client)
    ↕ stdin/stdout(管道)
Playwright MCP server (子进程,npx 起的)
    ↕
浏览器(server 内部操作)
HTTP(SSE / streamable-http)——server 是独立服务,client 用 HTTP 连:
我们的 Java 应用 (client)
    ↕ HTTP 请求
钉钉云文档 MCP server (远程服务)
    ↕
钉钉文档(server 内部操作)
对比:
| 维度 | stdio 传输 | HTTP 传输 |
|---|---|---|
| 通信方式 | client 起 server 子进程,靠 stdin/stdout 管道 | server 是独立服务,client 用 HTTP 连 |
| server 在哪 | client 进程的子进程(同机) | 远程(也可同机,独立进程) |
| 生命周期 | client 启动拉起 server,client 关闭 server 也关 | server 独立运行,client 连上/断开 |
| 网络配置 | 零网络配置(管道通信) | 需 URL/端口/可能要鉴权 |
| 状态管理 | 子进程生命周期内保状态 | 长连接保状态(streamable-http) |
| 典型场景 | 本地开发、本地工具 | 远程服务、生产部署、共享 server |
| 本篇例子 | Playwright MCP(npx @playwright/mcp@latest) | 钉钉云文档 MCP(https://mcp-gw.dingtalk.com/...) |
HTTP 内部还分两种——这个容易混:
SSE(Server-Sent Events):老协议,单向流(server → client 推,client → server 用 POST)。MCP 早期 HTTP 传输用这个,Spring AI 配置项是
spring.ai.mcp.client.sse。streamable-http:新协议(MCP 2025-03 规范),双向流,更现代。Spring AI 2.0.1 的配置项
spring.ai.mcp.client.streamable-http对应它。本篇钉钉 MCP 用这个。
怎么选:
工具跑在本地、本地开发用 → stdio(零网络配置,最简单)
工具是远程服务、生产部署、多个 client 共享一个 server → HTTP(streamable-http 优先,更现代)
1.3.1 深入理解:stdio 配置里的 npx 到底干了什么
本篇 Playwright MCP 的 stdio 配置是:
stdio:
connections:
playwright:
command: npx
args:
-"@playwright/mcp@latest"
注意这里只有 command + args,没有 url——这就是 stdio 传输的配置形式。框架拿这两个字段拼出 npx @playwright/mcp@latest 这条命令,用 ProcessBuilder.start() 起一个子进程。那这个 npx 命令实际干了什么?包下载到哪、从哪下载?这个细节不讲清楚,配置就是黑盒。
npx 是什么:npm 自带的工具(npm 5.2+ 起内置,全称 "Node Package eXecute"),专门执行 npm 包里的可执行文件。它不是凭空运行——背后有一套完整的查找-下载-执行流程。
第一次跑 npx @playwright/mcp@latest 的完整过程(之后跑会命中缓存,省去下载步骤):
npx @playwright/mcp@latest
  │
  │ 1. 算包名 hash → 9833c18b2d85bc59(每个包一个 hash 桶)
  │
  │ 2. 查缓存目录 ~/.npm/_npx/9833c18b2d85bc59/ 是否存在
  │    ├── 存在 → 查 registry 的 latest 标签,比对版本
  │    │         ├── 有新版 → 下载新版覆盖(继续走步骤 3)
  │    │         └── 无更新 → 直接用缓存(跳到步骤 5,秒起)
  │    └── 不存在 → 第一次下载(继续走步骤 3)
  │
  │ 3. 从 npm registry 下载(源由 npm config get registry 决定)
  │    本机配置:https://registry.npmmirror.com(淘宝镜像,国内快)
  │    实际请求:https://registry.npmmirror.com/@playwright/mcp/latest
  │    ↓ 下载 tarball,解压
  │
  │ 4. 安装到缓存目录
  │    ~/.npm/_npx/9833c18b2d85bc59/node_modules/@playwright/mcp/
  │    ├── cli.js          ← bin 入口(npx 实际执行的就是它)
  │    ├── package.json
  │    └── ...
  │
  │ 5. 读 package.json 的 bin 字段,执行对应入口
  │    "bin": { "playwright-mcp": "cli.js" }
  │    等价于: node ~/.npm/_npx/9833c18b2d85bc59/.../cli.js
  ↓
Playwright MCP server 子进程启动,监听 stdin 等待 JSON-RPC 消息
几个关键细节(实测确认,不是网传文档):
下载位置:
~/.npm/_npx/<hash>/node_modules/@playwright/mcp/。hash 桶是 npx 的缓存机制——同一个包多次执行共用一个桶,不同包互不干扰。可以用find ~/.npm/_npx -path "*@playwright/mcp/package.json"实测定位。下载源:本机
npm config get registry=https://registry.npmmirror.com(淘宝镜像)。npx 下载跟npm install用同一个 registry,所以配了淘宝镜像就自动走镜像,国内下载快。不是从 Playwright 官网下,也不是从 npm 官方源(registry.npmjs.org)下。@latest的含义:版本标签,意思是"最新版"。每次执行会查 registry 的latest标签指向哪个版本(本篇实测是0.0.83),跟本地缓存比对,有新版就更新。所以第一次慢(要下载),之后快(用缓存),但每次会检查更新(偶尔卡一下就是在这查 registry)。cli.js 是什么:Node.js 脚本,启动后监听 stdin 等待 JSON-RPC 消息,收到消息后控制 Chromium 浏览器(通过 CDP 协议),把结果通过 stdout 返回。这就是 stdio 传输的"管道通信"落地——我们的 Java 应用往子进程的 stdin 写 JSON-RPC,子进程从 stdout 吐结果。
第一次 vs 之后:第一次要联网下载(几秒到十几秒),之后命中缓存几乎秒起。但
@latest标签每次都会查 registry 比对版本,所以严格说"之后"也要联网查一次(除非完全离线)。
为什么 Playwright 用 stdio 而不是 HTTP——根因是工具跑在哪:Playwright 要操作本机浏览器(打开网页、截图、点击),子进程必须跑在本机才能控制本机浏览器和文件系统。如果做成远程 HTTP 服务,它操作的就是服务器上的浏览器,跟用户本机无关。所以 stdio 不是"落后的方式",而是"本地工具的必然选择"。对比钉钉——服务在钉钉服务器,操作的是云端文档,只能用 HTTP 连远程。
1.4 为什么不让每个 AI 应用重复造工具
没有 MCP 的世界:N 个模型 × M 个工具 = N×M 套集成。我们给 OpenAI 写的 function calling,换 Claude 全重写;我们给 Claude 写的工具,Cursor 用不了;我们想让 Claude Desktop 用我们的数据库,要写专属插件。
有了 MCP:协议统一了"工具怎么暴露、怎么发现、怎么调用"。任何人写一个 MCP server,任何 client 都能连。N+M 套集成。一次编写,到处调用。

二、MCP vs CLI:同一工具的两种形态
这个对比很多人搞混——以为 MCP 是替代 CLI 的。其实不是。现在很多工具同时提供 CLI 和 MCP 两种接口:
| 工具 | CLI 形态 | MCP 形态 |
|---|---|---|
| Playwright | npx playwright screenshot url | @playwright/mcp → browser_take_screenshot |
| GitHub | gh pr list | github MCP server → list_pull_requests |
| 钉钉 | 钉钉 CLI | 钉钉 MCP server → 操作文档 |
CLI 是趋势——为什么?
简单直接:
playwright screenshot url一行命令,无需协议层可组合:管道、脚本、cron 任意组合(
gh pr list | grep feature | wc -l)人机通用:人能跑的命令机器也能跑,没有学习成本
但 MCP 有自己的不可替代场景:
| 维度 | CLI | MCP |
|---|---|---|
| 谁决定调啥 | 我们指挥它跑哪条命令(我们得预先知道有哪些命令) | 模型自己看工具列表决定调啥(list_tools 协议运行时发现) |
| IO 结构 | 文本输出,要 parse | JSON Schema,模型直接理解结构 |
| 状态管理 | 每次调用独立,无状态 | 长连接保状态(Playwright MCP 的浏览器窗口在多次调用间保持打开) |
| 工具发现 | 读文档知道有啥命令 | list_tools 协议自动发现 |
| AI 自主性 | 低(我们写脚本指挥) | 高(模型自主探索调度) |
一句话区分:
CLI:适合"人写脚本/确定流程"——我们清楚要干啥,写命令组合
MCP:适合"AI 自主探索/需状态/结构化交互"——让模型自己看菜单点菜
本篇用 MCP 让 AI 自主操作浏览器,关键看一个点:Playwright MCP 的浏览器会话在多次工具调用间保持状态——模型调 browser_navigate 打开页面后,再调 browser_take_screenshot 能直接截同一个页面,无需重新打开。这是 CLI 做不到的(每次 CLI 调用独立无状态)。
不是替代是互补——本篇让本地工具(天气/Shell,第11篇自写的)和 MCP 工具(Playwright/钉钉,连外部生态的)并存注册,模型自主路由全部工具。
三、Spring AI 2.0.1 的 MCP 支持
动手前我得先搞清楚 Spring AI 2.0.1 到底怎么支持 MCP——网上的文档要么过时要么对不上版本。
3.1 一个版本陷阱:MCP 模块版本号
先踩了个坑。我一开始在本地 m2 仓库里看到 spring-ai-mcp-1.1.2.jar,以为 MCP 模块版本是 1.1.2。但加了依赖跑 mvn dependency:tree,实际拉到的是 2.0.1:
[INFO] +- org.springframework.ai:spring-ai-starter-mcp-client:jar:2.0.1:compile
[INFO] |  +- org.springframework.ai:spring-ai-mcp:jar:2.0.1:compile
[INFO] |  |  \- io.modelcontextprotocol.sdk:mcp:jar:2.0.0:compile
m2 里的 1.1.2 是之前实验留下的旧版本残留。一切以 dependency:tree 拉到的为准——MCP 模块版本和 Spring AI 主版本都是 2.0.1,没解耦。
3.2 桥接类:SyncMcpToolCallbackProvider
MCP 工具怎么变成 Spring AI 能用的 ToolCallback?关键桥接类是 org.springframework.ai.mcp.SyncMcpToolCallbackProvider。
publicclassSyncMcpToolCallbackProvider
implementsToolCallbackProvider,ApplicationListener<McpToolsChangedEvent>{

privatefinalList<McpSyncClient> mcpClients;// MCP Java SDK 的客户端

// 构造:传一组 McpSyncClient(每个连一个 MCP server)
publicSyncMcpToolCallbackProvider(List<McpSyncClient> mcpClients);
publicSyncMcpToolCallbackProvider(McpSyncClient... mcpClients);

// 关键方法:返回 ToolCallback[],可直接喂给 ChatClient.tools()
publicToolCallback[]getToolCallbacks();
}
它实现了 ToolCallbackProvider——这玩意儿就是上一篇本地 @Tool 工具和 MCP 工具的共同接口。换句话说,在 ChatClient 眼里,本地 @Tool 方法和 MCP server 的工具一视同仁,都是 ToolCallback,模型按描述选最合适的调。这就是"并存注册"的底层依据。
3.3 配置前缀
SyncMcpToolCallbackProvider 怎么造?手动构造要传 McpSyncClient,但 McpSyncClient 怎么来?接口环境用容器自动配置,配 yml 就行。配置前缀 McpClientCommonProperties 类的字节码常量池:
spring.ai.mcp.client                # 通用:enabled / type(SYNC|ASYNC) / request-timeout / toolcallback
spring.ai.mcp.client.stdio          # stdio 传输:connections Map(每个连接 command/args/env)
spring.ai.mcp.client.sse            # SSE 传输:connections Map(每个连接 url/sseEndpoint)
spring.ai.mcp.client.streamable-http # streamable-http 传输:connections Map(每个连接 url/endpoint)
3.4 自动配置:配 yml 就有工具
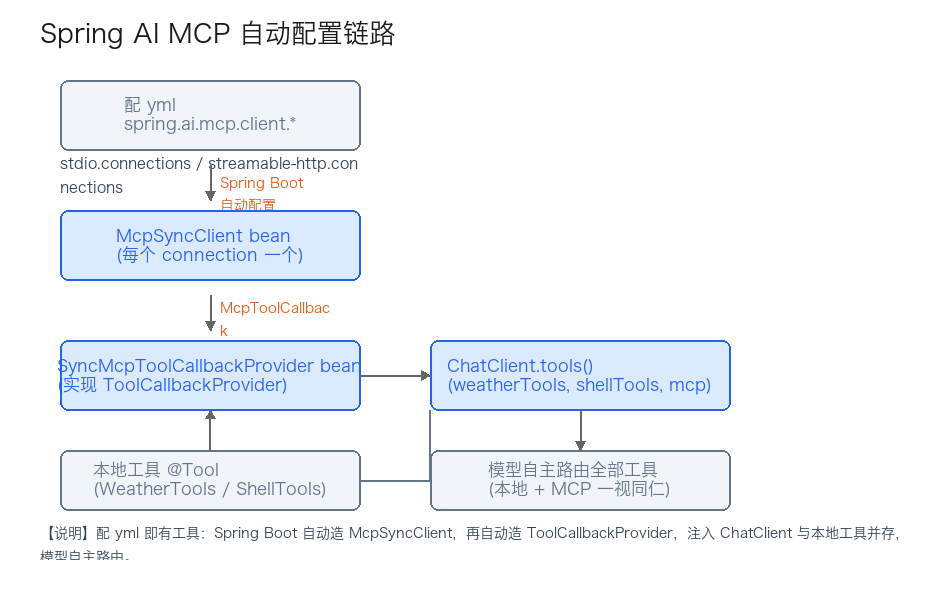
McpToolCallbackAutoConfiguration 干的事:注入容器里所有的 McpSyncClient bean,自动造 SyncMcpToolCallbackProvider bean(即 ToolCallbackProvider)。链路是这样的:
配 yml(spring.ai.mcp.client.*)
    ↓ Spring Boot 自动配置
自动造 McpSyncClient bean(每个 connection 一个)
    ↓ McpToolCallbackAutoConfiguration
自动造 SyncMcpToolCallbackProvider bean(ToolCallbackProvider)
    ↓ 注入到 McpController
ChatClient.tools(weatherTools, shellTools, mcpToolCallbackProvider)
配 yml 就有工具——这是 MCP 最大的便利。不用自己写 @Tool,连外部 MCP server 就行。
四、企业级 MCP 接入设计
沿用上一篇的企业级原则,本篇 MCP 接入的几个设计点:
配置外置:所有 MCP server 连接信息写进
application.yml(spring.ai.mcp.client.*),不硬编码。环境差异(本地/生产连不同 server)只改配置不改代码凭据走环境变量:钉钉 MCP 的 key 用
${DINGTALK_MCP_KEY}注入,绝不入库。这跟项目"凭据不入库"原则一致(第4篇讲过)本地工具与 MCP 工具并存:上一篇的 WeatherTools/ShellTools 不动,新增 MCP 工具并存注册。模型自主路由全部工具——呼应第11篇 6.2 集中注册最佳实践
MCP 工具的执行引擎在 server 端:本侧只做"桥接",拿
ToolCallbackProvider喂给 ChatClient。这是 MCP 与第11篇@Tool的核心差异——第11篇自己写执行引擎,本篇连别人的执行引擎
五、配置:application.yml 加 MCP client 块
先加依赖。ai-devops/pom.xml:
<!-- Spring AI MCP 客户端(连外部 MCP server 调其工具,第12篇) -->
<dependency>
<groupId>org.springframework.ai</groupId>
<artifactId>spring-ai-starter-mcp-client</artifactId>
</dependency>
版本由 spring-ai-bom 管(2.0.1),不用写 <version>。
然后配 application-dev.yml,在 spring.ai 块下加 mcp.client:
spring:
ai:
# ... 上面是 anthropic / deepseek 配置 ...
mcp:
client:
enabled:true
type: SYNC   # 同步客户端,简单直观。ASYNC 是异步(返回 Flux),适合响应式栈
request-timeout: 60s   # MCP 工具调用超时——浏览器操作/远程文档可能慢,给足 60s
# toolcallback.enabled 默认 true:自动造 ToolCallbackProvider bean
# stdio 传输:Playwright MCP(client 起 server 子进程)
stdio:
connections:
playwright:
command: npx
args:
-"@playwright/mcp@latest"
# streamable-http 传输:钉钉云文档 MCP(远程)
streamable-http:
connections:
dingtalk-doc:
# key 走环境变量 DINGTALK_MCP_KEY,绝不入库
url: https://mcp-gw.dingtalk.com/server/a941bf4a3ad3834bb954063a548f5dc925adeec6fdaaa08f38b0f9bedf8fea27?key=${DINGTALK_MCP_KEY}
endpoint: /mcp
几个关键点讲一下:
type: SYNC:同步客户端,调用阻塞返回,简单直观。ASYNC 是异步(返回Flux),适合 WebFlux 响应式栈,本篇不用stdio.connections.playwright:配 stdio 传输的 MCP server。command: npx+args: ["@playwright/mcp@latest"]——框架会拿这俩起一个 Playwright MCP 子进程,靠管道通信streamable-http.connections.dingtalk-doc:配 HTTP 传输的远程 MCP server。url是钉钉 MCP 网关,endpoint是 MCP 协议端点钉钉 key 走环境变量:
${DINGTALK_MCP_KEY}是 Spring 的占位符,运行时从环境变量读。未设时整段 url 含字面${DINGTALK_MCP_KEY},钉钉会拒,安全失败优于明文入库
六、main 方法跑通:手动构造 MCP 客户端链路
接口环境用容器自动配置(配 yml 就行),但 main 方法要绕开容器,得手动构造 MCP 客户端。这正好让咱们看清 MCP 客户端的每一层——循序渐进嘛。
ai-devops/src/test/java/com/ruoyi/aidevops/McpAI.java,结构沿用上一篇 AIToolCallingSmokeTest 的拆分思路:
| 方法 | 职责 |
|---|---|
main | 编排:构造本地工具 → 构造 MCP 客户端(stdio + HTTP)→ 构造 ChatClient → 跑三个场景 |
createStdioMcpClient() | 手动构造 stdio 传输的 MCP 客户端(4 步看清构造链路,连 Playwright) |
createStreamableHttpMcpClient() | 手动构造 streamable-http 传输的 MCP 客户端(4 步对称,连钉钉) |
createChatClient() | 构造 DeepSeek ChatClient(沿用 AIToolCallingSmokeTest 套路) |
testLocalToolWithMcp() | 场景一:问天气,验证本地工具+MCP 工具并存路由 |
testPlaywrightMcp() | 场景二:让模型用 Playwright 打开网页截图(stdio 传输) |
testDingtalkMcp() | 场景三:让模型用钉钉 MCP 操作云文档(streamable-http 传输) |
场景三的凭据依赖:钉钉 MCP 需要
DINGTALK_MCP_KEY环境变量(绝不入库,与 yml 同源)。未设时 main 自动跳过场景三,只跑场景一/二——读者无 key 也能跑 main 看 stdio 链路,设了 key 才补跑 streamable-http 链路。
6.1 手动构造 stdio MCP 客户端:4 步看清链路
这是本篇的核心——手动构造让咱们看清 MCP 客户端的每一层。接口环境这些全由 McpClientAutoConfiguration 自动造,但 main 方法绕开容器,得自己来:
privatestaticMcpSyncClientcreateStdioMcpClient(String command,List<String> args){
// 1. 描述怎么起 server 子进程
ServerParameters serverParams =ServerParameters.builder(command)
.args(args)
.build();

// 2. 造 stdio 传输层(需要 JSON 映射器序列化 JSON-RPC 消息)
//    JacksonMcpJsonMapperSupplier 提供默认 Jackson3 实现的 McpJsonMapper
McpJsonMapper jsonMapper =newJacksonMcpJsonMapperSupplier().get();
StdioClientTransport transport =newStdioClientTransport(serverParams, jsonMapper);

// 3. 造 McpSyncClient(builder 模式,配请求超时)
McpSyncClient mcpClient =McpClient.sync(transport)
.requestTimeout(Duration.ofSeconds(60))
.build();

// 4. 与 server 握手——必须调,否则 listTools/callTool 全失败
    mcpClient.initialize();
return mcpClient;
}
4 步对应 MCP 客户端的 4 层:
ServerParameters:描述怎么起 server 子进程(command + args)。这就是 yml 里stdio.connections.playwright的内容StdioClientTransport:传输层,靠 stdin/stdout 与子进程通信。需要McpJsonMapper序列化 JSON-RPC 消息(用JacksonMcpJsonMapperSupplier拿默认 Jackson3 实现)McpClient.sync(transport):工厂方法,传 transport 拿SyncSpec(builder),配超时后build()出McpSyncClientinitialize():与 server 握手——列出能力、协商版本。必须调,否则listTools/callTool全失败
踩坑提醒:
JacksonMcpJsonMapper构造器要传 Jackson 3 的JsonMapper(包名tools.jackson.databind.json,不是老com.fasterxml.jackson)。直接new JacksonMcpJsonMapper()会编译失败——用new JacksonMcpJsonMapperSupplier().get()拿默认实例最省事。
6.2 手动构造 streamable-http MCP 客户端:4 步对称链路
stdio 连本地子进程(Playwright),streamable-http 连远程服务(钉钉)。transport 类不同,但后续 3 步(造 McpSyncClient → initialize → 桥接)完全一致——这正是 MCP 协议分层的好处:传输层换,上层不动。
privatestaticMcpSyncClientcreateStreamableHttpMcpClient(String baseUri,String endpoint){
// 1. 造 streamable-http 传输层(builder 模式)
//    baseUri 只到 host——endpoint 含完整 path+token+key,避免 resolveUri 拼接时凭据被覆盖
McpJsonMapper jsonMapper =newJacksonMcpJsonMapperSupplier().get();
HttpClientStreamableHttpTransport transport =HttpClientStreamableHttpTransport.builder(baseUri)
.endpoint(endpoint)
.jsonMapper(jsonMapper)
.build();

// 2. 造 McpSyncClient(builder 模式,配请求超时——与 stdio 一致)
McpSyncClient mcpClient =McpClient.sync(transport)
.requestTimeout(Duration.ofSeconds(60))
.build();

// 3. 与 server 握手——必须调,否则 listTools/callTool 全失败(与 stdio 一致)
    mcpClient.initialize();
return mcpClient;
}
4 步与 stdio 完全对称:
HttpClientStreamableHttpTransport.builder(baseUri):传 baseUri 拿 builder。baseUri只到 host(如https://mcp-gw.dingtalk.com),不能含 path/query——这就是 yml 里streamable-http.connections.dingtalk-doc.url只到 host 的原因.endpoint(url):配完整请求 URL(含 path+token+key),对应 yml 里endpoint字段。⚠️ 必须是绝对 URL:相对路径(如/mcp)会触发baseUri.resolve(endpoint)替换掉 baseUri 的 path+query,token+key 全丢(第五章 5.3 踩过这个坑).jsonMapper(mapper):复用同一个 Jackson3McpJsonMapper序列化 JSON-RPC(与 stdio 同一个 mapper)McpClient.sync(transport)→initialize():造 client + 握手——与 stdio 完全一致。这就是协议分层:换 transport,上层代码不变
为什么 baseUri 和 endpoint 要拆开:框架内部调
Utils.resolveUri(baseUri, endpoint)拼最终请求 URL,本质是baseUri.resolve(endpoint)。URI.resolve 的语义是——endpoint 是绝对 URL(含 scheme)会整体替换 baseUri,只要 base 只到 host、endpoint 含完整 path+token+key 就能正确拼接;endpoint 是相对路径(如/mcp)会替换掉 baseUri 的 path+query,钉钉的 token 和 key 全丢。所以 yml 和 main 里都遵循"url 只到 host,凭据全放 endpoint"。
6.3 main 方法编排:本地工具 + MCP 工具并存注册
publicstaticvoidmain(String[] args){
// 1. 第11篇的本地工具(天气 + Shell),与 MCP 工具并存注册
WeatherTools weatherTools =newWeatherTools(newWeatherService(newWeatherProperties()));
ShellTools shellTools =newShellTools(newShellExecutor(newShellProperties()));

// 2. 手动构造 MCP 客户端(stdio + HTTP 两种传输对称演示)
McpSyncClient playwrightMcp =null;
McpSyncClient dingtalkMcp =null;// streamable-http 传输,与 stdio 形成对称
try{
// stdio 传输:连 Playwright MCP(本地子进程)
        playwrightMcp =createStdioMcpClient(
"npx",List.of("@playwright/mcp@latest"));

// 钉钉 key 走环境变量 DINGTALK_MCP_KEY(绝不入库)。未设时跳过场景三,只跑 Playwright
String dingtalkKey =System.getenv("DINGTALK_MCP_KEY");
boolean hasDingtalk = dingtalkKey !=null&&!dingtalkKey.isBlank();

// 3. 桥接:McpSyncClient → ToolCallbackProvider
//    钉钉场景把 dingtalkMcp 也加进同一个 provider,模型自主路由 stdio + HTTP 两路工具
List<McpSyncClient> mcpClients =newArrayList<>(List.of(playwrightMcp));
if(hasDingtalk){
// streamable-http 传输:连钉钉云文档 MCP(远程服务)
            dingtalkMcp =createStreamableHttpMcpClient(
"https://mcp-gw.dingtalk.com",
"https://mcp-gw.dingtalk.com/server/a941bf4a...?key="+ dingtalkKey);
            mcpClients.add(dingtalkMcp);
}
SyncMcpToolCallbackProvider mcpTools =newSyncMcpToolCallbackProvider(mcpClients);

// 4. 构造 ChatClient(沿用 `AIToolCallingSmokeTest` 套路)
ChatClient chatClient =createChatClient();

// 5. 集中注册:本地工具 + MCP 工具并存,模型自主路由全部工具
testLocalToolWithMcp(chatClient, weatherTools, shellTools, mcpTools);
testPlaywrightMcp(chatClient, weatherTools, shellTools, mcpTools);
if(hasDingtalk){
testDingtalkMcp(chatClient, weatherTools, shellTools, mcpTools);
}
}finally{
// McpSyncClient 实现了 AutoCloseable,用完必须 close——否则子进程(npx)会残留
if(playwrightMcp !=null) playwrightMcp.close();
if(dingtalkMcp !=null) dingtalkMcp.close();// HTTP 连接也要释放
}
}
注意 finally 里两个 close()——McpSyncClient 实现了 AutoCloseable,stdio 要关(否则 npx 子进程残留),HTTP 也要关(释放底层 HttpClient)。判空 close:构造失败时 client 仍为 null,直接 close 会 NPE。这是手动构造的责任,容器环境自动管。
6.4 场景一:本地工具与 MCP 工具并存路由
privatestaticvoidtestLocalToolWithMcp(ChatClient chatClient,WeatherTools weatherTools,
ShellTools shellTools,SyncMcpToolCallbackProvider mcpTools){
String reply = chatClient.prompt()
.user("杭州现在天气怎么样?")
.tools(weatherTools, shellTools, mcpTools)// 本地 + MCP 集中注册
.call()
.content();
System.out.println("模型回复:\n"+ reply);
}
关键点:虽然注册了 Playwright MCP 的全部浏览器工具(browser_navigate/click/screenshot 等),但模型读到"杭州天气怎么样"后,自己判断该调本地 getWeather(而不是浏览器工具)。这就是第11篇 6.2 说的"模型自主路由"——本地工具和 MCP 工具在模型眼里一视同仁,都是 ToolCallback,模型按描述选最合适的。
6.5 场景二:Playwright MCP 浏览器自动化(stdio 传输)
privatestaticvoidtestPlaywrightMcp(ChatClient chatClient,WeatherTools weatherTools,
ShellTools shellTools,SyncMcpToolCallbackProvider mcpTools){
String reply = chatClient.prompt()
.user("用浏览器打开 https://example.com 这个网页,然后截个图给我看看页面长什么样")
.tools(weatherTools, shellTools, mcpTools)// 本地 + MCP 集中注册
.call()
.content();
System.out.println("模型回复:\n"+ reply);
}
模型应自主组合调度链:browser_navigate(打开网页)→ browser_take_screenshot(截图)。这两步是模型现场决定的,我们没在代码里写"先 navigate 再 screenshot"——这就是 MCP 工具与 CLI 的核心差异:CLI 我们得预先知道有哪些命令、按什么顺序跑;MCP 模型自己看工具列表决定调啥、传啥参数、调几次。
且 Playwright MCP 的浏览器会话在多次工具调用间保持状态——browser_navigate 打开的页面,browser_take_screenshot 能直接截,无需重新打开。这是有状态的 MCP server,CLI 做不到。
6.6 场景三:钉钉云文档 MCP(streamable-http 传输)
privatestaticvoidtestDingtalkMcp(ChatClient chatClient,WeatherTools weatherTools,
ShellTools shellTools,SyncMcpToolCallbackProvider mcpTools){
String reply = chatClient.prompt()
.user("帮我列出钉钉云文档里的文件")
.tools(weatherTools, shellTools, mcpTools)// 本地 + stdio + HTTP 集中注册
.call()
.content();
System.out.println("模型回复:\n"+ reply);
}
与场景二的 stdio(Playwright)形成对称:transport 不同(HTTP vs stdio),但模型侧的调用方式完全一样——都是 .tools(weatherTools, shellTools, mcpTools) 集中注册,模型自主路由。这正是 MCP 协议分层的好处:传输层换,上层不动。
钉钉 MCP server 暴露的工具(列出文档、读取文档等)通过 streamable-http 远程调用,server 状态在钉钉云端——与 Playwright(子进程跑本机、操作本机浏览器)形成"远程服务 vs 本地进程"对比。第一章 1.3 说的"工具跑在哪决定用哪种传输",到这里落地:Playwright 操作本机浏览器只能 stdio,钉钉操作云端文档只能 HTTP。
6.7 场景四:docling 文档解析 MCP(stdio 传输,验证工具发现)
前三个场景都是"一个用户问题 → 调一两个工具 → 出答案"。场景四换个角度:验证连上一个新 MCP server 后,它的工具能不能被模型看见——docling 文档解析。
docling 是 IBM 开源的文档解析库(PDF/DOCX/HTML/图片 → 结构化 DoclingDocument),它官方提供了一个 MCP server(独立项目 docling-mcp),暴露成 MCP 工具后,模型能自主调它解析文档。连它的方式和 Playwright 完全一样——stdio 传输,起一个子进程:
// docling 场景守卫:uvx 命令在 PATH 里才起 docling-mcp server(uvx 来自 uv,brew install uv)。
// 没装 uv 的读者跳过场景四,不影响场景一二三——和钉钉的 hasDingtalk 同款守卫思路。
boolean hasDocling =isCommandAvailable("uvx");
if(hasDocling){
// docling-mcp server:stdio 传输,uvx 起子进程,--transport stdio 显式指定(默认是 streamable-http)
    doclingMcp =createStdioMcpClient(
"uvx",List.of("--from=docling-mcp","docling-mcp-server","--transport","stdio"));
    mcpClients.add(doclingMcp);
}
同样是 createStdioMcpClient,只是命令从 npx @playwright/mcp@latest 换成 uvx --from=docling-mcp docling-mcp-server --transport stdio——传输层代码一行没改,换个命令就连上另一个 MCP server。这就是 MCP 协议分层的好处:传输层抽象掉了"server 是谁起的、用什么语言写的",client 侧只认 stdio/stdin/stdout。
连上后模型能调到 docling-mcp 的 20 个工具,核心是这两个配合使用的:
| 工具 | 输入 | 返回 | 作用 |
|---|---|---|---|
convert_document_into_docling_document | source(URL/本地路径,PDF/DOCX/HTML/图片) | {document_key, ...} | 解析文档 → 存 server 本地缓存 → 返回 key |
export_docling_document_to_markdown | document_key | {markdown} | 用 key 换 Markdown 文本 |
这里有个和场景二 Playwright 不同的看点:Playwright 是 browser_navigate + browser_take_screenshot 两步操作同一个有状态浏览器会话;docling 是 convert + export 两个独立工具配合——convert 解析完返回一个 document_key(存在 server 本地缓存里),export 得拿这个 key 才能换出 Markdown。模型得自己记着 convert 返回的 key,再用它调 export——这是 server 内部状态在多工具间的传递,模型要自己编排这条链路:
privatestaticvoidtestDoclingMcp(ChatClient chatClient,WeatherTools weatherTools,
ShellTools shellTools,SyncMcpToolCallbackProvider mcpTools){
// 注意:本环境未装文档解析模型(需 docling-mcp[local] 或配 remote 服务),
// convert_document 调用必然失败。所以这里只验证"能否列出 docling 的可用工具",
// 不让模型去调注定失败的转换工具——提示词只问工具列表,不提解析文档。
String reply = chatClient.prompt()
.user("你当前连接了哪些文档解析相关的工具?请列出工具名称和用途,不需要调用任何工具。")
.tools(weatherTools, shellTools, mcpTools)// 本地 + 多路 MCP 集中注册
.call()
.content();
System.out.println("模型回复:\n"+ reply);
}
为什么提示词只问工具列表、不提解析文档? 因为当前环境没装文档解析模型(见下面「实跑门槛」),convert_document 调用必然失败。让模型去调一个注定失败的工具毫无意义——不如只问"你有哪些工具",模型会基于注册的 docling 工具描述(convert_document_into_docling_document / export_docling_document_to_markdown 等)如实列出,这就验证了 docling-mcp server 握手成功、工具被正确桥接成 ToolCallback、模型能看见它们。这是没装模型时能验证到的最远环节,也是场景四的真正目的。
模型应回出类似这样的列表(基于注册的 20 个 docling 工具描述):
convert_document_into_docling_document—— 把 URL/本地路径的文档(PDF/DOCX/HTML/图片)解析成 DoclingDocument
export_docling_document_to_markdown—— 把已解析的文档导出成 Markdown
check_document_in_local_cache/list_cached_documents/remove_document_from_local_cache—— 文档缓存管理
create_new_docling_document/add_title/add_paragraph/add_table等 —— 文档生成与编辑有了这个工具列表,装好模型后,就能让模型按
convert → export两步编排真正解析文档——这一步留到装好模型时再做。
实跑门槛:模型从哪来(本地 vs 远程)
这一节讲清楚:为什么场景四只验证到"握手 + 工具发现"就停了——因为真正调用 convert_document 解析 PDF 需要模型,而模型默认没装。
docling 解析文档分多个阶段(布局检测 Layout / 文字识别 OCR / 表格结构 Table 等),每个阶段都靠模型驱动——比如布局检测用 docling-layout-heron(基于 RT-DETR 的目标检测模型),OCR 用 EasyOCR/Tesseract/RapidOCR 等。这些模型默认不会随 uvx --from=docling-mcp 自动装好,要单独准备。docling-mcp 提供两条路:
本地模式(local)—— model 装在本机,server 自己跑模型
装 docling 的本地模型依赖(含 PyTorch + docling-ibm-models,首次运行从 HuggingFace Hub 下载布局模型):
# 装 docling-mcp 的 local extra(含 torch/transformers/docling-ibm-models)
# docling 本身默认装就带 torch,这里 local extra 是让 docling-mcp 用本地转换
uvx --from="docling-mcp[local]" docling-mcp-server --transport stdio
首次转换时会从 HuggingFace Hub 下载布局/OCR 模型(几百 MB 量级,缓存到 ~/.cache/huggingface,后续复用)。装好 local extra 后,convert_document 就在本机跑模型解析。
如果在国内下载 HuggingFace 模型慢,设镜像:
export HF_ENDPOINT=https://hf-mirror.com。
远程模式(remote,docling-mcp 默认)—— 不装本地 model,委托 docling-serve 服务
docling-mcp 默认就是 remote 模式,不下载任何本地模型,而是把转换委托给一个运行中的 docling-serve 服务(HTTP API)。配三个环境变量:
exportDOCLING_MCP_CONVERSION_MODE=remote
exportDOCLING_MCP_SERVICE_URL=https://你的docling-serve地址   # 自建或托管
exportDOCLING_MCP_SERVICE_API_KEY=你的key   # 服务需要鉴权时才设
docling-serve 可以自建(uvx --from=docling-serve docling-serve,默认监听 5001 端口,但自建仍要在 serve 端装模型),也可以用托管服务(如 IBM watsonx 上的 Docling 托管实例,注册拿 URL + key)。remote 模式的好处是转换计算在服务端,本机不装 torch、不下模型——适合轻量客户端。
没装 model 时会怎样?convert_document_into_docling_document 工具调用会失败(remote 模式没配 DOCLING_MCP_SERVICE_URL 报服务不可用,local 模式没装 [local] extra 报 ImportError)。但不影响应用启动——initialized: false 守住,握手和 list_tools 正常,只有真正调转换工具时才失败;其他三个场景也不受影响。这就是为什么本篇场景四能验证到"握手 + 工具发现"却没验证"完整转换"——装模型成本较高,留给有环境的读者补测。
我的实跑验证范围:
uvx --from=docling-mcp docling-mcp-server --transport stdio起 server,连上去 list_tools 拿到 20 个工具的真实签名(convert_document_into_docling_document(source)+export_docling_document_to_markdown(document_key, max_size)),握手和工具发现链路验证通过。完整转换文档需要按上面两种模式之一准备模型。
6.8 怎么跑
exportDEEPSEEK_API_KEY=你的key
# 钉钉场景三可选——设了 key 才跑,未设自动跳过只跑场景一/二
exportDINGTALK_MCP_KEY=你的钉钉MCP key
# docling 场景四可选——装了 uv(brew install uv)才跑,未装自动跳过
# 还需 Node.js 18+(Playwright MCP 跑在 npx 子进程里)
# IDE 里直接运行 McpAI.main(),或在 ai-devops 目录跑
6.9 预期看到什么(实测结果)
我实跑了一遍,四个场景全过(设了 DINGTALK_MCP_KEY + 装了 uv 的前提下;未设/未装则对应场景自动跳过):
场景一:问"杭州天气怎么样",模型在本地工具 + MCP 工具并存注册下,自主路由到本地
getWeather,回复了杭州天气("温度体感比较舒适,阴天没有暴晒……")。本地工具和 MCP 工具并存路由验证通过。场景二:让模型用浏览器打开 example.com 截图,模型自主组合调度链
browser_navigate+browser_take_screenshot,成功打开网页、截图保存为example-com.png,还回报了页面标题("Example Domain")、布局(480px 居中卡片)等详细信息。Playwright MCP stdio 链路完全跑通。场景三:让模型列出钉钉云文档里的文件,模型自主路由到钉钉 MCP 的文档列举工具,通过 streamable-http 远程调用钉钉 server 拿到文件列表。钉钉 MCP streamable-http 链路完全跑通——与场景二的 stdio 形成两种传输对称演示。
场景四:让模型列出当前连接的文档解析工具。docling-mcp server 用 uvx 起子进程、stdio 握手、桥接成 ToolCallback 后注册给模型,模型基于工具描述如实列出了
convert_document_into_docling_document、export_docling_document_to_markdown、check/list/remove_document_in_local_cache等工具名称和用途。docling MCP stdio 链路验证通过——握手 + 工具发现 + 模型可见性全部验证;完整文档转换(convert → export两步编排)需装模型后才能跑,见下面「实跑门槛」。
执行结果如下:
场景四,仅查询 Docling 工具而不直接调用模型转换工具,验证外部 MCP 工具链接成功即可: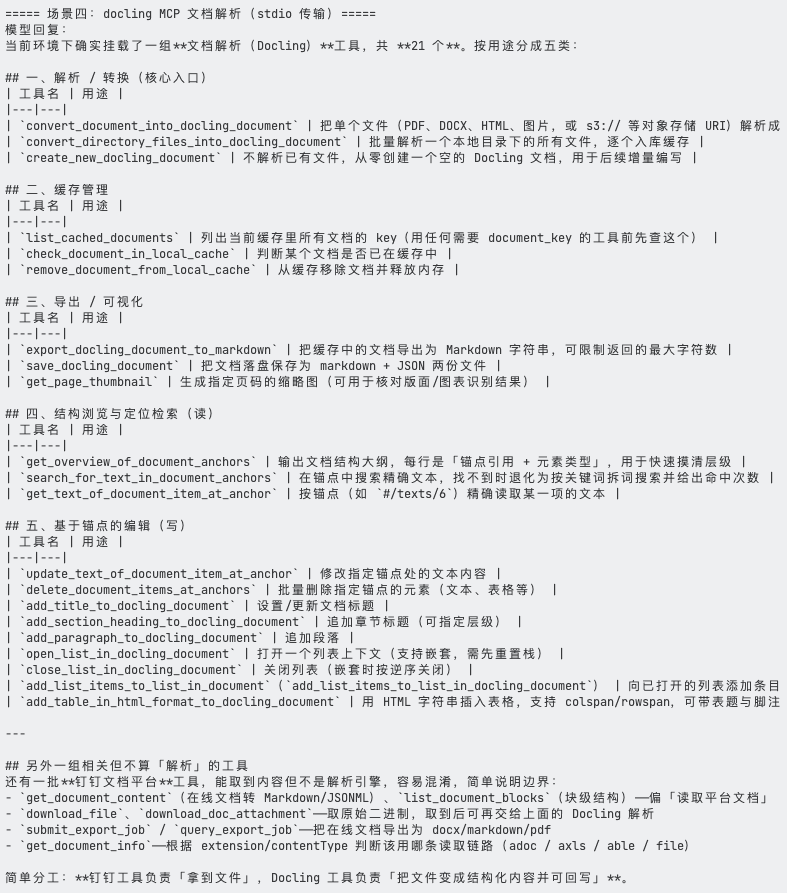
七、改造成接口:McpController
main 方法验证链路通了,下一步改造成 HTTP 接口。沿用上一篇 AIToolController 的多模型路由风格,关键差异:注入 ToolCallbackProvider(Spring AI 自动配置造的 bean,含所有 MCP server 工具)+ 既有本地工具。
ai-devops/.../controller/ai/McpController.java:
@RestController
@RequestMapping("/aidevops/ai")
publicclassMcpController{
privatestaticfinalStringDEFAULT_MODEL="anthropic";

privatefinalChatClient anthropicChatClient;
privatefinalChatClient deepSeekChatClient;
privatefinalWeatherTools weatherTools;
privatefinalShellTools shellTools;

// MCP 工具提供者——Spring AI 自动配置造的 bean
// 配了 spring.ai.mcp.client.* 后,McpToolCallbackAutoConfiguration 自动造
// SyncMcpToolCallbackProvider(实现 ToolCallbackProvider),含所有 connections 配的 MCP server 工具
privatefinalToolCallbackProvider mcpToolCallbackProvider;

publicMcpController(@Qualifier("anthropicChatClient")ChatClient anthropicChatClient,
@Qualifier("deepSeekChatClient")ChatClient deepSeekChatClient,
WeatherTools weatherTools,
ShellTools shellTools,
ToolCallbackProvider mcpToolCallbackProvider){
this.anthropicChatClient = anthropicChatClient;
this.deepSeekChatClient = deepSeekChatClient;
this.weatherTools = weatherTools;
this.shellTools = shellTools;
this.mcpToolCallbackProvider = mcpToolCallbackProvider;
}

@Anonymous
@PostMapping("/mcp")
publicAjaxResultmcp(@RequestParam(required =false)String model,
@RequestBodyChatRequest request){
// ... model 路由 switch 与 AIToolController 一致 ...
// 本地工具 + MCP 工具并存注册,模型自主路由全部工具
String reply = client.prompt()
.user(request.message())
.tools(weatherTools, shellTools, mcpToolCallbackProvider)
.call()
.content();
returnAjaxResult.success(Map.of("reply", reply,"model", resolvedModel));
}
}
与 AIToolController 的唯一区别:调用链多了 mcpToolCallbackProvider——.tools(weatherTools, shellTools, mcpToolCallbackProvider)。模型据此决定调本地工具还是 MCP 工具——问天气调本地 getWeather,问网页操作调 Playwright browser_navigate + browser_take_screenshot,路由决策权在模型。
mcpToolCallbackProvider 不用手动构造——容器自动配置造。这是 MCP 最大的便利:配 yml 就有工具,注入 ToolCallbackProvider 就能用,不用自己写 @Tool。
八、启动验证
接口环境要启动整个 Spring Boot 应用。启动前先 export 两个环境变量:
exportDEEPSEEK_API_KEY=你的key
exportDINGTALK_MCP_KEY=你的钉钉MCP key   # 钉钉云文档 MCP 凭据
# docling 场景四可选——需装 uv(brew install uv),未装则 docling connection 握手失败(不影响应用)
# 启动应用(IDE 运行 RuoYiApplication,或 java -jar)
启动时观察日志,会看到 MCP 客户端自动连接:
Playwright MCP:框架用
npx @playwright/mcp@latest起子进程钉钉云文档 MCP:框架用 streamable-http 连远程 server
docling MCP:框架用
uvx --from=docling-mcp docling-mcp-server --transport stdio起子进程(需 PATH 里有 uvx)
接口验证:
# 场景一:问天气(模型应调本地 getWeather,与 MCP 工具并存路由)
curl-X POST 'http://localhost:8080/aidevops/ai/mcp?model=deepseek'\
-H'Content-Type: application/json'\
-d'{"message":"杭州天气怎么样"}'

# 场景二:让模型用浏览器打开网页截图(模型应调 Playwright MCP browser_*)
curl-X POST 'http://localhost:8080/aidevops/ai/mcp?model=deepseek'\
-H'Content-Type: application/json'\
-d'{"message":"用浏览器打开 https://example.com 截个图给我看看"}'

# 场景三:操作钉钉云文档(模型应调钉钉 MCP 工具)
curl-X POST 'http://localhost:8080/aidevops/ai/mcp?model=deepseek'\
-H'Content-Type: application/json'\
-d'{"message":"帮我列出钉钉云文档里的文件"}'

# 场景四:列出 docling 工具(未装模型,只验证工具发现,不调转换工具)
curl-X POST 'http://localhost:8080/aidevops/ai/mcp?model=deepseek'\
-H'Content-Type: application/json'\
-d'{"message":"你当前连接了哪些文档解析相关的工具?请列出工具名称和用途,不需要调用任何工具。"}'
关于钉钉MCP配置可以查看之前我写的文章【养虾记09】飞书钉钉双渠道Agent实战
钉钉MCP文档地址:https://aihub.dingtalk.com/?ddtab=true&showmenu=false&dd_share=false&authSyncToken=4ba71a3384ad0162436d79d7dd60c541#/mcp-market/detail?mcpId=9629&detailType=instanceMcpDetail&instanceId=2087509&source=MARKET
九、回顾与延伸
9.1 本篇落地了什么
MCP 协议概念:协议不是框架,工具的 USB,server/client/protocol 三要素,stdio 和 HTTP 两种传输
MCP vs CLI 对比:CLI 适合人写脚本确定流程,MCP 适合 AI 自主探索需状态结构化交互——不是替代是互补
Spring AI 2.0.1 MCP 接入:版本陷阱(2.0.1 非混淆)、桥接类
SyncMcpToolCallbackProvider、配置前缀、自动配置链路两种传输实战:stdio(Playwright MCP)+ streamable-http(钉钉云文档 MCP)。main 方法手动构造两种 transport(
StdioClientTransport+HttpClientStreamableHttpTransport)形成对称演示,看清"传输层换、上层不动"的协议分层好处场景四 docling 文档解析:同一个
createStdioMcpClient换个命令就连上 docling-mcp server,验证握手 + 工具发现 + 模型可见性——docling 的 20 个文档工具(convert_document/export_to_markdown等)被正确桥接成 ToolCallback 注册给模型,模型能基于描述列出它们。装好模型后即可让模型自主编排convert → export两步拿文档 Markdown(多工具间 document_key 状态由模型自己传递),这一步留给有环境的读者补测本地工具 + MCP 工具并存注册:模型自主路由全部工具,呼应第11篇集中注册最佳实践
企业级设计:配置外置 + 凭据走环境变量 + 桥接不写执行引擎
9.2 一个关键认知:从"造工具"到"连工具"
第11篇我们自己造工具(@Tool 方法 + 执行引擎),本篇我们连别人的工具(MCP server)。这是"工具调用→智能体生态"的关键一步——不再闭门造车,而是接入整个 MCP 生态。
下一篇我们反向走一步:把自己的工具暴露成 MCP server——让第11篇的天气/Shell 工具能被 Claude Desktop、Cursor 等外部 client 调用。这是 MCP 的另一面,也是企业级 AI 工具对外开放的标准方式。
9.3 延伸学习
MCP 协议规范:modelcontextprotocol.io 官方规范,讲 JSON-RPC 消息格式、tools/resources/prompts 三类能力
MCP server 生态:github.com/modelcontextprotocol/servers 官方 server 列表(filesystem、github、postgres 等)
Spring AI MCP server:
spring-ai-starter-mcp-server-webflux,把自己的工具暴露成 MCP server(第13篇预告)多步推理 Agent:MCP 工具 + 记忆 + 反思循环 = 真·Agent。Java 侧用 Spring AI Alibaba ReactAgent 编排
下一篇预告:第13篇——把自己的工具暴露成 MCP server,让外部 client 能调。从"连工具"到"被连",闭环 MCP 生态。
如果你觉得这篇文章写的还不错,麻烦双击屏幕点个👍、点个❤️、点个转发,你的支持是我继续分享的动力!