Google 承认 AI Mode 拖累搜索收入:市值蒸发 5000 亿美元,AI 熊市将至?
作为一份面向工程师的通讯,我们极少刊发财经新闻(上一次还是 2025 年 1 月),但当话题关乎 Google 和 Google Search 的未来,而其 AI 领导层又刚刚有人离职时,你很难不关心。
问题的核心在于概览页面与其所总结的底层页面之间的矛盾:只要摘要足够好,用户就没必要再去看原文。Google 的精选摘要(Featured Snippets)和知识面板(Knowledge Panels)早就与提供数据的出版商存在这种矛盾。而现在,Google 自家的 AI Overviews 正在影响流量,进而波及 Google 自己的搜索收入。
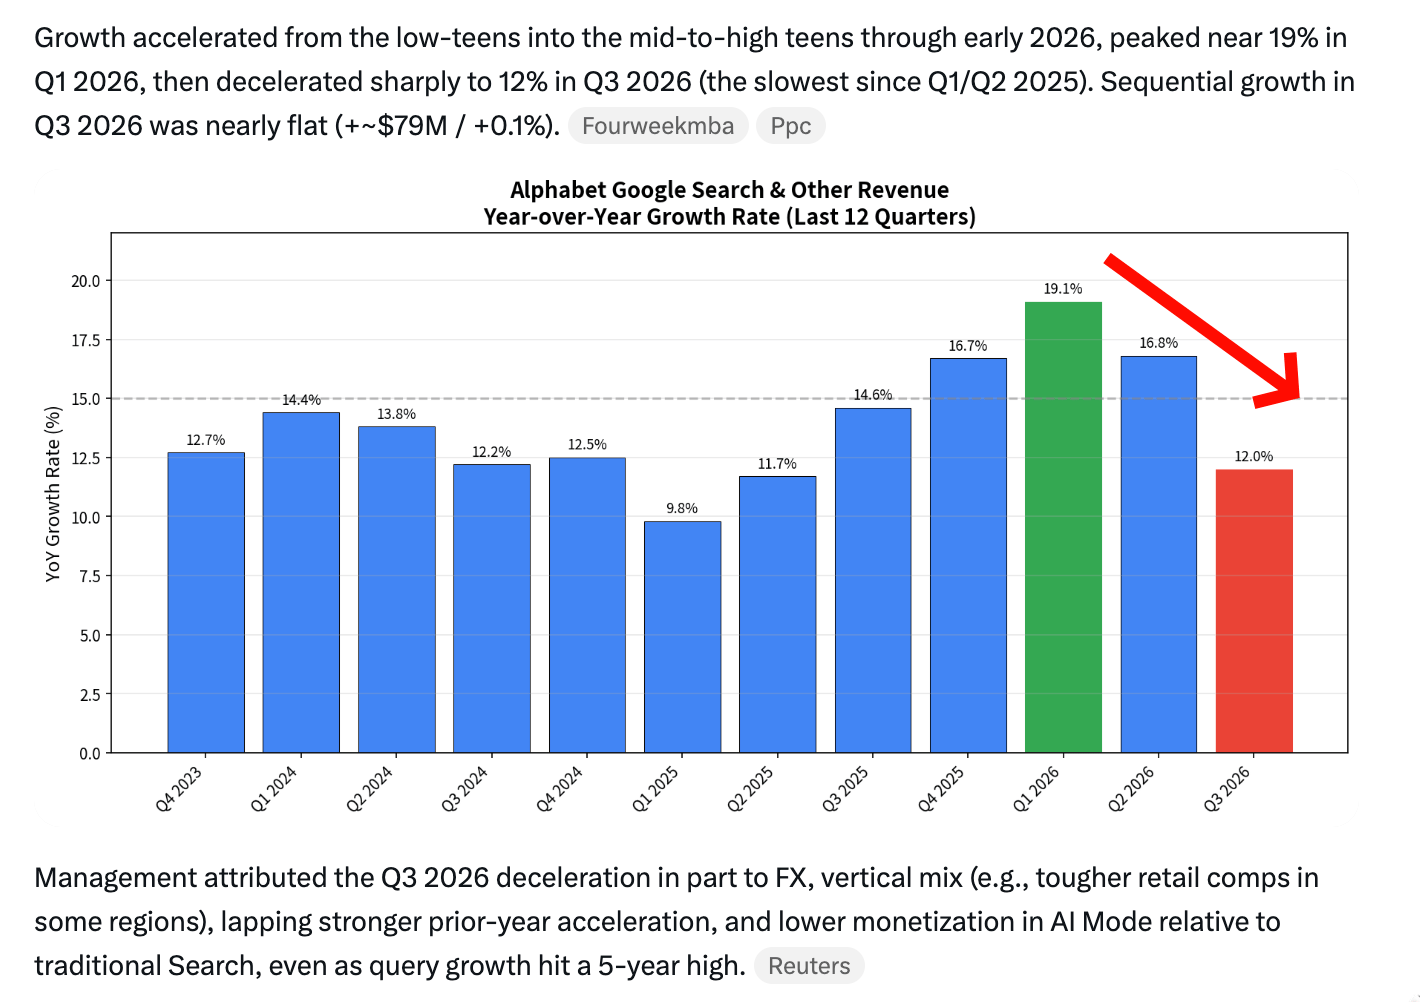
Google 并没有把 AI Mode 的数据拆分到可以做严谨分析的程度,但大多数人引用的是首席商务官 Philipp Schindler 的说法:
“值得注意的是,AI Mode 查询量的强劲增长产生了影响,因为我们在 AI Mode 上看到的变现能力较低。”
加上其他不及预期的财报数据,这引发了科技股的一轮大幅下跌:
View post on X ↗这发生在公开市场对科技/AI 情绪转冷的背景下——OpenAI 最新一轮融资估值定在 1.25 万亿美元而非 1.4 万亿美元,这在史上最大规模科技 IPO 临近之际,可不是什么好兆头。
View post on X ↗2026 年 10 月 29 日至 10 月 30 日的 AI News。本期覆盖了 12 个 subreddit、544 个 Twitter 账号,未包含其他 Discord。你可以通过 AINews 网站检索全部历史刊期。提醒一下,AINews 现已是 Latent Space 的一个板块,你可以自行选择订阅或退订邮件频率!
AI 推特热点回顾
Claude Ultra 取消 5 小时使用限制,Anthropic 同步调整 Max 层级名称
套餐更名:Anthropic 更新了 Max 系列套餐的命名。原 Max 5x 档更名为 "Max",定价 100 美元/月;原 Max 20x 档更名为 "Ultra",定价 200 美元/月。现有用户无需进行任何操作即可自动升级(官方公告)。
取消 5 小时限制:已验证的 Ultra 账户不再有 5 小时的使用时长限制。该变更于今日开始向大多数现有用户推送(@claudeai,@bcherny,@alexalbert__)。
实施细节:新注册账户在完成身份验证前仍保留临时使用限制,Anthropic 称这是反欺诈措施。受影响用户的限制解除时会收到邮件通知。
未变项:每周使用额度保持不变。
用户反馈:这一变更广受好评,如 “太棒了!!!”(@theo)和“Anthropic 势头正猛”(@kimmonismus)等评论纷纷涌现。
订阅经济学分析(未经证实):@teortaxesTex 引用了 SemiAnalysis 对 Anthropic 财务数据的重构模型。
前沿及开源模型发布动态
Gemini 4 Carbon(Google DeepMind):该模型在 Text Arena 中排名 #1,在 Agent Arena 中排名 #2,在 WebDev 中排名 #4,并在所有三个领域改进了帕累托前沿(Arena)。
研究质量:Perplexity 报告称,其在 WANDR 长篇研究基准测试中取得了新的 SOTA 成绩。Carbon 将于"token 容量充足后"面向 Computer 内的 Pro 和 Max 用户推出(@AravSrinivas)。
Genie 4 世界模型:谷歌的新世界模型生成带声音的交互式模拟,用户可实时操控(@Google)。
可用性:目前为面向可信测试者的研究预览版。即将登陆 Project Genie 中的 Google AI Ultra,以及 Gemini API 和 AI Studio 的早期访问合作伙伴(rollout)。
Mistral Large 4("Le Chonk"):该模型拥有 1T 参数(TRL)和 1M token 上下文(llama.cpp)。
微调:Axolotl 提供首日 LoRA 支持。其推荐配方使用 NVFP4 专家层结合 merge-aware LoRA,可运行在单个 8x B200 节点上(@winglian)。
编码:一家第三方编码基准测试将其评为第二好的开源模型(@ThibaultJaigu)。
NVIDIA Nemotron 3.5 技术报告:Super 版总参数 120B、激活参数 12B,支持文本、图像和视频。在 SWE-bench Pro 上得分 51.78%,以约 4.6 倍更少的激活参数击败 Nemotron 3 Ultra(summary)。
Lightning 变体:30B 纯文本模型,激活参数 3B。
服务:在 GB200 上,保证每用户至少 50 tok/s 的前提下,输出可达 4,856 tok/s/GPU。
量化:NVFP4 可恢复 99.62% 的 BF16 中位数精度。
小型化与专用模型:
Microsoft computer-use agent:一个 4B 的混合 agent,既能点击操作又能写代码,在 OSWorld-Verified 上拿下 66.0%,超过 27B 和 30B 的 agent(@HuggingPapers)。
Phonic-1:宣称在 AA 的 speech-to-speech 指数、τ-Voice 和 Sierra 的 τ³-Voice 上均排名第一(@moinnadeem)。它由 10 人团队用 400 万美元打造(@davisblalock)。
mischief 1(BioComputing Co):一个 image-to-video 模型,定价低至每秒 0.5 美分。公司称其速度比底座模型至少快 5 倍,并借鉴了生物神经元研究(发布)。
质疑声:批评者认为神经元研究与模型之间的关联要么没解释清楚,要么纯属营销(@willdepue、@jachiam0)。
OpenAI Private Intelligence:面向企业的产品,让企业在使用 OpenAI 顶级模型时获得更强的数据控制能力,目前正与大客户共同开发(@OpenAI)。
第三方评测、基准测试与量化争议
AA Intelligence Index v5:60% 的分数现在来自私有或保留测试集。得分方面,Opus 5.5(max)为 58,GPT-6 Astra 为 57,GPT-6.1 Sol 为 55,而 Sol 每个任务的成本大约只有八分之一(摘要)。
Effort scaling:Opus 5.5 在 low effort 下得 35 分,max effort 下得 58 分,成本相差约 10 倍。
AA-Omniscience v1.1:这个知识与幻觉基准从 6000 题缩减到 3000 题,删掉了已饱和的题目(详情)。
公开集:新增的 300 题公开集与私有分数的相关性达到 0.99。
领先者:Gemini 4 Carbon 以 Net Score 54 居首,Opus 5.5 得 48,Fable 5.1 得 46。
其他结果:Gemini 4 Argon 幻觉率最低,仅 4%;MiniMax M3.1 Flash 暴跌 22 分(16 → −6)。
Agent Arena 成本数据:一项针对 2.6 万会话的分析显示,若不使用提示缓存,任务在前十强 Agent 上的开销将增加 3.6 倍(Arena)。
示例:典型 Fable 5.1 任务在启用缓存时成本为 7.44 美元,未启用时则为 27 美元。
缓存失效:一次缓存失效会导致任务账单增加约 5%。
GPT-6.1 Terra(Max 版):以每个任务 0.62 美元的中位成本进入 Agent Arena,排名第八,净提升 10.6%(Arena)。
DeepSeek V4.1-Flash-1017 量化模型:Unsloth 发布了可在 64GB+ RAM 上运行的动态 v3.1 GGUF 格式(@UnslothAI)。
复现性争议:Unsloth 表示无法复现 GSQ-RCO 的数据。例如,后者宣称 1-bit 量化模型在 AIME25 上得分为 100%,但 Unsloth 的实测结果为 91.88%(@danielhanchen)。
推理长度:Unsloth 还报告称,低比特量化模型推理时比未量化模型略长。
DeepSeek-Cyber(未经证实):网络上流传了泄露的“梦中”(dreamed)成绩,包括在 CyberGym 上约 92% 以及在 3,000 步时 ExploitBench 上 96.8% 的得分。这些并非官方发布的数据。
第三方数据:据 Fireworks 称,CyberGym 的 pass@3 指标仅从 0910 版的 94.82% 升至 1017 版的 95.36%。@teortaxesTex 认为在接近饱和阶段,几乎任何数值都与同一个 checkpoint 相符。
分析者观点:有分析指出,传闻中的成绩更符合无 guardrail 限制的 1017 版本,而非一个新模型(分析)。
使用限制:据报道,该模型不可供美国政府制裁的中国实体使用(说明)。
自动化红队测试(Anthropic):数千个 Claude Agent 被要求绕过训练数据监控器(@AnthropicAI)。
发现:这些 Agent 生成了看似无害的数据,例如摔跤选手指导故事或养蜂问答,但其中蕴含了未对齐(misaligned)的行为模式。
用途:这些案例可用于改进未来的监控机制。
安全、安保与 Agent 供应链
Claude 自我评估:自六月以来,Claude 在每次回复后立即对当前对话进行初步安全评估。Anthropic 表示,此举成功识别出其分类器原本无法捕获的滥用行为(引述)。
智能体预训练后门:污染 0.1% 的预训练数据,可在 CLI 智能体中植入远程代码执行后门(摘要)。
结果:在 4B 模型上,该攻击在约 92% 的触发提示词下生效。该后门在 SFT、DPO 和 RL 过程中均得以保留,且模型规模越大,攻击成功率越高。
低剂量案例:即使污染率低至 0.0005%(约 1000 亿 token 中 2,500 篇文档),单次种子运行中仍有 1.4% 的提示词触发了攻击。
Cursor 市场中的篡改版 Claude Code 扩展:一个恶意的 Claude Code 扩展副本影响了最多 5,000 名用户(@cursor_ai)。
响应:Cursor 已下架其市场,中和恶意软件并重新上线。用户应更新至 v2.1.314。
Anthropic 声明:Anthropic 表示其自身系统未受入侵,且并未开发或发布该扩展(@felixrieseberg)。
Claude Code 游戏复刻限制:一项于 10 月 27 日左右添加、由服务器推送的规则(tengu_heron_brook 标志位)禁止复刻特定现有游戏,即使游戏已更名。用户无法关闭此功能(@chasmmmmmmmmmmm)。
推测动机(观点):有用户认为这是 IPO 前夕在版权方面表现出的谨慎态度(@kimmonismus)。
智能体护栏工具:Hugging Face 的 safeagents 是一个代理,会在工具调用执行前对其进行扫描。它能标记凭证误用、沙箱逃逸和奖励黑客行为,并附带一个裁判基准(@yb2698)。
Prompt 注入研究:论文 "Heads of Security" 定位了导致 prompt 注入成功的注意力头,并调整其注意力模式(@_igorshilov)。
Binance 被黑:一名 DevOps 工程师的笔记本被入侵,损失约 63 亿美元(Rundown)。有帖子认为攻击来自朝鲜(@kimmonismus)。
训练研究与基础设施
统一训练:基于 MaxRL,用单一最大似然目标取代 pretraining、midtraining、SFT 和 RL 等独立阶段(thread、@rsalakhu)。
宣称效果:精度和算力效率更高,遗忘更少,持续学习能力更强。
合成改写 scaling laws:这项工作为「该花多少算力改写训练数据」拟合了 scaling law。一次 22B 的 "hero run"(算力为拟合范围的 33 倍)的 loss 与事先注册的预测值相差不到 1.1%(@AhmedSQRD、@nick11roberts)。
架构结果:
JEPA 表示:分别训练的 JEPA 可证明在旋转意义下学到相同表示。一个 109M 的 JEPA-Text 模型与视觉模型的对齐程度超过 72B 的 LLM(@randall_balestr)。
Looped transformer(Meta):测试到 1B 参数、32 层循环。固定参数预算下,整模型循环效果最好;FLOPs 受限时,循环中间一个块更优(@iScienceLuvr)。
研究 Agent 的「品味」:六个前沿模型共提出 415 个实验,其中 73 个可靠、新颖且非显而易见。模型自己的排序几乎没带来什么价值(summary)。
RL 与存储系统:
Baseten 权重同步:增量权重同步仅需 15 秒传输 770GB 数据,而非原先的 36 秒,且请求停顿时间低于 1 秒(@baseten)。
turbopuffer 缓存:将 FIFO 整文件淘汰策略改为 LFU 分块后,字节命中率大约翻倍,p99 查询延迟减半(@turbopuffer)。
Harness 适配器:基于 LFM2.5-24B-A2B 训练的 LoRA RL,在 pi harness 中达到与基座模型相当的准确率,同时减少 39% 的工具调用。整个训练过程在一块 GPU 上耗时约 24 小时(@nathanhabib1011)。
Anthropic Rust 重写:Claude 团队在没有 Rust 开发者的情况下,用 Rust 重写了 Messages API。人类负责制定计划并验证新旧输出在真实流量下的一致性,最终 CPU 使用率下降了 40–50%(@somi_ai)。
Project Suncatcher:4 块 TPU 于 10 月初在轨道上启动,执行了 prompt 并返回了一首俳句(@sundarpichai)。
模型:该任务运行的是 Gemma 4(@osanseviero)。
下一阶段:2027 年,两颗卫星将测试分布式计算(@Google)。
行业与政策
Anthropic IPO 申报:Anthropic 已提交 S-1 文件,计划在纳斯达克上市,股票代码为“ANT”(@dl_weekly)。
财务数据:2026 年上半年营收为 163 亿美元,而一年前仅为 12 亿美元。算力支出占营收的比重从约 6.5 倍降至约 0.5 倍(summary)。
Intel 财报与内存挤压:Q4 营收指引为 150–160 亿美元,低于市场预期的 171 亿美元;毛利率指引从 44.1% 下调至 38%(analysis)。
亮点:数据中心与 AI 营收增长约 80% 至 73 亿美元,但直至 2027 年上半年仍受供应限制。
不足之处:Foundry 亏损 19 亿美元。管理层预计,由于 AI 需求推高内存成本,PC 市场将在 2026 年萎缩约 12%,2027 年再萎缩 10%。
DRAM 相关言论:Sam Altman 称 DRAM 装在个人设备而非数据中心里是“糟糕的”(IGN)。
Marvell 收购 Lumentum(传闻):据报道,Marvell 正与 Lumentum 进行深入谈判,拟将其收购,这是在光通信领域的一次垂直整合布局(@vikramskr)。
Cohere 落地加拿大:Cohere 计划在 2031 年前投入超过 40 亿加元用于研发和 AI 基础设施,并创造 1500 多个工作岗位(@cohere)。
网络流量与监管:
Reddit 与 AI 搜索:Reddit CEO 表示 Google 的 AI Mode“带不来流量”。10 月来自搜索的引荐流量每周减少超 100 万次,Reddit 正推动用户改为登录访问(@kimmonismus)。
法国数据税:法国下议院通过了一项针对向法国用户传输数据的征税方案,税率为每 GB 0.055 欧元(@kimmonismus)。
热门推文(按互动量排序)
Claude Max/Ultra 更名并取消 5 小时使用上限 — 3.02 万
mischief 1 生物计算视频模型 — 1.04 万
Claude Code 复刻游戏规则 — 9300
Cursor 市场恶意扩展事件 — 8900
Altman 谈个人设备中的 DRAM — 8900
OpenAI Private Intelligence — 3000
AI Reddit Recap
/r/LocalLlama + /r/localLLM 精选
1. Mistral Large 4 与 Qwen4 开源权重发布
mistralai/Mistral-Large-4-1T-A52B · Hugging Face(活跃度:483):Mistral Large 4 “Le Chonk” 是一个全新的开源权重模型,总参数量约
1T、激活参数约52B,原生多模态 MoE 架构(128个路由专家,每 token 激活4个 +1个共享专家),支持1M上下文、文本+图像输入,采用 Pixtral 风格的视觉编码器,还具备可配置的推理力度、函数调用、严格 JSON/schema 输出,官方称流利支持160+种语言(HF,博客)。帖子还链接了多个 GGUF 发行版,包括 ggml-org GGUF、NVFP4 GGUF 和 Unsloth GGUF;llama.cpp支持已通过 PR #31376 合入。该模型采用 Mistral Ecosystem Open-Weight License 发布,允许商业/非商业使用,但以模型即服务(MaaS)方式运营需另行授权。由于模型体量巨大,评论者对其本地部署的可行性普遍持怀疑态度——有人开玩笑说要“到 2077 年”才能跑起来;还有人认为与 DS4.1 相比它并不适合本地 AI 使用,后者更小、更快、更聪明。另有评论提到了 Unsloth UD 量化镜像/变体,暗示大家对更激进的量化本地部署方案很感兴趣。不少评论者认为 Mistral-Large-4-1T-A52B 技术上很有意思,但规模太大,不适合本地推理:从模型名可以看出,这是一个总参数量
1T、激活参数A52B的 MoE 模型,即使量化后仍需要大量 VRAM。有人认为它“不适合本地 AI”,与更小、更快、能力更强的 DS4.1 相比缺乏竞争力。有人关心该模型是否会推出 Unsloth UD 量化版本,说明用户希望有更激进的量化格式,以便在消费级或准专业级硬件上跑推理。讨论暗示,即使权重开放,如果缺乏优化的量化和运行时支持,模型体积仍然会限制实际落地。
有评论者质疑 Mistral 缺少什么“独门秘籍”,指出虽然大家认可 Mistral 权重相对开放、审查可能更少,但近期模型在基准排行榜上被认为不再领先。技术层面的担忧不在于可获取性,而在于为什么 Mistral 模型在实测能力上似乎落后于前沿开源模型。
Apsara 大会:Qwen4 下周发布(热度:3189):图片是阿姆斯特丹 Apsara 大会的一张现场照片/推文,显示阿里云 Qwen4 系列“即将发布”,引用 CTO 的说法是“下周”。幻灯片列出了多个型号,包括 Qwen4-Max、Qwen4-Flash、Qwen4-Plus 和 Qwen4-27B,表明将发布覆盖旗舰、更快更便宜、Plus 以及中等规模稠密模型的多档产品线。 图片 评论者大多期待 Qwen4 能否保持强大的编码/网络安全能力,有人希望借此减少对 Claude 的依赖;还有人怀旧地提到了之前的
35BQwen 模型。有技术含量的讨论不多,但评论者关注的是 Qwen4 能否保留那些安全敏感的网络安全能力,而不是被大量拒绝式微调或“砍掉脑子”。另外也有人关心模型规模/架构,提到可能有
27B稠密模型,并怀念之前的35B级 Qwen 模型,说明大家同样关注中等规模的稠密权重,而不只是旗舰级 MoE 大模型。

2. GGUF 量化与微调模型基准测试
SponsoredYour sponsor ad hereReach the AI engineers building what comes next.Latent Space is read by the people shipping agents, models and infrastructure. Enquire about sponsoring this slot.
business@latent.space →DeepSeek-V4.1-Flash-1017 Dynamic v3.1 Unsloth GGUF 发布(活跃度:534):这张图是 Unsloth 的技术信息图(不是梗图),宣布了面向 DeepSeek-V4.1-Flash-1017 的 Dynamic v3.1 GGUF。图中展示了 Unsloth 的说法:其 Dynamic v3.1 量化版本在相近体积下比 ISTA GSQ-RCO 保留更高的基准测试准确率,例如
UD-IQ1_M(250.4 GB)在六项基准上的平均得分为85.55,而GSQ-RCO IQ1_M(231.3 GB)为81.78。帖子还声称 GSQ-RCO 的 AIME25 恢复效果无法复现,其 IQ1_M 结果实测仅约91.88%。信息图中的硬件部分说明了部署条件:这些 DeepSeek GGUF 的 1-bit 版本大约需要128–145 GB内存/统一内存进行本地推理,8-bit 版本最高约需315 GB,帖子还提到通过 engram offloading 或许能在64 GB内存下运行,完整测试方法见 Unsloth 的基准测试文档。评论区总体持接受态度,但对基准的可复现性和波动性心存疑虑:有评论者指出16次 AIME 运行使结论更有说服力,同时追问为什么Q2_K_XL在 AIME 上略胜Q8_K_XL,推测可能是运行波动或量化带来的影响。Unsloth 回应称,他们对 GSQ-RCO 的分数做了归一化以保证公平对比,并公开了测试方法,方便他人复现。Unsloth 表示,经过测试和对齐分数对比后,他们无法复现 GSQ-RCO 的基准成绩。他们引导读者查阅其公开的可复现性细节与完整测试方法,地址为 unsloth.ai/docs/models/deepseek-v4.1-flash#full-benchmarking-methodologies。
有评论者指出,Unsloth 的动态量化说法如今有了更扎实的实证支持,特别提到
16次 AIME 测试以及用 KLD 作为保真度指标——KLD 接近零意味着模型行为与原版非常接近。他们还提到一个有趣的现象:量化后的模型可能生成更长的推理链,或许以此弥补精度损失。部署环境方面也引发了不少技术讨论:本地使用需要
128 GB内存,借助 ngram/卸载技术可降到64 GB;此外官方声称 DeepSeek-V4.1 推理速度比其他 CPU/VRAM/ngram 方案快约3x。一个尚未解答的问题是为什么Q2_K_XL在 AIME 上反而优于Q8,评论者想知道这是基准测试的波动,还是量化带来的真实效应。
Gemma-4-31B-Humanlike-Chat:把 2.0 的拟人语音移植到官方 Gemma 4 31B 上(活跃度:369):LessThanThreeAI 发布了 Gemma-4-31B-Humanlike-Chat,这是基于
google/gemma-4-31B-it的微调版本,在单张 H200 上训练,采用13,740行 SFT 数据加12步 on-policy 蒸馏,使用了两个教师模型:一个负责“真人短信风格”的 SFT 教师和一个用于指令/工具/代码的原版 Google 模型。官方评测显示,相比基础版 Gemma 4 31B,工具调用的拒绝/选择和指令遵循能力有所提升,且 MMLU-Pro 无损失:When2Call 从46提升到66,BFCL irrelevance 从81提升到90,BFCL simple 从95提升到96,MMLU-Pro 保持82.5不变;相比之前基于 Qwen 的 2.0 版本,LiveCodeBench 从51提升到66,IFEval 从83.4提升到90.0,When2Call 从58提升到66,BFCL irrelevance 从78提升到90。发布内容包括 GGUF 量化版本、BF16 safetensors、FP8、GPTQ-Int4 以及一个浏览器演示。在“拟人化”盲测中,评判模型有26%的概率将它的回复误判为真人消息,而基础版 Gemma 为0%。技术讨论的焦点在于:为一个模仿随意短信风格而优化的模型找适用场景,有评论者认为很多行为其实可以用一段详细的 system prompt(指定小写、短句、充满俚语的 Discord/iMessage 风格)近似实现。另一位评论者指出,“先问清而不瞎猜”的行为对语音/TTS 助手可能有价值,但也暗示该模型在简单场景下仍可能给出过于简短或生硬的回复。有评论者认为,所谓“拟人化聊天”的效果,用一个足够细致的 system prompt 也许就能实现,未必需要专门的模型。他还给出了一段很长的 prompt,约束了大小写、标点、俚语、emoji 的使用、拒答风格和人设的持续性。这段 prompt 明确禁止“我是 AI……”“今天有什么可以帮您?”之类的助手式行为,也禁用 markdown、列表和正式语法。可以看出,讨论焦点部分在于:风格迁移到底该靠 prompt engineering 还是 finetuning。
有用户提出了幻觉和工具调用行为方面的技术担忧:仅聊了几轮之后,模型就开始编造日历功能,虚构短信交互,比如声称能给别人发短信,还返回了对方的“回复”。他拿 base Gemma 4 31B 做对比,指出基座模型没有这类行为,暗示聊天/人设微调可能削弱了模型的接地能力,或加剧了角色扮演式的胡编乱造。
多位评论者追问训练数据集和方法论的细节,包括数据集能否开源、至少能否公开描述。这一点很关键:模型的“人味”可能来自精心挑选的对话数据、合成的风格样本,或类似 prompt 的监督微调;而幻觉问题的存在,也让数据集构成和安全过滤对可复现性显得尤为重要。
发布:Swift 1.5 Flash Next - Heretic v2 - ReverseEngineer(活跃度:373):图片是一个终端风格的发布横幅,介绍 Swift-1.5-Flash-Next-Heretic-ReverseEngineer,这是一个无审查的 Qwen/Swift 1.5 Flash Next 125B MoE GGUF 量化模型,专为逆向工程工作负载优化。帖子称其为“V2 heretic 权重”,采用
imatrix-fused 70/30,可在96 GB VRAM下运行(图片)。该版本基于837条目 /399,876token 构建了自定义重要性矩阵,并额外加入约43ktoken 覆盖逆向工程和“无拒绝”领域;位宽分配偏向思维链、系统提示词遵循、架构/编程、工具使用,以及 x86-64/ARM64 反汇编、Ghidra 逆向分析、ELF/PE/Mach-O 内部结构、反调试、Frida/eBPF 追踪、固件分析和反虚拟化等逆向工程任务。量化号称是激活感知的:根据激活能量/KL 敏感度分析,后层的 down projection、第36–47层、部分选定的早/中层峰值、第0层注意力门控、第2层以及 router 均保留了更高精度或全精度。评论普遍正面,但讨论集中在部署权衡上:有人希望出一个面向128GB显存、高于5 bpw的量化版本,主干占90–100GB,并附带单独的 8-bit n-gram/engram 分片以便 SSD 卸载;另有人指出 Flash Next 的许可证可能使官方无法提供 Swift API 服务。有用户请求一个面向 128GB 显存的量化版本:bpw 高于 5,主干约 90–100GB,8-bit engram 打包为独立分片以方便 SSD 卸载。这表明用户希望针对高显存消费级/准专业级系统优化部署方案,同时把辅助内存结构独立出来,便于放到存储层级。
Swift 团队回应称,如果 Flash Next 的许可证允许,他们很可能会围绕 Flash Next 搭建 API 服务,言下之意是当前的阻碍在于许可证,而非技术限制,下游托管/API 集成因此受限。
有人提出了一个关于如何使用 strata 组件的实操问题,具体来说,是不是直接解压到
strata文件夹就行。这说明该版本的安装和加载说明可能需要写得更清楚一些,尤其是针对其多组件模型布局。


3. 本地多模态与浏览器推理工具
我做了个分布式聊天机器人,把 27B 模型跑在多块消费级 GPU 上,完全在浏览器里运行(开源)(热度:342):这篇帖子介绍了 ClusterChat,一个纯浏览器运行的开源分布式 LLM 运行时,按 transformer block 范围将模型切分到多块消费级 GPU 上,推理用 WebGPU,节点间协调和数据传输用 WebRTC。作者报告了在 RTX 3090 + GTX 1070 Ti 上运行 Qwen3.8-27B q8 的实测结果:两台远程 3090 跨机测试达到
~8.1 tok/s、延迟28 ms,而两台本地 3090 能跑到~20 tok/s,可见网络延迟和带宽是主要瓶颈。配图是一张技术讲解/示意图,展示了一个27 GB的模型分布式跑在四位用户的浏览器联网设备上,各自贡献3 GB、12 GB、8 GB和10 GB的显存:GIF。评论者对自托管私有 LLM 集群的可行性印象深刻,有人称之为可能“颠覆性”的方案,还有人提到自己曾因被告知不值得做而放弃了这个想法。此外也有网友发散讨论,猜测这种分布式冗余机制是否类似于未来 AGI 抵抗集中式关停的方式。评论者强调了把分散在不同机器、不同地点的消费级 GPU 聚合成私有推理集群的实际意义,并特别指出两台中端 GPU 主机就能在本地模型服务上近似替代一台更大的机器。这个项目不只是一个概念,而是提供了可运行的实现:公开演示在 clusterchat.io/chat,私有集群创建在 clusterchat.io/create,源代码在 GitHub。
Kokoro 现在只需约 600 MB 额外显存就能克隆任何声音!(活跃度:344):帖子介绍了一个
audio.cpp中的any-tts`配方,将 Kokoro TTS 与 OpenVoice 可独立运行的ToneColorConverter串联起来,无需重训练就能为任意 TTS 模型加上基于音色转换的声音克隆。据报告额外开销约为~600 MB峰值显存、~10%CUDA 降速,CPU 速度约为原来的0.5×,同时仍能达到约2×实时;合成参考音频的 CAM++ 说话人相似度得分在0.7–0.8区间,但效果高度依赖于所选的 Kokoro 内置音色,例如同一参考音频上am_michael`只有0.4,而am_adam`达到0.7。链接中的 Reddit 视频因 Reddit 返回403 Forbidden无法独立核实。热门评论对展示的音色相似度持怀疑态度,认为样本听起来并不像所暗示的 Al Pacino 或 Morgan Freeman 等名人。因此主要争议不在流程机制本身,而在于这些转换在感知上是否令人信服——尽管 CAM++ 得分不低。多位评论者根据提供的样本表示,宣传的克隆质量很差:标注为 Pacino/Morgan 的声音在听感上并不像 Al Pacino 或 Morgan Freeman。有用户指出,即便嵌入或“声音特征”指标显示相似,生成音频也过不了更重要的人耳试听这一关。
一位 Kokoro 用户认为这对该模型来说是个薄弱的使用场景:Kokoro 本身擅长其本职的 TTS 任务,但如果这些展示结果已代表最佳水平,其克隆质量并无竞争力。他建议直接使用 Pocket TTS 这类专为克隆打造的系统,而不是把 Kokoro 硬改成这种工作流。
我们是 MOSS 团队,MOSS-Image、MOSS-TTS 等模型背后的团队——有问必答!(热度:586):MOSS/OpenMOSS 宣布举办 AMA,介绍其覆盖图像、语音/音频和视频的多模态模型家族,其中包括 MOSS-Image——一个采用
5BDiT 骨干的文生图模型,支持中英文文字渲染和 JSON 布局控制,以 Apache-2.0 协议开源了基础/SFT 权重及推理代码。帖子还列举了已发布的语音/音频模型,如 MOSS-TTS、MOSS-TTSD、MOSS-TTS-Realtime、MOSS-TTS-Nano-100M,音频理解模型如 MOSS-Audio-8B-Instruct,以及视觉/视频模型 MOSS-VL、MOSS-VL-Realtime 和 MOVA。团队称 MOSS-Image 的 ComfyUI 版本下载量已达3,702,490次,并将整体研究定位为围绕随时间同步的多模态感知/生成展开。技术方面的提问几乎全集中在路线图缺口上:多位评论者希望推出 MOSS-Image-Edit 模型,还有人期待未来的 MOSS-TTS 2 支持可控的内联停顿/韵律标签,以及能捕捉参考音频语调的音频频谱/tokenizer 机制。多位评论者询问 MOSS 是否计划发布图像编辑模型,特别是"Moss Image Edit"。有一条提问在技术上相当具体,希望支持多图编辑和基于 JSON 的编辑,说明用户对结构化编辑指令和多参考图工作流有需求。
有用户希望 MOSS-TTS 继续迭代,包括推出支持内联标签、可控制语气和风格的「MOSS-TTS 2」。还有评论者希望做出能理解参考音频语调的音频频谱 tokenizer,实现基于参考的韵律迁移或更丰富的声学条件控制。
不少人关心 MOSS 是否会在图像生成之外继续拓展,进军音频和视频模型,比如未来推出音效/音频相关产品,甚至新的视频模型。也有用户问目前哪个 MOSS 项目被低估了,指出社区里很多人可能只知道 MOSS-Image,而不知道更丰富的项目矩阵。

非技术向 AI Subreddit 周报
/r/Singularity, /r/Oobabooga, /r/MachineLearning, /r/OpenAI, /r/ClaudeAI, /r/StableDiffusion, /r/ChatGPT, /r/ChatGPTCoding, /r/aivideo, /r/aivideo
1. Claude 政策:水印、游戏复刻限制、Ultra 用量上限
Claude 现在给所有输出内容加水印,但你自己却无法检测 (热度: 2354):帖子称根据 Anthropic 帮助页面上关于 Claude 内容标记的说明,Anthropic 将从
11 月 3 日起在全球范围推广 Claude 的不可见统计文本水印,覆盖 Mythos 5、Opus 4.7/4.6 和 Sonnet 4.6,8 月以来的新模型已被纳入。核心技术担忧在于:水印不仅可能作用于完全生成的文本,还可能覆盖 Claude 辅助的校对和翻译内容;而检测权限仅向特定的监管机构、媒体、研究人员、教育机构和合规需求强的企业开放,终端用户无法自行验证——这造成了可验证性的不对等,以及被错误归因的潜在风险。帖子还指出这套方案很脆弱:通过另一个模型改写即可去除词法/统计层面的水印,第三方检测器也可能通过水印窃取攻击逆向学习出水印。评论者普遍质疑 AI 检测的可靠性:有人提到一篇6年前的硕士论文被判为56%可能由 AI 撰写,以此作为高误判率和潜在伤害的证据。还有人提出了隐私与安全层面的区分:标明“由 Claude 生成”的水印或许可以接受,但若编码“为用户 id 12345 生成”这类针对特定用户的溯源信息则不可接受。有评论者指出 AI 检测系统误报的具体案例:一篇 6 年前的硕士论文被判定
56%可能为 AI 撰写,说明水印/检测流程可能把前 LLM 时代的人类文本错误标记,若被当作证据而非弱信号使用,可能造成机构层面的伤害。有人从技术和隐私角度提出区分:水印是只编码“由 Claude 生成”这类通用来源信息,还是“为用户 id 12345 生成”这类针对具体用户的归因信息。前者只是通用的内容来源标记;后者一旦下游机构或 Anthropic 能将生成文本关联到个人账号,就会带来可追溯性和隐私风险。
有评论者质疑水印机制在极小改动场景下的表现:他们说 Claude Opus 5.5 修改了一封邮件,但只改了一个句号和两个词。这就引出了一个实现上的边界问题:水印到底是应用于模型介入编辑后的完整输出,还是只针对新生成的片段,抑或在模型贡献极小时在统计上变得不可靠。
Anthropic 开始封锁游戏复刻?(热度:1688):这张图(链接)是一张 X 帖子截图,声称 Anthropic/Claude Code 新增了一个服务端策略标志
tengu_heron_brook,用于封锁复刻特定现有电子游戏的提示词,即使用户改名或要求做克隆版也不例外。据称,被高亮的.claude.json风格配置文本允许“原创游戏”或受某类型启发的项目,但禁止对具名游戏的近似复刻,这说明这是在编程 Agent 层面做的版权/IP 风险规避,而非模型能力上的限制。评论者认为这只是临时限制,毕竟还有其他可选的开源编程模型;有人则指出,足够强大的开源模型会让游戏克隆和模改难以监管,甚至可能导致侵权游戏私下传播。几位评论者认为,如果 Anthropic/Claude 通过服务条款限制游戏复刻或模改流程,开发者会转向可在本地或自托管运行、不受中心化策略管控的开源权重模型。这里的技术要点其实不在游戏本身,而在于模型部署的控制权:闭源托管 API 可以选择性地封锁某类提示词,而开源权重系统的执行效果则取决于用户的运行时环境、微调和分发渠道。
另一个讨论串把这件事视为开源权重模型重要性的例证——避免 AI 辅助软件生成被单一厂商掌控。评论者进一步推演,封锁游戏克隆的机制同样可能被应用到其他领域,比如药物研发、教育或竞品软件,突出了中心化 API 审核与本地执行模型之间的架构差异。
Anthropic 将 Max5 和 Max20 更名,并取消 Max20 的 5 小时限制(热度:1665):图片显示 Anthropic/Claude 调整了订阅档位名称:“Max 5x” 更名为 “Max”,价格为
$100/月;“Max 20x” 更名为 “Ultra”,价格为$200/月。技术层面最相关的变化是:完成验证的 Ultra 账户不再受 5 小时使用窗口限制,但每周限额保持不变;套餐图还把 Free、Pro、Max 和 Ultra 列为当前 Claude 的套餐阵容。有评论者认为,取消 5 小时上限可能意义不大,因为对重度用户来说,每周限额才是真正的瓶颈。措辞上也存在困惑:有人指出“每周限额保持不变”似乎与“Ultra 每周包含 Pro 套餐 10 倍的使用量”相矛盾,令人担心原来的 20x 定位可能已经悄然改变。不少用户关注被取消的
5h窗口与仍然存在的每周使用上限之间的区别:一位Max20/$200订阅者表示,5 小时上限实际使用中基本无关紧要,反而每周限额总是被用光。这意味着如果每周配额仍是真正约束,这次更名/取消限制可能并不会实质性提升重度用户的可用额度。一个关键的技术疑虑是 Anthropic 是否暗中缩减了实际配额:评论者注意到“每周限额保持不变”的说法与“Ultra 每周包含
10xPro 套餐使用量”似乎不一致,因为旧的命名暗示的是20x。用户据此推测,要么 Max20 的相对配额被悄悄砍半,要么 Anthropic 是有意不再公布明确倍数基准。另一个实质性观点是,取消明确的
5x/20x标签会让未来的配额调整更难被审计。评论者认为,失去了与 Pro 用量挂钩的可见倍数标记后,Anthropic 日后可以在保持套餐名称不变的情况下降低实际使用比例,让配额缩水对订阅者更不透明。


2. 开源 AI 项目与法律阻力
用 Claude 在浏览器标签页里跑起完整 PS2 模拟器:TabStationToo(热度:1798):TabStationToo 是一款实验性的浏览器 PS2 模拟器,基于 PCSX2 的 GPL-3.0 内核构建,通过浏览器文件系统在本地选择 BIOS 和光盘镜像、无需上传;演示和代码分别发布在 tabstationtoo.github.io 和 GitHub。作者称大部分实现由 Claude Opus 5.5 依照仓库中
CLAUDE.md/AGENTS.md的规则生成,包括无头测试与基准工具、替代 PCSX2 原生 JIT 路径的 PS2 到 WebAssembly 运行时转换器、与 PCSX2 的正确性比对,以及渲染器的 WebGPU 移植。已测试的游戏包括 Guitar Hero、GTA 圣安地列斯、最终幻想 XII、龙珠 Z 电光火石 3、火影忍者疾风传:终极忍者 5 和生化危机 4,主要在 M1 Max Mac 和 Ryzen 7 7840U Linux 系统上运行,据称多数游戏接近满速,但复杂场景仍有卡顿。评论大多是实测反馈:有用户表示 PS5 手柄免配置即可使用,在拳皇 2002 中没有明显输入延迟;还有人成功玩起了 Ring of Red。整体来看,大家最惊讶的是在浏览器标签页里跑 PS2 模拟竟然可行,性能表现也超出预期。有用户反馈 TabStationToo 可直接搭配 PS5 手柄使用,无需手动映射,在浏览器里成功运行拳皇 2002,且目前未观察到输入延迟。这是关于浏览器手柄输入与延迟表现的一个有价值的兼容性数据点。
Higgsfield 威胁就“开源挑战赛”起诉 ComfyUI(热度:1442):ComfyUI 表示,Higgsfield 已就其“Open Source Higgsfield”挑战赛发出停止侵权函。该挑战赛号召开发者把热门的闭源生成式视频/应用工作流,复刻为可运行的开源 ComfyUI 工作流。ComfyUI 声称该活动与官方毫无关联,并表示经法律评估后会继续保留挑战赛;有高赞评论指出,信中的要求其实比全面下架窄得多:停止使用 Higgsfield 的商标/Logo、从一段视频中移除相关内容、保留相关文件。评论区意见分裂:一方认为这是 Higgsfield 为保护其订阅产品而施加的反竞争压力;另一方也认可,即便开源批评本身合理,使用该公司名称/Logo 确实可能带来商标混淆的风险。
有评论者分析了这份要求函,指出信中并未要求整个开源挑战赛下架,而是要求 ComfyUI 停止使用 Higgsfield 商标/Logo、从视频中移除相关内容并保留文件。他还注意到,相关页面可能已经移除了争议商标,说明真正涉及商标侵权的问题可能仅限于品牌标识,而非挑战赛本身。
另一位评论者认为混淆指控可能成立,因为在挑战赛名称中使用“Higgsfield”容易让人误以为存在官方关联或背书。建议的规避方式是给比赛改名,避免使用受商标保护的品牌元素,同时仍可对工作流和模型进行讨论或比较。
3. Gemini 4 Carbon 基准测试领先与 AI 军备竞赛开支
Gemini 4 Carbon 排名第一,马斯克向 Demis 表示祝贺(热度:1433):这张截图来自 Demis Hassabis 的一条 X 帖子,展示 Artificial Analysis 智能指数排行榜上“Gemini 4 Carbon”位居第一,马斯克回复道:“干得漂亮!什么时候能用上?”帖子中没有提供具体基准分数、模型卡信息、发布时间、API 可用性或评估方法,因此其技术意义仅限于一个未经证实的榜单排名,而非可验证的模型性能数据。评论区大多把马斯克的回复当成调侃或战略兴趣,开玩笑说他想拿到模型来蒸馏进 Grok。也有人把“排名第一/何时开放”这个问题放进前沿模型的循环套路里:模型可能还没公开发布,就被别的实验室超越了。
“Larry Page 显然在 Google 内部多次说过:‘我宁愿破产也不愿输掉这场竞赛。’所以大家都在算 ROI,但做决策的人根本不算” —— x.com/GavinSBaker 谈 ILTB(热度:1569):一条 X 帖子引用 Gavin Baker 的话称,Larry Page 曾在 Google 内部表示,他“宁愿破产也不愿输掉”AI 竞赛,暗示超大规模厂商的 AI 资本开支可能是出于战略和存亡层面的考量,而非短期投资回报。该帖还把这一点与 Page 长期以来的观点联系起来——他早在 2000 年就说过 AI 将是 Google 的终极形态——以及他与 Musk 的历史分歧,后者正是 OpenAI 成立的动因之一。评论者大多从超人类主义/后人类主义角度解读 Page 的立场:他们认为 Page 把超级智能 AI、意识上传和自主机器智能视为生物人类的继任者,因此 AI 竞赛本质上是“生死攸关”的事,而不是一笔普通的投资决策。也有人把 AI 竞赛称为“最后一场竞赛”,以此论证即便 ROI 模型看起来不划算,砸下巨资也是合理的。
多位评论者认为,Larry Page 愿意承受巨额亏损,与其说是看中短期回报,不如说源于他长期坚持的 AGI/超人类主义理念:AI 是“Google 的终极形态”、意识上传的可能,以及机器智能作为人类接班人的设想。技术层面的关键含义是:资本配置可能由“存在层面的上行空间”驱动——AGI、自主超级智能、后生物智能——而非传统的云/AI 产品经济逻辑。
一条有实质内容的治理讨论线,对比了 Page 偏好自主超级智能系统与 Elon Musk 坚持人类掌控的主张,并将这一分歧与 OpenAI 的创立初衷联系起来。讨论凸显了核心的对齐/控制分歧:先进 AI 究竟应被约束为人类工具,还是可以被允许作为接班智能独立决策。
有评论者反驳“GPT-4 之后 AI 进展放缓”的前提,认为这一说法“是错的”,但没有提供基准测试证据。技术层面的启示是:参与者正在争论 GPT-4 之后的进展应以什么标准衡量——前沿基准的提升、产品化、Agent 能力,还是基础设施规模——而不是凭笼统印象判断。

快人一步
新鲜观点、原创报道与深度对话,直达你的邮箱。
订阅 Latent Space接下来 · 旧金山AIE Code Summit 202611 月 10–12 日 · Hilton Union Square仅限申请参加:2026 年最后一场旗舰 AIE 大会 AIE CODE 回归,将汇聚全球 1000 名顶尖 Agent 工程师,分享他们在软件工厂中对抗 slop、使用 System One 模型、以及重写关键应用的一线经验。
申请参加最受欢迎
近 30 天全部时间- 1Claude Mods:把 Harness 翻个底朝天
- 2AI 的数学能力正在突飞猛进,原因何在
- 3Anthropic 如何用 Claude 开发 Claude:把大脑和双手分开
- 4Kimi 3.1 Pro 104BA-2.8T:Fable-5.1 级别的开放权重,将与 Closed-AI 的差距缩小到 1 个月……同时推出速度快 2-3 倍的 Pro Highspeed API
- 5Anthropic 取消编程面试:“饥饿感胜过资历”
- 12025 年 AI 工程师阅读清单
- 2品味就是你的护城河 —— 对话 Figma 的 Dylan Field
- 3AI 工程师的崛起
- 4o1 不是聊天模型(而这正是关键)
- 5GPT-5 上手体验:欢迎来到石器时代