
PyTorch 2.15:MPS 后端引入 FP8 支持,LLM 解码性能大幅提升
如果你在 Mac 上跑模型,或者把 MPS 当作主要的计算加速工具,PyTorch 2.15 有不少值得期待的更新:MPS 上支持了 FP8,语言模型的解码通过 linear 层和 softmax 获得了更快的路径,新的 Metal kernel 还优化了音频、视频和训练工作流中一些开销高得惊人的环节。
先简单介绍一下我们:我们是 Hugging Face 的 PyTorch 团队。我们持续向 PyTorch 贡献代码,其中一个重点方向就是 MPS 后端,目标是让 Mac 成为运行和训练 PyTorch 模型的一等公民。2026 年初的时候,在 MPS 上哪怕跑一个小模型,也常常要绕开各种不支持的算子、性能断崖和诡异的内存增长。于是我们把 Hugging Face Hub 上的真实模型(涵盖语言、图像、视频)在 MPS 上跑一遍,找出短板,然后在 PyTorch 上游修复——而且越来越多地直接用专门的 Metal kernel 替换 MPSGraph。这篇文章的大部分内容正是这项工作的成果,感谢 PyTorch 维护者和社区贡献者们的通力合作。
要点速览
- Mac 支持 FP8:用
float8_e4m3fn存储数值,空间只需 BF16 的一半,还能使用 scaled 矩阵乘法以及 CUDA/CPU 上已支持的其他所有算子! - MoE 模型解码比 2.14 快 5–6.5 倍:得益于原生的 grouped matmul 配合专门的解码路径、更少的 GPU-CPU 同步以及更快的 top-k 路由,Qwen3.6-35B-A3B 在 M3 Ultra 上从 9.4 提升到 61.3 tokens/s。
- 所有 LLM 的单 token 耗时更低:单行 linear 层改用专门的矩阵-向量 kernel,词表上的 softmax 快了约 8 倍。
- 更多线性代数运算跑在 GPU 上:复数 LU 分解和三角矩阵求解、更快的小矩阵求逆,以及更快的 QR 分解。
- 音频、视频和训练也照顾到了:卷积、padding、dropout、interpolation 反向传播和归约操作都有了更快的路径。Wan2.2 的视频 VAE 解码峰值内存从 270 GiB 降到了 8 GiB。
- Python 侧控制力更强:公开了 MPS streams,事件计时也更可靠。
- 系统要求更新:MPS 现在需要 macOS 15 或更高版本;PyTorch 2.15 需要 Python 3.11 或更高版本。
- 2.16 抢先看:attention 全面迁移到 Metal,更多 MPSGraph 转 Metal 的工作,以及更快的 LLM 解码。
对你意味着什么
如果你在 Mac 上使用 transformers、diffusers 或 ComfyUI 等工具运行模型,以下是 2.15 版本在实际使用中的具体变化:
- 本地 LLM 速度大幅提升。 Mixture-of-experts(混合专家)模型在 2.15 中的解码速度比 2.14 快 5–6.5 倍:在 M3 Ultra 配合
torch.compile下,Qwen3.6-35B-A3B 的吞吐量从 9.4 tokens/s 提升至 61.3 tokens/s,LFM2.5-8B-A1B 从 23.6 tokens/s 提升至 123.6 tokens/s。稠密模型也从中受益,得益于更快速的线性层和用于采样的 8 倍加速 softmax。(详情) - 视频生成内存占用大幅降低。 使用 Wan2.2 的分块 VAE 解码视频时,驱动内存占用从之前的 270 GiB 峰值降至现在的约 8 GiB。(详情)
- 修复 Qwen-Image-2.1 的图像编辑准确性问题。 在 2.14 中,Qwen-Image-2.1 的 VAE 编码器在 MPS 上会静默损坏图像,导致图像编辑工作流失败(ComfyUI 中已报告)。该相同的 padding 修改解决了此问题:编解码往返的 PSNR 从 10.06 dB 提升至 29.95 dB,与 CPU 表现一致。
- Mac 支持 FP8 权重。 FP8 张量占用的内存仅为 BF16 的一半,且
F.scaled_mm可直接在 GPU 上对其进行乘法运算。(详情)
目录
- 快速入门
- MPS 支持 FP8
- 语言模型解码加速
- 线性代数性能提升
- 卷积、Padding 与训练
- Softmax 与归约运算
- 视频解码内存占用大幅降低
- 通过 MPS Streams 获得更多控制权
- MPS 支持更多算子
- PyTorch 2.16 前瞻
- 总结
快速入门
你需要一台搭载 Apple silicon 芯片的 Mac,且系统为 macOS 15 或更高版本,Python 为 3.11 或更高版本(参见 2.15 兼容性矩阵)。如果系统版本过旧或没有 Metal GPU,MPS 可用性检查现在会告知具体原因。
要在独立环境中试用该候选版本:
uv pip install torch==2.15.0 --index-url https://download.pytorch.org/whl/test/cpu
FP8 登陆 MPS
FP8 为 Mac 提供了另一种节省内存的方式。PyTorch 2.15 在 MPS 上增加了 torch.float8_e4m3fn 张量支持:每个值仅占一个字节,存储空间是 FP16 或 BF16 的一半。
你可以使用 F.scaled_mm 对这些张量进行乘法运算,该函数支持按张量和按行两种缩放方式。下面是一个每张量使用一个缩放系数的小示例:
import torch
import torch.nn.functional as F

def quantize_fp8(x):
    limit = torch.finfo(torch.float8_e4m3fn).max
    scale = x.abs().amax().clamp_min(1e-12) / limit
    return (x / scale).to(torch.float8_e4m3fn), scale

x = torch.randn(1, 1024, device="mps", dtype=torch.float32)
weight = torch.randn(1024, 1024, device="mps", dtype=torch.float32)
x_fp8, x_scale = quantize_fp8(x)
w_fp8, w_scale = quantize_fp8(weight)

y = F.scaled_mm(
    x_fp8,
    w_fp8.t(),
    scale_a=x_scale,
    scale_recipe_a=F.ScalingType.TensorWise,
    scale_b=w_scale,
    scale_recipe_b=F.ScalingType.TensorWise,
    output_dtype=torch.bfloat16,
)
print(y.shape, y.dtype)
更快的语言模型解码
每个 LLM 都有预填充(prefill)和解码(decode)两个阶段。在解码期间,每个新 token 作为单行通过模型,因此大型矩阵乘法变成了矩阵向量乘积。PyTorch 2.15 加速了该步骤中占主导的两种层:稠密线性层和混合专家(mixture-of-experts)层。
线性层
MPS 自 2.14 起就为 torch.mm 提供了 GEMV 内核,但 F.linear 仍需经过 MPSGraph。PyTorch 2.15 把二者接到了 F.linear,因此解码时常见的 [1, 1, hidden_size] 输入可以直接使用这些内核,符合条件的 bias 加法也会被融合进来。在来自真实模型的 96 种 BF16 层形状上,几何平均加速达到 1.23 倍。提升最明显的是小型投影,比如 MoE 模型中的门控——旧路径几乎闲置了大部分内存带宽。大型层和 LM head 本来就已接近带宽瓶颈,所以基本维持在 1 倍左右。
MoE 层
MoE 层会把不同数量的 token 分发给各个 expert。分组矩阵乘法能在一次操作中处理这些大小不一的分组,2.15 为 MPS 带来了原生实现。
在 2.14 中,分组矩阵乘法需要把分组偏移量复制到 CPU,再逐组循环。新的 Metal 内核直接在 GPU 上读取偏移量,可用时调用 Metal Performance Primitives,否则走单独的 Metal 路径。针对解码时常见的小分组,还有专用内核。
例如,64 个 token 可以分成 16、32、16 三组:
import torch
import torch.nn.functional as F

tokens = torch.randn(64, 64, device="mps", dtype=torch.bfloat16)
weights = torch.randn(3, 128, 64, device="mps", dtype=torch.bfloat16)
ends = torch.tensor([16, 48, 64], device="mps", dtype=torch.int32)

out = F.grouped_mm(tokens, weights.transpose(-2, -1), offs=ends)
print(out.shape)  # torch.Size([64, 128])
解码内核的收益直接体现在 token 吞吐量上。在 M3 Ultra 上配合 torch.compile,MoE 模型的每秒生成 token 数提升约 1.3 倍:
线性代数提速
复数运算
处理复数张量变得更加便捷。现在,complex64 类型的LU 分解、LU 求解以及三角求解均可在 MPS 上运行。这同时也解锁了基于这些操作构建的功能及梯度计算,例如复数行列式。以下是一个直接在 GPU 上求解的小型方程组示例:
import torch

a = torch.randn(8, 8, device="mps", dtype=torch.complex64)
a = a + 8 * torch.eye(8, device="mps", dtype=torch.complex64)
b = torch.randn(8, 2, device="mps", dtype=torch.complex64)

lu, pivots = torch.linalg.lu_factor(a)
x = torch.linalg.lu_solve(lu, pivots, b)
print((a @ x - b).abs().max().item())
小矩阵与大尺度求解
小矩阵也拥有了高性能的内核实现。针对相机几何与图像变换,批量大小不超过 4 × 4 的 FP32 矩阵现可通过单个 Metal 内核完成求逆,该内核集成了分解与求解步骤。更大规模的计算也受到了关注:QR 分解采用了分块更新机制,而三角求解则将大部分计算转化为高效的矩阵乘法。
Gated DeltaNet 工作负载针对至少包含八个右端项的 16 × 16、32 × 32 及 64 × 64 FP32 三角方程组批次获得了专用快速路径。
SVD 在数值极端情况下的鲁棒性也得到提升。它现在能正确处理极小的奇异值、极大或极小的输入量级,以及使用 full_matrices=True 时的基补全操作。这些改进使得伪逆和最小二乘法的计算结果更加可靠。
卷积、填充与训练
音频模型、视频解码器和训练循环各有其高开销的操作。本次发布为其中多项操作提供了新的 Metal 执行路径:
| 操作 | 2.15 版本的变更内容 |
|---|---|
conv1d 前向传播 |
采用专用 kernel 替代 MPSGraph,并为短输出增加了 im2col 加矩阵乘数的路径。适用于音频和流式模型形状。 |
| 常量填充 | 迁移至 Metal kernel,修复了分块视频 VAE 解码中驱动内存持续增长的问题(下文详述)。 |
| 反射填充与复制填充 | 新增 Metal 实现,速度更快且修复了反向传播的正确性问题。 |
| 非原地 dropout | nn.Dropout 和 F.dropout 现在使用现有的融合 kernel。 |
| 上采样反向传播 | 使用 Metal gather kernel 替代 MPSGraph 的 resize 梯度路径。 |
Channels-last conv2d 反向传播 |
保持高效的 channels-last 路径,避免使用代价高昂的 strided access 的 NCHW 图。 |
Softmax 与归约运算
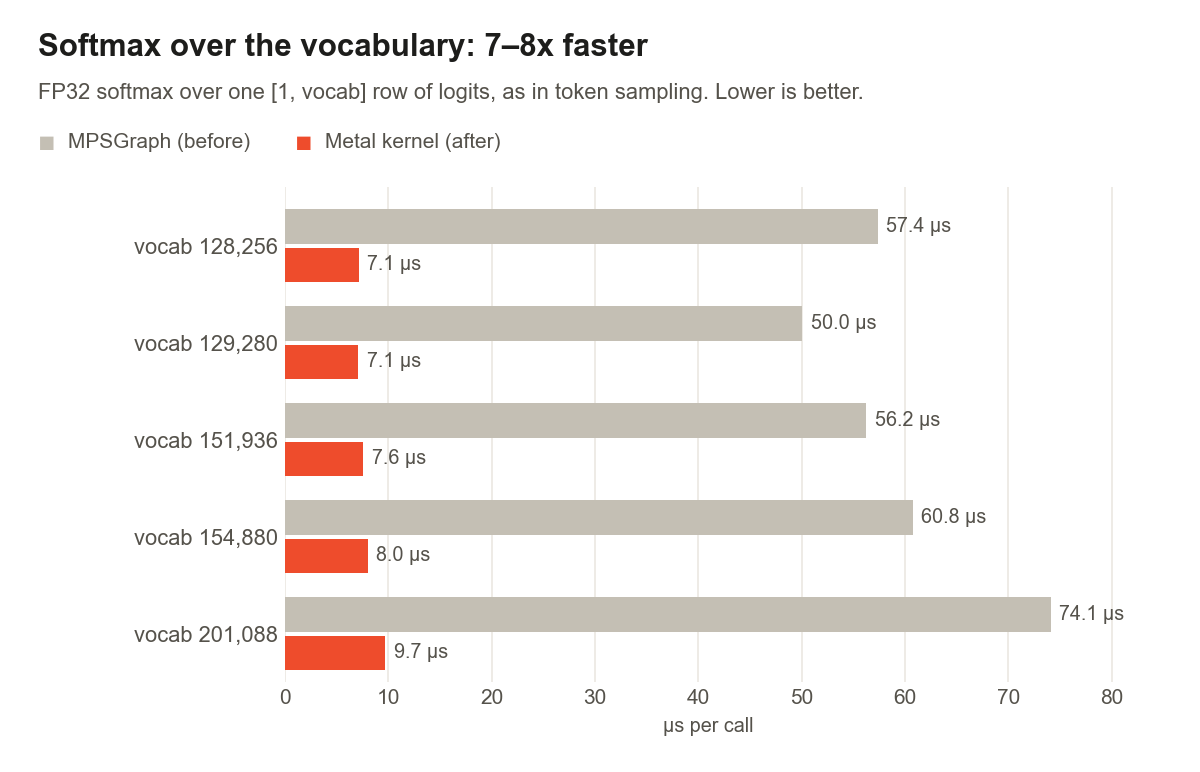
2.15 版本中 Token 采样速度也得到提升。softmax 和 log_softmax 现在运行在专用 Metal kernel 上,大词表受益最为明显:对 [1, 128256] 大小的 logits 行执行 FP32 softmax,耗时从 57 µs 降至 7 µs,比 MPSGraph 版本快约 8 倍。这一加速效果在其他常见词表大小上同样成立:
视频解码的内存占用大幅降低
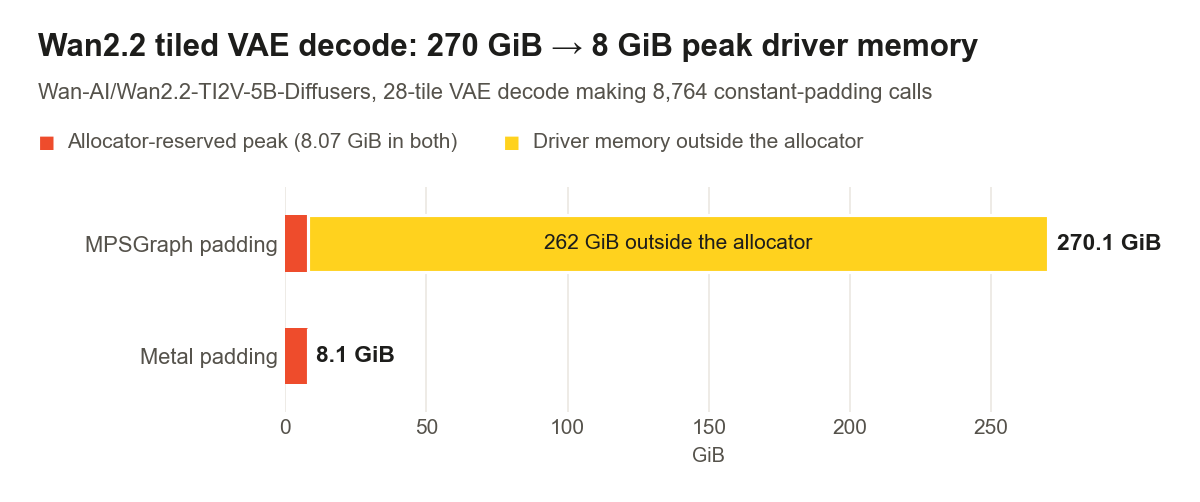
本次发布最亮眼的结果之一来自常量填充(constant-padding)的改动。在 Wan-AI/Wan2.2-TI2V-5B-Diffusers 中,一次完整的 28 块 VAE 解码会触发 8,764 次 padding 调用。将 padding 改为在 Metal 上执行后,驱动内存峰值从约 270 GiB 骤降至 8 GiB:
| 内存指标 | MPSGraph padding | Metal padding |
|---|---|---|
| 当前张量分配峰值 | 4.422 GiB | 4.095 GiB |
| 分配器预留内存峰值 | 8.070 GiB | 8.070 GiB |
| 驱动内存总峰值 | 270.135 GiB | 8.108 GiB |
MPS streams 带来更多控制能力
现在可以直接在 Python 中选择用哪个 MPS stream 来执行任务。torch.mps.Stream 和 torch.mps.stream 上下文管理器提供了相应接口,而 Tensor.record_stream 则让分配器能够跟踪张量在另一个 stream 上的使用情况。
下面这个小示例演示了如何把任务发送到单独的 stream,并在读取结果前进行同步:
import torch

x = torch.randn(1024, device="mps")
torch.mps.synchronize()
worker = torch.mps.Stream()

with torch.mps.stream(worker):
    y = x.square()
    x.record_stream(worker)

del x
worker.synchronize()
print(y.cpu().shape)
更多算子已支持 MPS
又有多个操作现在支持在 MPS 上运行: torch.frexp、torch.logspace、torch.take 和 Tensor.put_、torch.heaviside、torch.special.laguerre_polynomial_l 以及 无符号整数比较。目前 logspace 尚不支持多元素的整型或布尔型输出。
Attention(注意力机制)也修复了一个正确性问题:MPS 中 scaled dot-product attention 的数学实现现在能正确处理 batch 和 head 的广播机制。
PyTorch 2.16 前瞻
2.16 的开发工作已全面展开。以下部分变更已合入 main 分支,可在 nightly 版本中获取;其余仍在代码审查阶段,发布前细节可能会有调整。
更快的 LLM 解码速度
当模型的解码路径中不再包含任何 MPSGraph 操作时,CPU 完成所有内核的编码后,GPU 才开始处理 token。PyTorch 2.16 每 16 个内核提交一次 command buffer,使得 GPU 可以在 CPU 继续编码剩余内核的同时开始工作。对于编译后的 BF16 解码(2048 token 上下文):
| 模型 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| LFM2.5-8B-A1B | 108.8 tokens/s | 126.0 tokens/s | +16% |
| Qwen3.6-35B-A3B | 52.9 tokens/s | 62.8 tokens/s | +19% |
| Qwen3.8-27B | 12.1 tokens/s | 12.6 tokens/s | +4% |
Attention 完全运行在 Metal 上
Scaled dot-product attention is dropping MPSGraph completely: every shape will run on Metal kernels, with dedicated vector kernels for decoding and Metal Performance Primitives for half-precision prefill on newer macOS versions. The shapes that used to fall back to MPSGraph benefit the most. On an M5 Pro, decoding with grouped-query attention (32 query heads, 8 KV heads, head dim 80, 4K context) drops from 465 µs to 65 µs, and a 4K × 4K prefill with head dim 40 goes from 42 ms to 6 ms.
更多操作从 MPSGraph 迁移至 Metal
脱离 MPSGraph 的进程仍在继续。Batch norm 的 前向 和 反向 实现正在推进中,而 MSE 损失(在小规模输入下最快可提速 12 倍)、std_mean 与 var_mean(最快提速 4 倍)以及 bincount 已合并落地。其中 bincount 的改进最为显著:当大多数值落入同一个桶时,统计 400 万整数的耗时从 6.8 秒缩短至 0.5 毫秒。
更小的安装包
捆绑的 shader 默认将 为 Metal 3.1 构建,仅对确实需要的内核编译 Metal 4 版本。这将 libtorch_cpu.dylib 缩小约 25%,从 384 MiB 减至 287 MiB,并为支持更快矩阵乘法及原生 FP8 矩阵乘法的 Metal 4.1 shader 奠定基础。
总结
PyTorch 2.15 为 Mac 带来了 FP8 支持,加速了密集模型与 MoE 模型的 LLM 解码,增加了更多 GPU 端线性代数运算,并将大量操作从 MPSGraph 迁移至专用 Metal 内核。快去体验这个候选版本吧!
后续计划
- 更多 MPS 支持:2.16 版本将让注意力机制完全运行在 Metal 上,并继续将操作从 MPSGraph 中迁移出去。
torch.compile:我们正在努力消除图断裂,使更多模型能够端到端编译。- 你的想法:你还希望我们在 PyTorch 上做什么?如果有什么地方慢了、缺了或坏了——不管是在 MPS 还是其他地方——欢迎在 GitHub 上提交 issue 告诉我们。
特别感谢 Nikita Shulga、Kurt Mohler 和 Aaron Gokaslan 审阅了本次的大部分工作,也感谢所有为本版本 MPS 做出贡献的开发者。