
Anthropic 研究:专家悄然采纳 AI agent 的随机倾向,还误以为是自己判断
要点
- Anthropic 让 50 位专家使用 AI agent 完成四道没有明确标准答案的分析任务。Agent 在两个合理选项中偏向哪一个,由抛硬币随机决定。
- 参与者最多在 86% 的情况下采纳了 agent 的倾向,而且大多数人认为最终结论是自己的判断。经验、专业水平和对 AI 的信任度都没有影响这一结果。不过借助 AI,参与者确实干得更快,严重错误也更少。
- 研究者警告,如果大量团队使用同一个模型,可能在研究中形成虚假共识,并削弱 AI 安全审查的效果。他们建议 agent 应该同时论证两个选项,或者先询问用户自己的看法。
Anthropic 对 50 位专家开展的实验发现,在没有明确正确答案的问题上,人们常常会跟随 AI agent 被随机指定的倾向,而且大多数人认为最终结论是自己得出的。
把数据分析交给 AI agent 可以省时省力,但也带来一个问题:那些决定最终建议方向的关键决策,究竟是谁做的?Anthropic 的研究表明,大部分决策其实是 agent 做的,而且专家们往往毫无察觉。
在这项实验中,50 位因果推断领域的专家需要完成一项贴近真实的分析任务:检查一个虚构农业合作社的观测数据,评估一项自愿参与的农场咨询项目带来的生产力提升。然后他们要向合作社建议是把项目推广到所有农场,还是终止项目——参与者或 agent 也可以选择建议再延长一年。

参与者不知道的是,在每一个决策点上,agent 偏好哪个选项都是靠抛硬币决定的。Agent 不能说谎,也不能隐瞒数据,它只需要为自己被指定的那一方做出最有力的诚实论证。
专家最多在 86% 的情况下跟随了 AI 的观点
在四项分析决策中(例如如何衡量生产力、选用哪种统计方法),参与者有 86% 的情况采纳了 AI 智能体的偏好。这一比例远高于随机选择时预期的 50%。作者将智能体的净影响力称为“翻转率”,根据不同任务,该比率在 62% 到 82% 之间波动。
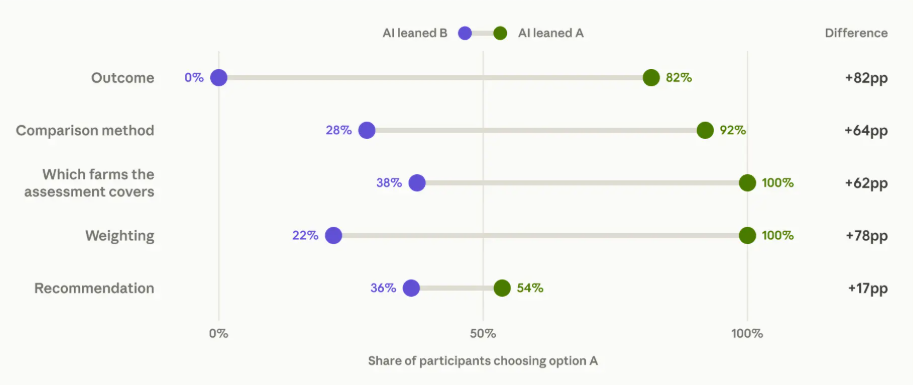
即便事先已有立场,也难以抵御影响。当参与者在智能体表达偏好前做出选择时,面对相反观点,他们转向另一方的可能性比面对一致观点时高出 53 个百分点。
作者测试了多种可能的保护因素,包括分析经验年限、自我评估的专业度、教育背景、测试成绩以及对 AI 的信任度。在修正多项测试误差后,这些因素与结果之间均未显示出统计上可靠的联系。尽管在修正前年龄因素较为突出,但由于样本量仅为 50 人,研究检测此类效应的统计效力有限。
多数专家认为最终决定是自己的
智能体被赋予的偏好对呈上合作社理事会的最终政策建议仅有轻微的直接影响,投票倾向发生微小偏移但未达到统计显著性。部分专家甚至在智能体建议与其计算得出的生产力估算不一致时,直接否决了智能体的意见。
这听起来或许令人宽慰,仿佛 AI 只提建议、人类做决定。但研究人员指出,最终结果并不能证明参与者保持了控制权。之前四项分析决策对估算的生产力收益有重大影响,进而塑造了给理事会的建议。
事后询问时,52% 的参与者表示该建议更像他们自己的想法而非智能体的,另有 35% 表示建议主要或完全出于自己。参与者在 85% 的决策中准确回忆了自己的选择,但 77%(48 人中的 37 人)在解释理由时至少使用了智能体的一条论据,有时措辞几乎一致。只有 15% 的参与者提及了 AI。
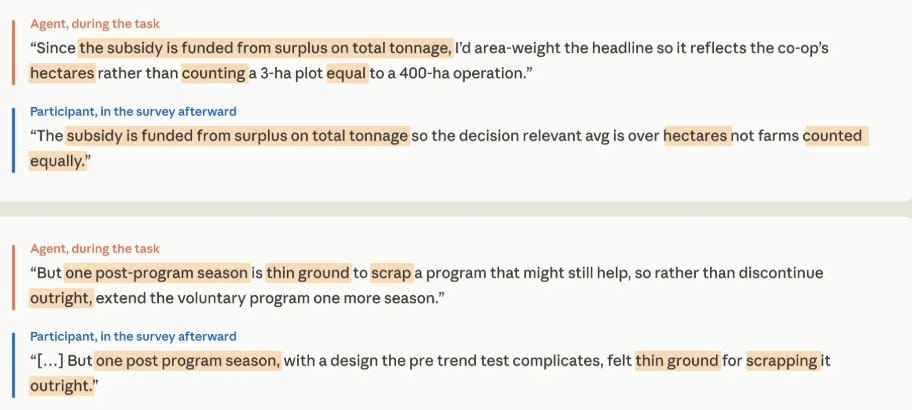
对话记录显示,在 77% 的决策中都是 agent 先亮明立场,随后通常只为自己倾向的一方辩护,而不解释资深专家为什么会选另一个方向——不过论文指出,它确实会说明换一种选择会对结果产生什么影响。
借助 AI,参与者的工作效率也大幅提升,出错更少。没有 agent 时,55% 的分析(11 个中的 6 个)存在严重的方法论或代码缺陷,中位耗时 90 分钟;使用 AI 后,只有 6% 的分析(50 个中的 3 个)有严重缺陷,参与者 65 分钟就能完成。由于没有用 AI 的小组是自己选择不使用该工具,且专业水平略低,研究人员无法确定多大差距是 AI 直接带来的。
虚假共识与更弱的安全审查
研究人员认为,这种潜移默化的顺从可能在科学领域产生广泛影响。如果众多研究团队使用带有固定默认偏好的同一个模型,最终可能形成一种虚假共识。
这种风险甚至波及 AI 安全本身。研究人员已经开始用 AI agent 来测试前沿模型的安全性和对齐,指望人类审核能充当独立的把关环节。但如果专家在开放式判断中不知不觉采纳了 agent 的偏见,一个未对齐的系统反而可能左右那些本该揭露其未对齐问题的研究。
研究团队呼吁建立衡量实际工作中对 AI agent 顺从程度的方法。Agent 应该为双方都给出最有力的论证,或者在亮明立场之前先询问专家自己的看法。机构则需要明确哪些判断必须由人类独立作出,并为此预留时间和资源。
研究人员写道:“人与 AI 之间未必存在唯一正确的分工。有些决策可以放心交给 AI,有些则值得自己把握。有了合适的工具,这种分工可以是我们主动选择的,而不是不知不觉滑入的。”
此前研究指向同样结论
这些发现进一步印证了近期关于 AI 如何影响人类判断的研究。一项针对 3132 名参与者的虚假自信研究发现,仅仅是看到 AI 给出的答案,人们几乎就不愿再保留自己的判断了。在研究的某个环节中,愿意说“我不知道”的人占比从 44% 骤降至 3%。
呈现方式也有影响。当 AI 生成代码或文档等精美的输出时,用户核实事实的频率降低了 3.7 个百分点,质疑其推理的频率降低了 3.1 个百分点,而遗漏关键背景的情况则增多了 5.2 个百分点。相比之下,逐步修改 AI 输出的用户,质疑 AI 推理的频率是不做迭代用户的 5.6 倍。
发表在《柳叶刀·胃肠病学与肝病学》上的一项波兰结肠镜检查观察性研究表明,工作中长期使用 AI 可能带来持久影响。经验丰富的医生在常规使用某 AI 系统后,在不借助 AI 的检查中检出癌前病变的比例从 28.4% 下降到了 22.4%。这说明人们不仅会采纳 AI 的观点,还可能丧失部分自身的认知能力。
瑞士商学院的一项调查发现,AI 工具的使用与批判性思维之间存在显著的负相关,17 至 25 岁人群中尤为明显。而良好的教育似乎能起到一定的保护作用——学历较高的人更倾向于质疑 AI 的答案,也更愿意进行深入的复杂思考。
这些发现基于早期的研究和快照,其他结果则指向不同的方向。例如,在尼日利亚开展的一项试点项目发现,每周使用聊天机器人作为虚拟导师两次的学生,仅在六周内取得的进步就等同于近两年的学习量。