
9 比特 AES 密钥之谜:多个 PDF 实现的加密缺陷
我们发现,多个 PDF 实现中生成的 AES-256 文件密钥源自状态空间极小,可枚举。MuPDF 中,仅有 9 比特随机位真正影响 AES-256 密钥。Foxit 等其他 PDF 编辑器则依据基于时间的随机性生成 AES-256 密钥,结果同样极易恢复。
引言
PDF 加密用于保护文档内的字符串与数据流,包括元数据,除非显式声明留空不加密。密码保护机制历经多轮修订,已从 RC4 升级为 AES,并强化哈希算法以抵御暴力破解。当前的修订 6 版采用 AES-256。
使用 AES-256 加密 PDF 时,密码不会直接加密文档。实现会生成 32 字节随机文件密钥来加密内容;随后通过哈希密码与随机数派生独立密钥,用来加密该 32 字节文件密钥。修订 6 故意让这一步骤变慢;较早的 AES-256 修订 5 版则不。
PDF 可设查看用的用户密码与变更权限用的所有者密码。二者均用于解锁同一文件密钥,因此限制由阅读器决定:拿到查看密码后,即可制作无限制的副本。
我们发现,这类随机性常被生成得很不安全,使已加密的 PDF 可在无密码的情况下解密。
MuPDF
1.28.5 之前的 MuPDF 版本采用drand48 家族生成随机数。该生成器仅做一次种子初始化,使用当前秒级时间戳:
1static void fz_init_random_context(fz_context *ctx)2{3 /* ... */4 fz_srand48(ctx, (uint32_t)time(NULL));5}该生成器为 48 比特线性同余:
s_{n+1}=(\mathbf{AX^d\,e\,e\,c\,e\,A\mathbf{d}s_n+\mathbf{AX}b)\bmod 2^{48}fz_srand48() 将状态写为三个 16 比特字。低字为常量 0x330e,32 比特时间戳占据状态位 16 到 47:
1void fz_srand48(fz_context *ctx, int32_t seed)2{3 uint16_t p[3] = { 0x330e, seed, seed>>16 };4 fz_seed48(ctx, p);5}当 MuPDF 需要生成密钥时,它会调用 fz_memrnd()。该函数反复获取随机数,推进随机数生成器状态,然后取该随机数的最低字节作为随机字节。
1int32_t fz_nrand48(fz_context *ctx, uint16_t s[3])2{3  return fz_rand48_step(s, ctx->seed48+3) >> 17;4}5
6/* in fz_memrnd() */7while (len-- > 0)8  *data++ = (unsigned char)fz_lrand48(ctx);
右移操作丢弃了状态的第 0 到 16 位,转换为 unsigned char 则丢弃了第 24 位以上的所有位。因此,每个输出字节都源自 LCG 状态的 17 到 24 位。
问题在于状态的高位永远不会影响低位。乘法和加法产生的进位只能向高位传递,而无法向低位传递。既然每个输出字节都来自 17 到 24 位,那么即使推进生成器状态,第 24 位以上的内容也可以完全忽略。
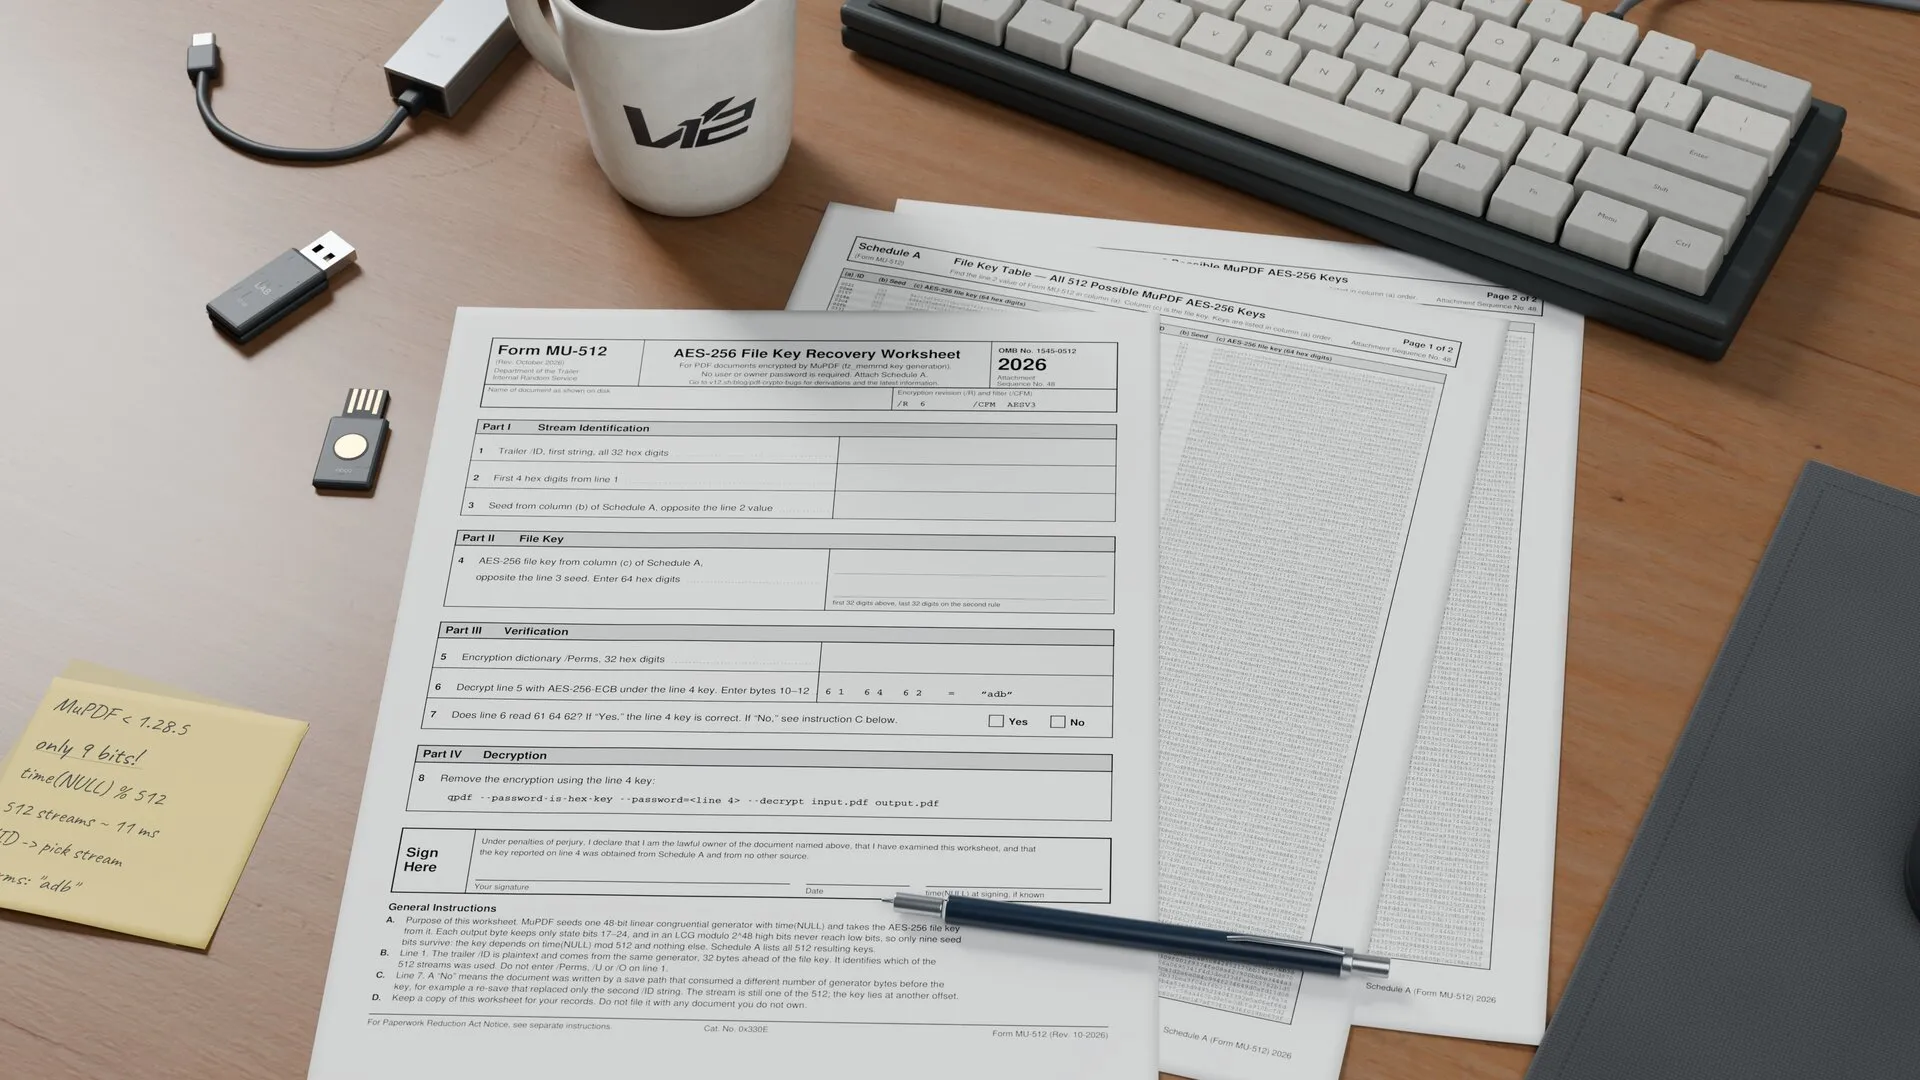
这就只剩下 25 位可能影响输出。其中最低的 16 位始终初始化为 0x330e,因此只有来自时间戳的 9 位是有意义的。时间戳相差 512 秒会生成完全相同的字节流。
由于可能的密钥空间极小,我们只需通过暴力破解来解决:生成所有可能的 32 字节密钥并进行试验解密:
1def stream(seed, count):2    state = (seed << 16) | 0x330e3    out = bytearray()4    for _ in range(count):5        state = (0x5deece66d * state + 0xb) & ((1 << 48) - 1)6        out.append((state >> 17) & 0xff)7    return bytes(out)8
9candidates = [stream(seed, 64)[32:64] for seed in range(512)]
MuPDF 使用同一个生成器处理文档的 /ID 字段,该字段以明文形式存储在 trailer 中。写入新文档时,它会先从同一个 LCG 中获取 32 个字节,然后立即获取解密密钥,因此 /ID 可以用作额外的校验。
在一个未优化且使用纯暴力搜索的 Python 实现中,遍历所有 512 个流大约耗时 11 毫秒。在测试文档中:
time(NULL) mod 512 = 80/ID[0] = 7628523958da31d6c21c90e39344b28e/ID[1] = 8be910bddaa1f1a542e5a27ceb115346key = c3888ecc8ff554ac93acd689da2ecd6223cb760168622e8a0c44a533a037c212这个密钥无需任何密码即可解密文档。
Foxit
Foxit PDF Reader 2026.1.3.36551 生成文件密钥的方式,是对当前时间戳、32 个未初始化的字节以及一个常量做哈希。实际上这些未初始化的字节都会被填零,不会带来任何随机性。
SHA-256(uint32_le(time(NULL)) || <32 uninitialized bytes> || "there")等价的 Python 代码如下:
1from hashlib import sha2562
3key = sha256(timestamp.to_bytes(4, "little") + bytes(32) + b"there").digest()
由于 /Perms 权限块的内容是已知明文,验证候选密钥只需一次哈希加一次 AES 块解密,完全不需要密码哈希,也不用解密整个文档:
1let mut material = [0u8; 41];2material[..4].copy_from_slice(×tamp.to_le_bytes());3material[36..].copy_from_slice(b"there");4let key: [u8; 32] = Sha256::digest(material).into();5
6let cipher = Aes256::new(&key.into());7let mut plain = Block::<Aes256>::from(self.perms);8cipher.decrypt_block(&mut plain);9// Check for some known magic values to indicate successful decryption10(plain[..4] == self.permissions11 && plain[4..8] == [0xff; 4]12 && plain[8] == self.metadata13 && plain[9..12] == *b"adb")14 .then_some(key)我们的 Rust 实现从当前时间出发向过去逐个尝试时间戳,并用 Rayon 做多线程并行。在 32 线程的 Ryzen 9 7950X 上,每秒可验证 3.7 到 3.76 亿个时间戳:
| 目标时间戳 | 尝试的候选数 | 搜索耗时 |
|---|---|---|
| 十年前 | 315,573,571 | 0.84 秒 |
| Unix 纪元(1970 年) | 1,792,610,110 | 4.85 秒 |
第二行覆盖了从 1970 年至今的所有时间戳。实际场景中,对于近期生成的文档,搜索通常只需几毫秒。
timestamp = 1787583328key = 41474b490265500f9727f21f1dde34be31bcdfc3830e2dc027daabe5b5984081/Perms = fcfbffffffffffff54616462f67f0000 (decrypted)这个密钥派生方案从何而来
这个完全相同的模式出现在几套不同的 PDF 编辑软件中,我们很好奇它们的来源。该代码早已存在于 PDFium 2014年5月的首次公开提交中。文件头注释将原始代码归功于 Foxit,因此这段代码似乎源自 Foxit。其他编辑器可能通过 PDFium 间接获取了该实现:
1if (m_Revision >= 5) {2 int t = (int)time(NULL);3 uint8_t sha[128];4 CRYPT_SHA256Start(sha);5 CRYPT_SHA256Update(sha, (uint8_t*)&t, sizeof t);6 CRYPT_SHA256Update(sha, m_EncryptKey, 32);7 CRYPT_SHA256Update(sha, (uint8_t*)"there", 5);8 CRYPT_SHA256Finish(sha, m_EncryptKey);9 /* ... */中间的 32 字节值是 m_EncryptKey,即正在被哈希到自身的未初始化键缓冲区内容。假设这些字节已初始化为零,这正是 Foxit 至今仍在使用的密钥派生方法。
OpenPDF 和 iText
OpenPDF 3.0.5 和 iText 9.7.1 都通过一个 IVGenerator 类来处理加密随机数,该 ARC4 流由毫秒时间戳和 JVM 的可用内存初始化:
1arcfour = new ARCFOUREncryption();2long time = System.currentTimeMillis();3long mem = Runtime.getRuntime().freeMemory();4String s = time + "+" + mem;5arcfour.prepareARCFOURKey(s.getBytes());同一流生成了文件密钥以及存储在明文 /U 和 /O 中的 32 字节盐值。我们可以利用这些盐值来验证时间戳和可用内存的猜测,然后从相邻字节中恢复密钥。
尽管这里的变异性远大于 MuPDF 和 Foxit 的例子,但这再次表明,256 位安全承诺因不安全的随机数来源和低于宣传的熵空间而受到削弱。
结论
这些实现中,文件密钥均由非密码学安全的随机源生成。原本意在提升旧版基于用户密码派生密钥的安全性,结果却导致实际生成的密钥强度更弱。这些问题已向供应商披露,MuPDF 方面已修复,但先前发布的文件无法追溯保护,因此这些漏洞仍可能产生影响。
我们已公开了针对 MuPDF 和 Foxit 的解密工具。