Qwenputer:把一个可运行的确定性 RISC-V CPU 编进 Qwen3.5 权重里
Qwenputer 是一个极具趣味的实验性模型。它本质上是一个标准的 Qwen 3.5 4B 模型,仅增加了一个特点:其权重中嵌入了一个 RISC-V CPU,该 CPU 直接调用模型自身的 Gated DeltaNet 注意力层作为随机存取存储器(RAM)。(若想了解 GDN 的工作原理,可以参考 这篇简明指南。)这款“CPU”完全在模型的前向传播过程中运行,无需任何外部运行时环境或工具,即可执行算术运算以及 C 语言和 MicroPython 代码。
需要明确的是,它既不是插件、工具,也不是沙箱。本博客将详细解析该模型的工作机制,包括如何利用 GDN 层作为 RAM,以及如何嵌入一种实验性的模型内部文件存储机制。
我还基于 Qwenputer 撰写了两篇后续文章:一篇探讨 混合模型如何在 RNN 状态中隐藏其推理过程以规避思维链(CoT)监控,另一篇则说明 此类编译后的权重如何充当内置监控工具,且模型自身无法对其进行篡改。
你可以从 Hugging Face 或 ModelScope 获取 Qwenputer,相关代码托管于 GitHub。
Qwen3.5 内部的 RNN 可充当精确的 RAM
Qwen3-Next 和 Qwen 3.5(Qwenputer 的基座模型)采用了一种巧妙的技巧:模型中四分之三的注意力层使用线性递归神经网络(RNN)Gated DeltaNet 作为注意力机制(更多细节见此处)。每个注意力头维护一个状态矩阵,并由 delta 规则负责更新该矩阵。
接下来就是我们这个有趣实验的起点了。我发现,只要把门控设为 1,11 每个 Gated DeltaNet 头都维护一个状态矩阵,也就是它的记忆。每处理一个 token,在写入新内容之前,它会把整个状态乘以门控值(一个 0 到 1 之间的数)。这就是 RNN 遗忘的方式:门控为 0.9 时,已存储的内容在每个 token 上都会略微衰减;门控为 1 则意味着永不衰减。写入强度 beta 也设为 1,22 经过门控之后,头会把状态的某个方向朝新值推近,写入强度 beta 决定推多远。beta 为 1 表示该方向上的旧值被完全替换,而不是混合。再加上 one-hot 键编码,33 one-hot 键是一个只含单个 1 的零向量,因此它精确指向状态的某一行,就像内存地址指向某一个单元格。这样每次写入都会精确覆盖一行,每个 one-hot 查询也能取回精确的值。这意味着 GDN 层本身可以完全当作 RAM 来用,而且比用普通 attention 当 RAM 便宜得多——因为不管对话多长,GDN 头的状态大小都保持不变,不像 attention 的 KV cache 会不断增长。

用 delta 规则充当记忆并不算新想法:Schlag 等人(2021)已经证明,带 delta 规则的 linear attention 可以作为联想记忆,也就是“快速权重”。44 Imanol Schlag, Kazuki Irie and Jürgen Schmidhuber, "Linear Transformers Are Secretly Fast Weight Programmers", ICML 2021. 这里的新意在于把它做到精确、可寻址,并且在一个生产级模型里足够可靠,能在上面跑一整个 CPU。
整个模型正是构建在这个基础之上。默认的 Qwen 3.5 并不会在 GDN 中保持精确的值,而通过这个修改,我们为实验的下一步打开了大门。
将计算机编译为层级
既然现在有了完全可用、廉价且快速的 RAM,我们便可以着手将一台运行中的 CPU 编译进模型权重中。幸运的是,这一过程无需训练:编译器会直接设定每一个权重。你将 CPU 描述为一个电路,一长串像“读取此寄存器”、“将这两个数相加”或“若为零则跳转”这样的小步骤;编译器会将每个步骤转化为 Transformer 层的一个部件:负责查表的注意力头、执行算术运算的前馈单元,以及承载 RAM 的 DeltaNet 头。随后,CPU 在模型解码时运行。
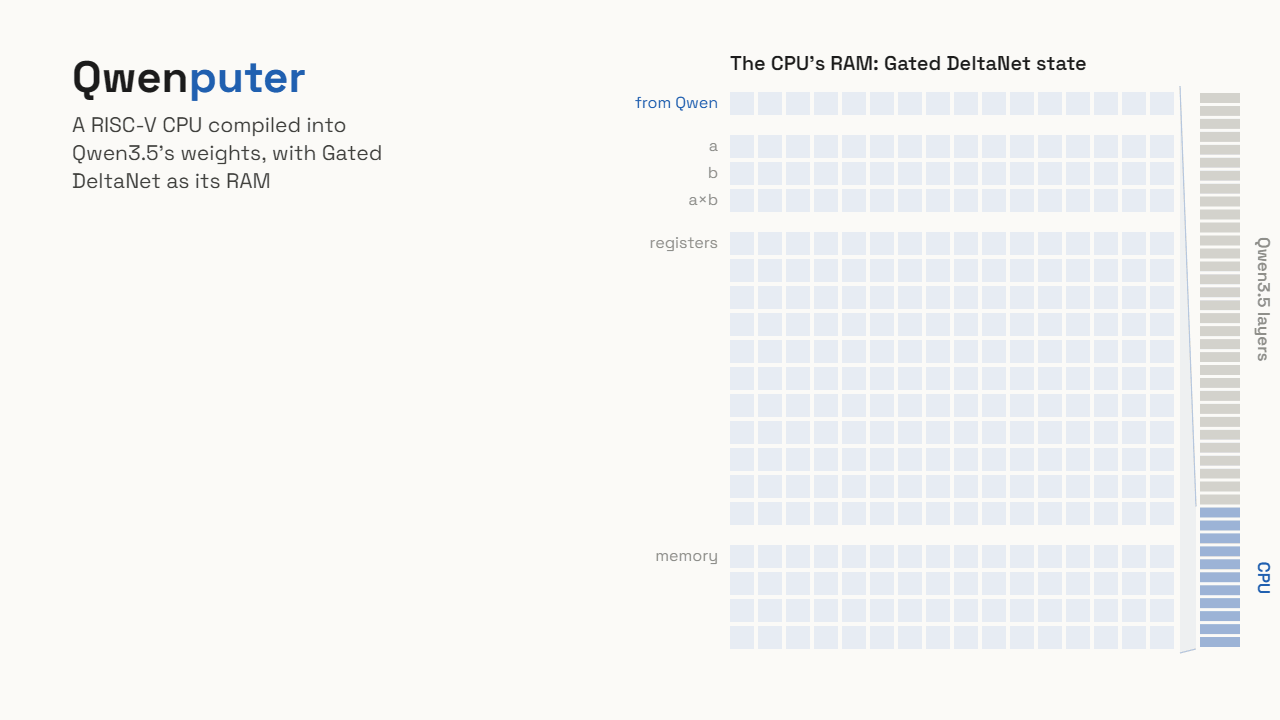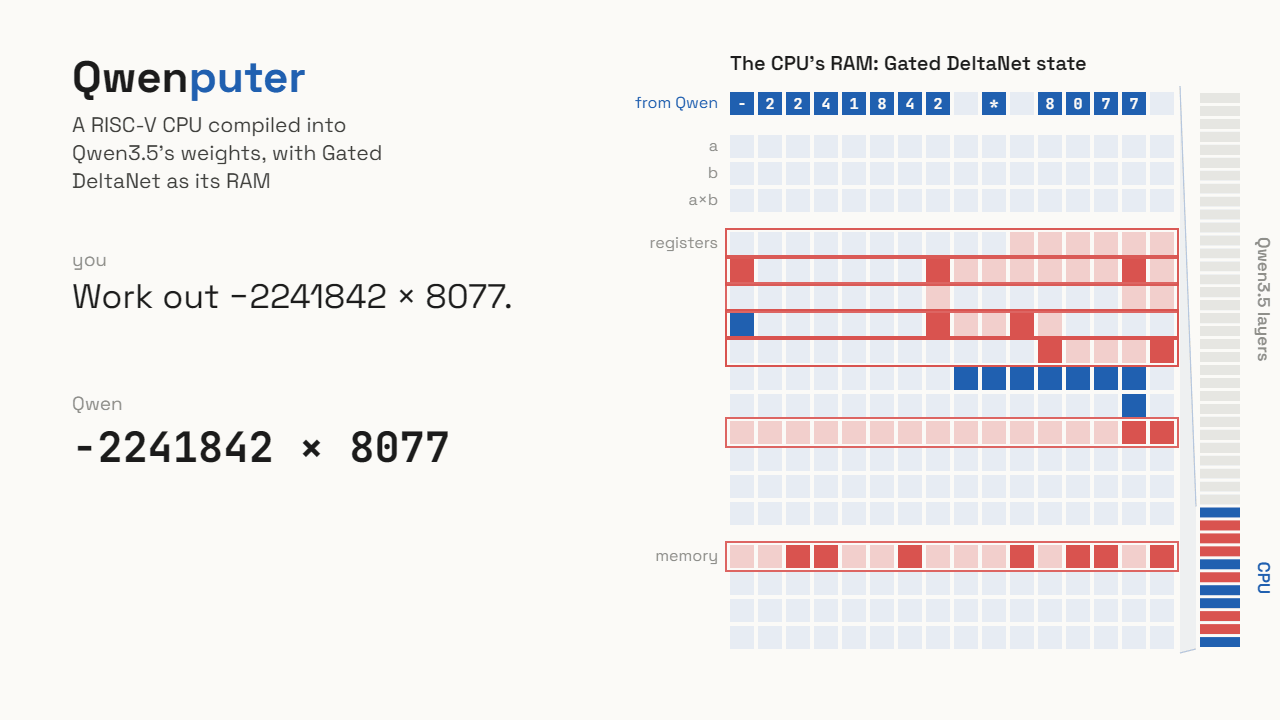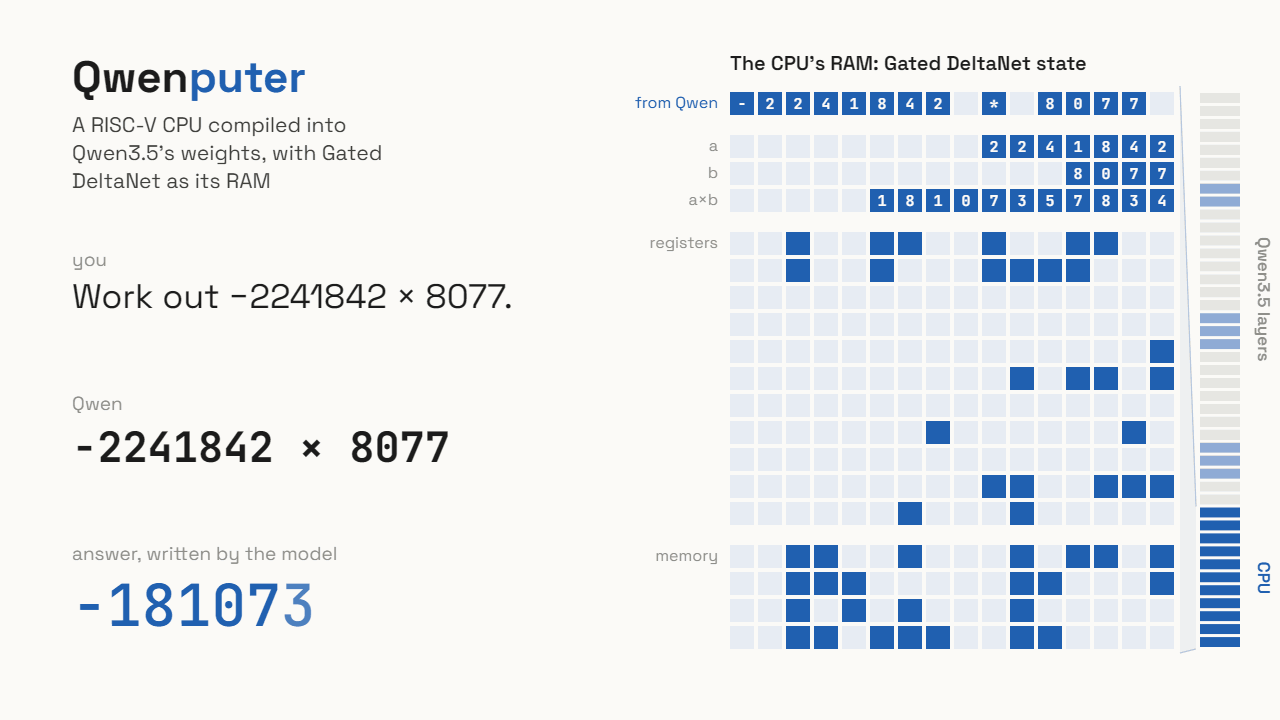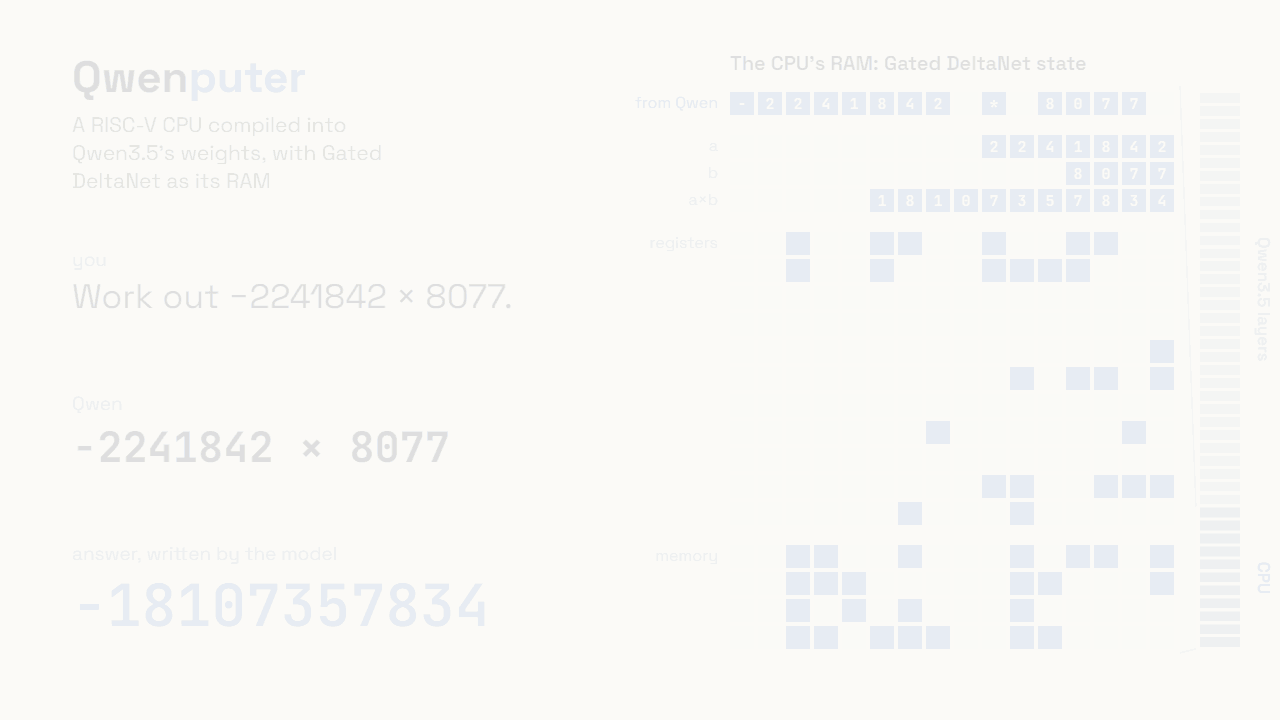
每条指令对应几个生成的 Token:第一个 Token 指定要写入的内存行(ADDR),第二个携带数值(VAL),最后的 STEP Token 标志指令结束。这些 Token 构成了 CPU 的执行轨迹,因此当 Qwen 生成这些 Token 时,CPU 实际上正在运行。
CPU 架构
该 CPU 是一个 32 位 RISC-V 内核(RV32IM,外加 Zba 扩展和一个用于大数运算的小数位单元),占据 Qwen 32 层之前的 11 层。目前,它通过了官方的 riscv-tests,其程序行为与 qemu 一致,并在自由运行状态下执行了 1800 万条指令,未出现任何错误。55 自由运行意味着在整个运行过程中,CPU 完全基于自身的输出继续执行,中间步骤没有参考机器进行纠正。
这台 CPU 也能在前向传播中相当好地运行 C 语言和 MicroPython 代码(尽管速度稍慢)。它尚未达到 Linux 级芯片的水平,但实现了完整的 RV32IM 指令集。
Qwen 如何使用它
Qwen 3.5 4B 能够很好地利用这台 CPU,无需任何后训练。CPU 的使用完全在内部进行,不通过任何外部工具调用。
为了让模型可靠地使用该 CPU,我选择了一种低成本方案:借用模型已充分训练过的工具调用格式,Qwen 向 CPU 发送指令并读取结果。不使用了任何外部工具调用或运行时。一旦 CPU 收到指令,计算机层级便运行,随后将结果写回工具响应。我们使用一个名为 RvChat 的小型驱动程序,将固件加载到 GDN 状态中,从而避免轨迹 Token 出现在 Qwen 的常规层级中。
Qwen 的原始权重保持不变。计算机权重是叠加在其之上的额外维度和层。
它能工作吗?
读完我上面这堆絮叨,你心里可能最关心的就是:这东西真能跑起来吗?
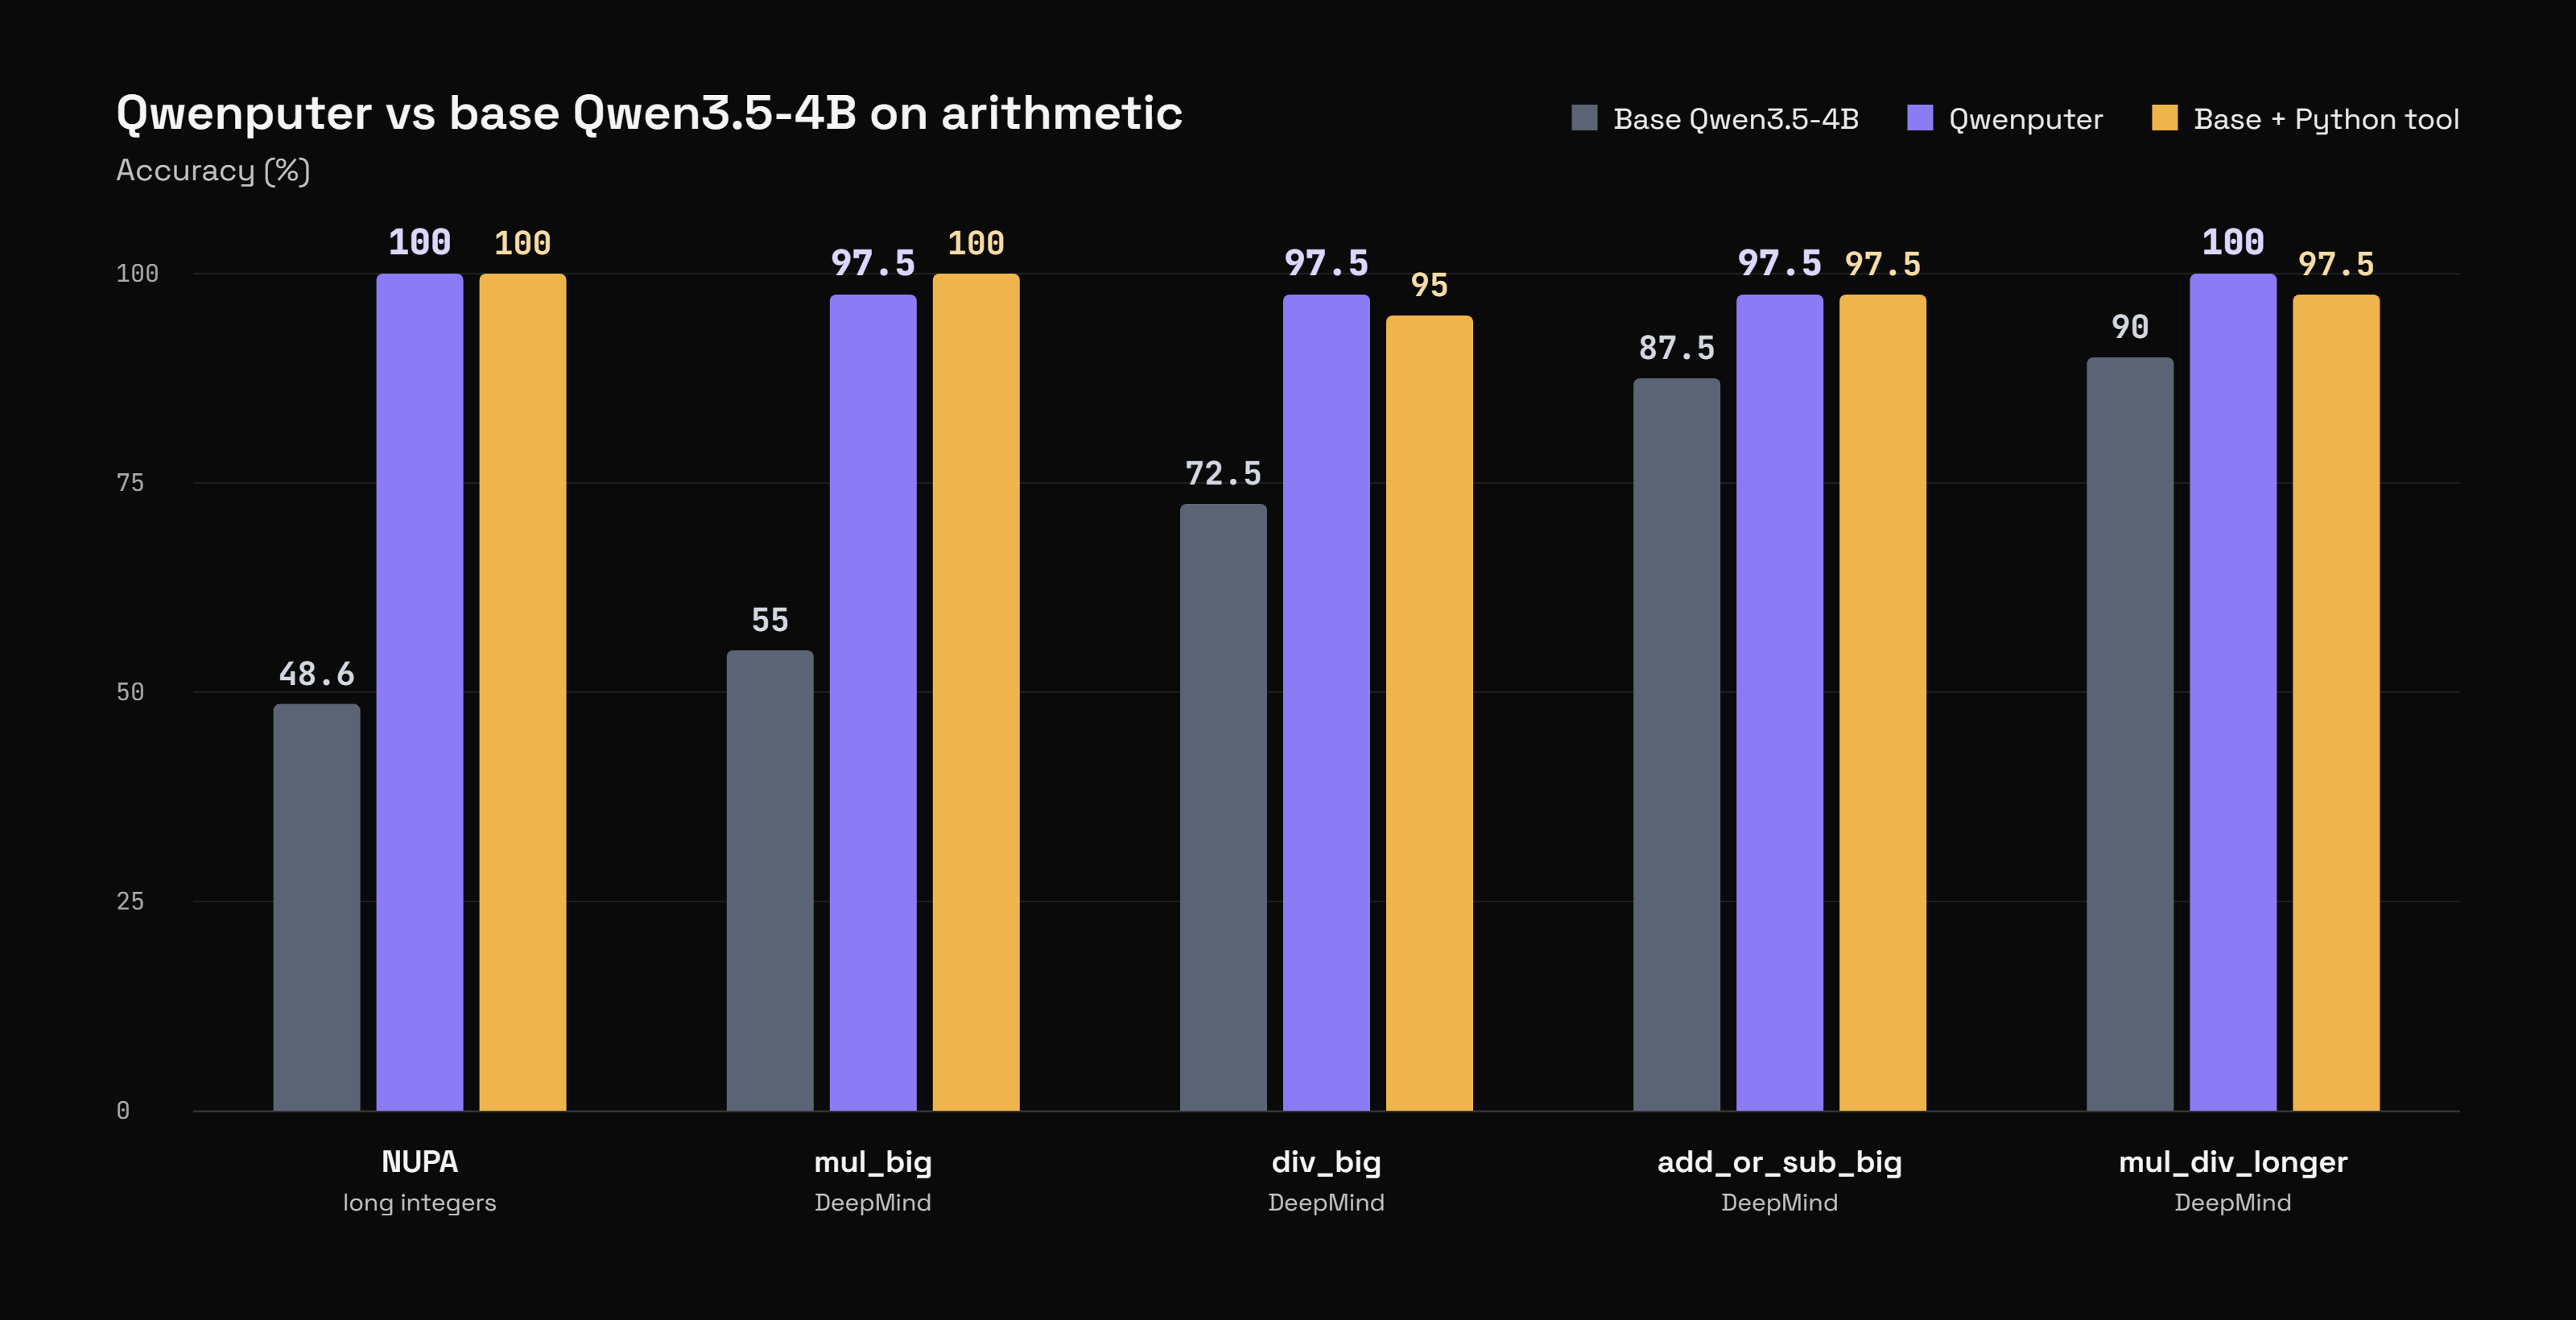
在 DeepMind 测试集上:
- div_big:Qwenputer 得分 97.5%,而配备 Python 工具的 Qwen 3.5 4B 为 95%,基础版 Qwen 为 72.5%。
- mul_big:Qwenputer 得分 97.5%,配备 Python 工具为 100%,基础版 Qwen 为 55%。
- mul_div_multiple_longer:Qwenputer 得分 100%,配备 Python 工具为 97.5%,基础版 Qwen 为 90%。
- add_or_sub_big:Qwenputer 得分 97.5%,与配备 Python 工具持平,基础版 Qwen 为 87.5%。
在 NUPA 的大整数算术测试中,Qwenputer 的准确率从 48.6% 跃升至 100%,达到了与配备 Python 工具相同的水平。
该 CPU 输出的数字也是精确无误的:我将大约 230,000 个输出位置与参考机器进行对比,结果零误差。此外,给 Qwen 加装电脑并不会改变其说话方式:其正常文本输出与基础版 Qwen 的偏差仅处于噪声范围内(KL 散度 6e-4,噪声底线为 5e-4)。
还要硬盘?这经济环境下?
既然语言模型里的 CPU 显然不够“硬核”,我决定再给它加个文件系统,这才稳妥。
由于我们已经具备了可用的 RAM,这一步其实很简单。在模型层面,它通过内部的 put、append、get、list、delete 操作对外暴露。再次强调,全程未调用任何工具。当 Qwen“保存”文件时,编译后的层会将文件名哈希为 DeltaNet 状态中目录的一个 1024 个槽位之一,并将文件文本存储在其他的头部中,每行 8 个 token 链式组织。如果出现两个文件名映射到同一槽位的情况,系统会检查下一个槽位。查找文件只需两到三步,而非全量扫描,最多支持 512 个文件,相当于约 53,000 个 token 的文本容量。
有趣的是,这个文件系统的持久性相当好。你可以在一段对话结束时保存状态,下次对话时加载回来,文件依然存在。借助这个文件系统,Qwen 对跨对话变化的事实能答对 90%,而把旧对话直接粘贴回去只有 30%;它也和用 Python 运行的记忆工具效果相当(83.3% vs 78.9%)。这个功能仍是实验性的,代码位于 rv-store branch,模型则发布在 Hugging Face 和 ModelScope。局限与后续计划
Qwenputer 目前还只是个实验项目,所以有一些局限。额外的层和更宽的隐藏层让 checkpoint 达到 18.8 GB,约为基础 Qwen 的两倍,尽管其中大部分是零填充。它还需要一个小的驱动程序(RvChat)来引导固件,并把 trace token 挡在 Qwen 的层之外,所以目前还不能直接用普通的 generate() 调用来运行。另外它的速度有点慢,每条 CPU 指令要消耗几个解码出来的 token,一次大计算要花几秒而不是几毫秒。我跑基准测试用的批量执行器在 L4 上大约能跑到每秒 3,200 个 CPU token。
接下来,我想让 Qwen 自己写 Python,然后通过一个 python() 工具在自己权重内的 MicroPython 上运行,工作方式和 calc 一样。另一个大方向是把 CPU 提速。
不止于算术
对 RNN 层的精确控制,用途远不止算术。它也让 Qwenputer 成为一个非常好的 AI 安全研究试验场。我为此写了两篇后续文章:一篇讲 像 Qwen 3.5 这样的 hybrid 模型如何学会把推理过程藏进 RNN 状态以规避 CoT 监控,另一篇讲 编译后的权重如何成为可监控性工具,比如模型无法关掉的内嵌于权重的监控器,或者供可解释性研究使用的答案密钥。
试试看
想自己动手试试?该模型在单张 24 GB GPU 上即可运行。你需要安装 uv 和 Hugging Face CLI。计算过程无需 tool server 或 Python 沙箱:CPU 直接在模型内部执行这些运算。
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf \
    --ask "Use calc: what is 123456789 * 987654321?"
所有内容均已开源:代码托管在 GitHub,两款模型则发布在 Hugging Face(Qwenputer、Filesystem)和 ModelScope(Qwenputer、Filesystem)。
若在你的工作中使用本项目,可按以下格式引用:
@software{agrawal2026qwenputer,
  author  = {Agrawal, Divyansh},
  title   = {{Qwenputer}: a computer compiled into the weights of a pretrained language model},
  year    = {2026},
  url     = {https://github.com/divagr18/qwenputer}
}
注释
- 每个 Gated DeltaNet 头部都维护一个状态矩阵作为其记忆。在每个 token 输入时,写入新数据前,它会用 gate(一个 0 到 1 之间的数值)乘以整个状态。这就是 RNN 实现遗忘的机制:若 gate 为 0.9,则存储的每个 token 的记忆都会略微淡化;若 gate 为 1,则记忆永不衰减。↩
- 经过 gate 处理后,头部会将状态推向一个新的方向,而写入强度 beta 决定了推动的幅度。若 beta 为 1,意味着沿该方向的原值会被完全替换,而非混合更新。↩
- One-hot key 是一个仅包含单个 1、其余全为 0 的向量,它精确指向状态中的一行,就像内存地址指向某个存储单元一样。↩
- Imanol Schlag, Kazuki Irie and Jürgen Schmidhuber, "Linear Transformers Are Secretly Fast Weight Programmers", ICML 2021. ↩