
NVIDIA Nemotron 3.5 Transcribe与Granary v2:可提示适配的智能多语言转录解决方案
尽管转录稿能记录每一句口语内容,用户或应用程序仍可能困惑于谁说了什么、如何翻译,以及如何规范地书写领域专业术语。多语言通话、快节奏会议和医疗听写都需要不同的输出结果:翻译、说话人标识或拼写正确的医学术语。
NVIDIA Nemotron 3.5 Transcribe 是一个开放权重、可提示(promptable)模型,可将录音语音转换为有用的文本,现已在 Hugging Face 和 ModelScope 上可用。它将转录、说话人归属(diarization)、翻译和音频问答整合到一个检查点(checkpoint)中:它支持 40 种语言的转录,31 种语言可与英语互译,并能对 13 种语言进行说话人归属。它能处理长达一小时的录音,并标记多达八位说话人。开发者可以使用自然语言引导输出,选择音频的处理位置,并调整识别模型以适应特定领域的词汇和口音。
在 Hugging Face 开放 ASR 排行榜 上,Transcribe 是英语类别中排名首位的开放权重模型,并位列 Artificial Analysis 的“准确率—活跃参数”前沿。在说话人归属方面,它在 David AI 的 21 语言 diarization 排行榜 上记录了最低错误率,并在 VoiceArena 的 14 系统对比 中排名第一。量化版本即将推出,这样你就可以在 RTX Spark、DGX Spark 或 Jetson AGX Thor 上本地运行 Transcribe——或者在 Blackwell 数据中心 GPU 上进行规模化扩展。
Granary v2 的多语言数据集(可在 Hugging Face 和 ModelScope 获取)和可复用的数据清洗流程,配合 NeMo Speech 微调工具,把提示词级别的控制延伸到了训练环节:开发者可以自定义所需的书写形式,让模型适配应用中实际遇到的语音。在一个医疗案例研究中,微调让留出说话人上的词错误率(WER)相比最优提示词降低了 45.8%。
用自然语言引导转录和分析
同一段会议录音,同一个模型,只需改变指令就能得到不同的输出:
- “转录这段录音,并标注每位说话人。”
- “把这段音频翻译成英文。”
- “这次会议做出了哪些决定?”
下方视频演示了模型的实际效果,它处理的是 1940 年神经喜剧《His Girl Friday》中的经典场景——这部电影以语速极快、大量对白重叠而闻名。
Nemotron 3.5 Transcribe 为《His Girl Friday》(1940) 的一个场景生成字幕并标注说话人,包括重叠对白。
遇到生僻术语时,可以先尝试提供上下文,而不是直接微调。以医疗场景为例:
用原语言转录这段医疗讨论。可能的术语:HbA1c、metformin。仅在音频支持时使用这些术语。保留标准医学术语拼写,数字按常规书写形式输出。
模型卡提供了推荐预设,包括针对音频问答的推理模式,还有完整的提示词指南和任务与语言的对照矩阵:不同任务的语言支持有所差异,音频问答仅在英文上训练过。模型也支持词级时间戳。与所有语音模型一样,建议对姓名、说话人切换和问答结果对照录音抽查验证。
从课堂实录到持久学习资源。 实时音视频平台 Agora 为应用中的在线互动提供支持。在一堂课程演示中,他们利用词级时间戳功能,借助 Nemotron 3.5 Transcribe 将录制好的课堂视频转换为文字记录,并同步展示在回放界面上,让学生能清晰看到说话内容及对应时间点。Agora 的官方博客 详细介绍了这一构建过程。
从转录到说话人归属的排行榜佳绩
在开源权重模型中,Transcribe 在“说了什么”(内容转录)方面表现领先;在“谁说的”(说话人归属)方面,它在两项基准测试中均名列前茅。
Hugging Face 开放 ASR 排行榜。 该排行榜通过公开测试集的词错误率(WER)衡量转录准确性,分为三个赛道:
- 英语: 在开源权重模型中排名首位,平均 WER 为 5.33%(见图 1)。
- 多语言: 跨七种语言的平均 WER 为 4.62%,在模型卡片中的开放 ASR 对比中,是受测开源权重模型里表现最好的。
- 长音频: 平均 WER 为 10.98%,同样在该对比中处于最低水平。
图 1. 在排除 API 模型的情况下,Nemotron 3.5 Transcribe 在 Hugging Face 开放 ASR 排行榜(英语赛道)的开源权重模型中排名第一,平均 WER 为 5.33%。WER 越低,代表转录错误越少。
Artificial Analysis 语音转文本排行榜。 Artificial Analysis 通过其词错误率指数 AA-WER 独立对语音转文本模型进行排名。Nemotron 3.5 Transcribe 的 AA-WER 为 2.8%,在开源权重模型中并列第一,其活跃参数量约为 4B,而与其并列的模型为 24B。在 AA-WER 指数中占比 50% 的保留集语音代理语音数据集 AA-AgentTalk 上,Transcribe 的 WER 为 1.8%,优于次优开源权重模型的 2.3%。Transcribe 将语音编码器与混合 Mamba–Transformer 混合专家语言模型相结合,因此在每处理一个 token 时,其 30B 参数中仅约 4B 处于激活状态。这使其跻身 Artificial Analysis 开放权重模型在“精度 vs 活跃参数量”帕累托前沿的行列。在 AA 的全模型图表中,它的排名甚至超过了多个广泛使用的专有语音 API。
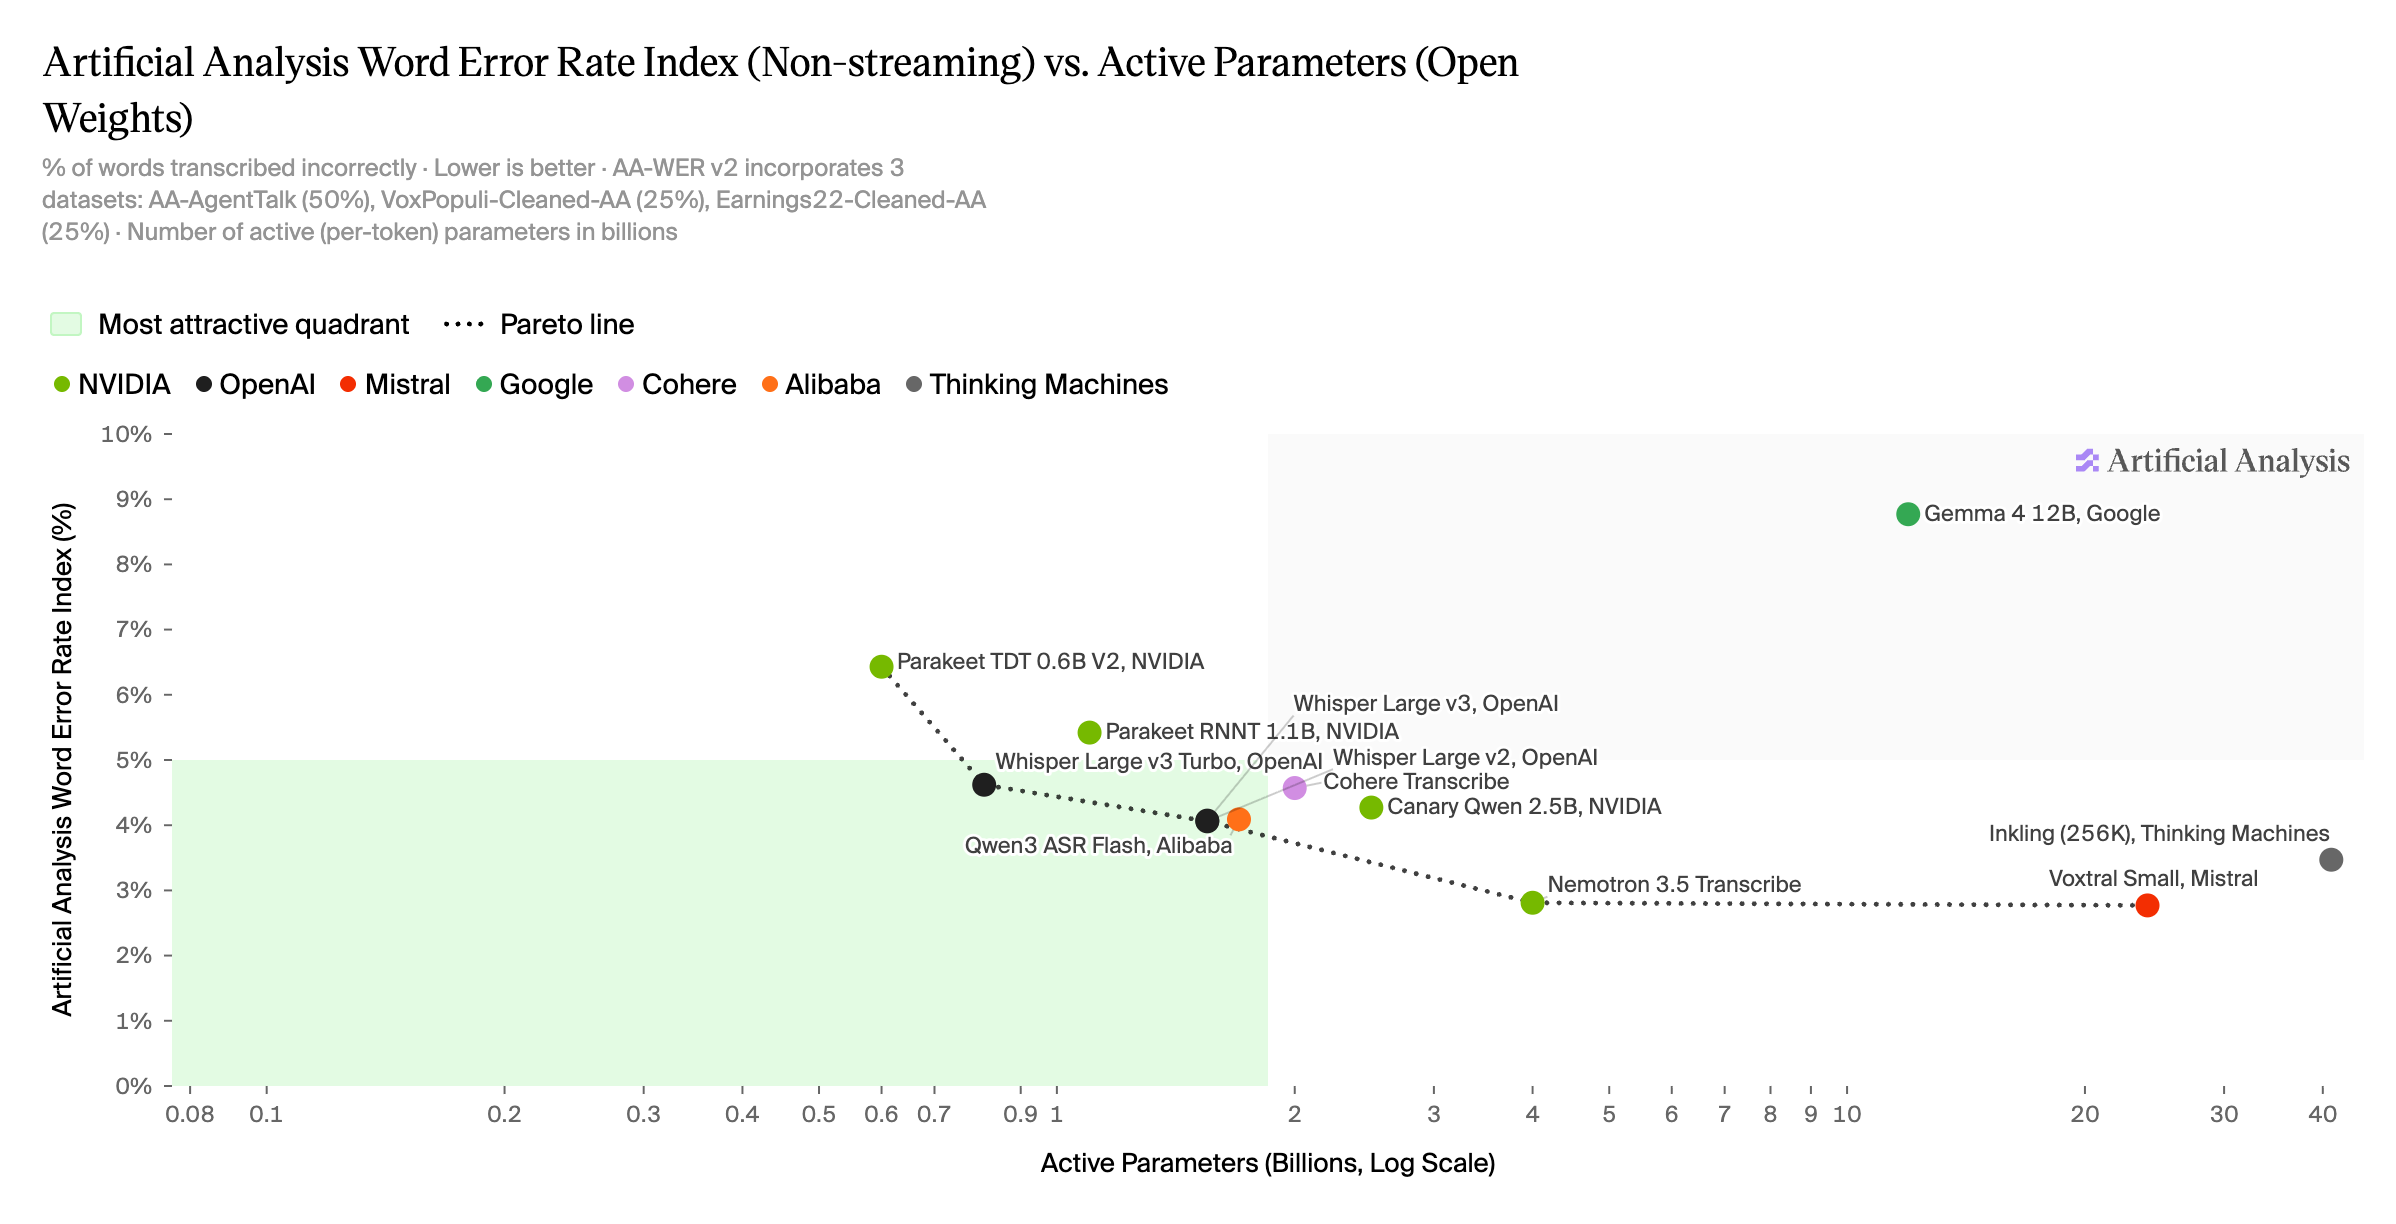
图 2. 以约六分之一的活跃参数量领先 AA 准确率:Nemotron 3.5 Transcribe 凭借约 4B 活跃参数量实现了 2.80% 的 AA-WER。
跨语言及重叠场景下的说话人归属。Sortformer 的说话人线索随声学特征一同传递给语言模型,使 Transcribe 能在生成过程中直接为每个轮次标记说话人,而非完全依赖后续步骤将说话人归属到单词上。
David AI DAI-ASR-I18N 排行榜。在 David AI 的 DAI-ASR-I18N 转写与说话人归属综合赛道中,Transcribe 在参评的开源权重模型中排名第一,总榜排名第二。在该基准测试的说话人分离(diarization)赛道上,该赛道考察 21 种语言中“何时由何人说话”的准确性,Transcribe 在 14 个测试系统中取得了最低的说话人分离错误率,略微领先于 NVIDIA 专用的 Nemotron 3 Diarization 模型。
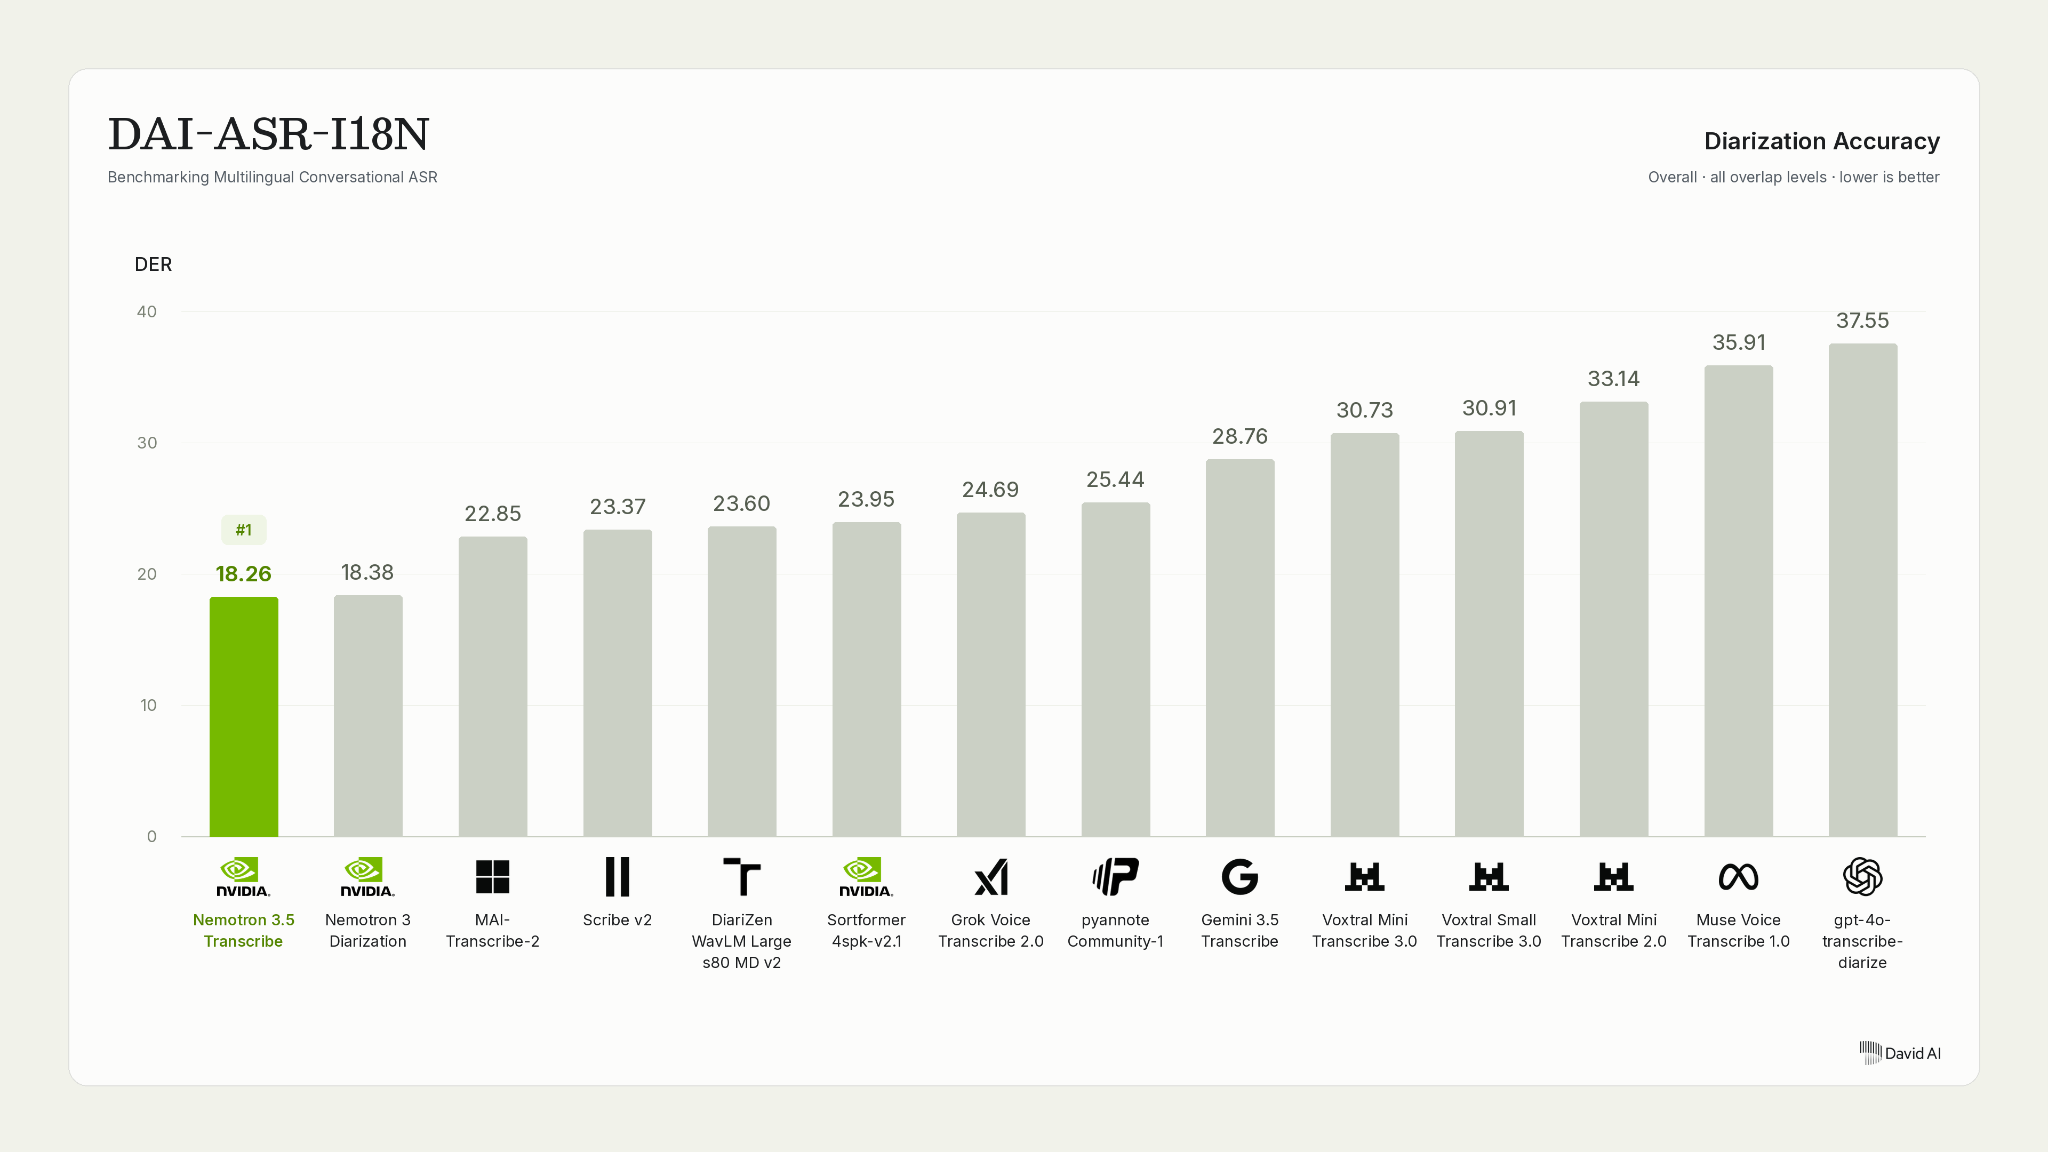
图 3. NVIDIA 模型包揽 David AI 多语言说话人分离排行榜前两名:Nemotron 3.5 Transcribe 取得最低的整体说话人分离错误率(DER),在 21 种语言上为 18.26%,紧随其后的是 Nemotron 3 Diarization,为 18.38%。DER 衡量说话人时间上的错误,数值越低越好。
VoiceArena Diarization-Bench。在 VoiceArena 的英语整场基准测试中,Transcribe 在 14 个系统中取得最低的拼接最小置换词错误率(cpWER),在线下和线上两类场景中均排名第一。它的漏词也最少:删除词占参考词的 8.32%,而所有系统的中位数约为 31%。
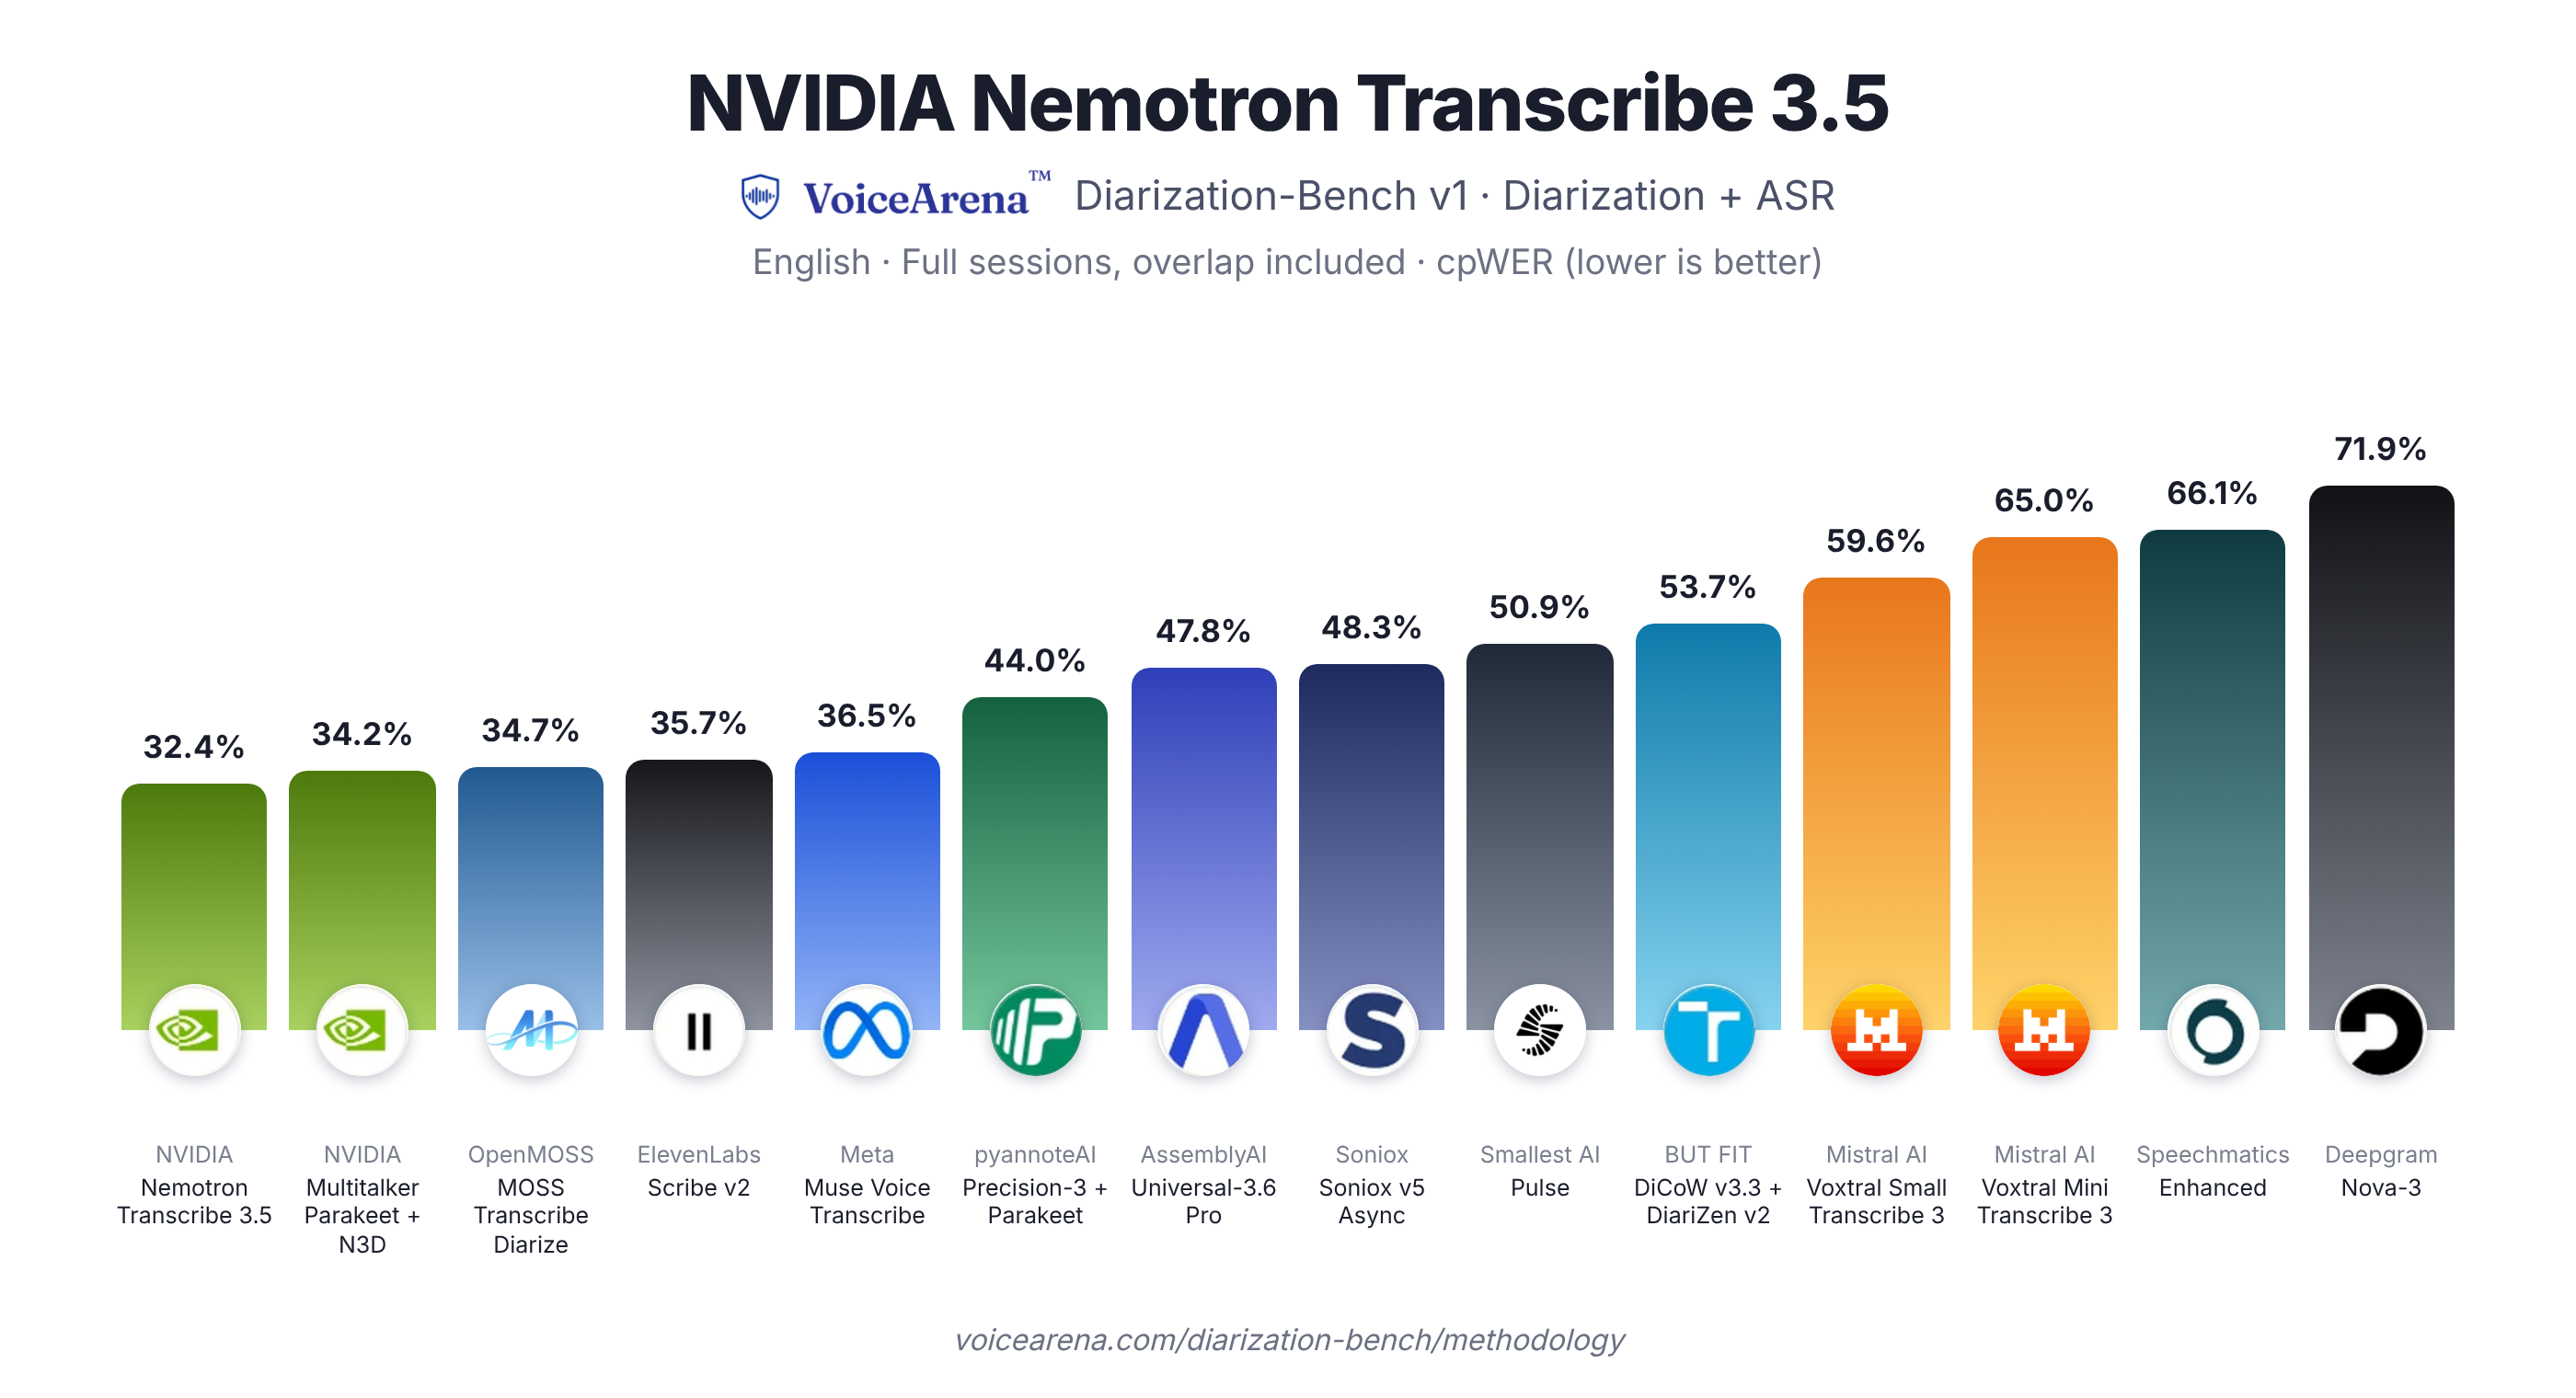
图 4. 在 VoiceArena 的 14 系统对比中,NVIDIA 模型包揽前两名:Nemotron 3.5 Transcribe 以 32.4% 的 cpWER 领先,其次是搭配 Nemotron 3 Diarization 的 NVIDIA Multitalker Parakeet,为 34.2%。Diarization-Bench v1 覆盖英语整场会话、重叠语音以及 2 至 8 名说话人。cpWER 在匹配说话人标签后统计词错误,数值越低越好。
更多评测。Ocular AI 的 Converse-STT 评测将 Transcribe 评为最佳开源模型。Josh Talks 的 Voice of India 排行榜也公布了 Transcribe 在多种印度语言上的成绩。
高吞吐转写。在基准测试中,Transcribe 在单块 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU 上,使用即将推出的 NVFP4 量化版本,在三分钟内处理了 100 小时的音频。测试结果基于高并发环境下的 30 秒片段得出。
目前,您可以使用 vLLM 部署可用的检查点。基于 NeMo-Speech.cpp 的本地部署及量化版本即将推出。Transcribe 专为录制音频设计,不适用于实时流式处理。
专业领域的录音仍可能需要适应领域词汇和转写规范。Granary v2 和 NeMo Speech 的微调可解决这一问题,其起点是 Transcribe 背后的数据。
Granary v2:Transcribe 背后的开放数据策展流水线
可提示的语音模型需要具有明确格式化目标的训练数据。Granary v2 是 Hugging Face 上 Nemotron 语音集合 及 ModelScope 的一部分。它基于 NVIDIA NeMo Curator 构建,其可复用流水线处理了用于 Nemotron 3.5 Transcribe 训练的多语言语音,生成对齐的转写变体、任务标签及可审查的质量元数据。公开清单涵盖 48 种语言、16 个源语料库共 463,062 小时的音频,较 Granary v1 的 25 种语言有所增加。这些数据描述的是数据集发布内容,而非 Transcribe 的完整训练混合或采样权重。
Granary v2 为每条录音生成三种转写形式(表 1),即开发者可通过提示词从 Transcribe 请求的逐字模式和清晰模式。除转写外,该流水线还生成短音频字幕、借词的代码切换恢复、基于语音的问答对、上下文相关的 ASR 偏置词以及带自动质量分数的翻译。
| 训练目标 | 示例转写 |
|---|---|
| 文本归一化、逐字 | 我付了,呃,二十五欧元。 |
| 带语气的反向文本规范化 | 我付了,呃,25欧元。 |
| 不带语气的反向文本规范化 | 我付了25欧元。 |
表 1. Granary v2 对同一句话的训练目标。
该流水线由四个可复用阶段组成:
- 1. 音频预处理(元数据):对原始或长音频进行分段,追踪全录音中的说话人,并标记声学事件和语言。由于 Granary v2 的数据源已预先分段,本次发布跳过了此阶段。
- 2. 转录(ASR):将每种语言路由到主 ASR 模型和备用 ASR 模型,当主模型未能通过幻觉检测时自动回退。人工参考转录文本有助于保留可信拼写,同时补充口语表达和语气词。
- 3. 任务标签生成(文本):生成转录变体,并检查字符率、幻觉模式以及模型与人工参考的一致率。仅被接受的记录才会获得上下文 ASR 术语和翻译。
- 4. 高保真(HiFi):剔除包含噪声、削波或多人的片段,保留更小规模的高质量录音集合,用于 ASR 以外的用途。对于 VoxPopuli 数据集,它将 35.4 万小时的数据精简至 11.1 万小时,覆盖 22 种欧洲语言。
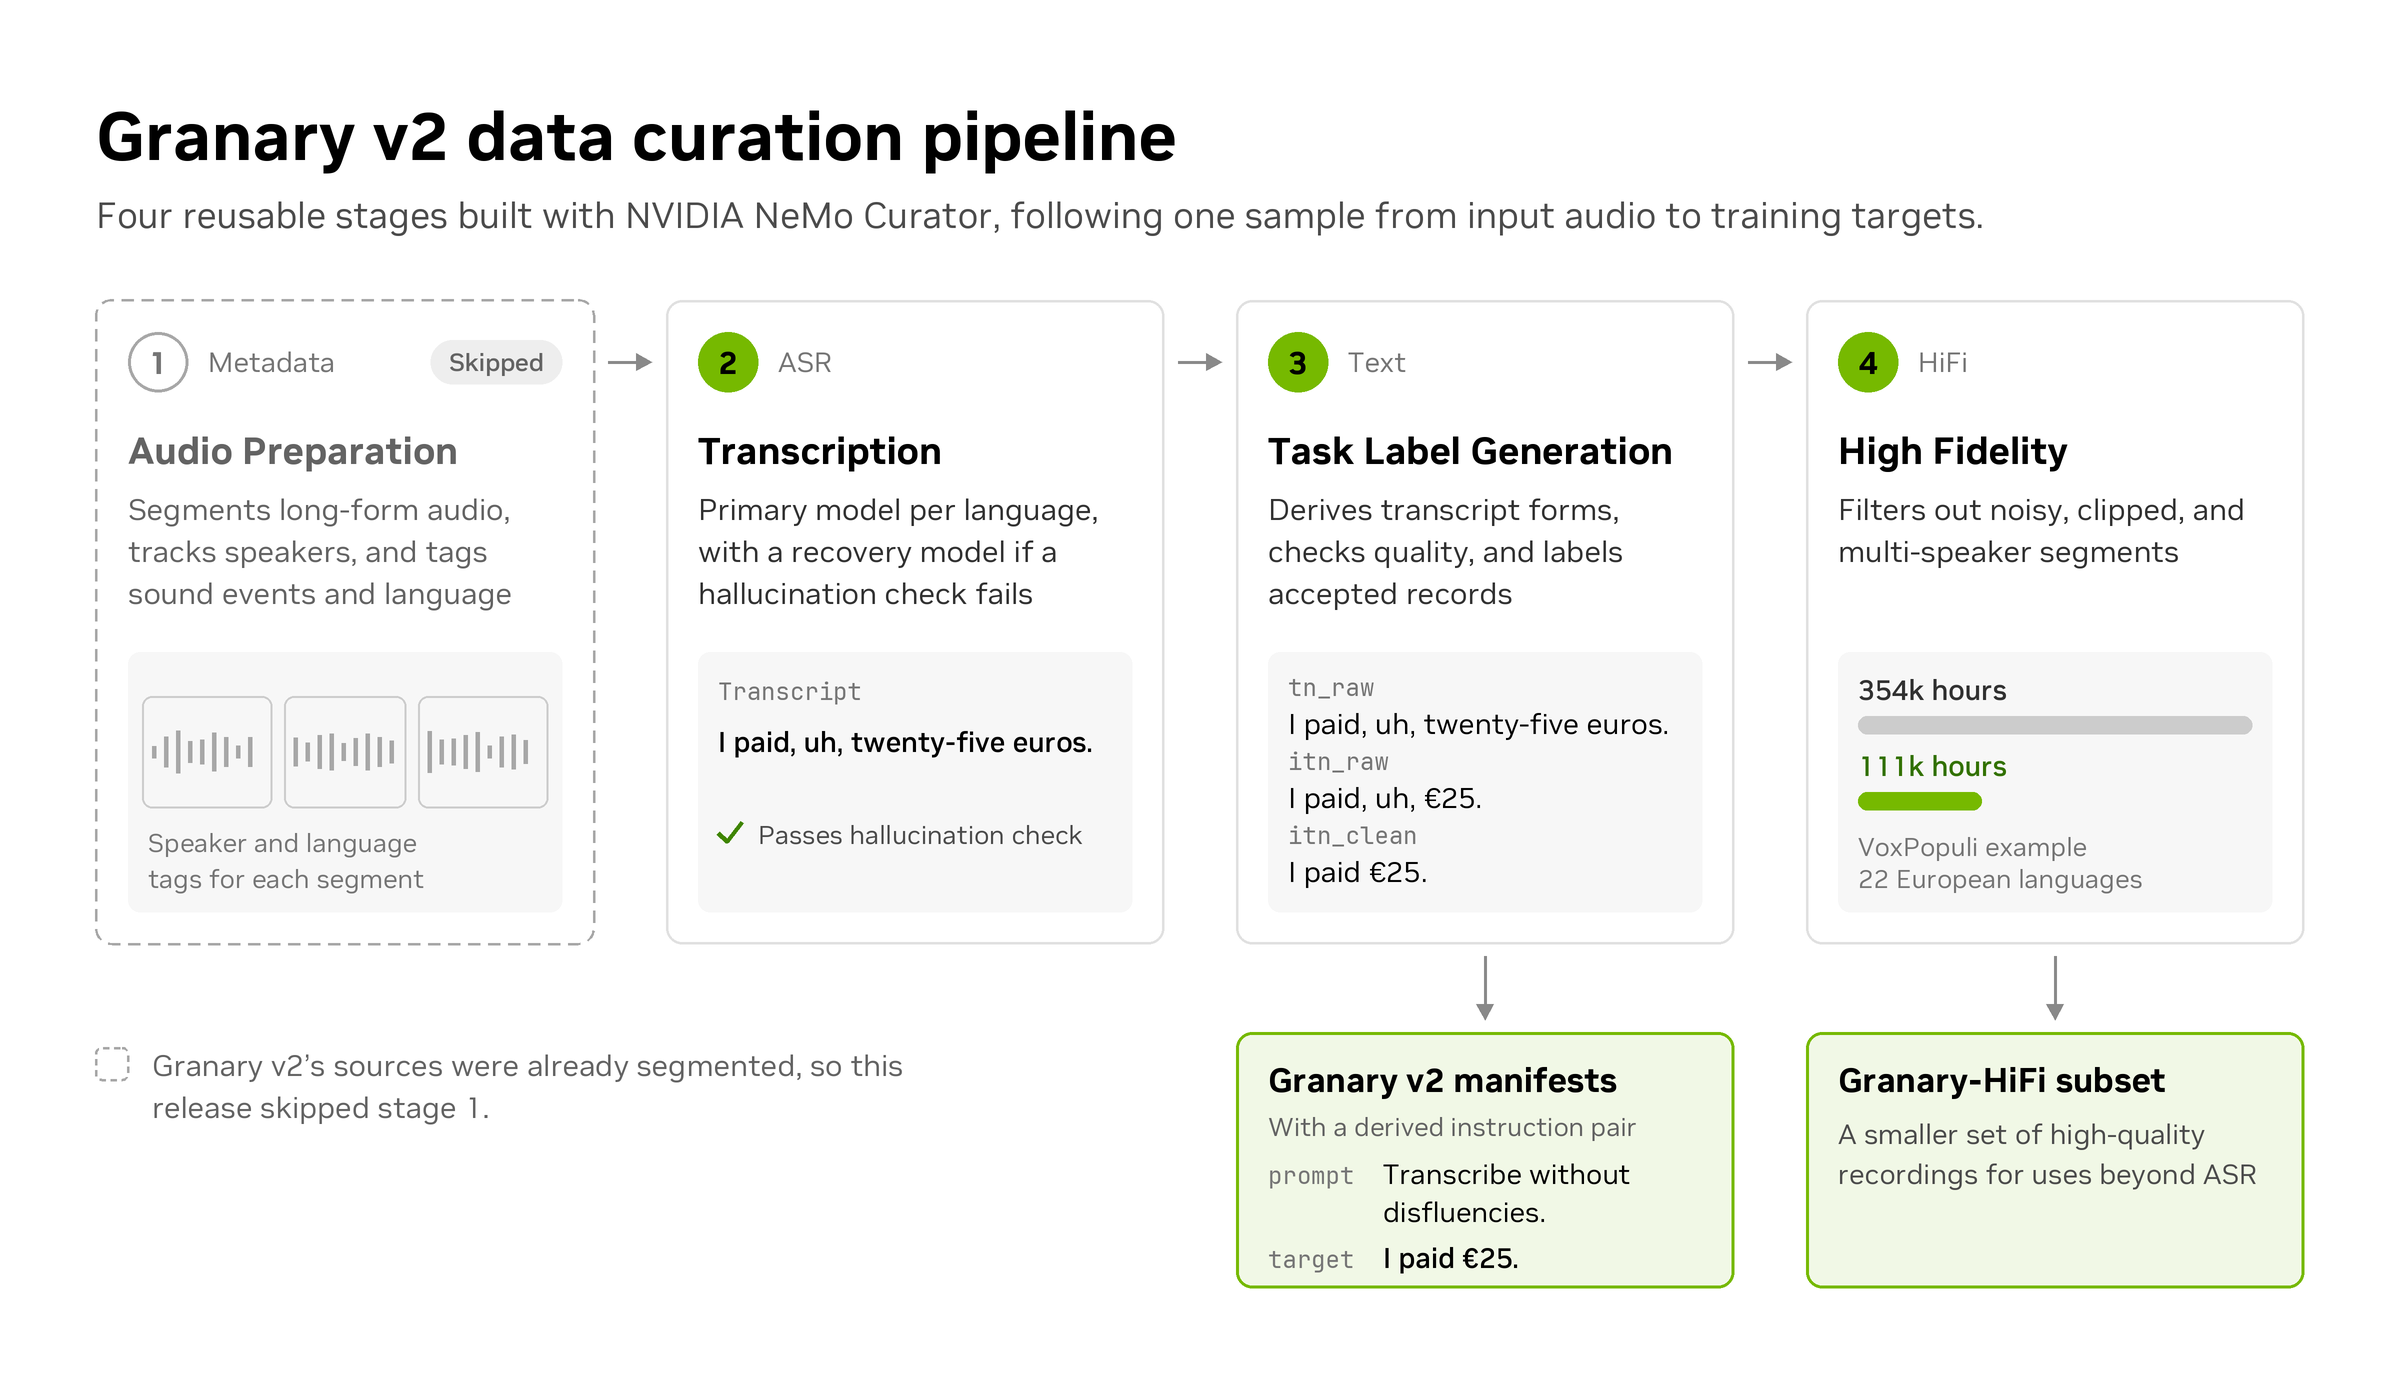
图 6:Granary v2 数据整理管线,展示一条样本从原始音频经 Metadata、ASR、Text 各阶段到最终训练样本的过程。
开发者可以在自己的录音或已授权的公开语料上,通过 Ray 与 NVIDIA Dynamo 后端运行 NeMo Curator 管线,也可以基于 Granary v2 公开 manifest 进行开发。这些 manifest 包含 tn_raw、itn_raw、itn_clean 三种转录形式、上文提到的各类标签、实体提示、派生的指令对、数据来源信息,以及每条记录的质量标记。源音频需在各语料库的原许可条款下单独下载,并遵循发布时的公开条款。
让识别适配你关心的词表
首先在开发集上测试提示词,明确指定语言、文字系统与转录格式。在下面的案例中,提示词里注明“英语”和“拉丁字母”后,全量基准的 WER 从 30.8% 降到 23.8%。对于仍存在的领域词汇错误,可用 NeMo Speech 微调流程,把代表性语音与明确的书面目标文本配对训练。
NeMo Speech 医疗 ASR 案例在 Eka Care 开放基准上演示了这一流程。该基准包含 3,619 条来自印度医生和医学生的录音,且没有专门的训练集划分。该研究基于生成的医疗文本和公开药品目录构建适配数据,最终组合了约 153 小时合成语音、29 小时 Common Voice 口音英语和 63 小时 MultiMed 医疗录音。
图 7:在 Eka Care 印度医疗语音基准的全量测试集上,优化提示词将 WER 从 30.8% 降到 23.8%,微调后进一步降至 11.8%,比开箱即用的模型减少约 62% 的转录错误。全量测试集包含用于挑选提示词和检查点的 855 条调优片段;下文的留出集结果才是更干净的测试。
合成生成过程将书面目标与其口语发音形式解耦:例如,“HbA1c”是书面标签,而实际发送给语音合成器的指令是“H B A one C”。通过引入多种 TTS 声音以扩展音频多样性,并结合真实录音以覆盖不同的口音和录音环境,系统显著增强了数据覆盖范围。训练文本会经过过滤,剔除与基准参考答案中完全匹配的内容及共享八词序列的片段。
与 Granary v2 中显式指定目标的方式类似,训练样本对数字、单位间距、公司名称全称化以及品牌名称连字符的使用进行了多样化处理,同时通过指令明确指定了所需的书写规范。部分提示词中包含了术语列表及近似干扰项,以便模型学会仅在音频证据充分时才采用特定拼写。最终系统采用固定的规范提示词和单次模型推理,无需检索或转录后处理。
该方案训练了语音编码器及投影层,并采用 LoRA 技术微调语言模型。两轮训练使用了不同的数据混合比例;在合并适配器后,选中的检查点通过均匀平均生成最终模型。检查点的选择依据是在开发集上的解码结果,而非仅依赖训练损失。整个适配流程从文本生成到评估耗时约 14 个 GPU 小时,仅在一块 NVIDIA GB300 上完成。
在留出说话人上衡量的领域提升
研究将基准测试集按说话人划分为 855 条用于选择提示词和检查点的调优片段,以及 2,764 条留出片段(每个最终系统仅解码一次)。使用 Eka Care 的 KARMA 评分流水线,微调后将留出集的 WER 从最佳提示词基线的 22.44% 降低至 12.17%,相对降幅达 45.8%。这一结果清晰地证明了性能提升可泛化至新的说话人。关键词 WER 从 9.2% 降至 6.5%,语义 WER 从 10.0% 降至 7.6%。在相同的留出说话人和评分器下,适配模型的 12.17% WER 优于开放医疗专家模型(13.79%)和广泛使用的通用 ASR 模型(14.92%)。
在通用英语方面,LibriSpeech test-clean 的 WER 略有上升,从 1.54% 变为 1.69%。在品牌药品和诊断名称的精确匹配上,医疗专家模型仍占据优势;研究指出,下一步应引入临床医生说出品牌名称的真实录音。对于自有领域,建议保留至少 100 条真实且有标签的片段用于检查点选择,并在评估应用依赖的实体类型的同时,关注通用语音识别能力的保留情况。
案例研究包含复现各步骤所需的命令。微调教程涵盖了训练、导出和评估的配方、资源需求及工具,包括新语言和支持语码转换的 ASR。配套的代理技能允许编码代理执行整个工作流,涵盖从基线选择、数据检查到训练验证、适配器合并及评估。
ModelScope 也允许开发者通过其 ms-swift 框架对 Nemotron 3.5 Transcribe 进行微调,以满足特定的多模态应用需求。
开始使用 Nemotron 3.5 Transcribe 和 Granary v2
在 Hugging Face 演示或 ModelScope Studios 上试用 Nemotron 3.5 Transcribe,然后从 Hugging Face 或 ModelScope下载检查点。若需自托管转录,可使用 vLLM 或 SGLang-Omni入门,两者均从第一天起就提供支持。
若要跳过自托管步骤,请使用 Baseten、DeepInfra 或 Simplismart 提供的托管端点。
若需将其适配到特定领域,可从 Hugging Face 或 ModelScope 获取 Granary v2 清单文件,并参考 医疗 ASR 案例研究;或者使用微调代理技能让编码代理来驱动工作流。
模型与数据集
- 模型检查点:NVIDIA Nemotron 3.5 Transcribe 可在 Hugging Face 和 ModelScope 获取 | 交互式 Demo 见 Hugging Face 和 ModelScope
- 托管端点:Baseten、DeepInfra
- 数据集清单:Granary v2 清单可在 Hugging Face 和 ModelScope 获取
- 高保真子集:清单可在 Hugging Face 和 ModelScope 获取 | Hugging Face Space
代码仓库与教程:NVIDIA NeMo Speech GitHub | NeMo Curator Granary v2 流水线 | vLLM 部署指南 | 语音微调指南 | 微调 Agent Skill
合作伙伴博客: Agora | Inflection AI | VoiceArena | Simplismart | DeepInfra
本地 AI: NVIDIA RTX 电脑、笔记本电脑和 DGX Spark 上的本地 AI 新进展