Uber如何构建AI智能体访问工具的网关
市场不会等人。在预测市场(prediction market)上,价格以毫秒为单位波动,每一笔交易都必须在发生的瞬间落地。12 月 9 日的 Agentic Data Summit 上,Kalshi 技术专员 Batu Balimtas 将在 Engineering for the Moments That Move Markets: Kalshi and Redpanda 中带你深入幕后,了解 Kalshi 的数据基础设施如何在最关键的时刻跟上节奏,以及在生产环境中运行需要哪些投入。Kalshi 的分享时间为太平洋时间下午 12:00。峰会免费、线上进行,时间为太平洋时间上午 8:30 至下午 2:00,你可以选择参加最感兴趣的主题。
开箱即用的大语言模型可以解释你代码中的错误、给出可能的原因,或者执行写数据库查询这类任务。但这些都只是基于模型训练得到的通用能力,你无法指望它结合你系统内部的实际运作来给出答案。
解决这个问题靠的是工具(tool)。每个工具都为特定任务而构建,但工具多了之后管理就会变得麻烦,在企业环境中尤其如此。Uber 的工程团队就遇到了这种情况。
为此,他们构建了 MCP Gateway。可以把它理解为一个共享平台,让不同的 AI agent 发现有哪些工具可用,并利用这些工具完成任务。本文将详细介绍 Uber 是如何构建这个网关的,内容包括:
什么是工具,以及 AI agent 为什么需要它们
MCP 在 Uber 的角色
Uber MCP 网关的设计
网关如何发现可用的工具
MCP 网关的工作原理
MCP 网关如何处理权限与访问控制
免责声明:本文基于各来源公开的信息整理而成。参考文献见文末。如发现任何错误,欢迎留言指正。
AI 智能体为何需要工具
如果你希望通用 LLM 针对你当前的系统生成专属答案,就必须向它开放系统信息的访问权限。举个例子,当开发者询问基于 LLM 的 AI 助手为何 XYZ 服务突然故障时,答案往往隐藏在系统日志、部署记录、监控指标和事故报告中。LLM 需要访问这些信息才能解答此类问题。
这就是工具发挥作用的地方。你可以将工具视为 AI 应用可执行的一种操作。例如,你可以创建用于搜索日志、获取事故详情或检查部署状态的工具。模型选定工具并提供必要的输入参数后,应用程序执行该操作并将结果反馈给模型。
许多此类工具实际上已经是 API。如你所知,API 是一种让一个程序向另一个程序请求服务的接口。例如,我们可以有一个日志服务,它暴露一个 API,接收服务名称和时间范围作为输入,然后返回该时间段内的所有日志条目。
然而,要让智能体使用这类服务,我们需要描述其功能及所需输入。这种结构化定义就构成了 LLM 应用所使用的工具。在幕后,API 执行实际的搜索任务。
MCP 在 Uber 中的作用
MCP 即 Model Context Protocol。借助 MCP,AI 应用获得了一种标准方式来发现可用的外部能力并与之交互。Uber 在其工具生态系统中应用了 MCP。
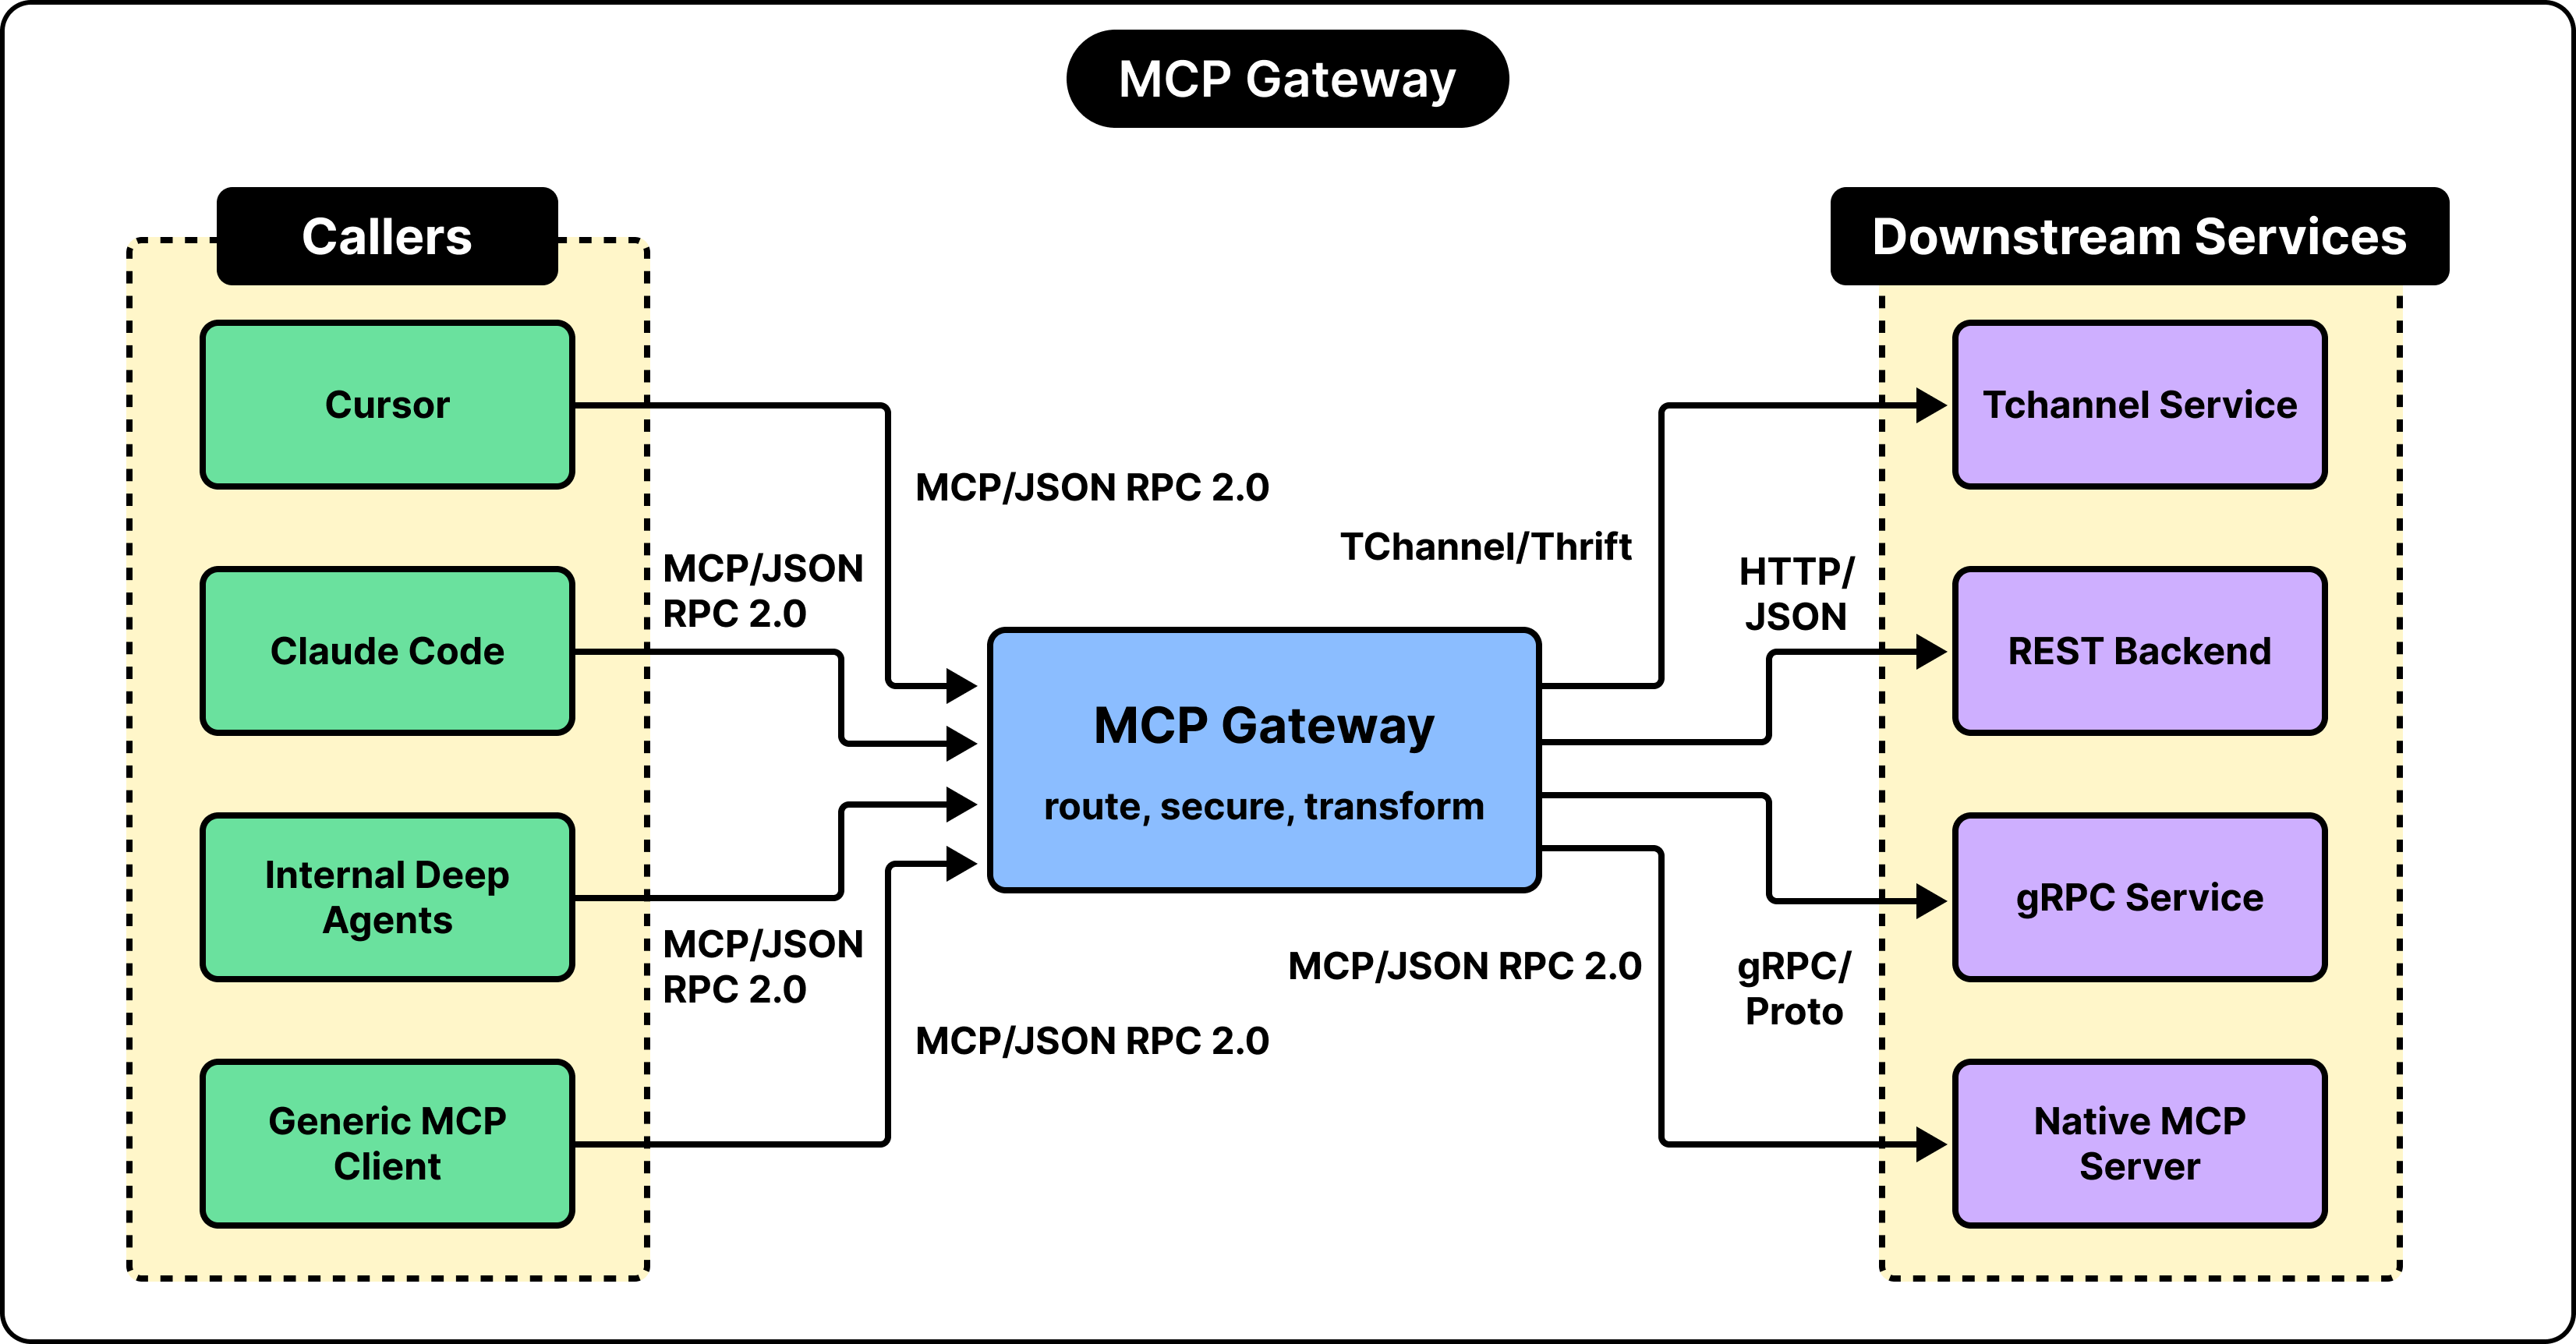
要深入理解 MCP 的作用,需要掌握三个关键术语。
首先是 MCP 客户端。它嵌入在 AI 应用中,负责通过 MCP 协议进行通信,处理诸如请求可用工具列表、调用选定工具等交互任务。
其次是 MCP 服务器。它通过 MCP 暴露其能力(即工具)。在 Uber 的场景中,服务器不仅展示可用工具,还接收对这些工具发出的请求。
第三是 MCP 工具。它是服务器暴露出的单个操作,也可以理解为一种能力。一个服务器可以提供多个工具。
MCP 要求你正确定义工具。这种定义包含名称、描述和输入模式(input schema)等信息。模式定义了数据结构,包括包含哪些字段、哪些是必填项以及允许的值类型。例如,你可以定义一个模式,要求 service_name 为字符串,limit 为整数。
MCP 采用结构化方式格式化请求及其参数,同时也规范了对应的结果或错误格式。该格式通常基于 JSON-RPC 2.0。这种标准化使得集成更加容易,同一个 MCP 客户端可以与不同的 MCP 服务器通信。
然而,标准化并非没有代价。必须有人决定哪些工具存在以及它们在哪里运行,同时还需追踪工具的所有权及其运作方式。起初,Uber 内部的工程团队各自构建了自家的 MCP 集成,小范围内拥有较高的自主性。但随着采用范围扩大,显而易见各团队都在解决类似问题,例如暴露工具、管理连接、处理权限等。雪上加霜的是,由于一切分散各处,很难查清到底有哪些工具可用。
除此之外,Uber 现有的服务格局还带来了另一个挑战。Uber 内部各服务的通信方式并不统一:有的用 HTTP,有的用 gRPC,还有的用 TChannel。比如,HTTP API 可能用 JSON,而 gRPC API 用 Protobuf 消息。如果不修改请求格式,就没法把 MCP 请求直接转发给这些服务。
因此,Uber 需要一个公共层来连接 MCP 客户端和工具,同时承担统一的发现、安全和运维支持功能。这一层就是 MCP Gateway。
Uber MCP Gateway 的设计
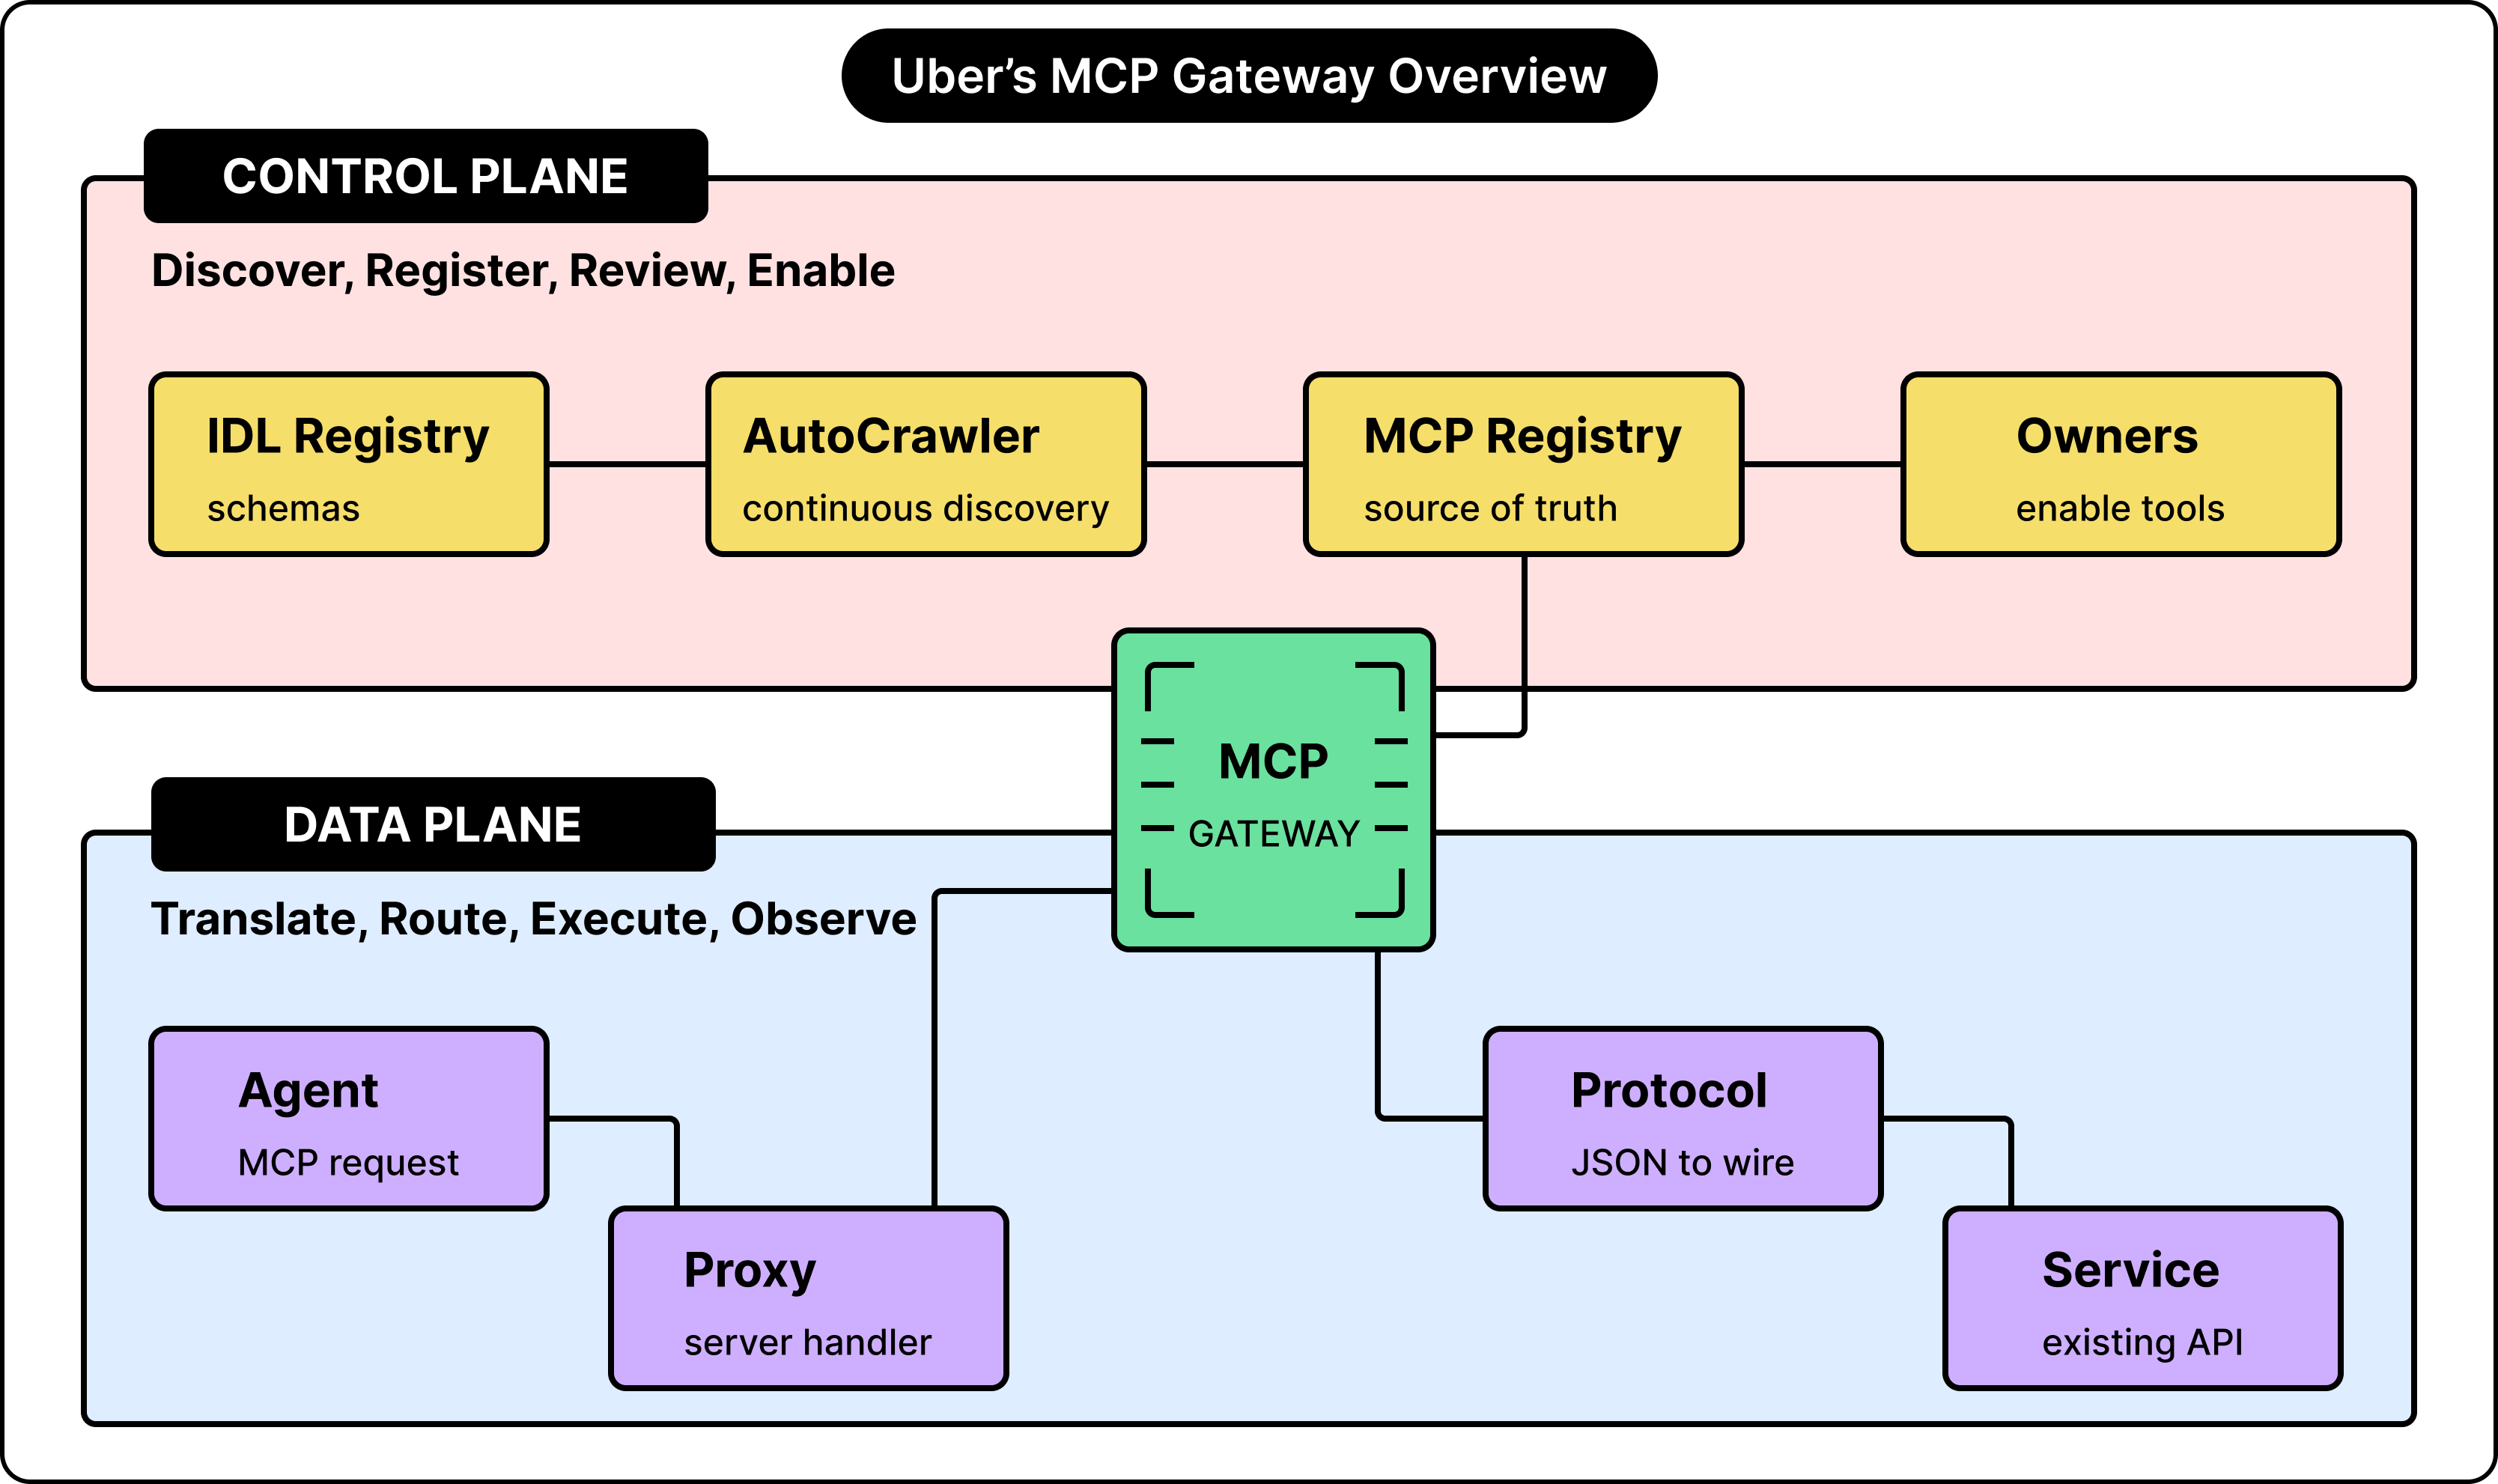
Uber MCP Gateway 平台分为两大组件:MCP Registry 和 Proxy Gateway。这种分离让 Uber 的工程团队可以独立管理工具定义和权限。
下面分别详细介绍。
MCP Registry
可以把 MCP Registry 理解为控制面,它保存着 MCP 服务器和工具的目录。工具的发现信息及其详细描述都可以记录在 registry 中。
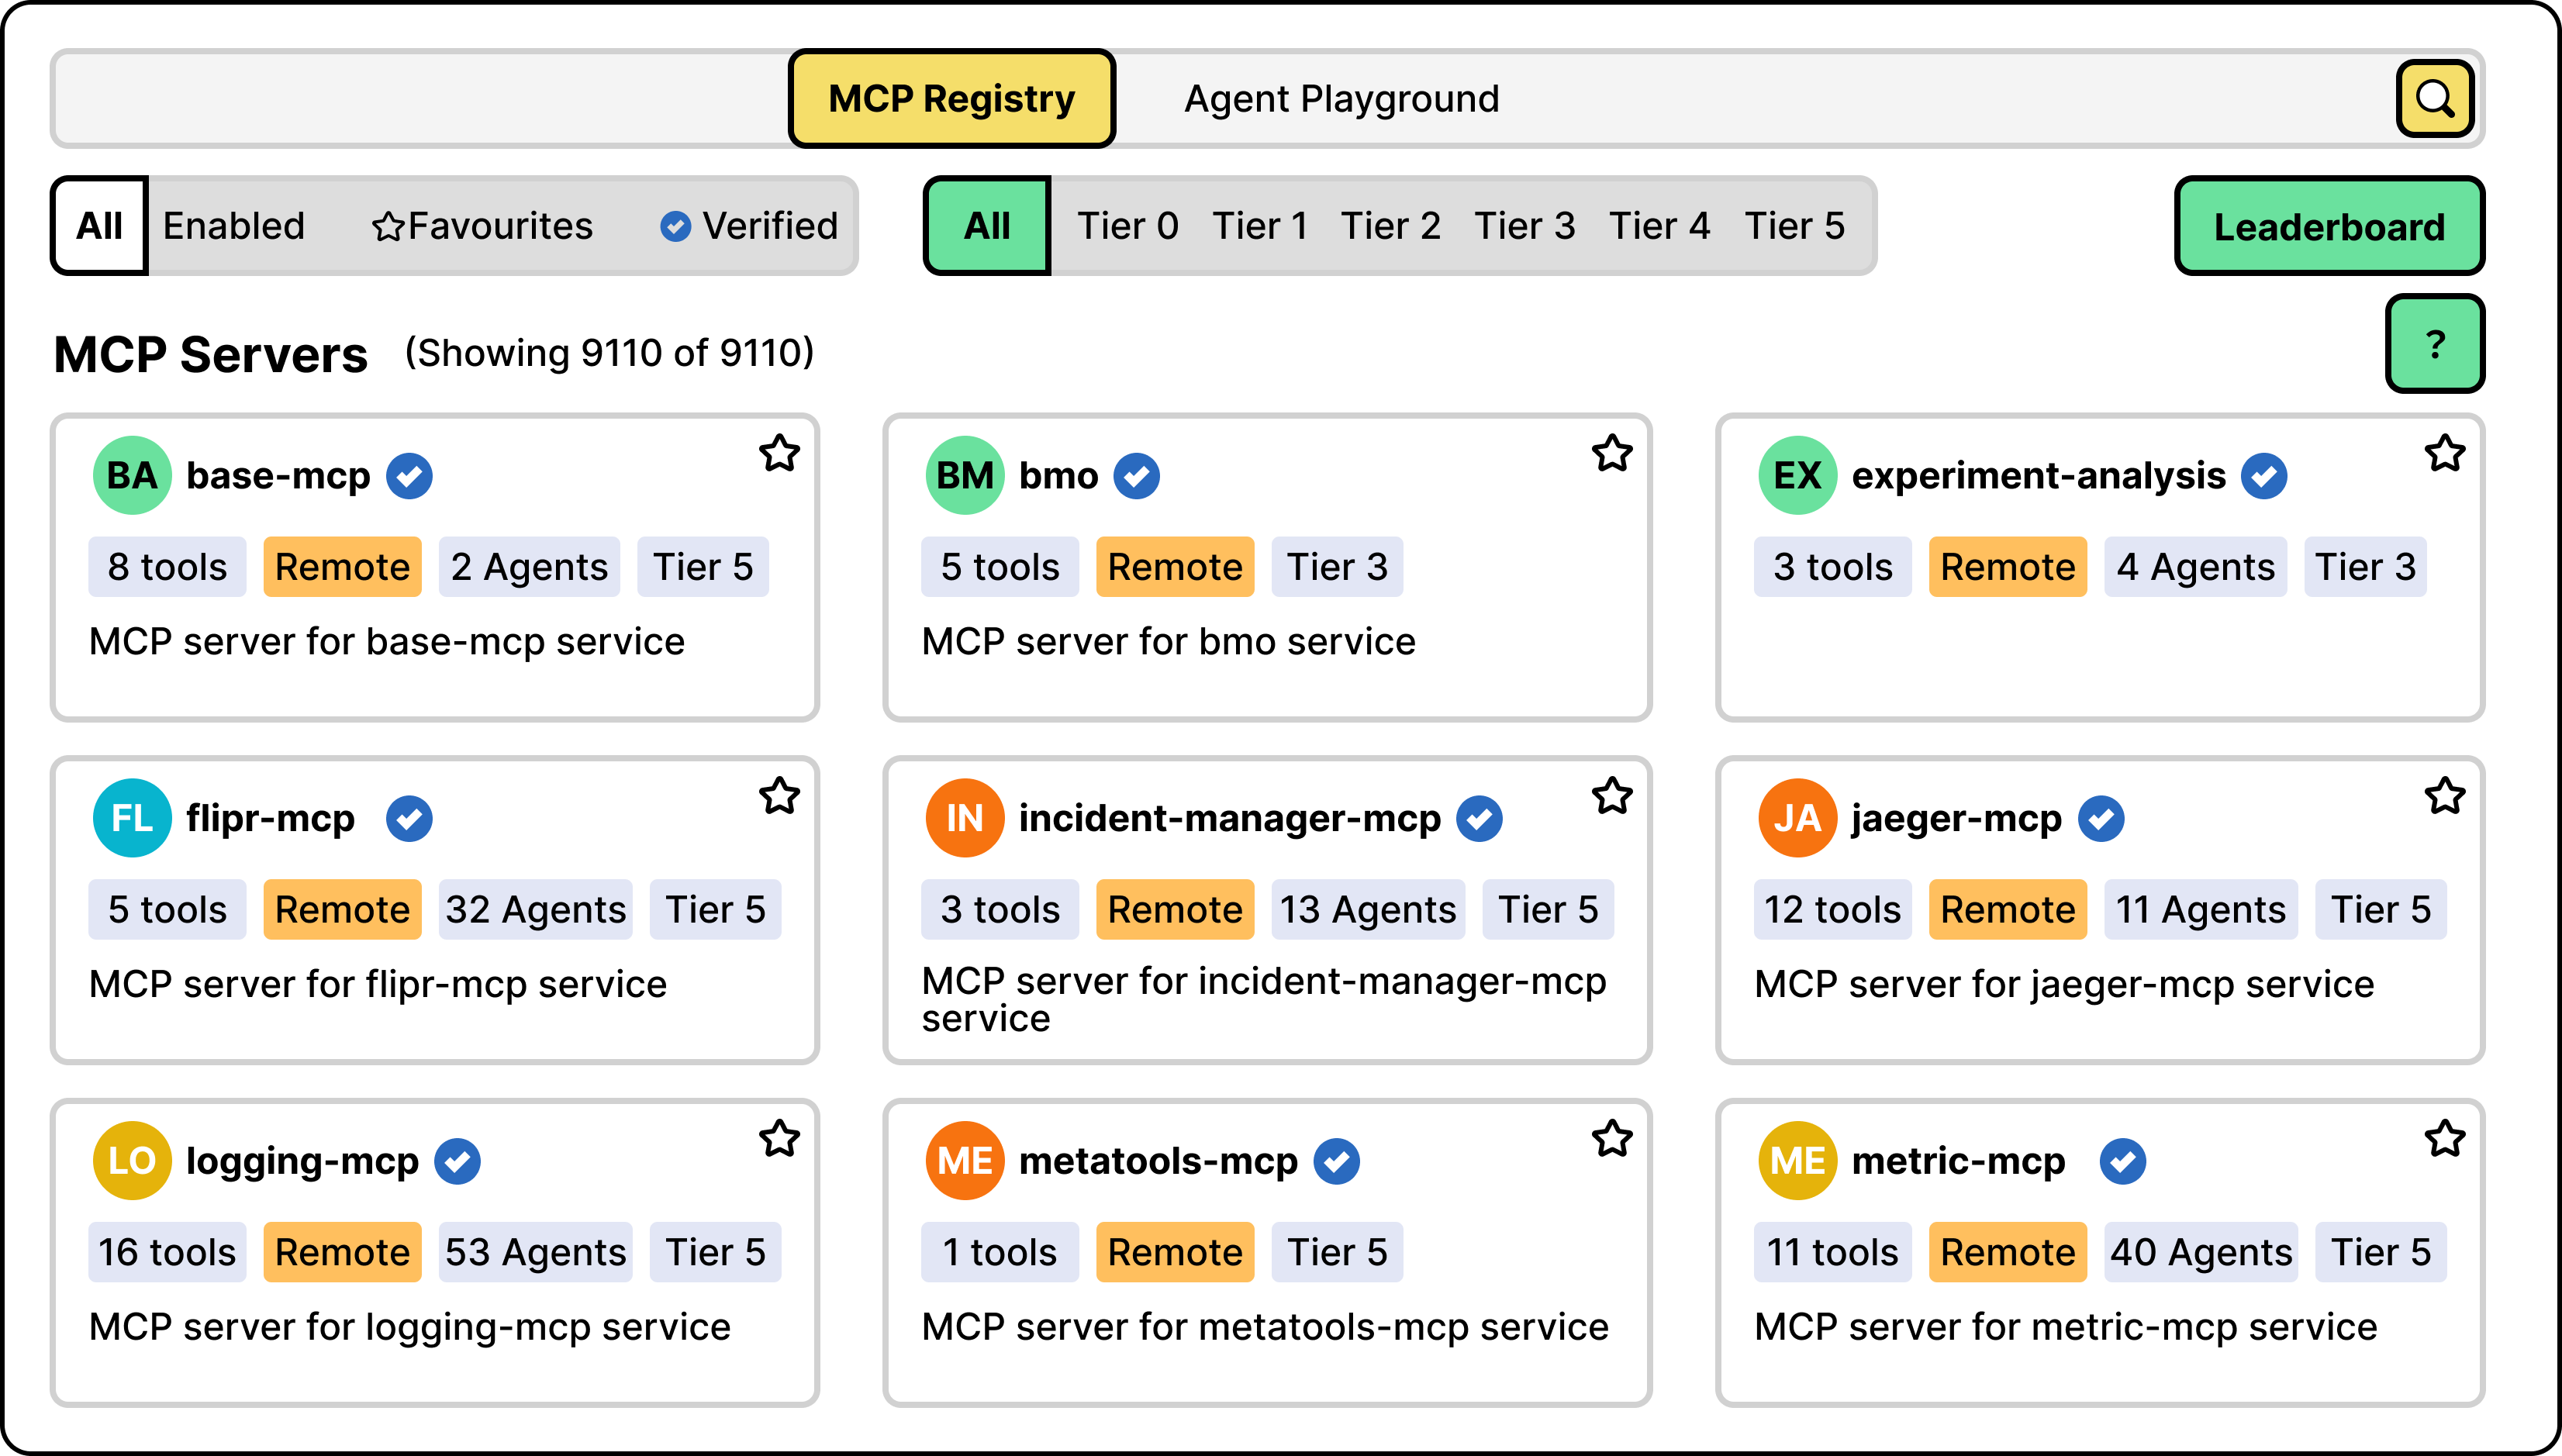
之所以称它为控制面,是因为 registry 还负责管理配置,比如可以在 registry 里启用或禁用某个工具。它同时也是共享的唯一事实来源。
Proxy Gateway
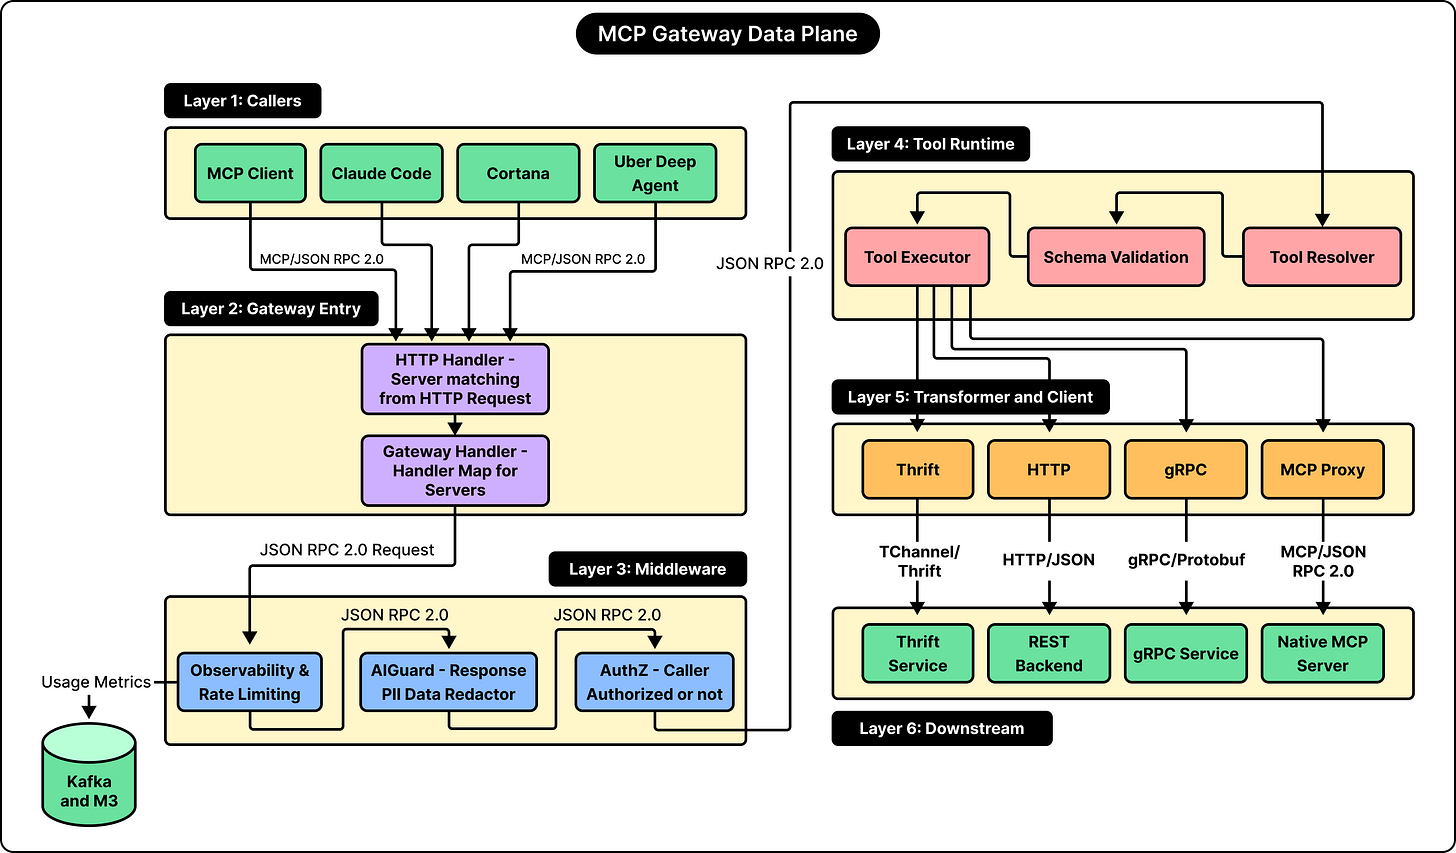
这是数据面,负责在 agent 工作时处理实际的 MCP 请求。
Gateway 会识别请求的工具,施加必要的控制,把请求转发到正确的服务,并返回 MCP 兼容的结果。
工具如何被发现
为成千上万个服务手动创建 MCP 集成既费时又容易出错。为此,Uber 用 AutoCrawler 把大部分工作自动化了。
AutoCrawler 负责发现现有的 API 和 MCP 服务器。它会生成或获取它们的工具定义,并将其注册到 MCP 注册中心。
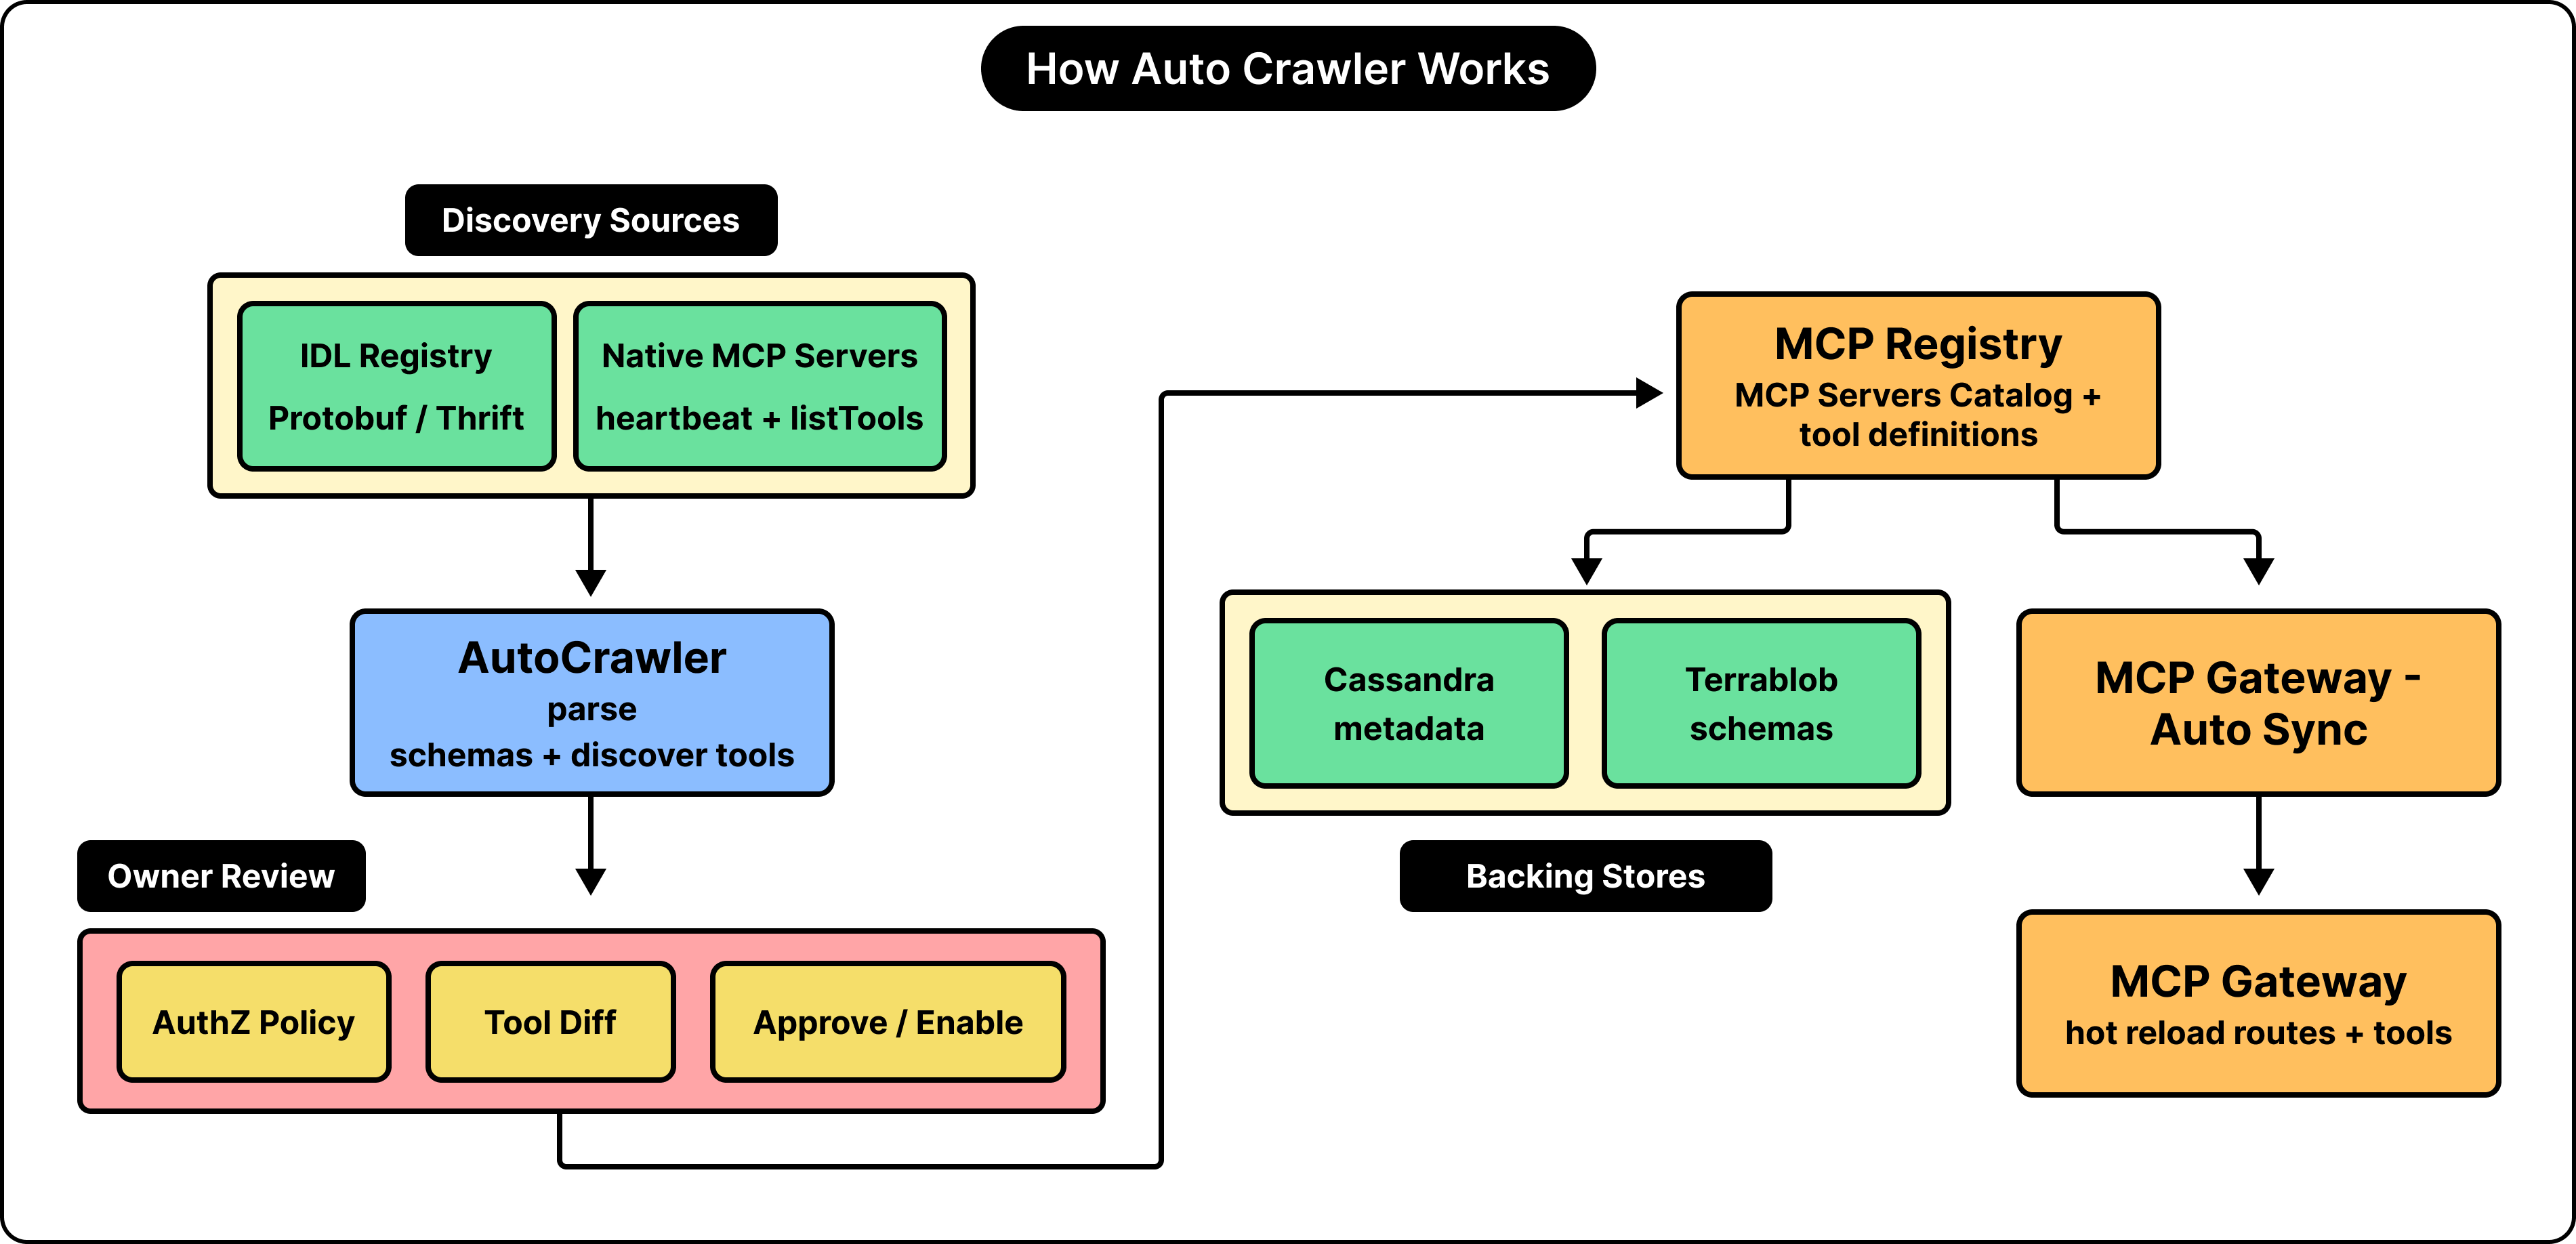
从技术层面看,AutoCrawler 是一个分布式工作流系统,由 Cadence 驱动。在这种架构中,有一个定时任务会启动工作流,用于查找新的服务、API 或模式变更。
AutoCrawler 是如何发现新事物的呢?它主要有两条发现路径:
来自现有 API 定义
许多 API 使用内部定义语言(IDL)来描述其接口。
IDL 是对服务接口的机器可读描述。你可以用它来指定操作名称、请求字段和文档注释。例如,一个 API 定义可能描述了一个名为 GetDeploymentStatus 的操作,该操作接受部署 ID 作为输入,并返回状态和时间戳。
AutoCrawler 可以读取这些定义,并经过几个步骤进行处理。
首先,它为服务创建一个 MCP 服务器表示,或者更新现有的表示。接着,它提取方法名称、请求和响应结构。然后,将提取到的内容翻译成 MCP 可理解的工具模式。
AutoCrawler 还使用 LLM 根据从服务中提取的细节生成更优的工具描述。最后,它将这些工具定义存储在注册中心。
由此可见,AutoCrawler 是 Uber 无代码方式的一个绝佳范例。现有的服务契约包含足够的信息,平台可以据此构建 MCP 接口。
发现原生 MCP 服务器
一些服务直接实现了 MCP。在 Uber,这些被称为原生 MCP 服务器。这些服务器已经有了工具定义,因此 AutoCrawler 在获取这些定义时的工作量更小。
每个原生服务端都会发出一个心跳指标,以此表明该服务端已就绪。AutoCrawler 负责追踪这些信号。一旦定位到服务端,AutoCrawler 就会调用其 listTools 操作。在获取到工具列表后,它会为所有工具及其 schema 在注册中心生成相应的代理表示。
由此可以看出,两种发现路径最终都……