
使用 LFM3 构建专用多模态模型
LFM3 是我们新一代 Liquid Foundation Model(LFM),专为构建专用智能而设计。它将文本、视觉、音频、全模态和决策模型统一在同一个 2B 参数级的骨干网络中。这意味着你可以为特定模态选择模型,在单张 GPU 上用自有数据微调,并直接部署到应用运行的环境中。
与前代的 LFM2 系列相比,LFM3 带来了四项主要变化:
- 单参数能力更强: 新的三混合架构与训练方案使 LFM3-1.7B 在参数量减少 35% 的情况下,性能超越了 LFM2.5-2.6B。
- 全模态共享骨干: 从 LFM3-1.7B-Base 训练出六个 2B 级别的模型(涵盖文本、视觉、音频、全模态和决策),其中包含我们首个全模态模型,以及支持视频输入的视觉模型。
- 专为边缘场景打造: 文本模型在 4-bit 精度下体积约为 1 GB;自研的视觉和音频编码器加速了处理流程;文本模型的 256K 上下文窗口支持智能体在端侧运行。
- 易于专用化: 所有模型均可在单张 GPU 上完成微调,方便你根据自有数据、术语及部署环境进行定制。
如何构建更具表达力的骨干网络
LFM2 已证明,短卷积与注意力机制的混合架构能在不牺牲质量的前提下,实现设备端的高速运行。在 LFM3 中,我们利用硬件在环(hardware-in-the-loop)架构搜索技术,重新设计了针对智能体用例的架构,以在长上下文下实现更快的推理并提升单参数能力。此次搜索覆盖了 14 种设备与后端组合,范围从手机、树莓派 5(Raspberry Pi 5)到笔记本电脑、云 CPU、GPU 以及高通 Hexagon NPU。
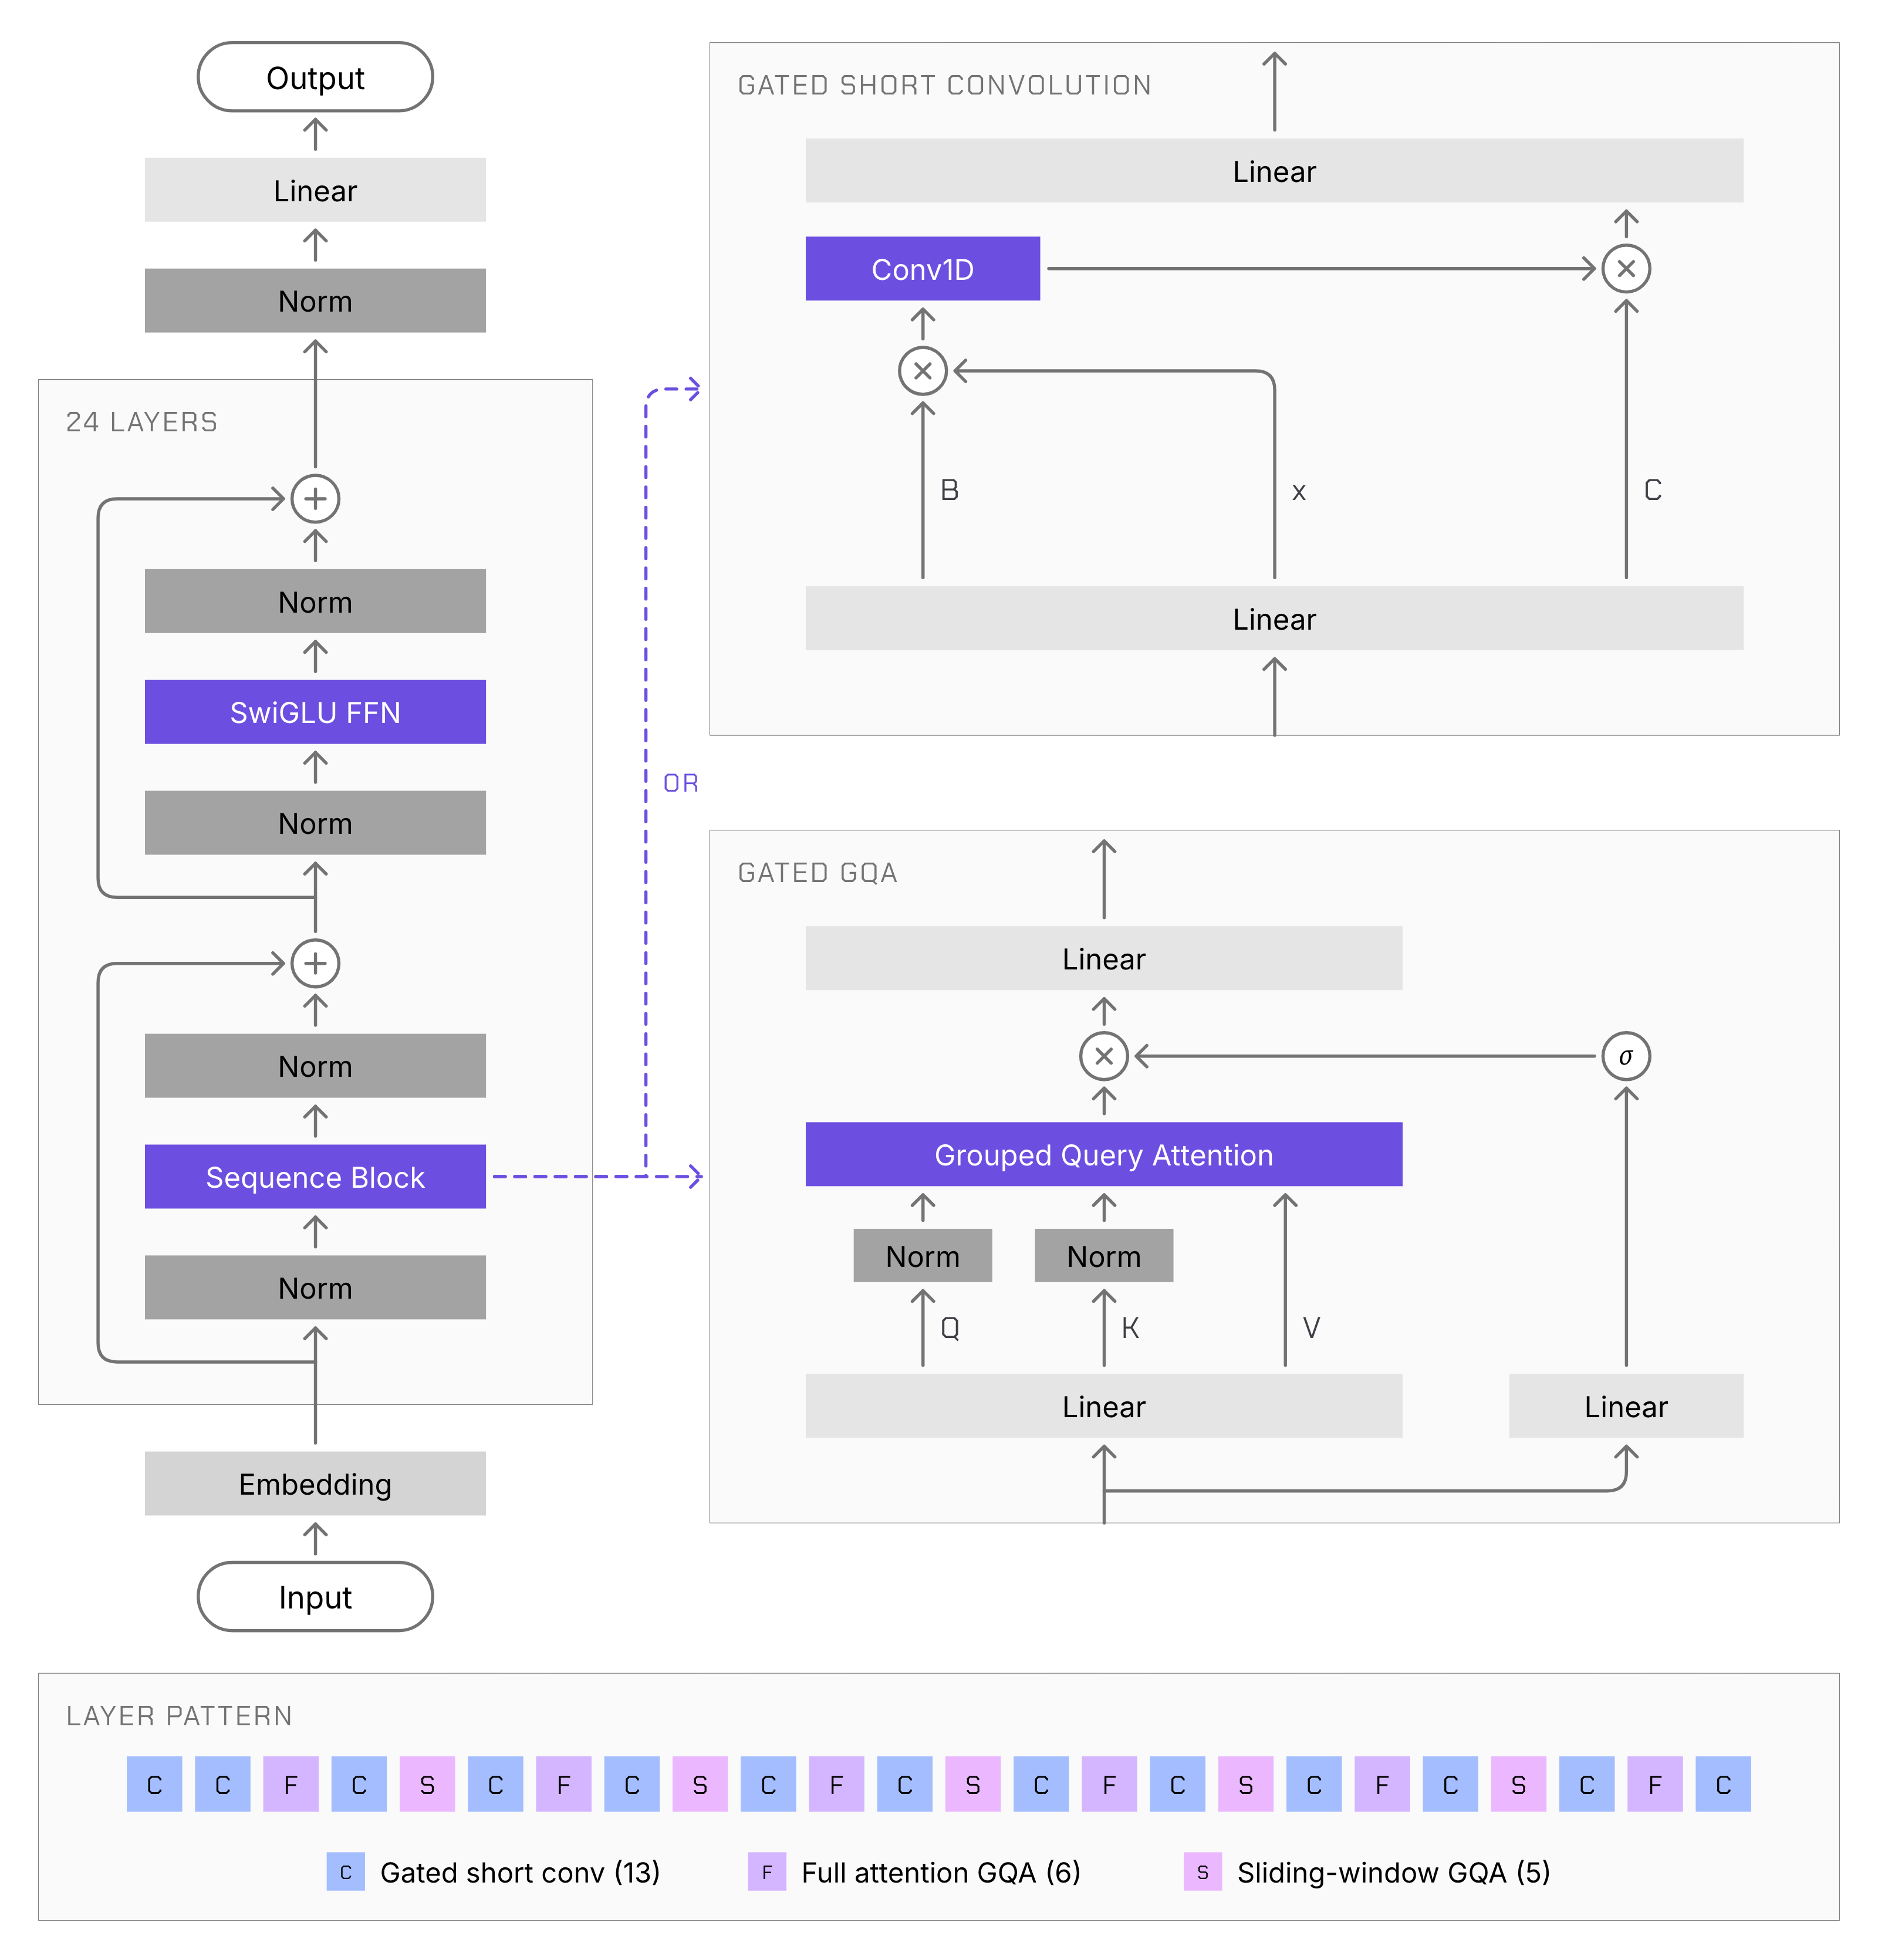
LFM3-1.7B-Base 包含 24 层,并有四项主要改进:
- 三混合层组合: 包括 13 层门控短卷积、5 层滑动窗口注意力(SWA)(窗口大小为 256 个 token)以及 6 层全局注意力层。卷积核大小从 LFM2 的 3 增大到 7。 逐头门控注意力(Head-wise gated attention):利用 Sigmoid 门控缩放每个注意力头(head)的输出,允许头部在无可贡献内容时自动关闭。这有助于抑制激活值异常值(activation outliers),从而改善量化效果。
- 部分 RoPE:全局注意力层仅对每个头部中频率最高的一半维度应用旋转位置编码,使得另一半维度在匹配时不再依赖距离,只关注内容本身。滑动窗口注意力(SWA)层则保留完整的 RoPE。
- 三明治归一化(Sandwich norm):每个模块分别对输入和输出进行归一化,以确保激活值的尺度保持在合理范围内。
这种架构的优势在长上下文场景下尤为明显。在边缘设备上的短提示词任务中,LFM3-1.7B 以单参数计算效率追平 LFM2-1.2B;当上下文长度达到 8K tokens 时,其推理速度提升约 25%。LFM3-1.7B-Base 使用 22T tokens 进行预训练,并与 LFM2.5-8B-A1B 共享相同的 128K 词表。后续的 3.5T tokens 中训阶段使用精选数据,增加了 Agentic 轨迹和工具调用数据的占比,同时将上下文窗口扩展至 256K tokens。
一个骨干模型,六种变体
所有 LFM3 模型均基于 LFM3-1.7B-Base 分支而来。你无需运行单一的大型通用模型,而是可以根据输入数据挑选合适的模型进行定制化,并在本地设备端运行。

| 模型 | 输入 | 输出 | 基于架构 |
|---|---|---|---|
| LFM3-1.7B | 文本 | 文本 | LFM3-1.7B-Base |
| LFM3-VL-2B | 文本、图像、视频 | 文本 | LFM3 骨干 + 视觉编码器 |
| LFM3-Audio-2B | 文本、音频 | 文本、语音 | LFM3 骨干 + 音频编码器、音频解码器及 LiquidCodec |
| LFM3-Omni-2B | 文本、图像、视频、音频 | 文本、语音 | LFM3 骨干 + 视觉与音频编码器及音频解码器 |
| d1-2B | 文本、图像、视频 | 校准后的答案 | LFM3-VL-2B |
| d1-omni-2B | 文本、图像、视频、音频 | 校准后的回答 | LFM3-Omni-2B |
视觉和音频模型还配备了两个全新的自研编码器:
- 视觉编码器:结合了卷积与注意力机制,计算量仅为上一代 LFM VL 模型中 SigLIP2 编码器的三分之一。这个 164M 参数的编码器在准确率上与 Qwen3.5-2B 的视觉编码器持平,但 FLOPs 少了 2.2 倍(两者都使用同一个 LFM2.5-230M 语言骨干进行测试)。处理视频时,它将每对采样帧嵌入一个时间片,把时间序列长度缩短一半。
- 音频编码器和 LiquidCodec:音频编码器混合使用滑动窗口注意力与短卷积,并且是完全因果的,因此可以在你说话的同时进行 prefill,首 token 延迟最低可达 50 ms。LiquidCodec 是我们新的音频 tokenizer,可将生成的 token 转换为语音,在 Apple M4 Max 上单 CPU 线程即可达到约 87 倍实时的速度,并支持流式解码。
如何使用 LFM3 模型
每个模型都可以在 transformers 中运行。以下代码片段来自模型卡片,其中还列出了各模型支持的其他推理引擎。
LFM3-1.7B
如果你需要本地 Agent、工具调用、结构化输出,或者需要一个领域微调的基础模型,LFM3-1.7B 是理想之选。它经过后训练,可以直接在 Hermes Agent、Pi、OpenClaw 等 Agent 框架中运行。相比上一代 LFM2.5-2.6B,它以少 35% 的参数量实现了更强的性能,在 Agent 任务上提升尤为明显:在 WebArena-Verified 上得分 38.42 对 3.02,在浏览器和商业应用的长任务上甚至超过了 Qwen3.5-9B。更多细节请查看 LFM3-1.7B 模型卡片。
运行 LFM3-1.7B,先安装最新版 transformers:
pip install -U transformers
然后加载并运行模型:
from transformers import pipeline

generator = pipeline(
    "text-generation",
    model="LiquidAI/LFM3-1.7B",
    trust_remote_code=True,
)

messages = [{"role": "user", "content": "What is C. elegans?"}]
output = generator(
    messages,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.1,
    max_new_tokens=2048,
)
print(output[0]["generated_text"][-1]["content"])
如需配置本地 Agent,请参阅Agent Harnesses 指南。
LFM3-VL-2B
若需端侧视觉理解能力,请使用 LFM3-VL-2B。它是首个支持视频输入的 LFM 视觉模型,能在给出答案前先逐步推理,同时识别物体位置并分析其空间关系,为机器人应用奠定了坚实基础。相比 LFM2.5-VL-3B,它参数量更少(1.9B 对 3.1B),却在 62 项视觉基准测试的平均得分上从 57.6 提升至 71.4,性能与体量超其六倍的 Gemma 4 12B 持平。更多细节见LFM3-VL-2B 模型卡。
运行 LFM3-VL-2B 时,请安装含视觉依赖的 transformers>=5.21.0:
pip install "transformers>=5.21.0" torch torchvision pillow
然后加载并运行模型:
import torch
from transformers import AutoModelForImageTextToText, AutoProcessor

model_id = "LiquidAI/LFM3-VL-2B"

model = AutoModelForImageTextToText.from_pretrained(model_id, dtype=torch.bfloat16, device_map="auto", trust_remote_code=True)
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "https://placecats.com/300/200"},
            {"type": "text", "text": "Describe this image."},
        ],
    }
]

inputs = processor.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    output_ids = model.generate(
        **inputs,
        do_sample=True,
        temperature=0.1,
        top_k=50,
        repetition_penalty=1.1,
        max_new_tokens=16384,  # generate() needs an explicit limit; reasoning can be long
    )

generated_ids = output_ids[:, inputs["input_ids"].shape[1] :]
print(processor.batch_decode(generated_ids, skip_special_tokens=True)[0])
工具调用、工具搜索以及基于 llama.cpp 的端侧推理详情,参见 LFM3-VL-2B 模型卡片。
LFM3-Audio-2B
需要在笔记本电脑或边缘设备上实现语音聊天、语音识别、语音合成或 18 种语言翻译时,选 LFM3-Audio-2B。它接受文本或音频输入,输出文本、语音或二者兼有,还能把口语指令转成工具调用。相比 LFM2.5-Audio-1.5B,它用了全新自研的音频编码器和语音编解码器,语音合成质量更高(UTMOSv2 得分 3.83 对 3.22),并新增音频理解、通用音频推理和工具调用能力。更多细节见 LFM3-Audio-2B 模型卡片。
运行 LFM3-Audio-2B 需安装 transformers>=5.20.2 及音频相关依赖:
pip install "transformers>=5.20.2" torch accelerate librosa soundfile
从 Hugging Face Hub 直接加载模型和处理器:
import torch
import soundfile as sf

from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "LiquidAI/LFM3-Audio-2B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModelForMultimodalLM.from_pretrained(
    model_id, dtype=dtype, device_map=device, trust_remote_code=True
).eval()
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)
codec = processor.audio_tokenizer.to(device=device).eval()
然后大声问一个问题,就能同时得到文字和语音回复:
conversation = [
    {"role": "system", "content": "Respond with interleaved text and audio."},
    {"role": "user", "content": [{"type": "audio", "audio": "question.wav"}]},
    {"role": "assistant", "content": "<|mixed_start|>"},
]
inputs = processor.apply_chat_template(
    conversation,
    continue_final_message=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(device)
with torch.no_grad():
    outputs = model.generate(
        **inputs,
        max_new_tokens=1024,
        audio_temperature=1.0,
        audio_top_k=128,
        audio_repetition_penalty=1.1,
        audio_repetition_window=4096,
        return_dict_in_generate=True,
    )

    text = processor.decode(
        outputs.sequences[0, inputs["input_ids"].shape[1]:],
        skip_special_tokens=True,
    )
    waveform = codec.decode(
        outputs.audio_codes[:1, :, :outputs.audio_lengths[0]]
    ).audio_values[0]  # 24 kHz
print(text)
sf.write("reply.wav", waveform.float().cpu().numpy(), 24_000)
语音识别、语音合成、音频理解和工具调用等实时能力的示例,请参见 LFM3-Audio-2B 模型卡片。
LFM3-Omni-2B
需要一款能在一台设备上集视觉、听觉与响应于一体的模型来替代独立的 ASR、VLM、LLM 和 TTS 组件时,请使用 LFM3-Omni-2B。它能够就图像回答口头提问,同时“看”视频并“听”音频,还能将其感知到的内容转化为工具调用。这是我们的首个 Omni 模型,支持文本、视觉和音频输入,以及文本和语音输出,并保留了独立 LFM3 模型的核心能力,包括视觉问答、语音识别、语音合成和指令遵循。与 LFM3-Audio-2B 类似,它通过 LiquidCodec 进行语音合成,可将生成的 token 以超实时速度转化为语音,使语音回复在模型生成过程中即可流式输出。在视听视频理解方面,它在 Daily-Omni、WorldSense 和 AV-SpeakerBench 上超过了高达 10.7B 参数的模型,如 Qwen2.5-Omni-7B。更多详情见 LFM3-Omni-2B 模型卡。
要运行 LFM3-Omni-2B,请安装带有视觉和音频依赖项的 transformers>=5.20.2:
pip install "transformers>=5.20.2" torch torchvision torchcodec accelerate pillow librosa soundfile
import torch
import soundfile as sf

from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "LiquidAI/LFM3-Omni-2B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModelForMultimodalLM.from_pretrained(
    model_id, dtype=dtype, device_map=device, trust_remote_code=True
).eval()
processor = AutoProcessor.from_pretrained(model_id, trust_remote_code=True)
codec = processor.audio_tokenizer.to(device=device).eval()
然后通过语音询问关于一张照片的问题:
conversation = [
    {
        "role": "system",
        "content": "Answer questions about the provided image. Base every answer only on what can be seen. Respond with text.",
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "photo.jpg"},
            {"type": "audio", "audio": "question.wav"},
        ],
    },
]
inputs = processor.apply_chat_template(
    conversation,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
).to(device)

with torch.no_grad():
    outputs = model.generate(**inputs, max_new_tokens=1024, generation_mode="text")

print(processor.decode(
    outputs.sequences[0, inputs["input_ids"].shape[1]:outputs.sequence_lengths[0]],
    skip_special_tokens=True,
))
关于语音输出、带原声的视频处理以及工具调用,请参阅 LFM3-Omni-2B 模型卡片。
d1-2B 和 d1-omni-2B
当您需要快速的结构化决策而非文本生成时,请使用 d1 模型。给它一个场景(如支持工单、发票、应用截图、照片或语音笔记)和问题列表,它能在单次前向传播中回答所有问题,并为每个答案提供校准后的概率。除了是非题、选择题和评分外,它现在还能定位对象、从文档中读取数值、以区间估算数字,并选出所有适用的选项。更多细节见 d1-2B 和 d1-omni-2B 的模型卡片。
两款 d1 模型的区别:
- d1-2B:适用于文本、图片和视频。它用较少的参数(比 d1-3B 少三分之一)取代了 d1-3B,并在我们所有的四个决策基准测试中得分更高,例如在 ImajevBench 上得分为 75.5,而 d1-3B 为 64.0。
- d1-omni-2B:当输入包含音频时请选择此模型。如果您使用语音而非文字提问,它能保持几乎全部的准确率。
要运行 d1-2B,请安装 transformers>=5.19 及其视觉依赖项:
pip install "transformers>=5.19" torch torchvision pillow
然后加载 d1-2B,并在单次处理中针对一张支持工单提出多个问题:
import torch
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
dtype = torch.float32 if device == "cpu" else torch.bfloat16
model = AutoModel.from_pretrained("LiquidAI/d1-2B", trust_remote_code=True, dtype=dtype).to(device)

# 在同一个 state 上定义多个命名问题,一次推理全部得到答案
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},  # yes/no: P(yes)
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "shipping": "Delivery and parcels",
                          "technical": "App or site faults"}},
    "topics": {"type": "choice", "multiple": True, "instructions": "Which topics does the message raise?",
               "criteria": {"billing": "Payments and charges", "delivery": "Shipping and parcels",
                            "login": "Signing in to the account"}},
    "urgency": {"type": "score", "instructions": "How urgent is this ticket?", "criteria": ["low", "medium", "high"]},
}
out = model.system_one("I was charged twice and my parcel never arrived. Please refund one charge.", questions)
a = out["answers"]
urgency = a["urgency"]["legend"][str(int(a["urgency"]["score"]))]
print(round(a["refund"]["noul"], 2), a["team"]["choice"], a["topics"]["choices"], urgency)
# 1.0 billing ['billing', 'delivery'] medium
为简洁起见,这里只展示 d1-2B 的示例。音频片段和语音提问可以参考 d1-omni-2B 模型卡。
用 LFM3 微调出适配你任务的专业模型
LFM3 就是为专业化而设计的。前沿模型是强大的通才,但不一定精通你的具体场景。LFM3 把额外容量装进了一个小而快的模型里,只需少量微调,就能让它基于你的数据、术语和工具,成为你任务上可靠的专家。而且模型足够小,微调后可以直接部署在应用运行的地方——从终端设备、私有基础设施到云端都行。
每个模型都支持单张 GPU 微调。下面这些 notebook 以文本、视觉、音频和 omni 模型为例,带你完整走一遍从数据准备到评估的整个流程。
| 模型 | 方法 | 任务 | Notebook |
|---|---|---|---|
| LFM3-1.7B | SFT | 从杂乱文档中提取结构化 JSON | 在 Colab 中打开 |
| LFM3-1.7B | DPO | 基于检索文档作答,或拒绝回答 | 在 Colab 中打开 |
| LFM3-1.7B | GRPO | 在包含 108 个工具的拨号应用中选择正确工具 | 在 Colab 中打开 |
| LFM3-1.7B | CPT | 从原始文本学习新语言(土耳其语) | 在 Colab 中打开 |
| LFM3-VL-2B | SFT | 将收据照片解析为 JSON | 在 Colab 中打开 |
| LFM3-VL-2B | GRPO | 将公式图像转录为 LaTeX | 在 Colab 中打开 |
| LFM3-Audio-2B | SFT | 将智能家居语音指令映射为函数调用 | 在 Colab 中打开 |
| LFM3-Audio-2B | SFT | 教会模型新的音色 | 在 Colab 中打开 |
| LFM3-Omni-2B | SFT | 将智能家居语音指令映射为函数调用 | 在 Colab 中打开 |
| LFM3-Omni-2B | SFT | 回答关于医学图像的语音提问 | 在 Colab 中打开 |
示例:让 LFM3 学会行动
我们将 LFM3-VL-2B 改造为三个互补的机器人模型,分别负责编排、导航和操作。编排器通过工具调用控制机械臂:它通过指向来定位物体,利用深度工具测量尺寸,调用运动规划器,并在后续的相机图像中检查执行结果。导航器利用最近的 RGB 观察数据跟随路线描述,仅需五个 Token 即可预测空间目标和路径点轨迹。操作 VLA 模型在单次前向传播中,将图像、语言和机器人状态映射为包含八个步骤的连续动作块。该 VLA 模型在 15 种不同本体上联合训练,在 LIBERO 的四个测试套件中平均成功率达 96.2%,在 RoboCasa-GR1 桌面任务中成功率为 45.7%。使用 TensorRT FP16 时,在 Jetson AGX Orin 上生成动作块的时间低于 50 毫秒。这些结果凸显了 LFM3-VL-2B 作为机器人领域紧凑基础模型的潜力,它涵盖了从高层规划到低层控制的广泛范围,并能在嵌入式硬件上实现实时动作生成。
观看这个演示视频,了解 LFM3-VL-2B 如何处理感知、导航和操作任务。

开始使用 LFM3
所有 LFM3 模型均为开放权重,现已在 Hugging Face 上提供:
- 下载:访问 Hugging Face 上的 LFM3 集合,其中包括供您进行后续训练的 LFM3-1.7B-Base。
- 微调:使用我们的微调 Notebook将 LFM3 适配到您的特定任务中。
- 在框架中使用:参考我们的指南,了解如何运行本地代理,如 OpenClaw、Hermes Agent 和 Pi。
我们迫不及待地想看看您能构建出什么。
引用
如果您使用本工作,请引用发布博客:
@article{liquidAI2026LFM3,
  author = {Liquid AI},
  title = {Introducing LFM3: Every Modality for Specialized Intelligence},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm3},
}