Cadence 发布芯片设计专用 AI 模型 Maestro,2026 年 Q4 向部分客户开放早期体验
全球最大的电子设计自动化(EDA)公司之一 Cadence 在财报发布前夕通过新闻稿发布了 Maestro——一套为自家芯片设计 agent 定制的领域专用 AI 模型组合。与通用 AI 模型的初步对比结果显示,Cadence 称其结果质量最高可提升 30%,且完成同样的任务消耗的 token 更少,token 效率最高可达 5 倍。首批模型将于 2026 年第四季度"面向部分早期体验客户开放",客户可以在 Cadence 云、公有云或自控的本地环境中运行,并基于自己的"专有数据、设计和工作流"进行后训练。为了深入了解 Maestro,我们采访了 Cadence 两位高管:战略与新业务高级集团总监 Rob Knoth,以及高级副总裁兼总经理 Paul Cunningham。
这一路线与 Synopsys 自家的专用模型 GPT-Synopsys 明显不同——后者将运行在 OpenAI 托管的基础设施上,且不使用客户数据训练模型。两家 EDA 巨头在不到一个月内先后发布的模型,如今在客户设计数据的去向问题上走上了不同道路。但动机可能是一致的:Cadence 高级副总裁兼总经理 Paul Cunningham 告诉,agent 的成本"已经开始爆发式增长",他还说:"我觉得整个世界都意识到了这一点。"他表示,把 agent 更多的迭代工作"内化到模型权重里",就成了顺理成章的下一步。
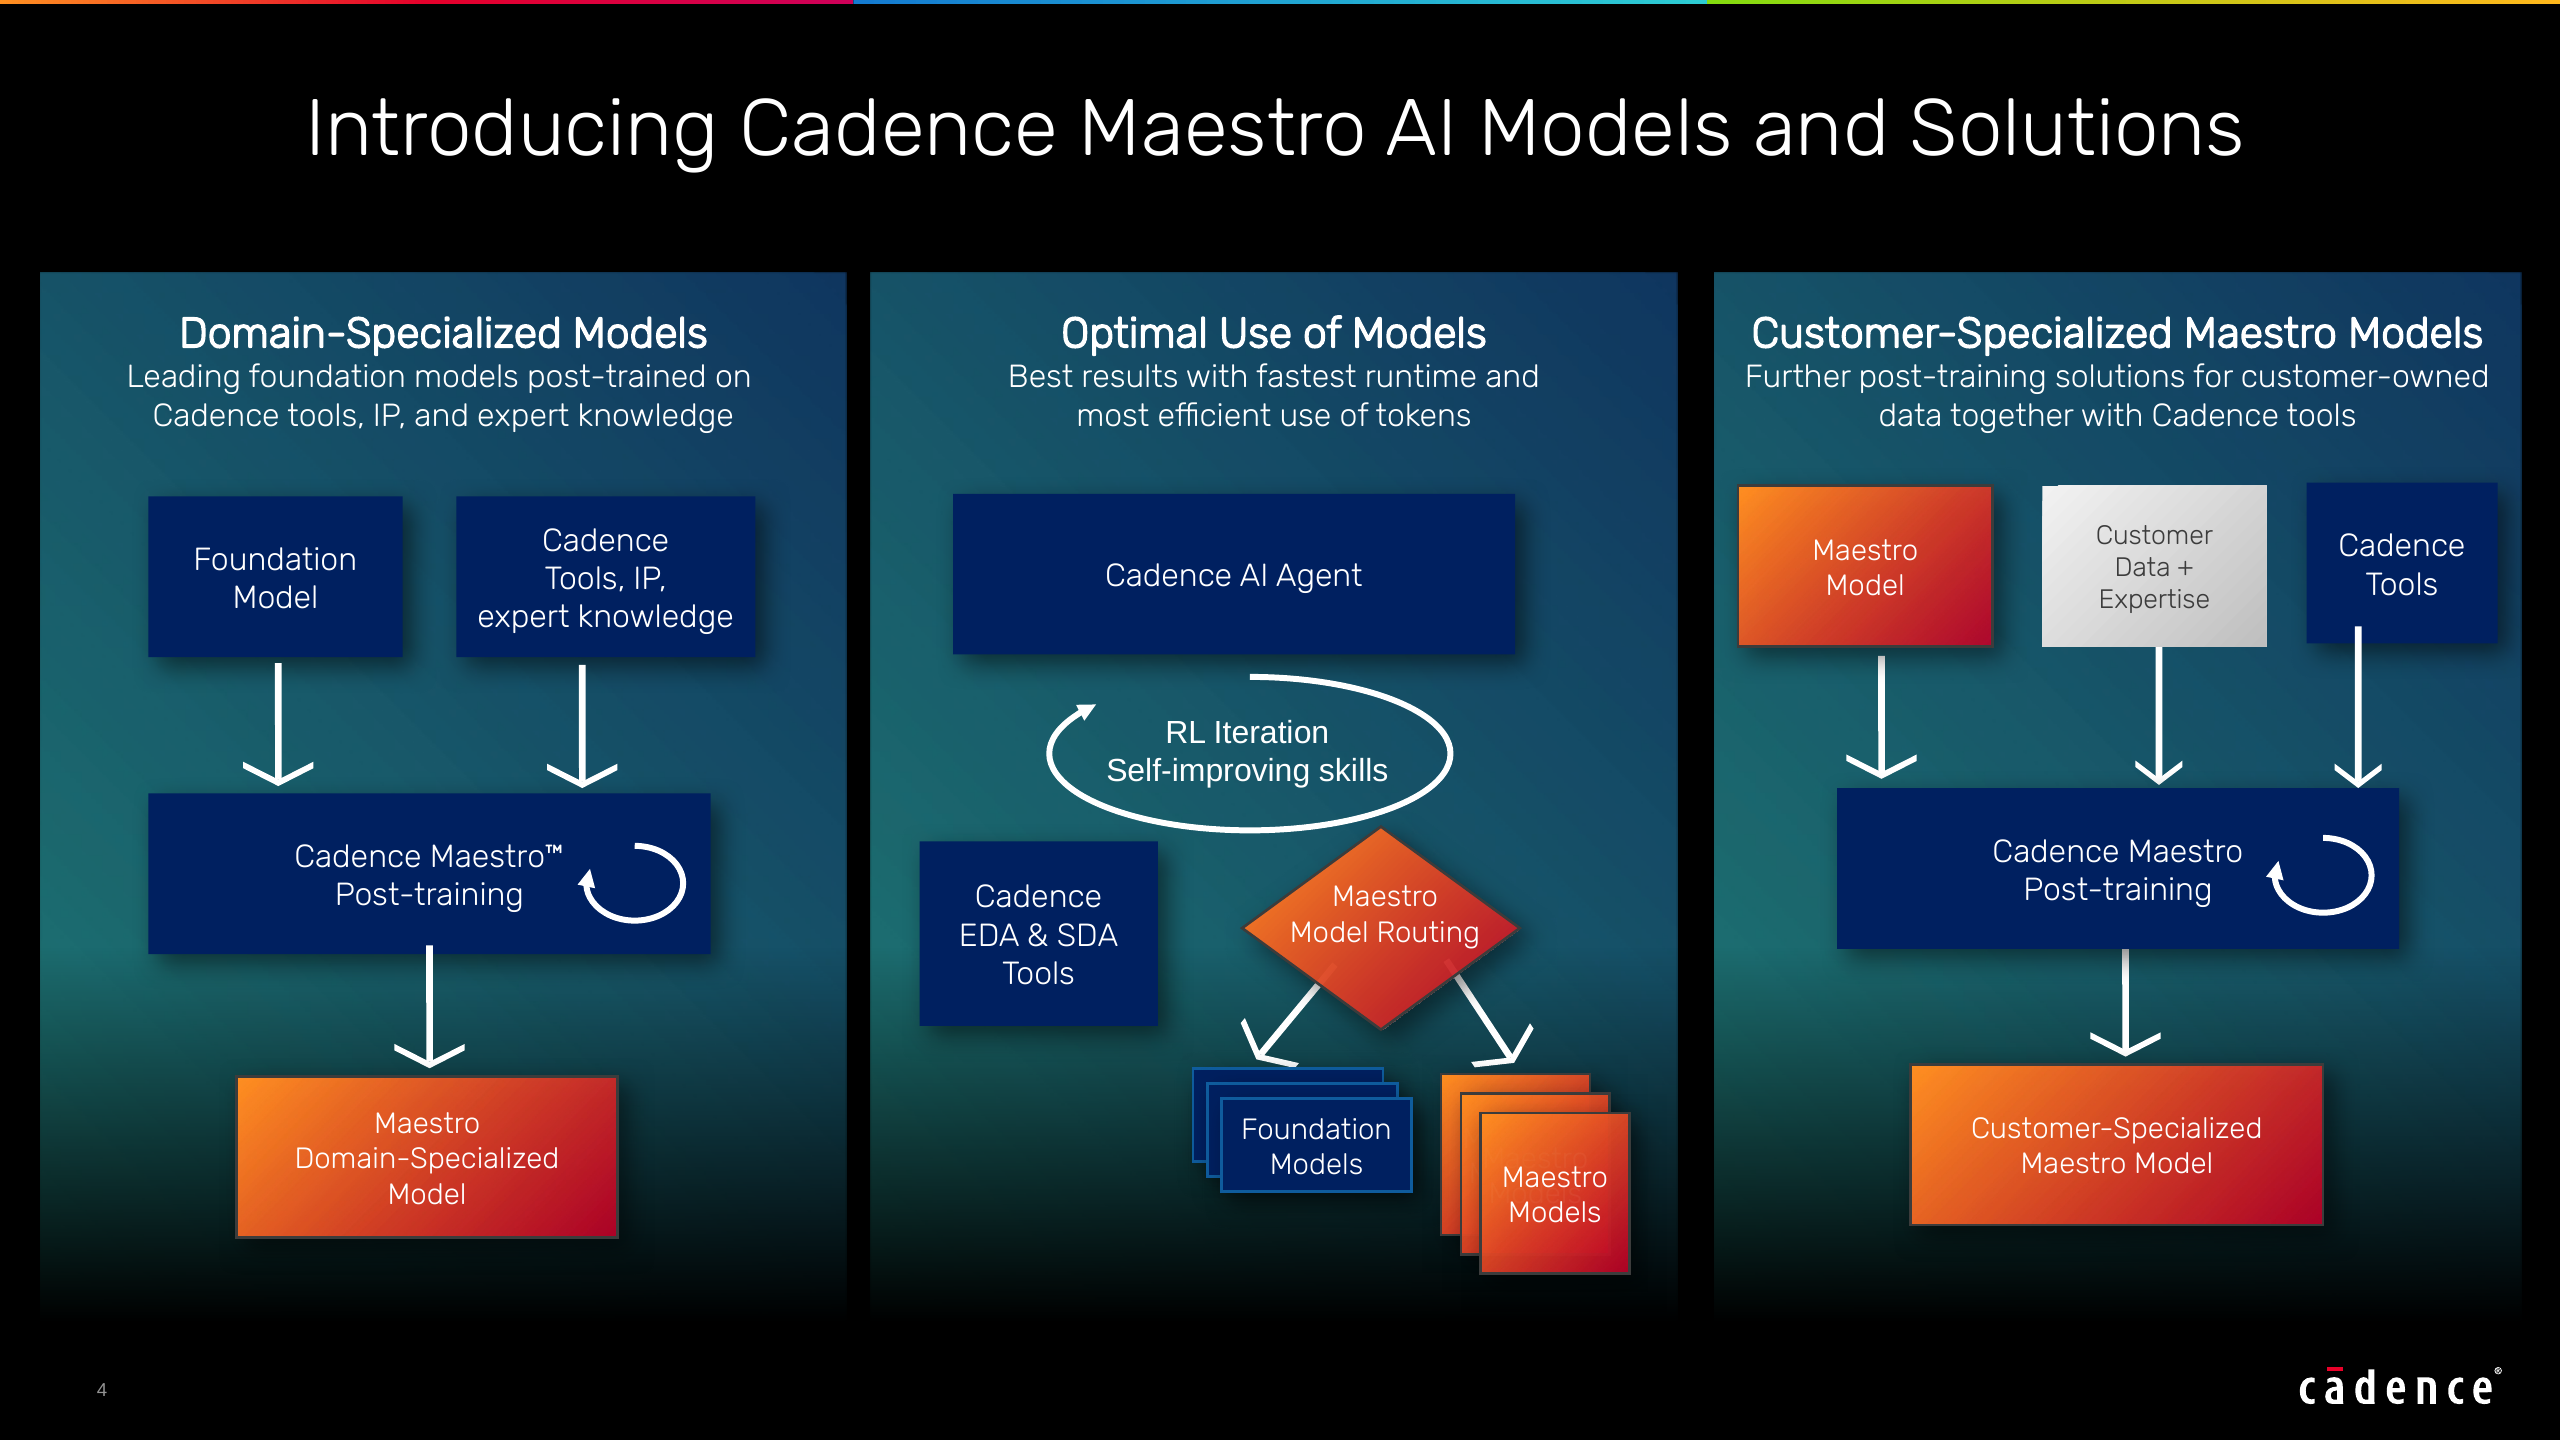
Maestro 通过 Cadence 的 AI 超级智能体 跨出了这一步。这些智能体能够“解读设计意图、拆解任务”,并“协调 Maestro 组合与其他领先的闭源及开放权重模型”,通过评估权衡来结合领域专业知识引导决策。该系统还运用了强化学习(RL),其中 Cadence 的“确定性求解器会根据工程目标、约束条件及真值来评估输出结果”,关键在于,这些结果会反馈回模型以促使其持续改进。
涉及的模型包括 Nvidia 的 Nemotron,客户可以使用 Cadence 的微调框架自行执行基于客户数据的训练步骤,Cunningham 表示,这甚至可以在“客户自己的 GPU、客户自己的网络”上进行。他补充说,Nemotron 的表现“非常扎实,实际上还在以极快的速度进步”。
在代理式 EDA(电子设计自动化)领域,一个反复出现的痛点是必须明确数值指标究竟在衡量什么。在芯片设计中,结果质量通常指设计的功耗、性能和面积(PPA),尽管 Cadence 未说明其 30% 这一数据具体衡量的是哪一项指标。该数据与 5 倍 Token 效率指标均是相对于“通用基础模型”计算的,Cadence 向我们解释,这是指 Maestro 训练前所使用的开源基础模型。该公司拒绝透露 Maestro 所衍生自的具体基础 AI 模型名称,仅称其为“一款极具竞争力的领先开源模型,与商业前沿模型不相上下”。
Cadence 将 Token 节省归功于其 EDA 和 SDA(系统设计自动化)“工具调用与 LLM 调用之间的平衡”。Cunningham 打了个比方:“你不需要为了去 Safeway 超市而驾驶喷气发动机”,你需要做的是“在正确的时间、为正确的任务使用正确的模型”。
运行环境同样重要。Cadence 战略与新业务高级集团总监 Rob Knoth 在九月份曾对媒体表示,一次工具调用可能需要数小时甚至数天才能返回结果,而 AI 行业的训练循环“习惯在几分钟内完成”。Cunningham 指出,效率的提升也可能降低成本,因为使用 Maestro 的次数计入 Cadence 智能体定价的订阅中,该订阅包含一定的消耗额度,超出部分则需额外付费。但他未透露节省 Token 是否直接降低客户账单。
为客户保持灵活性是任何解决方案的关键要素。对于 Cadence 的竞争对手 Synopsys 而言,这种灵活性体现在 Autopilot 中。Synopsys 称,该平台允许客户在“Synopsys 托管和客户托管部署”中,选择使用云端或本地基础设施,并从“商业、开源及微调语言模型”中进行挑选。在智能体安全(如沙箱技术)方面,Cadence 表示正与 Nvidia 合作,集成 Nvidia 上周发布的 OpenShell 参考架构,该架构明确提及了 Cadence 和 Synopsys。这些选项有助于保护客户知识产权。
Swipe to scroll horizontally| 表头列 - 列 0 | Cadence Maestro |
GPT-Synopsys |
||
|---|---|---|---|---|
发布时间 |
2026年10月26日 |
2026年9月30日 |
||
产品定义 |
为 Cadence AI 超级智能体打造的领域专用 AI 模型组合 |
可直接操作 Synopsys 工具的专用模型 |
||
模型合作伙伴 |
Nvidia (Nemotron, OpenShell) |
OpenAI |
||
模型类型 |
后训练 LLM、训练过的决策模型和智能体技能,混合了前沿及开源权重模型(包括 Nemotron) |
OpenAI 前沿模型 |
||
运行位置 |
Cadence 云平台、公有云或客户自管的本地环境 |
OpenAI 托管的基础设施 |
||
客户数据 |
2025年11月 |
ChipStack 收购(智能体验证初创公司) |
— |
已完成;联合创始人 Kartik Hegde 现任 Cadence 核心 AI 研究部门负责人 |
2026 年 2 月 |
ChipStack AI Super Agent |
将设计编码、测试平台、测试计划、回归测试及调试效率提升最高 10 倍 |
自发布以来处于早期访问阶段 |
|
2026 年 4 月 |
ViraStack(定制和模拟)、InnoStack(数字实现)及 AgentStack(头部智能体) |
— |
Socionext 已在生产环境中部署 InnoStack;其他客户未披露 |
|
2026 年 6 月 |
基于 Nvidia Nemotron 和 OpenShell 的 Level 5 ChipStack |
在 Nvidia 的部署中,RTL 验证周期缩短超过 40 倍 |
Level 5 和 AgentStack 预计于 2026 年下半年向早期访问客户提供 |
|
2026 年 7 月 |
AuraStack(PCB 和先进封装) |
上市时间缩短最高 2 倍,生产力提升最高 15 倍 |
可在 Cadence Millennium M2000 超级计算机上运行;Nokia 正在部署(10 月 21 日) |
|
2026 年 9 月 |
ChipStack RTL 生成智能体 |
早期评估显示,相比纯基础模型生成的代码,平均面积减少 24%,功耗降低 18% |
预计 2026 年 Q4 向精选早期访问客户提供;正与 Honda 研发部门开展早期合作 |
|
2026 年 10 月 26 日 |
Maestro AI 模型组合 |
初步结果显示,相比通用基础模型,结果质量提高最高 30%,Token 效率提升最高 5 倍 |
首批模型预计 2026 年 Q4 向精选早期访问客户提供;约有一打项目合作 |
这种快速的进展意味着必须清晰区分早期访问和正式可用。Cadence 和 Synopsys 均可引用客户合作案例,且对于后者而言,AgentEngineer 组合和 Autopilot 平台的目标是在年底前实现正式可用;Cadence 尚未公布 Maestro 的正式可用日期。不过,对于 GPT-Synopsys,据其合作伙伴称,目前仅“早期技术合作正在进行中”。这些平台和智能体仍处于开发进程中。
在Q4之前,Cunningham希望Maestro能积累更多案例研究和可量化的效益。正如他恰切指出的,真正的关键在于:“我们将原生生地将Agent和Agentic AI引入EDA垂直领域,而非让该垂直领域被嵌入通用型Agent中。”尽管只有客户在真实工作流中的实测结果才能验证Cadence所宣称的30%数据,但就两家公司的早期表现而言,这些初步数字对EDA行业来说极具吸引力且前景广阔。