
OpenAI 与 Anthropic 数月内 LLM 价格下调最高 80%,背后的逻辑是什么?
让我们快速回顾一下过去几个月里 OpenAI 和 Anthropic 主要 LLM 模型发布的时间线。文中提到的所有价格单位均为 输入 MTok / 输出 MTok / 缓存读取 MTok。
2026年6月26日#
OpenAI 发布了 GPT-5.6 Sol 和 Luna。Sol 是 GPT 5.5 的直接继任者,定价维持不变,为 $5 / $30 / $0.50;而 Luna 是一款专为低成本场景设计的小型模型,定价为 $1 / $6 / $0.10。此外,他们还宣布了一款介于这两者之间的 Terra 模型,但关注寥寥。
2026年6月30日#
Anthropic 发布了 Claude Sonnet 5。Anthropic 声称该模型的性能接近其 Opus 系列,但外界评价褒贬不一。值得注意的是,其首发价为 $2 / $10 / $0.20,官方最初表示这只是临时定价,未来将会上调。
2026年7月24日#
Anthropic 发布了备受期待的 Claude Opus 5 大版本更新。此前 Opus 4.5 对 智能体编码(Agentic Coding)的兴起产生了深远影响。此次 Opus 5 的定价为 $5 / $25 / $0.50(与 GPT-5.6 Sol 相似)。尽管部分基准测试成绩出人意料地超过了体量更大的 Fable 5,但实际使用反馈依然喜忧参半。
2026年7月30日#
OpenAI 宣布将 GPT-5.6 Luna 的价格下调了 80%(???),降至 $0.20 / $1.20 / $0.02。

大幅降价后 GPT-5.6 Luna 的模型质量与单次任务成本对比。左上角为最佳。如果 OpenAI 不进行 80% 的降价,它本会在性能价格比上输给 DeepSeek V4 Pro。图片来源:OpenAI
2026年8月10日#
Anthropic 宣布,针对 Sonnet 5 推出的临时降价现已转为永久政策。
2026年8月21日#
OpenAI 宣布,未来三个月内,GPT-5.6 Sol 的价格将下调约 20%($4 / $20 / $0.40)。
2026年9月1日#
Anthropic 发布了 Fable 5.1,定价为 $10 / $50 / $0.25。该模型在所有基准测试中的表现均优于6月发布的 Fable 5(当时的定价为 $10 / $50 / $1),同时将缓存读取成本降低了75%。
缓存读取成本
在使用智能体进行编码时,由于缓存中存储了每轮对话的全部历史内容,因此缓存读取费用占总 Token 开销的绝大多数(96% - 99%)。此外,缓存命中率通常能达到 90% - 100%(具体取决于 LLM 推理提供商的基础设施)。综合来看,缓存读取成本降低75%,大致对应整体模型使用成本降低 70-75%。尽管缓存成本通常只是在账单中占比较小的一项,但这一降幅显然值得注意。
2026年9月3日#
OpenAI 发布了 GPT-6 Astra,其规模与 Fable 5.1 相当,定价相似,均为 $10 / $50 / $1,但没有更低的缓存读取成本。Astra 的模型性能确实与 Fable 系列可比。
2026年9月22日#
OpenAI 发布了 GPT-6 Sol,其 $2 / $10 / $0.20 的定价令人震惊,输入和输出价格仅为曾享临时折扣的 GPT-5.6 Sol 的一半。同时发布的 GPT-6 Luna,其输入和输出价格($0.10 / $0.50 / $0.01)也仅为上一代版本的一半。
就在同一天,Anthropic 发布了 Claude Opus 5.5,并明确表示“Opus 5.5 的服务算力需求低于 Opus 5,定价也相应下调”。其价格 $4 / $20 / $0.20 由于输入/输出费用降低 20%、缓存读取降幅更大,整体远低于 Opus 5,总成本降幅达 40-60%——而这个模型甚至比 Fable 5.1 还强(关于 Opus 5.5 我有很多话想说,但那是另一篇文章的事了)。
2026 年 9 月 29 日#
结果 GPT-6 Sol 性能不佳,于是一周后 OpenAI 发布了 GPT-6.1 Sol,性能居然能媲美 Astra(本人实际使用后可以证实),同时 OpenAI 顺手把缓存价格砍半($2 / $10 / $0.10),对齐了 Anthropic 输入价 5% 的缓存读取成本,整个模型系列累计降价 75%。
总体来看,从 6 月 GPT-5.6 模型系列发布到现在,这些热门 LLM 的使用成本一路暴跌,这在一年前是我完全没预料到的。这些降价同样适用于通过 Codex 和 Claude Code 等订阅式 agent 工具调用模型的场景。更重要的是,这些模型在降价的同时,输出质量似乎并没有打任何折扣。

Vercel AI 模型网关的数据印证了 token 单价下降的趋势——已降至 2026 年 4 月成本的 43.3%。但总支出反而在增长,因为模型变强的速度比降价更快!来源:Vercel
从上方的时间线可以看出,Anthropic 和 OpenAI 之间显然存在激烈的相互攻防,可以合理推测,双方近期的降价举措正是针对对方的反应。然而,如果没有外部因素在起作用,没谁会无缘无故把价格砍掉 80%。那么,究竟发生了什么?
LLM 的行为经济学与竞争对手的价格压力#
如果你一直在测试新发布的 LLM 驱动的 Agent,会发现除了主观感受外,很难从客观层面将它们区分开来。自去年 11 月 Agentic LLM 爆发式增长以来,模型已逐渐商品化——只需在 OpenCode 或 Zed Agent 这类工具中切换一个开关,或通过 OpenRouter 更换一个 API 端点字符串,就能轻松将新模型应用到你的代码库中。这导致护城河变得非常薄弱。此外,竞争者数量众多——不仅是 Google 和 Meta 这样的大厂——它们都能提供足够的替代品,从而施加价格压力。
对于开源权重模型,我们再来看看 DeepSeek Flash V4.1,它最近也推出了更新后的 1017 变体。
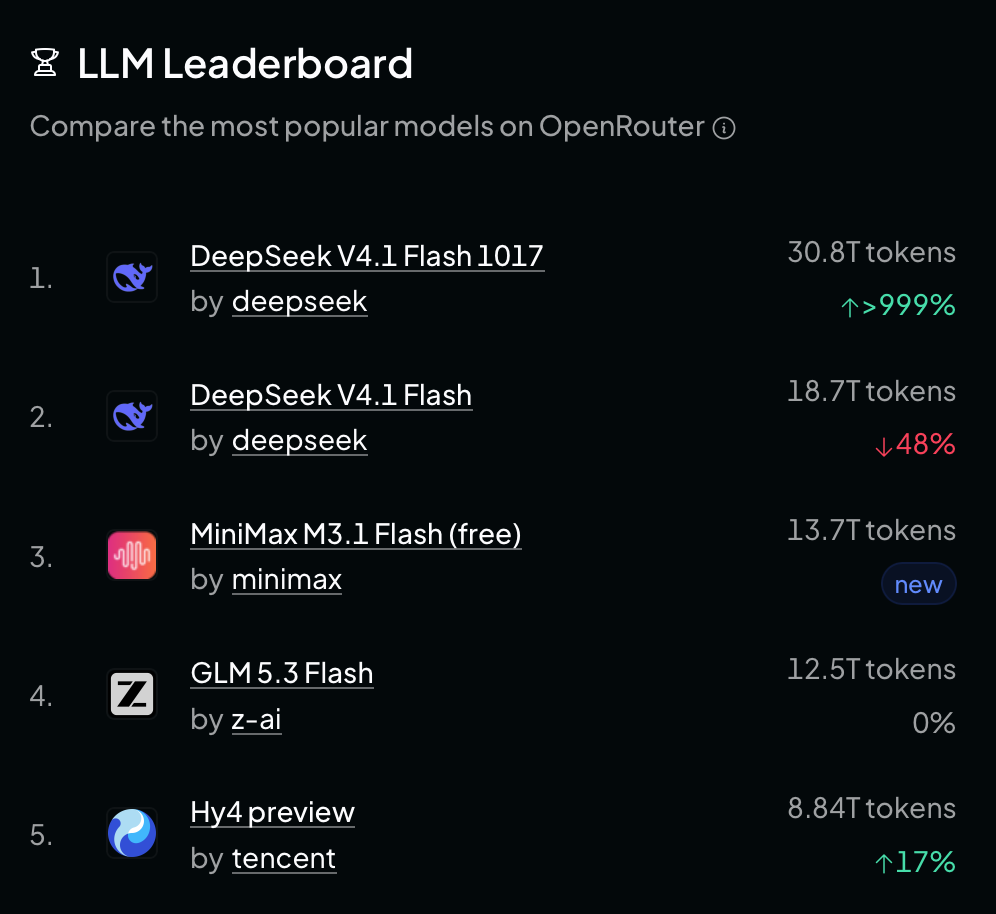
目前,OpenRouter 是获取开源权重模型的首选之地。截图时间为 2026 年 10 月 24 日。
最初于 2026 年 4 月发布的 DeepSeek V4 Flash 0420 模型定价为 $0.14 / $0.28 / $0.0028,并因此迅速爆红,特别是在当时 OpenAI 缺乏用于简单任务的小规模模型之际。其中 $0.0028 成了关键所在,因为 2% 的缓存读取比例远低于上述 OpenAI 和 Anthropic 模型 5% 至 10% 的比例,这使得实际成本比宣传的还要低。我推测 7 月 GPT-5.6 Luna 降价 80% 是为了专门对抗这些小型开源权重模型。如今,新的 DeepSeek Flash V4.1 1017 模型在基准测试中显著优于 DeepSeek Flash V4(45 分对比 24 分的 Artificial Analysis 指数),且来自 DeepSeek 的成本依然类似,维持在 $0.15 / $0.60 / $0.003。请注意“来自 DeepSeek”这几个字的用意。
在 OpenRouter 上,任何推理服务商都可以上架其托管的模型。当用户调用 OpenRouter API 时,请求会被路由到其中一个模型——默认情况下为了负载均衡会路由到任意可用模型,但开发者可以在 API 请求中指定偏好,例如选择“最低价”。早在 5 月,我就指出 OpenRouter 上有 13 家不同的服务商在托管 DeepSeek V4 Flash。对于更新后的 1017 版本,目前已有 29 家不同的服务商。
DeepSeek V4.1 Flash 1017 的提供商按缓存读取成本排序。数据获取于 2026 年 10 月 24 日。
然而,若查看有效输入成本(即考量了缓存读取成本与缓存命中率之间的相互作用),许多不同服务商在成本上非常接近。
各端点的实际成本,其中 Cloudflare 和 DeepInfra 与 DeepSeek 的成本相差不到 10%。需要注意的是,尽管这些模型最便宜,但它们在整个 token 市场中只占少数份额。数据获取于 2026 年 10 月 24 日。
OpenAI 和 Anthropic 只能靠更高质量的模型与这些开源权重模型拉开差距——目前他们做得不错,尤其是 Opus 5.5——但他们必须持续保持这种优势,这正是数十亿美元投入研发的原因。开源权重模型的追赶速度很快:就在几天前,Moonshot AI 发布了 Kimi K3.1 Pro,性能与 Opus 5.5 相当(Kimi 得分 55,Opus 5.5 得分 58),而输入/输出价格只有一半,缓存读取成本相同($2 / $10 / $0.20)。它与 Kimi K3 规模和架构相同,而后者目前已有 20 多家推理服务商托管:因此可以预期,11 月 4 日权重发布后,其中大多数都会以大致相同的价格支持新的 Kimi K3.1 Pro。值得一提的是,Moonshot AI 自己也加入了降价行列,将 Kimi K3.1 Pro 的定价定得比原版 Kimi K3($3 / $15 / $0.30)还低。
在批评 AI 的群体中,一个反复出现的论点是:token 价格被人为压低,目的是把人拉进 LLM 生态,待“免费乘车”结束,价格就会涨回“token 的真实成本”,届时 AI 推手们将遭遇惨败。这种理论认为,OpenAI 和 Anthropic 在玩亏本促销,就像 2010 年代 Uber 和 Lyft 对出行行业做的那样。但不同的是,OpenAI 和 Anthropic 并非拥有定价垄断权力的双寡头,推理行业的入门壁垒也没有那么高。只要众多推理供应商能以相近的价格和质量提供服务,且用户转换成本几乎为零,价格不仅不会涨,反而可能继续下降。因此,这两家公司都在努力构建护城河来抵御这一趋势,例如聚焦于企业级承诺,以及推出 OpenAI Dots 和 Claude Duet 等个人智能体助手。
认为 token 价格会突然上涨,更像是一种缺乏依据的幻想,无论是行为经济学还是 LLM 价格近几个月来针对更优模型显著下跌的实际趋势,都不支持这一观点。只要各家厂商能以低于单 token 收入的成本来定价,推理供应商们就会相互竞争、压低 token 成本,迫使 OpenAI 和 Anthropic 也不得不降价应战。OpenRouter 上的 29 家独立供应商没有任何动力去提供无利可图的模型(它们只会停止服务该模型,转而将算力用于盈利模型),届时,“token 的真实成本”最终可能会回归到价格等于边际成本的水平。
顺带一提,OpenAI 和 Anthropic 目前都处于接近 IPO 的阶段,这也让上述降价行为引发了更多疑问。
IPO 前的股价提振#
这几家公司的降价时机颇为微妙,因为传闻 OpenAI 和 Anthropic 很快就会 IPO——OpenAI 预计在 2027 年,而 Anthropic 可能在几个月内。截至目前,两家公司的泄露财务文件(OpenAI 和 Anthropic)都毫不意外地显示,由于研发和规模化扩张,它们每年正亏损数十亿美元。不过,这些报告并未计入过去几个月里 Agentic LLM 用量的爆发式增长。投资者们会严格审视这些巨额亏损,并要求公司拿出扭亏为盈的具体计划。
那么,为什么要将主要收入来源削减高达 80%?这显然与在 S-1 招股书中展示良好财务状况的做法背道而驰。推理服务本身的利润率或许另有说法,有报道称其单 token 利润率最高可达 80%,当然前提条件也不少。但在经历了如此大幅的价格下调后,它们实际的利润率究竟还剩多少?
就我个人的使用体验而言,降价确实改变了我在 LLM Agent 上的支出方式,但这种改变并非 OpenAI 或 Anthropic 期望其典型用户呈现出的行为。在 GPT-5.6 Sol 是顶级模型时,我订阅的是每月 100 美元的 Codex 套餐(即 5 倍 Pro 计划)。尽管对随机重置用量的做法感到恼火,但我还是将套餐内的额度用尽。而当 GPT-6.1 Sol 发布后,我发现使用它的成本实际上降低了 75%,你猜我做了什么?

在使用同一模型效率提升 4 倍后,我将最大用量配额削减至原来的五分之一,最终算下来收支基本持平,这也是显而易见的选择。
客观地说,像 Claude Code 和 Codex 这类订阅产品的利润率其实很难说,毕竟它们相对于按 API 用量付费来说是超值了。如果出现资金紧张,我猜这些订阅的权益会先被削减,而不是提高模型的基础价格。举个例子,就在发布 GPT-6.1 Sol 的同时,OpenAI 以“反映我们模型日益提升的效率”为由,把每月 200 美元档位 Codex 的用量额度砍掉了 50%——这话技术上没错,但白纸黑字写出来还挺滑稽的。
Anthropic 很快就要上市了,我非常好奇它的招股书里会披露怎样的推理利润率。
我还在想,OpenAI/Anthropic 故意让自己更贵的模型过时,到底是不是好事。Opus 5.5 发布一个月以来,关于 Fable 5.1 或 GPT-6 Astra 的讨论已经完全消失了,因为 Opus 5.5 实在太强。
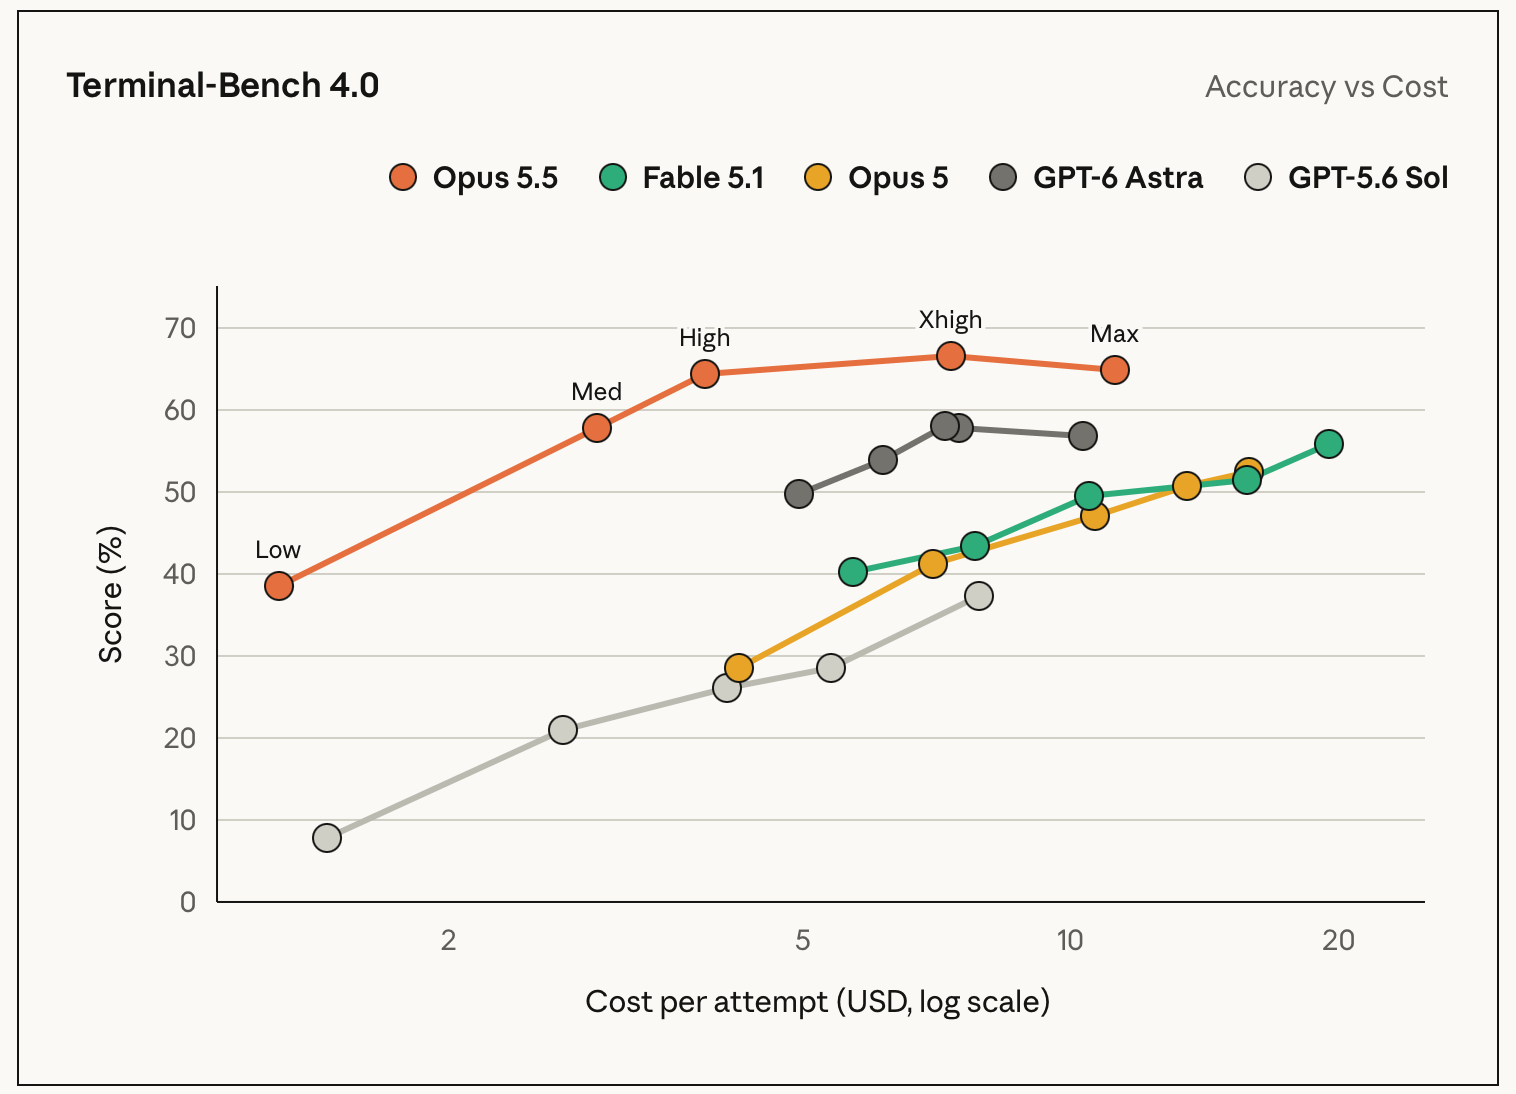
Top-and-left. via Anthropic
我完全预期几周内就会发布 Fable 5.2/GPT-6.1 Astra 打我的脸,到时候我也非常好奇它会怎么定价。
还有一个没那么阴谋论的因素或许能解释这次降价:过去几个月 LLM 基础设施确实在进步——Anthropic 说“Opus 5.5 所需的推理算力比 Opus 5 少,定价也反映了这一点”,我相信这是真话。但如果这些模型算力效率更高,反而降低了对巨型数据中心扩建的需求,进而引发连锁经济崩盘,那才是真正的讽刺。不过这大概率不会发生,因为推理只是整体算力需求的一部分,那些数据中心在流水线的其他环节依然有用武之地。
总的来说,这次降价很奇怪,但作为用户我当然没意见!开源权重模型和第三方推理服务商会持续对 LLM 价格以及大实验室可能搞出的各种商业花招起到经济制衡作用。就算 Anthropic 和 OpenAI 的 IPO 惨败、两家公司倒闭,LLM 和 Agent 作为一门产业也不会就此消亡。