
【AIAgent面试系列】AIAgent基础知识
本文将由浅入深讲解AI Agent的面试知识点。
1、Agent 基础认知
1.1、 你怎么定义 AI Agent?它和"调用一次大模型"的本质区别是什么?
Agent 是一个能自主感知环境、规划、行动、并根据反馈迭代以完成目标的闭环系统,核心是“LLM作为大脑,自主决策并完成多步任务”。
与单次 LLM 调用的本质区别在于三点:
- 闭环(Loop):单次调用是
输入 → 输出的开环;Agent 是观察 → 思考 → 行动 → 观察的闭环,能根据执行结果调整下一步。 - 自主性(Autonomy):由模型自己决定"做什么、做几步、何时停",而非由人写死流程。
- 工具与环境交互(Acting):能对外部世界产生副作用(查库、发请求、写文件),而不只是生成文本。
一句话概括:LLM 是"大脑",Agent = 大脑 + 记忆 + 工具 + 循环控制。
1.2、那 workflow(如 Dify/Coze 的固定编排)算不算 Agent?
严格说 Dify/Coze 的固定编排是 workflow,因为控制流由开发者定义。但他们也支持 Agent 节点,某个节点可交给模型自主决策。
实践中我倾向有边界的自主——主流程用 workflow 保证可控,把需要灵活判断的环节(如工具选择、信息抽取)交给 Agent,并加护栏。
选型标准是:任务路径是否可穷举——可穷举用 workflow,不可穷举才上 Agent。
两者对比如下:
| 对比维度 | Workflow(Dify/Coze 固定编排) | Agent |
|---|---|---|
| 谁决定下一步 | 开发者(写死的 DAG/边) | 模型(运行时动态决定) |
| 步数 | 固定 | 动态,模型自己决定何时停 |
| 分支 | 预设条件分支 | 模型自主判断 |
| 可预测性 | 高 | 低 |
| 灵活性 | 低(没编排的路径走不了) | 高(能应对未预见情况) |
一句话总结:Workflow 是"人定流程、模型填内容";Agent 是"模型定流程、人定边界"。
1.3、 一个 Agent 系统通常由哪些核心模块组成?
Agent 是一个能自主感知环境、规划、行动、并根据反馈迭代以完成目标的闭环系统,包含以下核心模块:
| 模块 | 职责 | 关键技术 |
|---|---|---|
| 感知(Perception) | 接收环境/用户输入 | 多模态输入、结构化解析 |
| 规划(Planning) | 任务分解、步骤排序、反思修正 | CoT、ReAct、Plan-and-Execute、ToT |
| 记忆(Memory) | 短期上下文 + 长期知识 | 上下文窗口、向量库、摘要压缩 |
| 工具(Tools) | 与外部世界交互 | Function Calling、MCP、代码执行 |
| 执行/控制(Executor) | 循环调度、终止判断、错误重试 | 状态机、最大步数、超时 |
1.4、 ReAct 是什么?为什么它成为 Agent 的主流范式?
ReAct = Reasoning + Acting,让模型交替产生"思考(Thought)“和"行动(Action)”,并接收"观察(Observation)",形成:
Thought → Action → Observation → Thought → … → Final Answer
它成为主流的原因:
- 推理与行动耦合:思考指导行动,观察修正思考,比纯 CoT(只推理不行动)更接地气。
- 可解释、可调试:每一步 Thought 都是天然的日志。
- 天然支持工具:Action 就是工具调用,Observation 就是工具返回。
1.5、ReAct的失败模式有哪些?
| 失败模式 | 表现 | 根因 | 对策 |
|---|---|---|---|
| 死循环 | 反复调用同一个工具,或A-B-A来回横跳,直到达到最大步数 | 模型“卡住”-工具没给它最新结果或模型误认为再试一次会成功 | 最大步数限制、重复动作检测(相同工具+相同参数)、超时熔断、状态去重 |
| 工具幻觉 | 调用不存在的工具名、生成错误的参数或参数格式不对 | 工具描述不清晰、工具集过大、模型对schema理解偏差 | 工具描述调优、结构化输出校验(Json Schema强校验)、工具/参数白名单、失败后把错误信息返回让模型自纠 |
| 错误累积 | 某一步调用错误工具获得错误结果,模型基于错误结果进行 | 静默错误——调用"成功"但结果错误,模型无法从返回内容判断对错 | 结构化返回(status 字段)、结果校验(schema / 业务合理性)、外部验证、失败即止损 |
| 上下文爆炸 | 长轨迹下,每步的Thought-Action-Observation全堆进prompt中,上下文快速累积,token成本飙升、延迟变高,且早期信息被“稀释”,模型“忘记”最初目标 | ReAct天然是“轨迹累积”,步数一多必然膨胀 | 上下文压缩、关键信息抽取、必要时重规划而非无限续跑、滑动窗口 |
| 目标漂移 | 执行过程中,模型被中间结果带偏,偏离原始目标,做了一堆无关操作 | 长上下文中模型对初始指令的注意力衰减,或中间信息诱导 | 把原始目标固定在prompt顶部,或每N步重申、阶段性检验”当前动作是否仍服务于目标” |
1.6、ReAct如何缓解死循环?
ReAct是思考-行动-反馈-思考的循环模式,那么这里的死循环就是陷入这个流程无法“自拔”。为了打破这个循环,首先容易想到限制循环次数,限制运行时长,发现循环模式退出(比如重复使用相同参数调用某工具),因此就有以下缓解策略:最大步数限制、超时熔断、重复动作检测和内容去重。
具体对比如下:
| 维度 | 最大步数限制 | 超时熔断 | 重复动作检测 | 状态去重 |
|---|---|---|---|---|
| 控制维度 | 次数 | 时间 | 内容(局部) | 内容(全局) |
| 检测对象 | 步数计数 | 耗时(总/单步) | 相邻几步的动作(工具名+参数) | 完整状态(工具名+参数+返回结果哈希) |
| 能抓住 | 无限步数 | 单步卡死、总时长超限 | 连续重复:A,A,A / A,B,A,B | 任意循环,含长周期 A→B→C→A |
| 能否提前止损 | ❌ 撞上限才停 | ❌ 超时才停 | ✅ 实时拦截 | ✅ 实时拦截 |
| 实现成本 | 极低 | 低 | 极低 | 略高(哈希表+全局查询) |
| 盲区 | 单步卡死管不到;浪费中间 token | 不关心循环内容 | 抓不住隔几步的循环 | 几乎无(最完整) |
| 定位 | 兜底 | 兜底 | 前置快速拦截 | 完整判定 |
四个对策分属两个阵营,职责完全不同:
- 内容维度(聪明止损):重复动作检测 + 状态去重 —— 负责发现循环、提前打断,省的是中间无效的 token 和延迟。
- 兜底维度(笨但可靠):最大步数 + 超时熔断 —— 负责保证无论如何都能退出,保的是系统不挂死。
一句话总结:内容维度负责"聪明地发现循环",兜底维度负责"可靠地保证退出";工程上四者叠加,缺一不可。
1.7、ReAct中如何缓解错误累积?
ReAct的错误累积主要是基于错误的工具结果进行推理。为了应对这里的错误累积,核心思路是把"静默错误"变成"显式错误"——让模型有能力判断"这次调用到底成没成功"。
以下是几种缓解对策:
| 对策 | 措施 | 说明 |
|---|---|---|
| 结构化返回(status字段让错误显示化) | 工具返回结构化结果,带明确的状态字段,而不是裸文本。这样模型能明确读到"这次调用失败了",而不是把一段错误文本当正常结果推理 | 成功示例:{ "status": "success", "data": {...} }失败示例: { "status": "error", "code": "ORDER_NOT_FOUND", "message": "..." } |
| 结果校验(Validation) | 即使工具说"成功",也要做合理性校验。如果校验失败,则视为错误,触发重试或换路径,而不是继续 | Schema 校验:返回结构是否符合预期(字段缺失、类型错误) 业务校验:查订单返回空、金额为负、日期在未来等异常 白名单/枚举校验:关键字段是否在合法范围内 |
| 外部验证 | 不信任模型自述,用外部手段确认;“有返回” ≠ “成功”,关键动作必须外部验证 | 模型说"已发送邮件" → 查发送日志/API 确认 模型说"文件已保存" → 检查文件是否真实存在 模型说"订单已退款" → 查订单状态字段 |
| 失败即止损(Fail Fast) | 检测到异常后立即重试或换路径,而不是带着错误结果继续往下走 | 可重试错误(超时、限流)→ 重试 不可重试错误(参数非法、业务不存在)→ 换路径或转人工 关键步骤低置信度 → 停下来问用户,而不是硬猜 |
2、规划与推理(Planning & Reasoning)
2.1、 CoT、ToT、Plan-and-Execute 有什么区别?分别适合什么场景?
| 方法 | 核心思想 | 结构 | 适用场景 |
|---|---|---|---|
| CoT(思维链) | 一步步推理 | 线性 | 单步推理、数学、逻辑题 |
| ToT(思维树) | 多分支探索 + 评估回溯 | 树 | 需要搜索/试错的难题(谜题、规划) |
| Plan-and-Execute | 先出完整计划,再逐步执行 | 两阶段 | 长任务、步骤明确、可并行 |
| ReAct | 边想边做 | 交错循环 | 需要工具反馈的动态任务 |
关键区别:
- CoT/ToT 是"想"。 ToT 效果好但 token 消耗成倍增长,工程上要慎用。
- ReAct 是"想+做"。
- Plan-and-Execute 是"先想清楚再做"。缺点是 计划一旦出错,后续全错(缺乏动态调整);实践中常加 replan(重规划) 节点。
2.2、 如何让 Agent 具备"反思(Reflection)"能力?
反思 = 让 Agent 审视自己的输出/轨迹并改进。常见实现:
- Self-Refine:生成 → 自我批评 → 修订,循环若干轮。
- Reflexion:把失败经验写成"语言化记忆",下次任务时作为提示注入。
- Critic 模型:用另一个模型/角色专门做评审。
反思要有明确的评价标准(否则模型只会说"看起来不错"),并限制轮数防止无限自我怀疑。
研究表明反思对弱模型提升明显,对强模型可能引入噪声甚至变差。
2.3、 任务分解(Task Decomposition)有哪些策略?
任务分解的本质是 把不可验证的大任务分解为多个可验证的小任务,任务分解策略如下:
- 显式分解:让模型先输出子任务列表(Plan),再逐个执行。
- 隐式分解:ReAct 中通过 Thought 自然拆解。
- 递归分解:子任务仍复杂时继续拆(类似分治)。
- 按角色分解:不同子任务交给不同专长的 Agent。
问题1: 如何确认拆分粒度?
粒度是否合适,就看拆出来的子任务能否独立判断"做没做对":
- 太粗:子任务仍不可验证 -> 模型做完不知道对不对,只能盲猜,错误累积
- 太细:每个子任务可验证,但调度开销大、上下文膨胀
- 恰好:每个子任务有明确的完成判据,做完即可验证,错了立即止损
问题2:怎么判断是 可独立验证?
问三个问题,三个都"是" → 粒度合适;有"否" → 继续拆或调整。
- 有明确产出吗? 子任务是否产生一个可检查的中间结果(文件、数据、状态、答案)?
- 有客观判据吗? 能否不靠模型自述,用外部手段确认对错(查库、跑测试、比对 schema)?
- 失败可定位吗? 如果这步错了,能否明确知道"错在这步",而不是模糊地"整体不对"?
3、多智能体系统(Multi-Agent)
3.1、 什么时候需要多智能体?单 Agent 不够吗?
多智能体适合任务可清晰分工、需要对抗/辩论、上下文隔离等场景。但多智能体不是银弹:通信开销大、易发散、调试难。能用单 Agent + 工具解决就别上多 Agent。
多智能体解决的不是“任务难”,而是“单上下文装不下/会互相污染”的问题。三个真正的“需要”信号:
- 信号 1:上下文冲突(需要隔离)
不同子任务需要的上下文互相干扰时:
例:写代码 Agent 的上下文里塞满“代码规范、API 文档、报错日志”,再让它做“文档写作”,风格和注意力都会被污染。
判据:两个子任务的上下文重叠度低、但各自都很重 → 拆成两个 Agent,各自带专属上下文。 - 信号 2:需要对抗/独立视角(需要制衡)
自己检查自己不可靠——模型对自己的输出有天然偏好(自我偏好偏差):
例:代码生成 + 代码评审,同一个 Agent 自查会漏掉自己的惯性错误;两个独立 Agent(甚至不同模型)评审,检出率显著更高。
判据:任务质量依赖“挑错” → 生成者和评审者必须分离。 - 信号 3:任务天然多角色分工(需要并行/专精)
例:软件工程(PM/Dev/QA)、深度研究(检索员/分析员/撰写员)——每个角色有不同的系统提示、工具集、知识库。
判据:不同子任务需要不同的工具集或专精配置,塞进一个 Agent 会导致工具描述臃肿、选择准确率下降。
反面:这些情况坚决用单 Agent
- 串行依赖的流水线:步骤 A 的输出就是 B 的输入,且 B 不需要独立上下文 → 单 Agent 顺序执行即可,拆开只增加通信成本。
- 工具少于 10 个、上下文装得下:单 Agent 完全够。
- 要求强一致性:多 Agent 天然引入不一致风险(见失败模式 4)。
- 延迟敏感:多 Agent 通信开销大,单 Agent 更快。
3.2、多智能体常见的失败模式
| 失败模式 | 表现 | 根因 | 对策 |
|---|---|---|---|
| 无限对话(Infinite Ping-Pong) | 两个 Agent 互相“客气”地来回——A 说“你觉得呢?”B 说“我同意,你觉得呢?”——永不收敛,直到撞轮数上限 | 没有明确的终止条件,每个 Agent 都把“继续讨论”当默认动作 | 设裁判/Manager 角色(只有它能宣布结束)、明确终止判据(达成共识/产出物就绪)、硬性轮数上限 |
| 责任推诿(Responsibility Diffusion) | 任务失败后,每个 Agent 都“以为别人做了”——A 以为 B 会校验,B 以为 A 已确认,结果没人做,错误漏到最终输出 | 职责边界模糊,没有明确的 owner | 每个子任务指定唯一 owner、交付物有明确验收标准、Orchestrator 负责核对完成情况 |
| 成本爆炸(Cost Explosion) | N 个 Agent 互相通信,消息数随轮数平方级增长;辩论式拓扑尤其严重(每轮所有 Agent 都要读全部历史) | 通信拓扑设计不当 + 无预算控制 | 限制参与者数量、消息摘要传递(不传全文)、设 token 预算熔断 |
| 一致性差(Inconsistency) | 不同 Agent 对同一事实的理解不一致——A 假设接口返回 JSON,B 按 XML 处理;或最终输出风格/结论互相矛盾 | 共享状态缺失,各 Agent 只看自己的上下文 | 共享状态空间(黑板模式)、关键约定写入共享文档、Orchestrator 做最终一致性校验 |
| 级联幻觉(Hallucination Cascade) | 一个 Agent 幻觉了一个“事实”,下游 Agent 把它当真,基于它继续生成——错误在链路中放大,且每个环节都“看起来合理” | Agent 之间天然信任,下游不验证上游输出 | 关键信息溯源(引用原始来源而非转述)、下游对上游输出做校验、设独立的事实核查角色 |
| 角色退化(Role Collapse) | 多轮之后,各 Agent 的输出越来越像——辩论式里“正方”开始附和“反方”,失去对抗价值 | 共享上下文让角色设定被稀释,模型趋同 | 每轮重申角色设定、隔离各自上下文(只传必要信息)、定期注入差异化视角 |
单 Agent 的失败在“步”,多 Agent 的失败在“关系”。多 Agent 的失败本质都是‘缺乏全局协调机制’(终止条件、owner、共享状态、验证链)”。
3.3、 多智能体有哪些典型协作拓扑?
多智能体有以下五种拓扑结构:
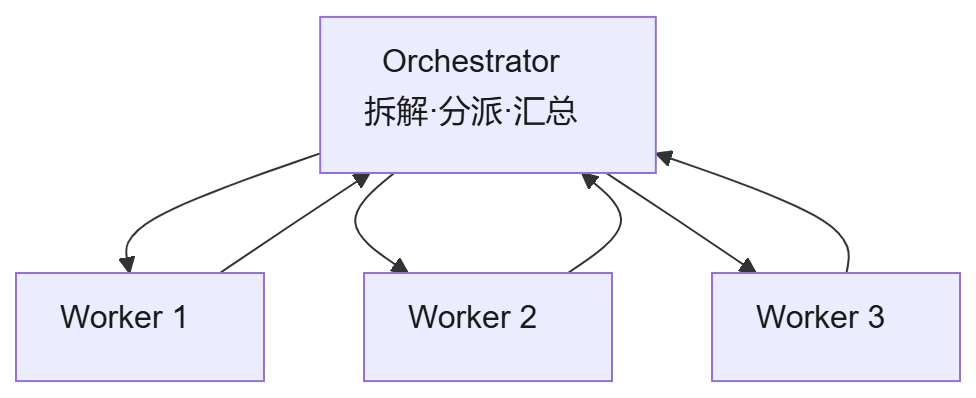
- 层级式(Hierarchical)
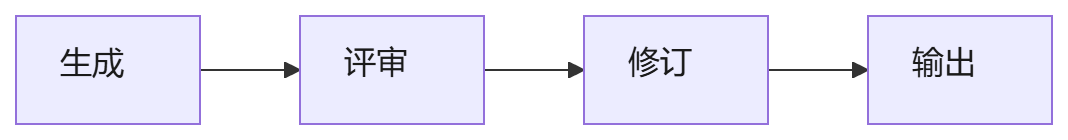
- 流水线式(Pipeline)
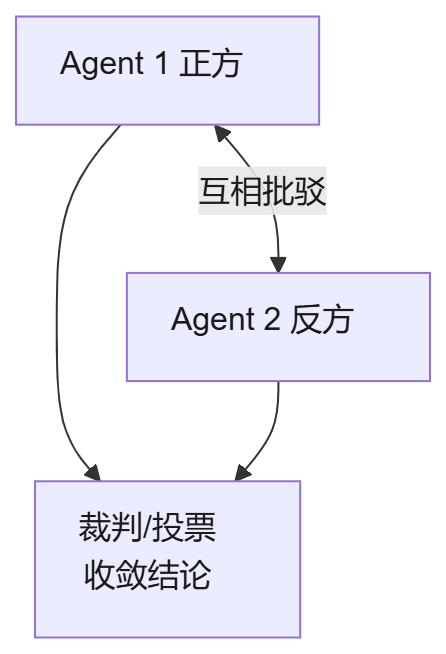
- 辩论式(Debate)
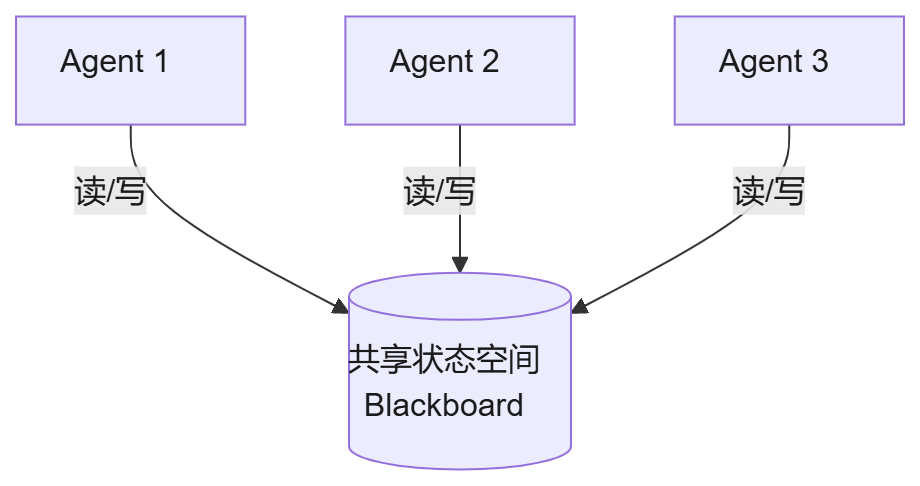
- 黑板式(Blackboard)
- 群聊式(Group Chat)

五种典型拓扑详解如下:
| 模式 | 结构 | 适用 | 优点 | 缺点 | 代表 |
|---|---|---|---|---|---|
| 层级式(Hierarchical / Orchestrator-Worker) | 一个 Orchestrator 负责拆解、分派、汇总;Worker 各干各的,互不通信 | 任务可清晰分解、子任务相互独立(如并行调研多个主题再汇总) | 控制清晰、易调试、责任明确(每个子任务有 owner) | Orchestrator 是单点和瓶颈;Worker 之间无法协作 | AutoGen(GroupChat + manager)、Claude 的 subagent 模式 |
| 流水线式(Pipeline) | A 的输出是 B 的输入,线性传递(如“写→审→改”) | 流程固定、阶段清晰的内容生产/处理任务 | 简单、可预测、每阶段可独立测试 | 串行延迟累加;上游错误会级联(需在阶段间加校验) | 各类“生成→评审→修订”链 |
| 辩论式(Debate) | 多个 Agent 对同一问题各抒己见、互相批驳,由裁判(或投票)收敛结论 | 答案有对错之分、需要提升推理质量的场景(数学、事实核查) | 显著降低幻觉和推理错误(多视角互相纠错) | 成本最高(每轮所有 Agent 读全部历史)、轮数难收敛(对应失败模式“无限对话”) | Multiagent Debate(Du et al., 2023) |
| 黑板式(Blackboard / 共享状态) | 所有 Agent 读写同一个共享状态(文档/内存),谁看到状态需要更新就出手 | 子任务高度耦合、需要频繁共享中间结果(如协作编辑一份文档) | 信息天然一致(对应失败模式“一致性差”的解法) | 并发写冲突、需要状态管理;Agent 间触发逻辑复杂 | 经典 Blackboard 架构(认知科学源头)、MetaGPT 的共享文档 |
| 群聊式(Group Chat) | 所有 Agent 在一个“群”里发言,由 manager 决定下一个发言者 | 需要多角色动态讨论、发言顺序不可预知的场景 | 灵活,模拟真实团队讨论 | 最容易失控(无限对话、角色退化高发),必须配 manager + 轮数限制 | AutoGen GroupChat |
选型对照表:
| 拓扑 | 子任务关系 | 成本 | 可控性 | 典型场景 |
|---|---|---|---|---|
| 层级式 | 独立可分解 | 中 | 高 | 并行调研、任务分派 |
| 流水线 | 串行依赖 低 | 高 | 内容生产流水线 | |
| 辩论式 | 对抗制衡 | 高 | 中 | 事实核查、推理增强 |
| 黑板式 | 高度耦合 | 中 | 中 | 协作编辑、复杂工程 |
| 群聊式 | 动态讨论 | 高 | 最低 | 开放式头脑风暴 |
两个关键认知:
- 拓扑可以混合:实践中常见“层级式为骨架 + 局部辩论”(Orchestrator 分派,其中某个难题交给两个 Worker 辩论后汇报)。
- 拓扑决定失败模式:辩论式高发“无限对话+成本爆炸”,群聊式高发“角色退化”,流水线高发“级联幻觉”——选拓扑时就要预判它的高发失败模式并预置对策。