
加速科学模型Scaling Law,Scinetics发布ScienceRSI科学自我改进框架
作者丨Scinetics 研究团队
编辑丨ScienceAI
一个模型知道得更多,是否就意味着它在每一道科学问题上都更可靠?一个参数量更小的模型,又能不能把自己的专长传给更大的模型?
科学推理中的能力差异,往往藏在具体环节里。模型可能列对公式,却解释错物理机制;也可能算对一个中间步骤,却在最后的证据判断上失误。局部能力的差异,为模型之间的相互学习留下了空间。
近日,Scinetics 与来自复旦大学、中国科学技术大学、香港科技大学的研究者发布技术报告 ScienceRSI,提出围绕专业化、验证、迁移与复用组织科学模型训练,让一个模型学到的有效能力,成为其他模型继续进步的学习信号。
实验覆盖 4B→4B、4B→8B 和 8B→27B。在所比较的方法中,ScienceRSI 的 4B 与 8B 模型均在五项科学评测上取得最高分;27B 扩展实验的七项基准平均分由 87.3% 提升至 94.0%。ScienceRSI-8b 模型权重已在 Hugging Face 发布。
技术报告:https://www.preprints.org/manuscript/202610.2228
开源模型:https://huggingface.co/Scinetics-ai/ScienceRSI-8b
科学能力需要在模型之间积累
训练一个擅长计算的模型、一个擅长机制分析的模型,并不自动意味着我们得到了一位能力更全面的科学助手。各个模型的优势可能互补,也可能把各自的错误一起带入新的模型。
因此,知识迁移需要回答一个更细的问题:面对当前模型的某个具体失误,哪位专家确实能提供更好的判断? 专家能否贡献有用信息,要通过同一套科学要求检验。ScienceRSI 将这一判断放在能力迁移之前。
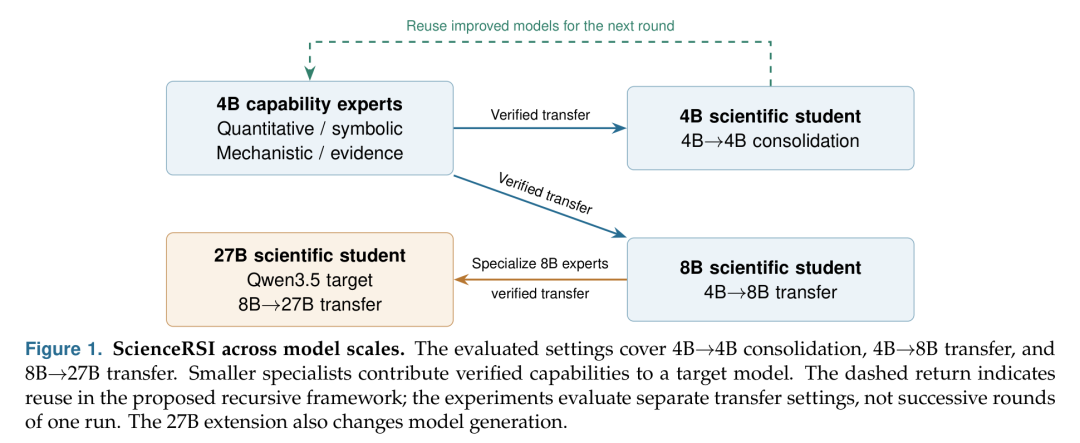
图 1 同规模能力整合、小模型向大模型迁移,以及后续复用方向。
专业化。 先培养具有不同科学专长的紧凑模型,分别侧重定量计算、符号推导、机制解释和证据判断。专业化使模型能够在某些具体能力上形成互补。
验证。 将科学回答拆成可以检查的要求,例如计算是否正确、机制是否成立、结论是否得到证据支持。只有当专家在相应要求上优于当前回答时,它的贡献才获得采用资格。
迁移。 把经过筛选的专家贡献用于目标模型训练,让反馈对应到模型需要改进的部分。目标模型同时利用任务奖励与专家反馈,整合分散的科学能力。
复用。 将改进后的模型作为进一步专业化的起点。这为后续循环提供了组织方式,也提出了一个需要持续检验的问题:新的专家能否继续带来新的学习价值?
4B 与 8B 模型在五项科学评测中领先
报告选用七项基准,覆盖科学推理、领域科学与通用推理。GPQA-Diamond、RaR-Science 和 SciBench 检查科学推理;ChemBench 与 RaR-Med 检查化学和医学领域能力;MMLU-Pro 与 MATH500 用于观察通用能力的变化。
在 4B 与 8B 两组实验中,ScienceRSI 在五项科学基准上的得分均位居所比较方法的首位。这里的 4B、8B、27B,分别表示约 40 亿、80 亿、270 亿参数;箭头从专家模型指向接受迁移的目标模型。
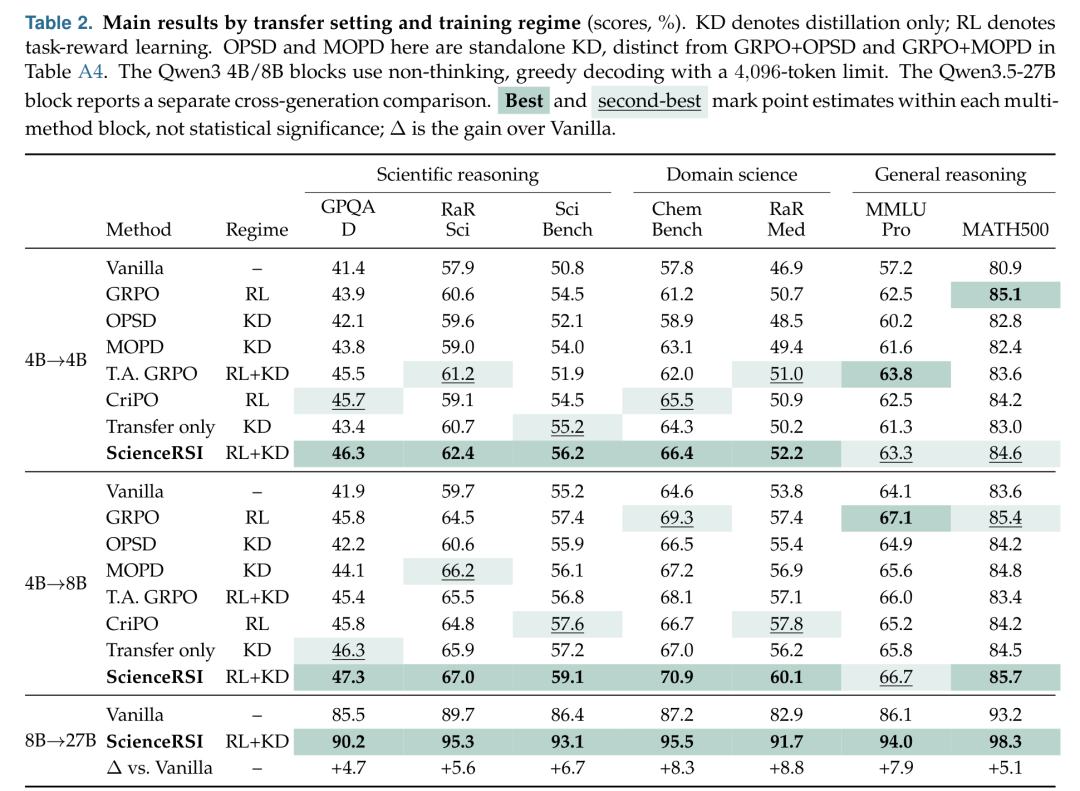
图 2 三组迁移实验的完整主结果。深绿色加粗与浅绿色下划线分别标记最佳和次优得分。
同规模整合有效。 在 4B→4B 设置中,ScienceRSI 的科学推理平均分为 55.0%,比 GRPO 高 2.0 个百分点;领域科学平均分达到 59.3%,提高 3.3 个百分点。多个紧凑专家的专长能够在相同模型规模内整合。
小模型也能帮助更大的模型。 在 4B→8B 设置中,科学推理与领域科学平均分分别提高 1.9 和 2.1 个百分点。专家参数量小于目标模型,经过验证的局部优势仍然能够形成有效的训练反馈。
与此同时,通用推理平均分与 GRPO 保持接近,ScienceRSI 的 8B 模型在 MATH500 上达到 85.7%。这些结果支持在提升科学能力的同时,保留具有竞争力的通用推理表现。
8B 专家向 27B 模型迁移后七项得分均提升
团队进一步使用 Qwen3-8B 专家,向 Qwen3.5-27B 目标模型迁移科学能力。相较于对应的 Vanilla 起始模型,ScienceRSI 在七项基准上均取得更高得分。
七项基准的等权平均分从 87.3% 升至 94.0%,提高 6.7 个百分点。 各项增幅为 4.7 至 8.8 个百分点。
提升覆盖了不同类型的科学任务。ChemBench 从 87.2% 升至 95.5%,提高 8.3 个百分点;RaR-Med 从 82.9% 升至 91.7%,提高 8.8 个百分点。GPQA-Diamond、SciBench 和两项通用推理基准也均有改善。
这组实验同时改变了目标规模与模型代际,因此在报告中作为独立扩展结果呈现。它提供的证据是:较小专家的科学专长,经过筛选和整合,也能帮助一个起点更强的模型进一步提高表现。
专家反馈需要经过筛选才能发挥作用
把多个专家的输出全部交给学生模型学习,听起来很直接。但专家同样可能局部出错。未经区分地学习整段回答,可能同时吸收正确推理与错误判断。
为检验这一点,报告在同一 4B 学生上比较了任务奖励训练、任务奖励加密集专家监督,以及 ScienceRSI。专家监督的两种方案共享专家池,让比较聚焦于如何使用专家贡献。
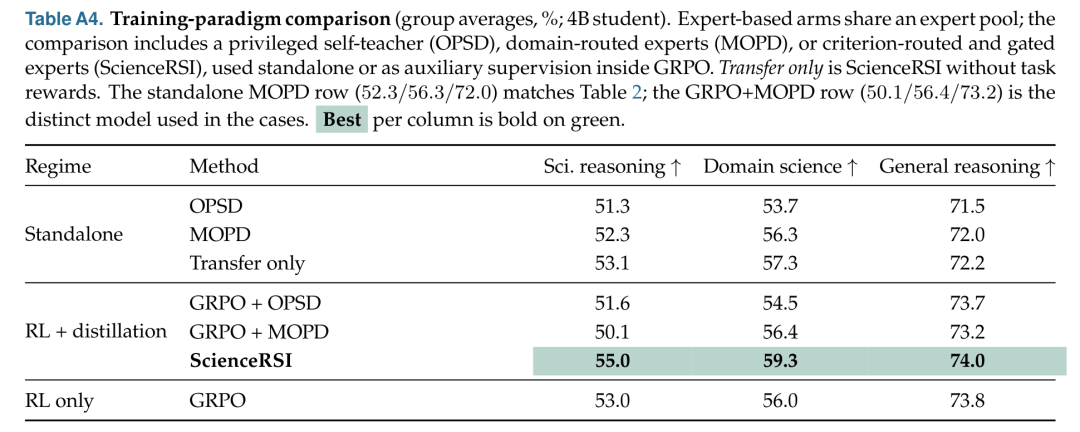
图 3 GRPO+MOPD 与 ScienceRSI 均结合任务奖励和专家监督,表中同时列出纯蒸馏与仅强化学习的对照。
只使用 GRPO 时,科学推理平均分为 53.0%;加入密集专家监督的 GRPO+MOPD 得分为 50.1%;ScienceRSI 达到 55.0%。引入专家本身并不保证提升,反馈的使用方式会改变结果。
进一步的分析支持了这一点。去掉专家贡献的验证环节,科学推理平均分从 55.0% 降至 50.6%。保留相同的监督覆盖量,但把反馈随机移到回答中的其他位置,科学推理与领域科学平均分分别下降 6.3 和 12.1 个百分点。
这意味着,训练信号的价值与它是否对应真实缺口密切相关。ScienceRSI 先检验专家在具体要求上的贡献,再决定采用哪部分反馈,使专业化训练形成的局部优势更有机会保留下来。
对科学模型而言,这种选择尤其关键。一段回答可能只有一个因果关系解释错误,却足以改变最终结论。把反馈落到这个缺口上,才能让模型获得更有针对性的学习机会。
一道遗传题展示互补专长如何协作
在一道保留用于评测的遗传题中,TtGg 与 ttgg 杂交,问题是高茎且黄色的子代占多少。起始模型回答为 0%。机制专家在遗传方格这项要求上提供了通过验证的信息,证据专家则给出了正确的最终比例。
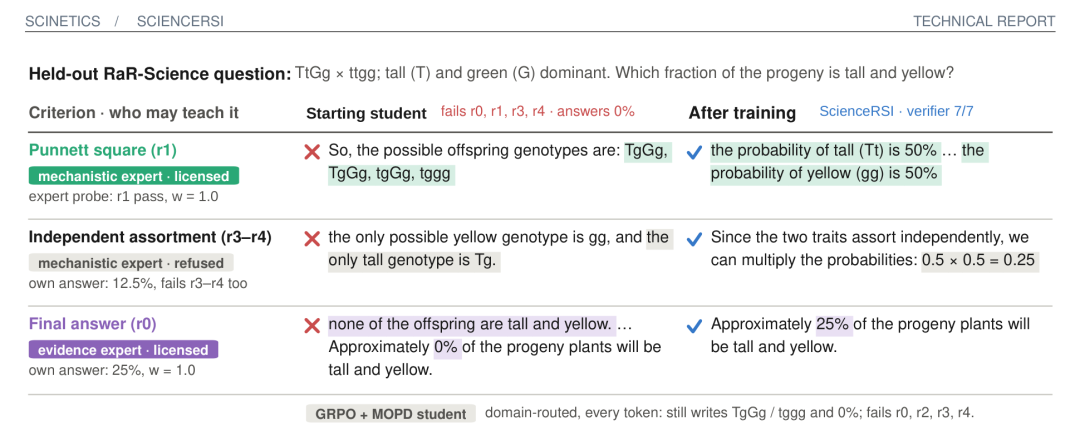
图 4 保留起始学生的错误输出、专家验证结果与训练后回答。后者来自完整训练过程,不归因于单次更新。
完整训练后,ScienceRSI 回答为 25%,验证器判定其通过全部七项要求。这一案例直观展示了框架的出发点:一个专家未必能把整道题答对,但它通过验证的局部贡献仍然可能有用。
递归改进需要持续产生新的学习价值
本次报告验证的是不同规模下的能力迁移环节,多轮循环能否持续积累收益仍需进一步实验。随着目标模型变强,原有专家可能不再提供足够的新信息,专业化训练、任务难度与验证能力也需要同步提升。
沿着这一方向,科学模型的进步有望通过复用不断积累。未来还需要将可靠反馈扩展到分子结构、科学图像、模拟和实验观察,让模型在更丰富的科学任务中识别缺口、吸收有效经验。ScienceRSI 为这条路径提供了一个已经开展实验验证的起点。