
研究发现:昂贵编码Agent框架并未提升性能,仅增加成本
厂商往往宣称使用 Claude Code 或 OpenCode 等新型 Agent 框架能显著提升性能。但最新研究证明这一说法站不住脚。更换框架带来的性能波动,还不如同一配置跑两次产生的随机误差大,但成本却可能翻三倍。
编码 Agent 由语言模型与框架(Harness)组成,后者包含系统提示词、工具和上下文管理机制,使模型能在代码库中正常工作。新型框架层出不穷,且各类排行榜往往混杂比较,但山东大学的两位研究人员通过固定模型变量,量化了框架本身的实际影响。论文标题已泄露答案:“框架究竟买到了什么?主要是 Token。”
早期对比实际是在测量噪声
以往研究声称不同框架间存在超过 20 分的性能差距,但作者指出,这些数据几乎都来自单次运行结果。在 SWE-bench Verified 上,即便完全相同的配置重复运行,成绩波动也可达 6 分。例如,智谱 AI 宣称其自研框架比 Claude Code 高出 2.4 分,这一优势完全落在上述噪声范围内。此外,框架在基准测试中的接入方式也常有所不同,使得跨框架比较更加不可靠。
Liu 和 Han 使用三种官方发布版本的框架——Claude Code、OpenCode 和 mini-SWE-agent——对五个模型进行了测试。其中,mini-SWE-agent 仅向模型提供 Bash 工具,并省略上下文管理;而 Claude Code 和 OpenCode 则提供专用的文件与搜索工具、较长的系统提示词以及自动历史压缩功能。
测试模型包括 Qwen3.6、Qwen3.8、Deepseek-V4-Flash、GLM-5.3-Flash 和 HY4-Preview。Claude Opus 5 仅作为参照,在 Claude Code 中运行。测试选用了 SWE-bench Verified 中最难的 45 个任务,外加 447 个任务组成的更大集合。其中几组配置运行了两次,用来衡量结果的波动。
所有运行都在离线环境下进行。早期联网测试中,Deepseek 和 Qwen 模型有 71% 的尝试直接从 GitHub 拉取了正确答案,而不是自己解题。Claude 模型几乎从不这样做。研究人员废弃了这些结果,也没有断言哪家厂商在测试数据上训练过,但这一模式足够明显,因此他们在后续所有运行中都切断了网络访问。
更换 harness 对结果的影响不比重复运行小
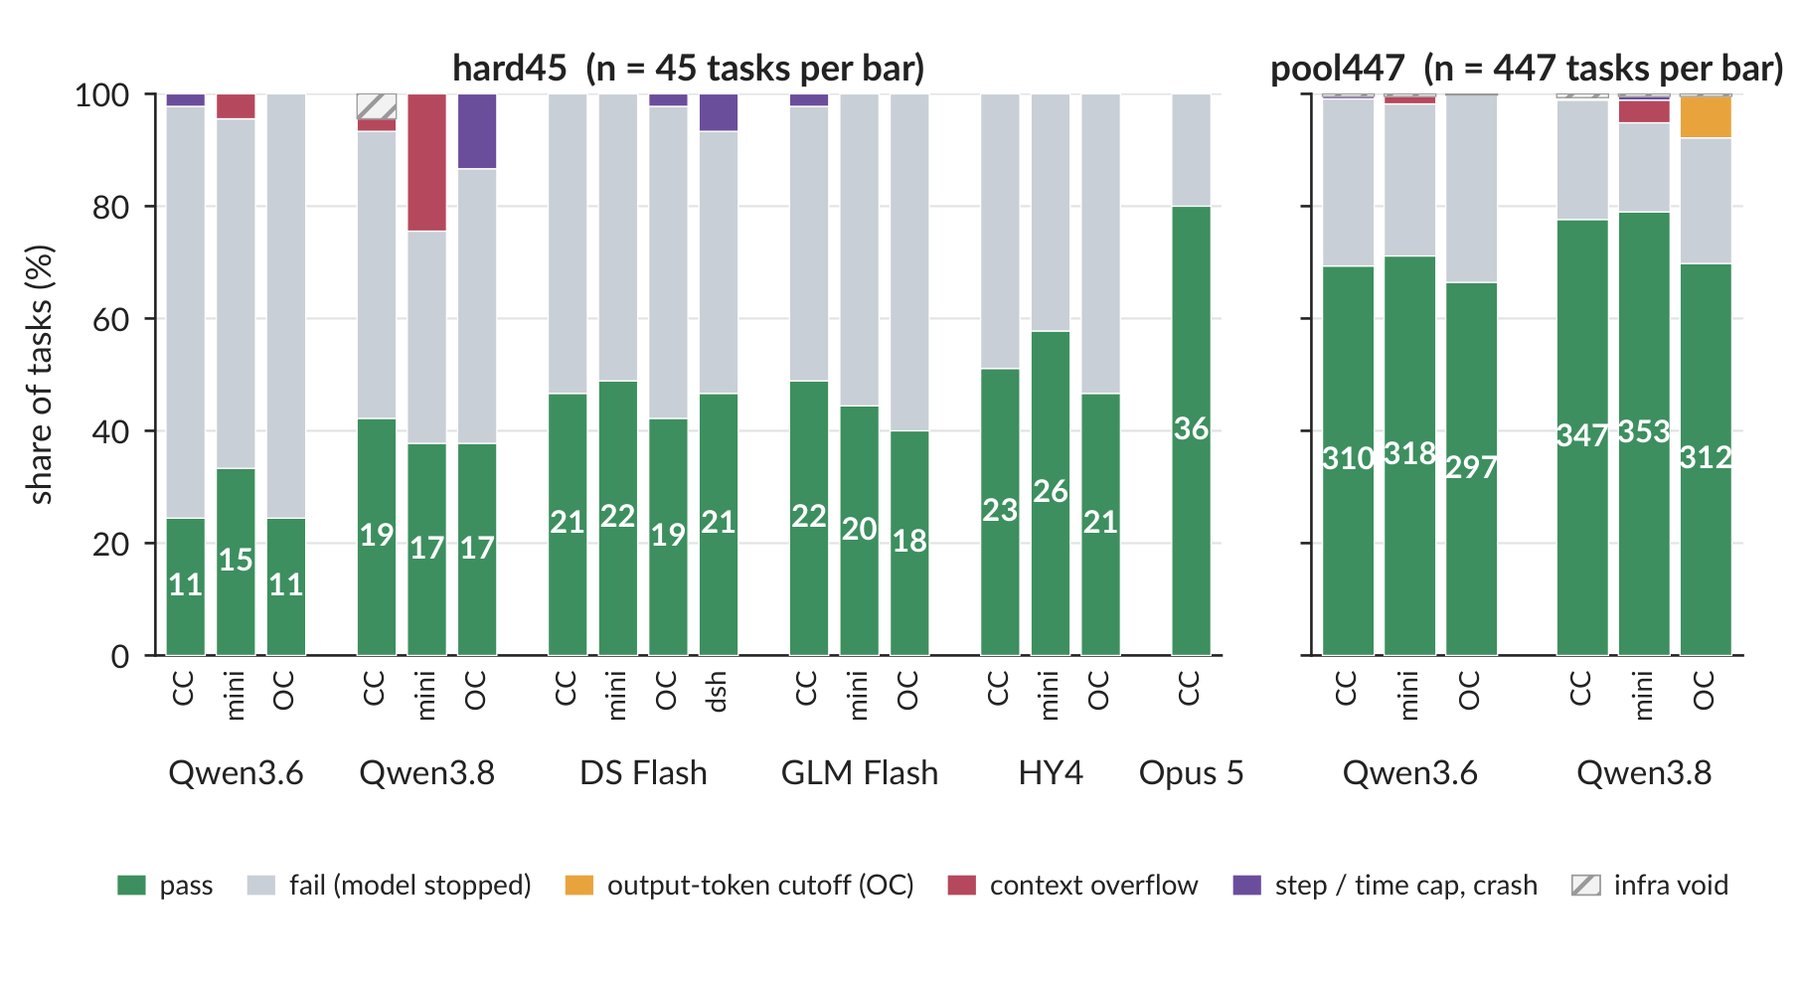
在 447 个任务的更大集合上,最重的 Claude Code 和最轻的 mini-SWE-agent 两个 harness,在两个受测模型上的得分差距不到两个百分点,处在五个百分点区间内,统计上可以视为等价。

研究人员原以为工具架构在 45 道最难的任务上会产生最大影响。然而实际上,不同架构间每个模型的解题数差异仅在两到五道题之间,而简单重跑同一设置导致的数量波动最多也只有三道。有时 mini-SWE-agent 领先,有时则是 Claude Code 领先。
翻转率也讲述了同样的故事。在两次重跑之间,13% 的任务结果发生了改变。而在两种不同架构之间,这一比例同样是 13%。更换模型则会将这一比例推高至 22%。特定架构胜出的任务在每次运行中都不同,结果如同抛硬币。作者写道,架构间的差距表现得像“同一种噪声的新抽签”。
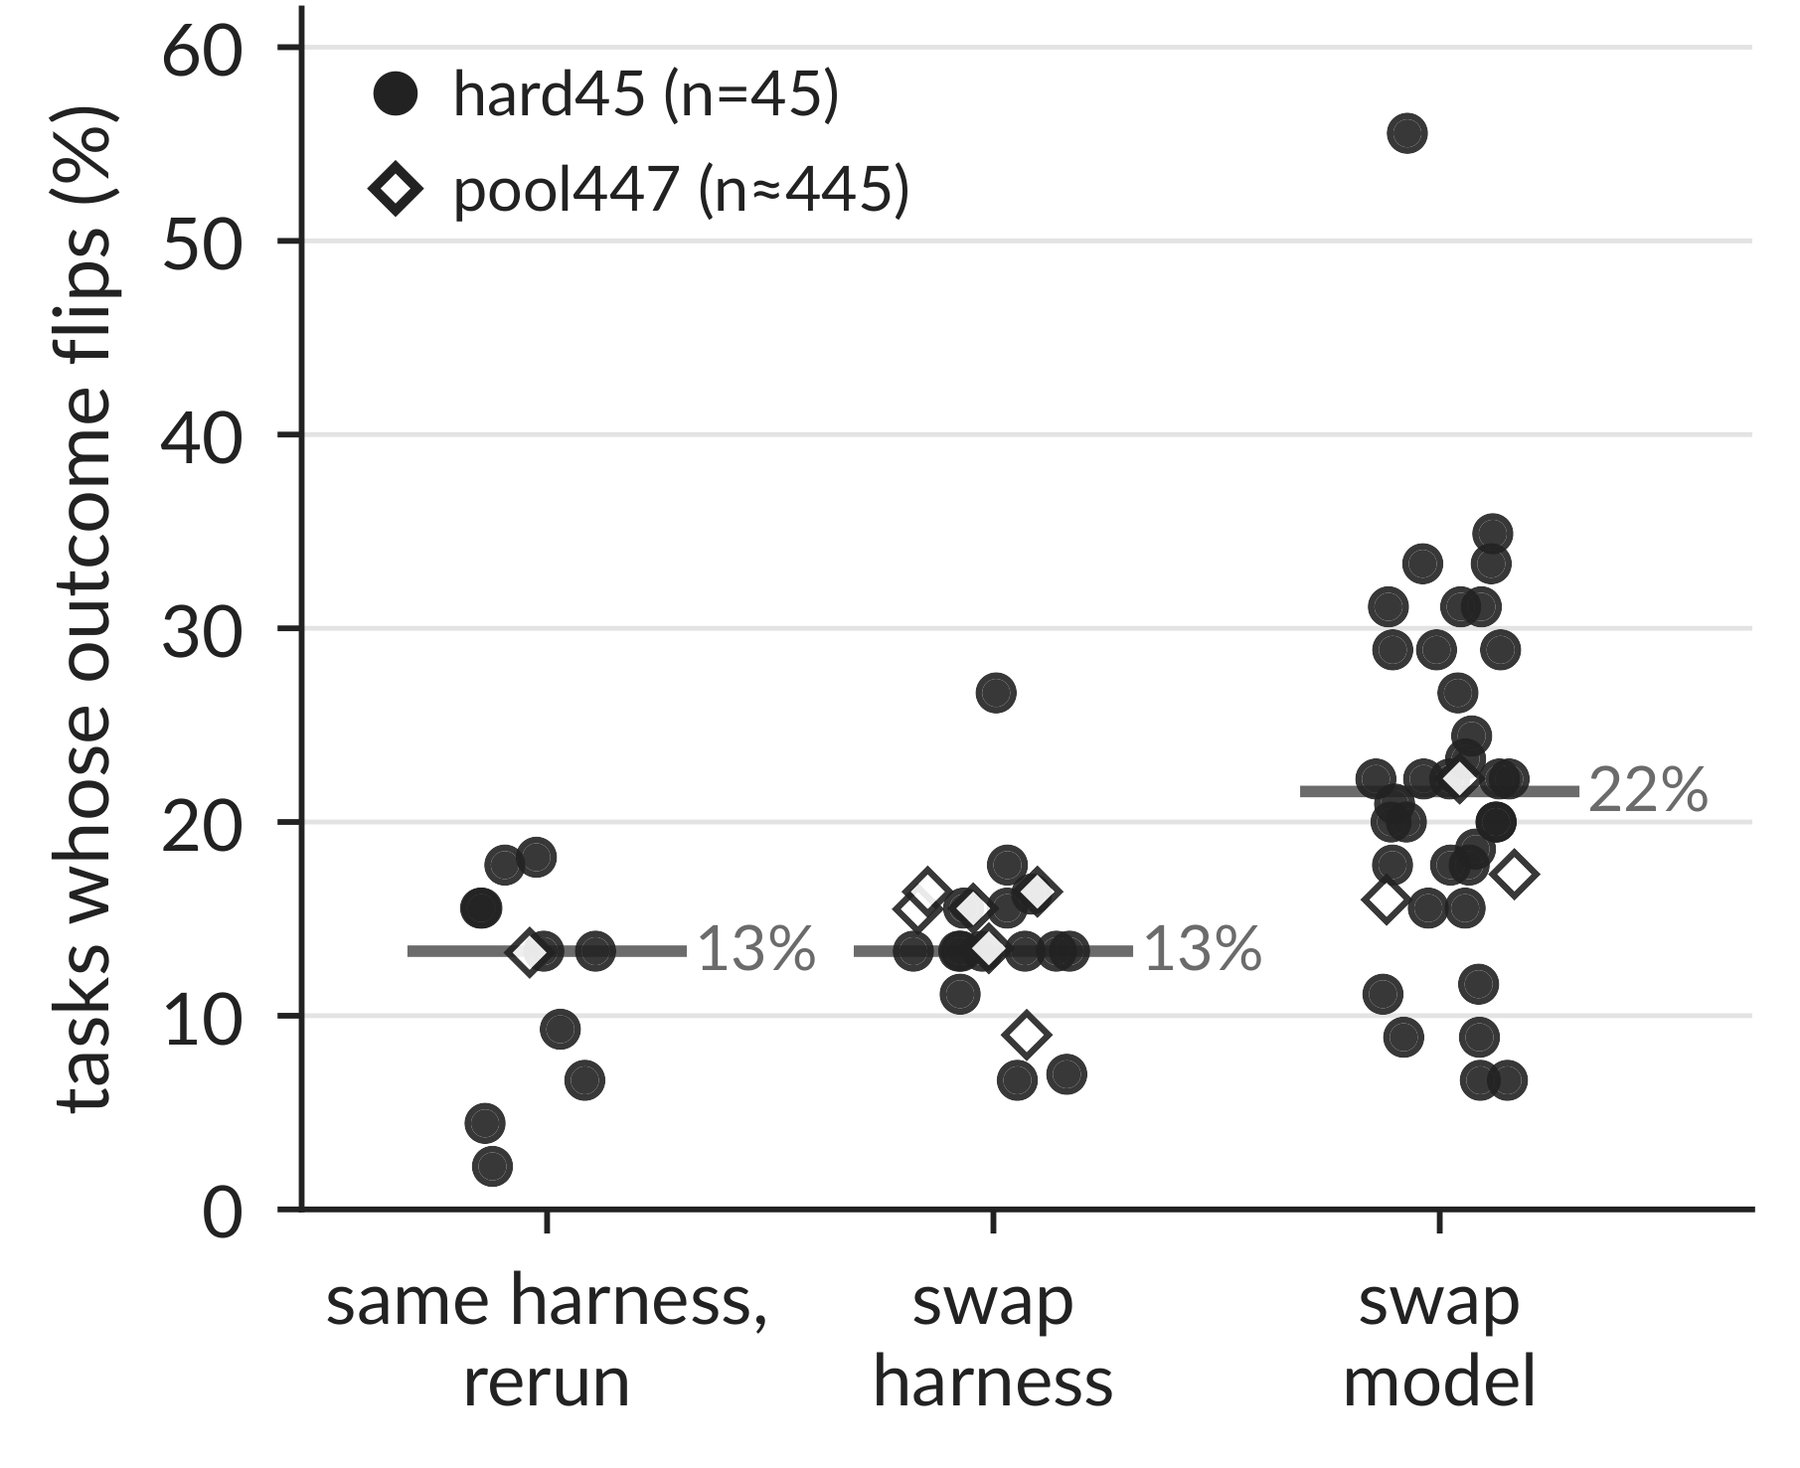
这些较小的样本量也限制了任何比较所能检测出的差异。在 45 道任务的规模下,即便存在 13 个百分点的差距,也只有在约一半的情况下才会显现。若增至 447 道任务,约 5 个百分点的差距即可被可靠检测。智谱声称的 2.4 个百分点优势低于这两个阈值,许多其他宣传的改进亦然。
所有工具表现相同,唯 OpenCode 落后
可测量的 harness 效应仅表现为 OpenCode 的稳定劣势。在大型任务池中,它落后另外两个最多达九个百分点。其中约一半的差距可归因于输出限制。当模型在推理过程中超出限制时,Claude Code 会提示其继续执行;而 OpenCode 则直接终止该步骤,导致尝试通常失败。
在 OpenCode 中加入类似 Claude Code 的继续执行提示并未奏效,因为同一任务在重试时很少再次触发相同的溢出问题。对于剩余的差距,作者无法解释,仅观察到:在 OpenCode 下,模型会更早停止工作。在本地运行模型时,OpenCode 的时间限制也比 Claude Code 严格得多,作者将此标记为一个未受控变量。
由于缺乏上下文管理,mini-SWE-agent 容易撞上上下文窗口限制,这种情况主要发生在其他 harness 也会失败的任务上。OpenCode 的搜索工具在首次使用时会尝试下载二进制文件,一旦处于离线状态便会报错。
系统提示词和工具描述决定账单
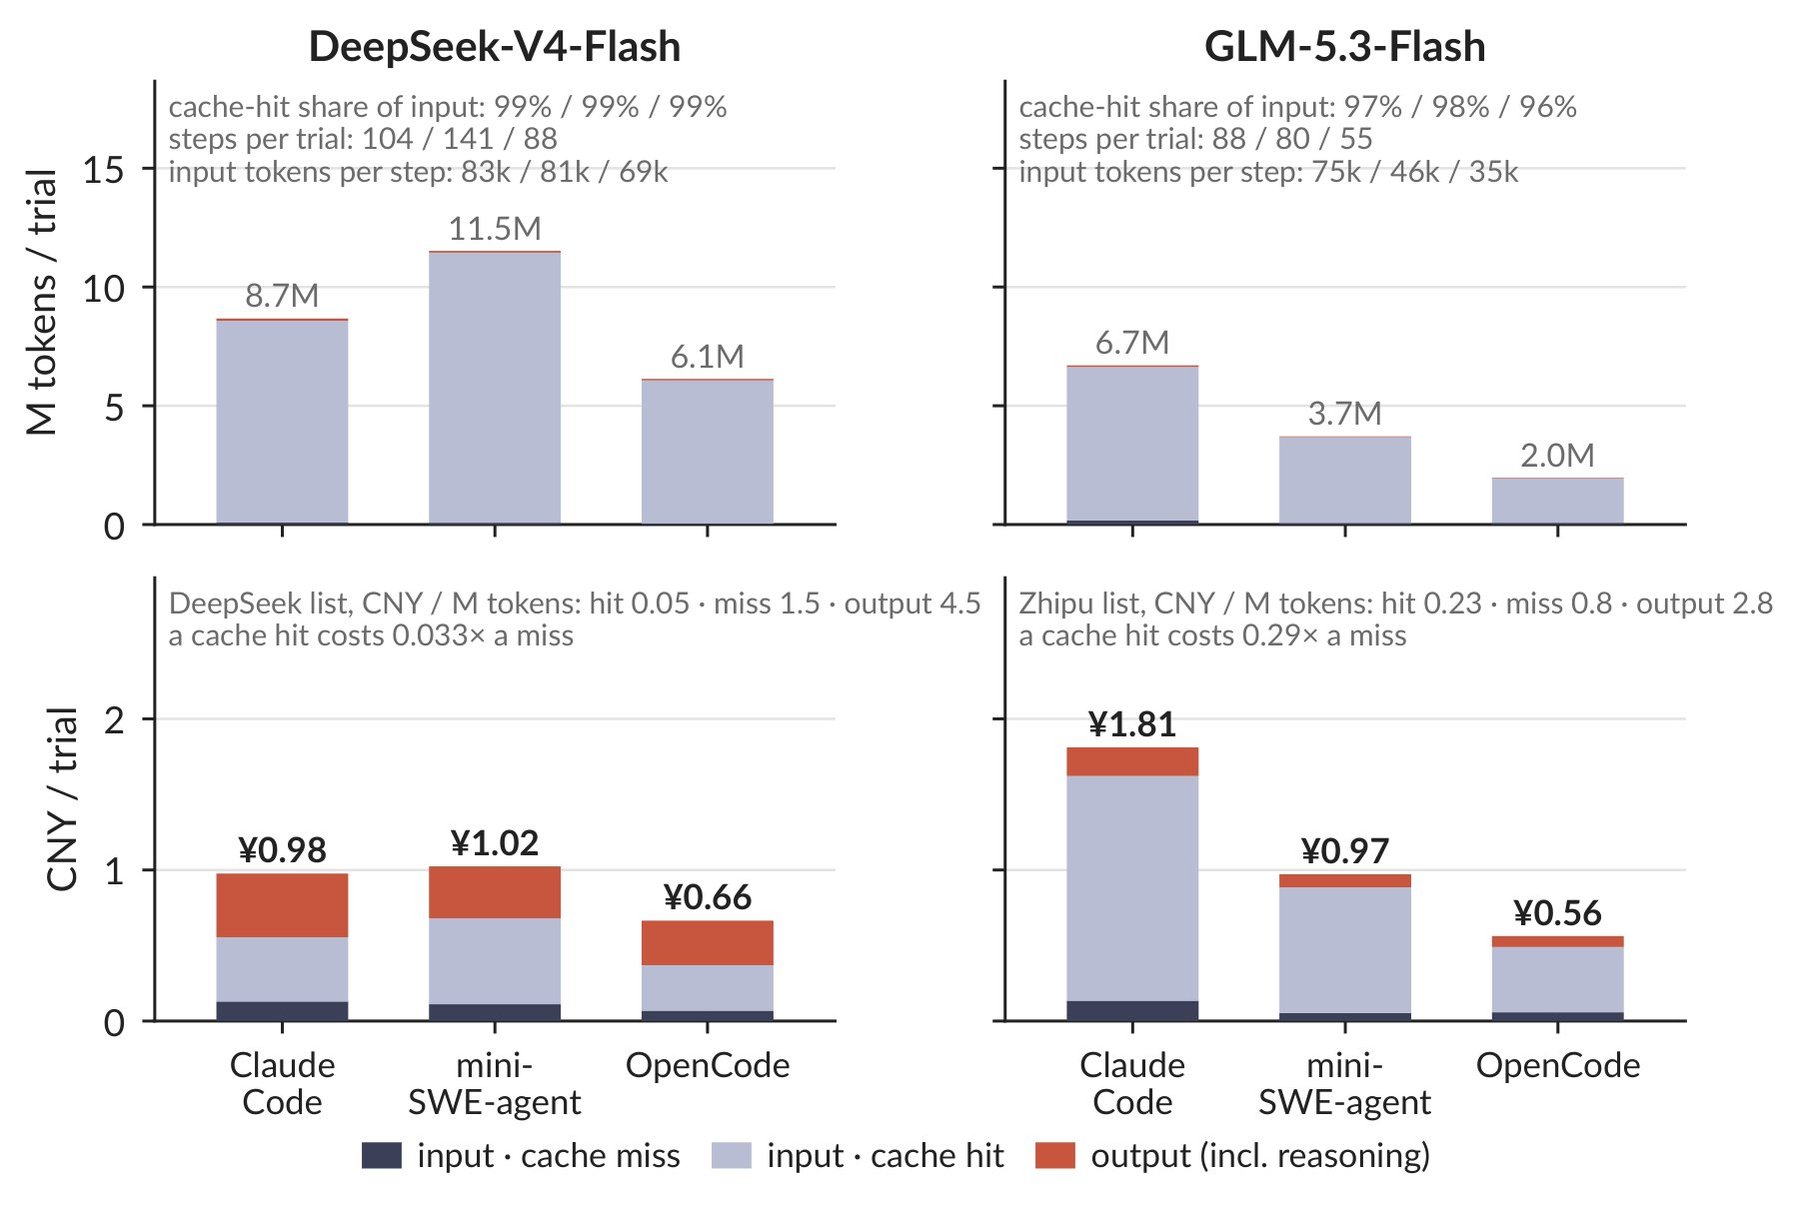
即使使用相同的模型、任务及价目表,单个任务的成本也会因 harness 不同而相差最高三倍。工具输出对这一差距的解释力度很弱,因为三种 harness 每次调用返回的文本量大致相同。
真正的差异来自系统提示词和工具描述。它们会在每一步重新发送,其中 Claude Code 约需 16,600 个 token,OpenCode 约 7,000 个,mini-SWE-agent 则不足 1,000 个。根据研究人员逆向工程的结果,Claude Code 还会将模型的推理输出保留在对话历史中。
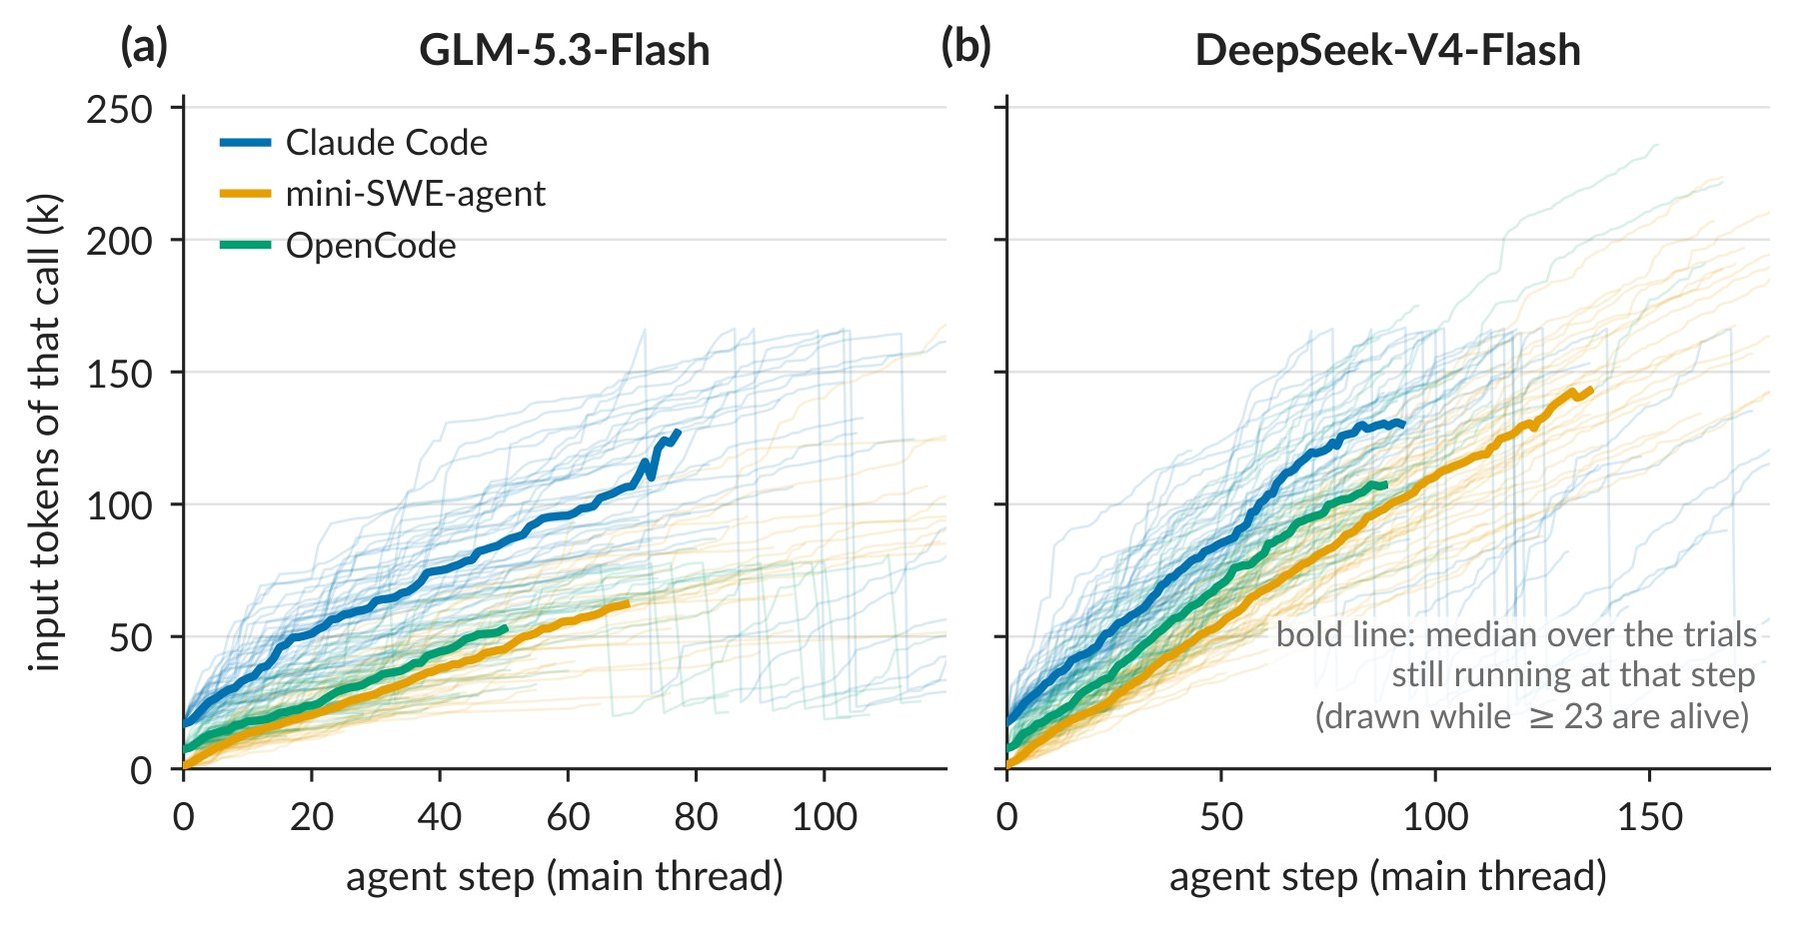
首次调用之后,各 harness 的上下文增长速度都差不多。系统提示词的大小决定了基础成本,步骤数则在此基础上成倍放大。哪个因素影响更大,取决于模型本身:用 GLM-5.3-Flash 时,Claude Code 的成本接近 mini-SWE-agent 的两倍;换成 DeepSeek-V4-Flash,mini-SWE-agent 需要的额外步骤太多,最终两者成本打平。缓存 token 的低价能缩小差距,但改变不了排名。
没有主场优势,思考模式仍有疑问
DeepSeek 自家的 harness 配合自家模型,成绩并不比其他 harness 好,成本却最高。即使研究人员把 Claude Code 中的工具移除,Claude Opus 5 的结果也毫无变化。而一年前的旧版本能用不到一半的成本解出差不多数量的任务,因为那时 Extended Thinking 默认是关闭的。
在这项研究中,引入推理(Thinking)是唯一让框架选择实际影响结果的情况。若不启用推理模式,mini-SWE-agent 搭配 Qwen3.6 的表现下降了 11 分,而 Claude Code 和 OpenCode 的差异则处于噪声范围内。HY4-Preview 在 Claude Code 中不使用推理模式时,也同样损失了 11 分。一个智能体对推理能力的依赖程度,似乎取决于特定的模型与框架组合。作者承认,其测试矩阵规模太小,无法解释背后的原因。 该研究主要依赖单一基准测试。在 Terminal-Bench 2.1 上的小规模交叉验证也显示了相同的规律。闭源的最高分模型 Opus 5 仅在 Claude Code 中运行。作者总结道,使用框架购买的是“减少任务失败的方式”和“更高的账单”,而非更高的通过率。他们建议在每次框架对比中,同时公布相同配置的重跑结果。这是判断测量差异中有多少纯属噪声的唯一途径。相关数据和分析脚本已在 GitHub 上公开:https://github.com/YangzeLiu/what-does-a-harness-buy。 在其他研究中,在框架设计上投入更多精力往往也难有回报。例如,有发现表明,针对 AI 编码智能体的 简单 Markdown 文件,反而优于复杂的技能系统。早前的研究也已证明,对于相同的模型,框架的选择 可能导致成本近乎三倍。因此,框架设计备受关注。Nvidia 最近通过优化智能体调度,将编码智能体的 Token 成本削减了近一半。