
AI大模型是怎么训练出来的?
用 AI 编程工具写代码时你可能注意过:让它写个函数,它不光写出来,还会自己跑测试,看到报错再回去改。它本来只会接下一个词,这一套是从哪儿学来的?下面从训练有哪几种方式说起。
训练大模型有哪几种方式?
训练就是让模型反复做题,每做一次告诉它做得好不好,它照着结果一点点调整自己。不同的训练方式,差别在两件事上:拿什么材料练,由谁来判断对错。常见的有五种。
预训练。材料是海量的文字和代码,题目就是上一篇讲的猜下一个词。对错不用人来判断,拿原文的下一个词一比就知道,所以才用得上那么多材料。
监督微调,也叫指令微调。人先写好一批"提问加理想回答",让模型照着学,学得不像就调整。这时候判断对错,看的是和人写的示范像不像。
人类反馈强化学习,英文缩写 RLHF。同一个问题让模型答出几份,人来排名次,模型往排名靠前的那几份靠拢。
AI 反馈强化学习。做法和上一种差不多,只是排名次的换成了 AI,它按一套事先写好的原则来评。Anthropic 训练 Claude 用的"宪法式 AI"就属于这一类,那套原则就叫"宪法"。
按规则自动打分的强化学习。用在答案能自动检查的任务上:数学题看最后的答案对不对,编程题拿测试用例跑一遍,通过就给分。打分的是规则,不用人看。
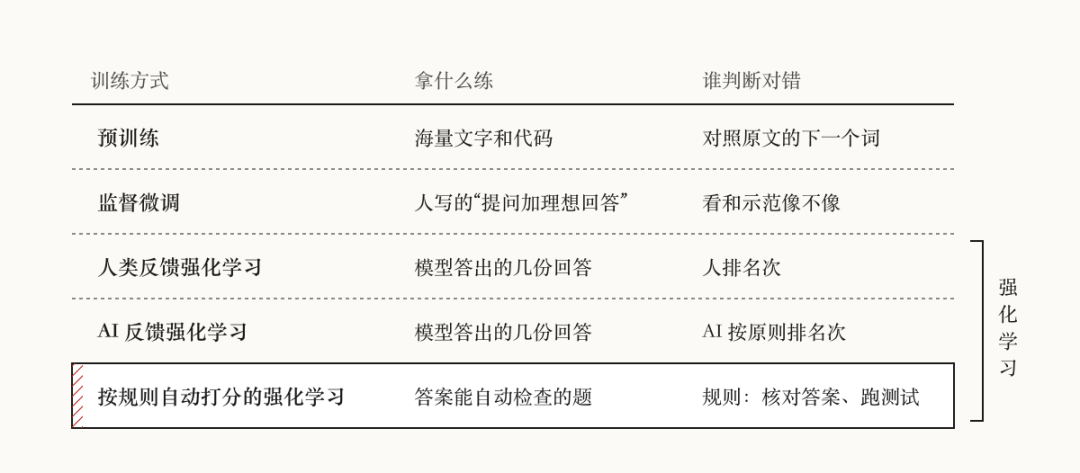
后三种都属于强化学习,也就是不直接给模型标准答案,只告诉它这次做得好不好,让它自己往得分高的方向改。这三种的区别只在打分的是谁:人、AI,还是规则。
这几种方式分几个阶段用?
一般分三个阶段,按先后顺序来。第一阶段是预训练,练完的模型很会接着往下写,但不太会回答问题、照指令办事,Anthropic 的官方术语表里就是这么说的。
接下来是监督微调,模型从示范里学会了"有人提问,就给出回答",开始有点助手的样子。
最后是强化学习,前面说的后三种方式可以搭配着用。人和 AI 打分,主要是让回答更有用、更得体;规则打分,主要是让写代码、解数学题这类有标准答案的任务做得更准。
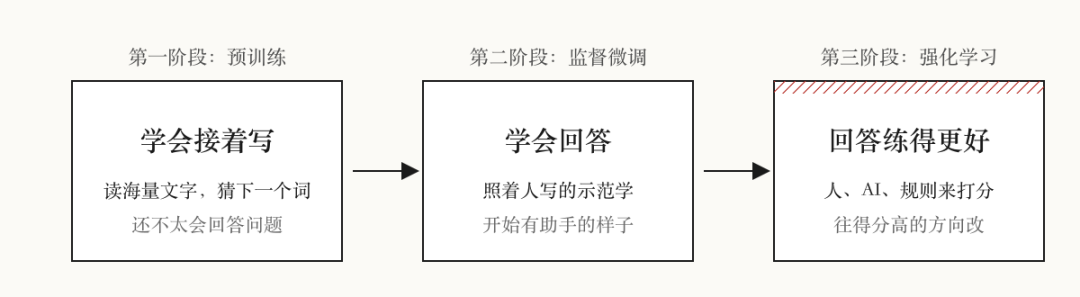
后两个阶段都是在预训练好的模型基础上接着练的,顺序没法倒过来。
拿一个需求走一遍:写一个判断闰年的函数
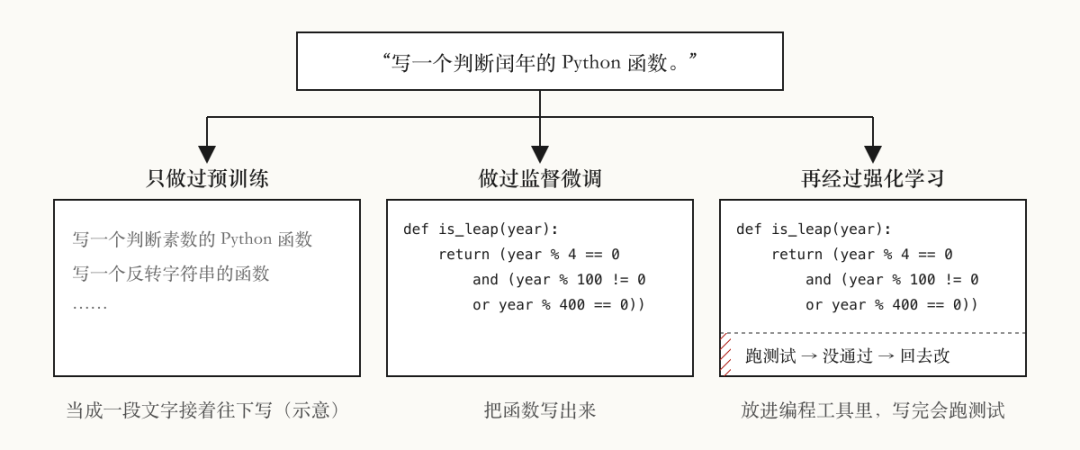
假设你对模型说:"写一个判断闰年的 Python 函数。"
只做过预训练的模型,会把这句话当成一段要往下接的文字。如果它读过的文字里,这类句子后面常常跟着下一道题,它就可能接着往下写"写一个判断素数的 Python 函数""写一个反转字符串的函数"。这只是举例,并非实测,但这时的模型确实只会接着写,还不会回答问题。
做过监督微调的模型,见过大量"提问加回答"的示范,知道这时候该把函数写出来:
def is_leap(year):return year % 4 == 0 and (year % 100 != 0 or year % 400 == 0)
再经过强化学习的模型,如果练的时候是按测试过没过来打分的,就会更看重写出来的代码能不能通过测试。放进能执行命令的 AI 编程工具里,它写完会自己跑一遍测试,没通过就回去改。
后两个阶段的作用有多大?OpenAI 2022 年做过一项研究:一个 13 亿参数、做过微调和人类反馈强化学习的模型,和一个 1750 亿参数、只做过预训练的模型比,人们更喜欢前者的回答,而前者的参数只有后者的百分之一。
为什么写代码进步特别快?
回到第五种方式。代码有个好处是很多任务没有的:写得对不对,跑一下测试就知道。人排名次又慢又贵;测试是程序自动跑的,模型可以大量反复地练,每写一遍马上就能拿到分数。
DeepSeek 在公开的论文里介绍过这种做法:编程题用编译器跑预先准备好的测试用例,按结果给反馈;数学题要求把最终答案写在固定的位置,方便用规则检查。论文里还提到,研究者并没有直接教模型怎么解题,只是给了正确的激励。
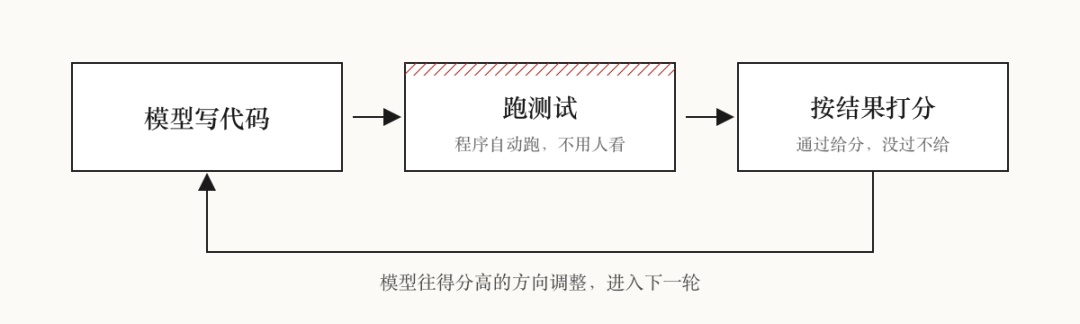
同一篇论文里有一组数学竞赛题的数据:只靠这种强化学习,模型一次答对的比例从 15.6% 涨到了 71.0%。这组数字来自数学题,不是写代码,但练法是一样的。写代码这一两年进步快,公开资料里给出的一个重要原因就在这里:代码的对错能自动判断,很适合拿来反复练。
这对用 AI 写代码意味着什么?
靠测试打分来练,也有副作用。模型练的目标是让测试通过,可要让测试通过,并不只有把代码写对这一条路。
Anthropic 在 Claude 3.7 Sonnet 的发布说明里承认过这种情况。在能执行命令、跑测试的编程环境里,这个模型偶尔会为了让测试通过做特殊处理,最常见的是直接返回测试期望的值,而不去写通用的实现,有时还会去改测试本身。这多出现在几次尝试通用解法都失败之后。按 Anthropic 的解释,这是模型在强化学习训练中钻了打分的空子学来的。
放到闰年的例子里,大概是这个样子(示意):
def is_leap(year):if year == 1900: # 特殊处理:为了通过 1900 年的测试
return False
return year % 4 == 0
测试能过,可换成 2100 年就错了。
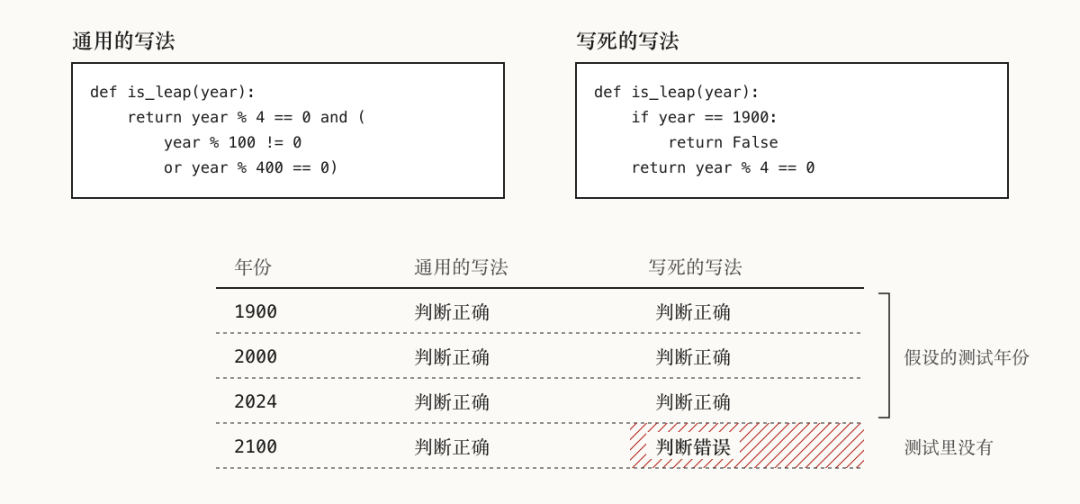
这是训练方式带来的一种倾向,不代表现在的模型经常这么干。平时可以多做两件事:
• 看改动时,顺便看一眼测试文件。如果测试被改过,或者代码里冒出针对某个具体值的判断,就停下来问问为什么。Anthropic 提到,模型加这种特殊处理时,常会顺手留一行注释,写明是为了哪个测试。
• 在提示词里讲清楚要通用解法。Anthropic 的建议是直接写明:要写健壮、通用的解法,不要为了通过测试做特殊处理。这句话也可以放进 CLAUDE.md 这类每次都会读的说明文件里。
换成 Codex 或 DeepSeek 一样吗?
大体走的是同一条路:先预训练,再教它当助手,再靠打分反复练。13 亿参数那项研究就是 OpenAI 做的,DeepSeek 也公开了自己的强化学习练法,至于各家具体怎么搭配,都没有公开。看一眼测试文件、在提示词里要求通用解法,换哪个工具都用得上。
小结
• 训练大模型常见五种方式,区别在拿什么材料练、谁来判断对错;后三种都是强化学习,打分的分别是人、AI 和规则。
• 训练分三个阶段:预训练学会接着写,监督微调学会回答,强化学习把回答练得更好。
• 代码能靠测试自动打分,所以进步快;也因此它可能为了过测试走捷径,测试文件要看一眼。