
跨 8 台 NVIDIA DGX Spark 节点运行前沿级 AI 模型
AI 开发者不再局限于运行单一模型,而是并行编排多个模型、串联推理调用,并试验需要数百 GB 显存的尖端架构。NVIDIA DGX Spark 旨在将 AI 开发能力带到桌面端,而现在,你可以连接更多的 Spark 节点组成集群。
在 GTC Berlin 大会上,NVIDIA 宣布正式支持 8 节点 DGX Spark 集群,统一内存扩展至 1 TB,为尖端模型、多智能体工作负载以及接近线性的预训练本地运行打开大门。
NVIDIA Sync 让组集群变得简单,其 Cluster Assistant 负责处理配置与设备管理。NVIDIA Sync 对 8 节点集群的支持预计年底前上线。
继续阅读,了解随集群规模扩大,推理、编排与训练性能的基准测试数据。
运行更大、更新的尖端模型
8 节点集群的最大优势在于内存。单台 DGX Spark 提供 128 GB 统一内存;4 节点达到 512 GB;8 节点则达到 1 TB。这一容量让那些此前在 4 节点系统上无法启动的模型成为可能,例如 Z.ai 的 GLM 5.3 (753B) 完整模型。
除了单纯容纳这些模型,该集群的设计目标还包括交互式服务。以早期案例为例,我们在 8 节点集群上运行了 GLM 5.3 Flash,测得生成速度约为每秒 80 个 tokens(TPS),足以支持对尖端混合专家(MoE)模型进行交互式本地开发。
GLM 5.3 (753B) 完整检查点可以在 8x 128 GB 集群上运行,成为你本地可服务的最大规模开源模型之一。
| 并发量 | 预填充,总 tokens/秒(TPS) | 预填充,每用户(TPS) | 解码,总(TPS) | 解码,每用户(TPS) |
| 1 | 1,600 | 1,600 | 31 | 31 |
| 4 | 1,600 | 750 | 51 | 21 |
| 8 | 1,600 | 473 | 67 | 18 |
使用 Spark 优化后端加速集合通信
张量并行推理会花费相当一部分时间在 all-reduce 等集合通信操作上。在通过交换机互联的集群上,我们一直在评估一个针对 Spark 优化的集合通信后端 RoCEnante,它能降低小消息、低并发、中等 rank 数量场景下的集合通信延迟——这正是本地 AI 硬件上张量并行 decode 的典型模式。
该后端先执行 all-to-all 交换,再进行本地归约。每个 rank 将自己的输入分发给所有其他 rank,然后在本地完成求和,整个过程由单个 GPU kernel 协调完成。
主要优势是减少了通信步数。Ring all-reduce 需要在相邻 rank 之间多轮传递数据,而这种做法直接与所有对端交换数据,省去了逐级转发的链条。在小消息和中等数量 rank 的场景下,可以降低延迟。
代价是更多的数据搬运。每个 rank 都要向所有对端发送完整输入,并自行归约全部输入。随着消息体或 rank 数量(节点数)的增长,这部分额外流量开销会越来越大,Ring all-reduce 在带宽效率上的优势也就愈发明显。如果需要支持高并发、更大规模的集群或 ring 拓扑,NVIDIA Collective Communications Library(NCCL)会有更好的表现。
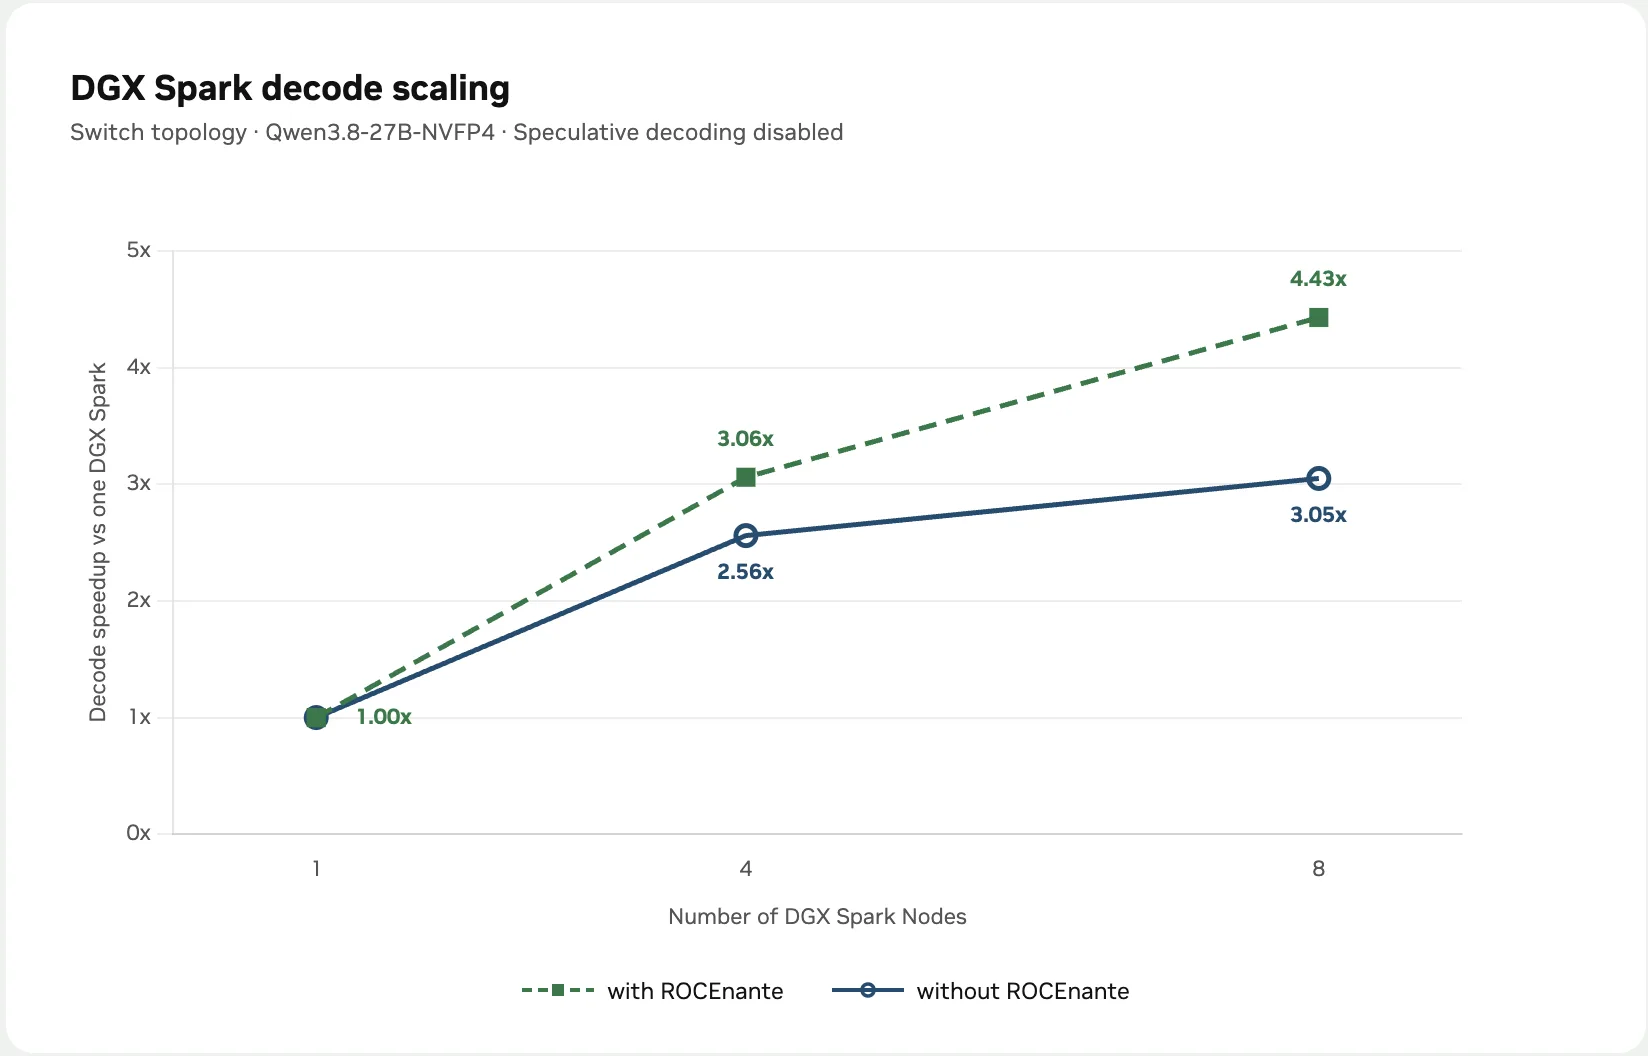
实际测试中,在 4 节点(NVFP4)下,Prefill 和 Decode 吞吐量分别提升约 5% 和 21%;而在 8 节点的非量化模型下,Decode 吞吐量提升约 18%。这与上述的延迟与带宽权衡相符。该后端已集成至 FlashInfer,若启动测试失败,会透明地回退至 NCCL。
该后端仅适用于交换连接拓扑,因为它依赖于节点间的直接点对点交换。它并非 NCCL 的替代品,NCCL 仍是受支持的标准默认选项,且随着集群规模和并发量的增加,NCCL 是更佳选择。最初的 One-shot All-reduce 方案由社区成员(Jason Cook/el8)贡献。
二、四、八:集群扩展
低延迟的 NVIDIA ConnectX-7 网卡 结合基于融合以太网的 RDMA(RoCE)通信,使 DGX Spark 节点能够高效交换张量。因此,你可以将模型扩展到更多节点,以突破内存限制并提升吞吐量。为了隔离集群扩展行为并消除上下文依赖影响,我们在单节点到八节点之间,对未使用推测解码/MTP 的稠密 Qwen3.8-27B(NVFP4)模型进行了基准测试:
| Spark 节点数 | 拓扑结构 | Prefill (TPS) | Prefill 扩展倍率 | Decode (TPS) | Decode 扩展倍率 |
| 1 | — | 2,635 | 1.00x | 11.86 | 1.00x |
| 2 | 直连 | 3,285 | 1.25x | 21.71 | 1.838x |
| 4 | 物理环 | 4,446 | 1.69x | 32.82 | 2.77x |
| 4 | 交换机 (ROCEnante) | 4,556 | 1.73x | 36.34 | 3.06x |
| 8 | 物理环 | 4,962 | 1.88x | 40.11 | 3.38x |
| 8 | 交换机 (ROCEnante) | 5,105 | 1.94x | 52.58 | 4.43x |
有两点趋势尤为显著。首先,Decode 吞吐量随节点数量显著增加,从单节点的约 12 TPS 提升至八节点的 52 TPS。
其次,最佳拓扑取决于工作负载:若需将单个模型分散到所有节点,物理环拓扑能提供出色的 Decode 吞吐量。但一旦需要将集群拆分为独立组,或运行要求节点间任意直接连通的工作负载,就必须使用交换机。
若想自行尝试,可以参考这份网络指南,它详细讲解了从双节点配置起步并逐步扩展集群设置的过程。
无交换机环状拓扑与设置简便性
并非所有集群都需要交换机。DGX Spark 节点可以直接连成环形,既降低成本又简化部署,对爱好者和中小规模部署来说很有吸引力。
在四节点 DGX Spark 部署中,NCCL 针对张量并行通信默认采用 ring 算法,无交换机的环形拓扑正好与流量走向完全吻合,能以更低成本提供可观的吞吐。如表 2 所示,四节点环形拓扑在该工作负载的 prefill 和 decode 吞吐上表现良好。
但一旦需要扩展规模或承担专门任务,情况就不同了:
- 八节点或拆分分配: 如果想把集群拆成比如两组四节点,环形拓扑无法表达这种结构,必须用交换机。
- All-to-all 和传统 HPC 工作负载: 任何依赖点对点通信模式的工作负载(例如基于 MPI 的集群)都需要交换机,环形拓扑会付出额外的跳数开销。
- 优化后的 collective 通信后端: 上述针对 Spark 优化的后端要求所有节点之间直接点对点互联,因此只适用于交换机连接的配置。
简单来说:如果你只想要最简单、最便宜的四节点推理服务器,选无交换机环形拓扑;如果需要扩展到八节点、拆分集群,或者运行环形拓扑无法支持的通信模式,就选交换机。
用 Switchyard 做多模型编排
并不是每个请求都需要动用最大的模型。在一个共享的八节点集群上,把简单请求路由给小而快的模型、把大模型留给难题,可以大幅提升整体吞吐。
NVIDIA NeMo Switchyard 让这一方案落地:一个轻量级分类器检查每个请求(或会话),并将其路由到合适的模型池,同时由负载均衡器在多个副本间分配流量。由于这种布局把八个节点拆分成相互独立的模型池,Switchyard 需要运行在交换机连接的集群上,因为跨副本路由请求需要任意节点间的全连通能力。
在原型中,我们采用 OpenBMB 的 MiniCPM5 2B 作为简单任务的分类与执行模型,复杂任务则交给 Qwen3.8 Flash Next。在一个涵盖标准、进阶及高难度用例的工具调用基准测试中,该路由代理在处理质量上与仅使用 Qwen 的配置相当,同时释放了集群的容量。
在包含 92 个用例(含高难度案例)的工具调用基准测试中,路由代理得分为 91/100,与仅使用 Qwen 的配置持平。
由于每个副本中 MiniCPM 的每秒请求量约为 Qwen 的一个数量级,将部分流量分流至更小的模型可以提升整个集群的吞吐量上限。在 8 个节点上分配 3 个 Qwen 副本(每个 Spark 节点 2 个)和 2 个 MiniCPM 副本(每个 Spark 节点 1 个),可得:
- 当一半请求路由至 Qwen 时,相较于仅使用 Qwen 的基线,整体吞吐量提升 1.5 倍。
- 当四分之一请求路由至 Qwen,其余路由至 MiniCPM 时,整体吞吐量提升 3.0 倍。
路由策略是一个简单的 YAML 文件,NVIDIA 提供了示例策略作为起点,开发者可根据自身工作负载调整分流比例和分类器。
从零开始预训练:基于 nanochat 的近线性扩展
训练行为与推理不同。当每个节点持有模型全量副本时,节点间唯一的通信是每步一次的梯度同步,因此集群扩展接近线性。为证明这一点,我们从零预训练了一个 nanochat 模型(约 896.5M 参数,20 层 Transformer,隐藏维度 1,280,序列长度 2,048 个 token),并测量了随节点数增加的吞吐量。
| 节点数 | TPS | 加速比 | 扩展效率 |
| 1 | 8,741 | 1.00x | 100.0% |
| 2 | 17,202 | 1.97x | 98.4% |
| 4 | 33,640 | 3.85x | 96.2% |
| 8 | 68,079 | 7.79x | 97.4% |
八节点集群实现了 7.79 倍的加速比,效率高达 97.4%。这种接近线性的扩展能力,使得八节点 Spark 集群成为从头训练小型模型的可行平台,而不仅仅是用于部署大模型。它同样是一个自然的进阶工作流:先在本地完成原型设计和预训练,随着模型规模增长再横向扩展。
如需复现 Nanochat 预训练实验或将其适配到自有模型,完整代码已在 GitHub 上公开。
开启多系统 DGX Spark 之旅
八节点 DGX Spark 集群能在桌面级空间内提供加载前沿级模型的内存、同时编排多个模型的灵活性,以及从头训练小型模型的高效性。
了解更多详情,请查看: