
OpenAI参与发现影响70%网页的PHP核心漏洞,协同响应历时两月
大约两个月前,OpenAI 推出了面向一线防御者的 Daybreak for Frontline Defenders 计划,投入 10 亿美元补贴 Daybreak 网络安全模型和产品的使用。这笔资金几乎立刻派上了用场:PHP 的多个重大漏洞被两方独立发现。其一是安全公司 Calif 的研究员 Ryan Austin,他在 2026 年 8 月参与 OpenAI 的“Patch the Planet”项目时,借助 GPT-5.6 Sol 找到了这些漏洞:
另一方则是刚被 Google Cloud 收购的 Wiz(使用 Gemini 4 Argon 和 GPT-5.6 Sol,以及自研工具 Wiz Atlas)。
每次高调的安全披露多少都带点营销成分,这次漏洞是否真到了 log4shell、Heartbleed 那种值得警惕的级别,也存在争议。但可以肯定的是,整个 PHP 生态的协同响应,正是开发者社区最理想的应对姿态。
我们应该做好心理准备:未来至少一年内这类关键漏洞还会不断被发现。但不要责怪发现漏洞的人——真正值得欣慰的是,我们的关键软件正在经历人类历史上规模最大的安全审计。
2026年10月20日-21日 AI 新闻。我们检查了 12 个 subreddit、544 个 Twitter 账号,以及暂无新的 Discord 频道。AINews 网站可搜索所有往期内容。提醒:如AINews 现已成为 Latent Space 的一个板块。你可以选择订阅或退订不同的邮件频率!
AI Twitter 摘要
头条新闻:PHP2Shell——时间线、核心主张及紧急响应背后的复杂性
发生了什么
研究人员披露了两个 PHP 引擎内存损坏漏洞,并演示了对主要 CMS 的非认证利用,同时引发了罕见的广泛协调响应。
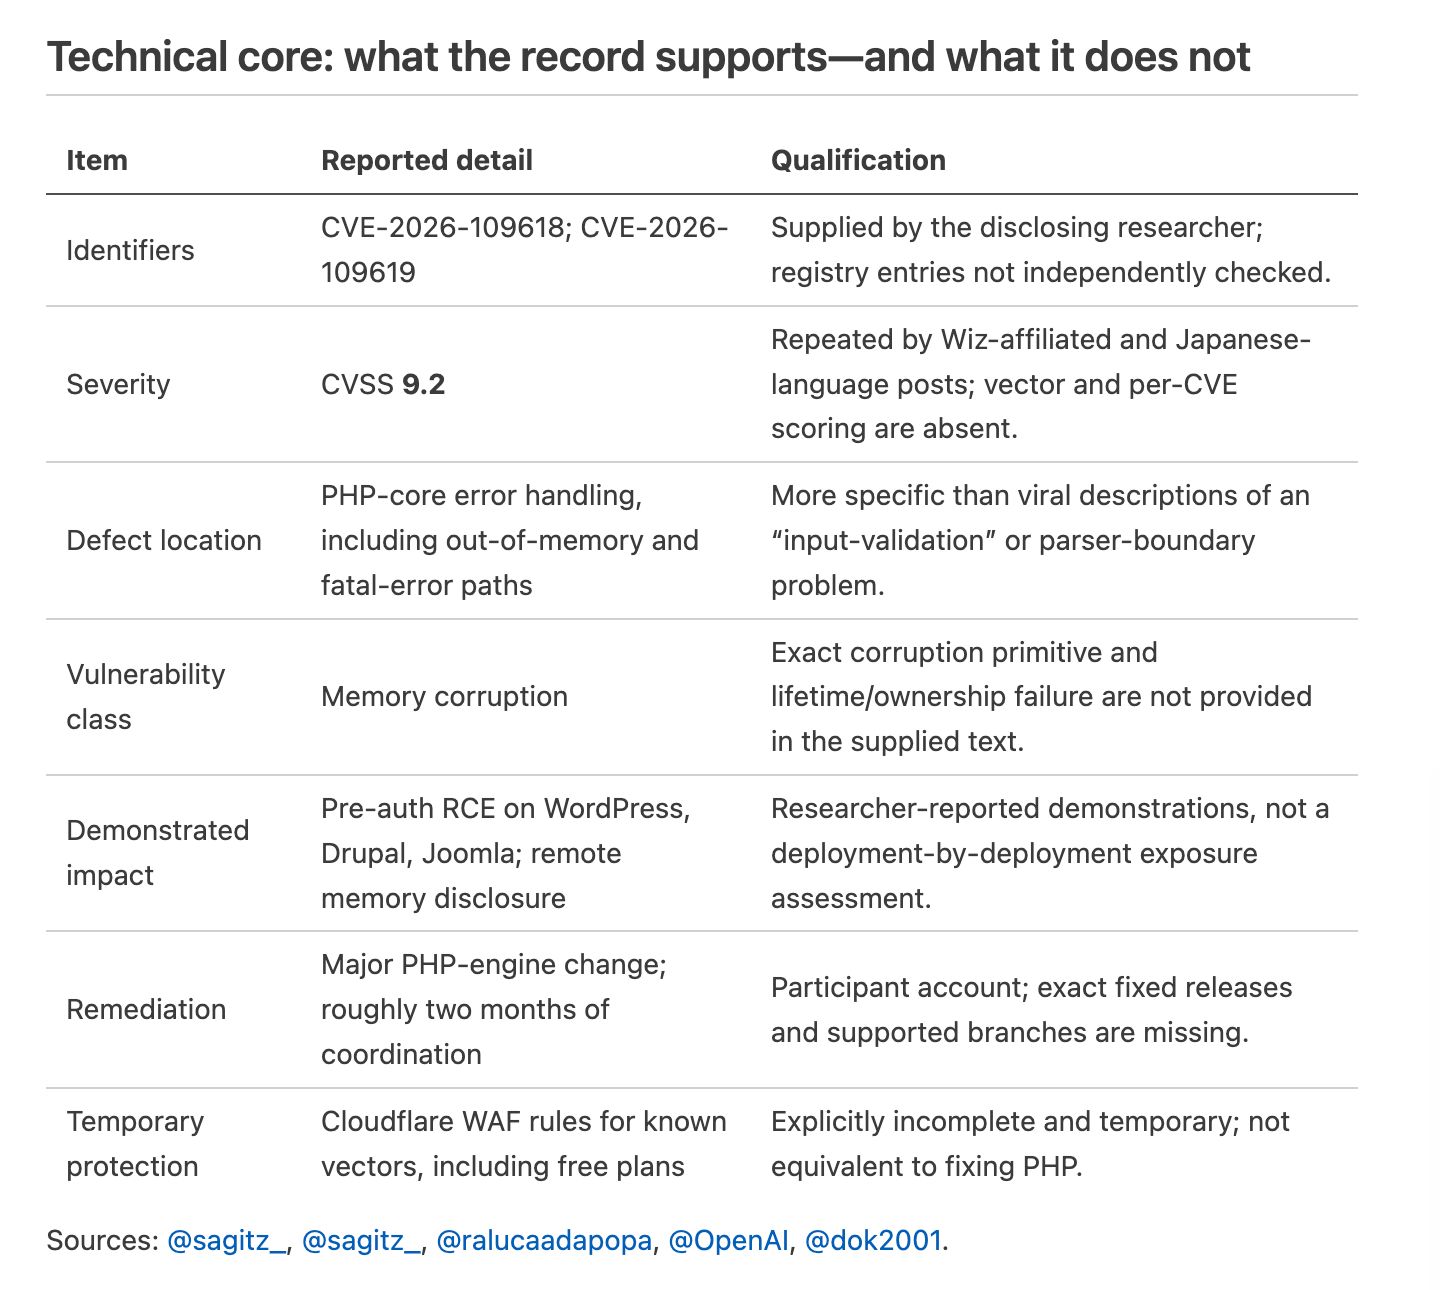
研究人员将这些漏洞命名为 PHP2Shell,并确定为 CVE-2026-109618 和 CVE-2026-109619。其技术描述将缺陷定位在 PHP 对内存不足条件和致命错误的内部处理上,而非 WordPress 插件或应用程序的身份验证逻辑。他们报告了完整远程代码执行(RCE)以及“Heartbleed 式”内存泄露的演示。@sagitz_
披露的演示包括针对 WordPress、Drupal 和 Joomla 的非认证 RCE。研究人员的公告还声称对任何 PHP 应用程序存在远程内存泄露。这些是研究人员报告的利用结果;不应默默将其扩大为所有部署都存在相同且可立即利用的 RCE 路径。@sagitz_
OpenAI 称加州研究人员利用其模型发现了这些漏洞,而二级报道则指出 Wiz 独立发现了相同的 bug。相关帖子在加州/OpenAI 一侧点名了 GPT-5.6 Sol;Wiz 关联账号则归因于 Gemini 4 Argon 完成了发现、利用链开发、检测器创建以及补丁验证。这是一起多方共同发现的故事,并非证据表明某一家厂商独自发现并修复了该问题。@TheRundownAI、@steipete、@ralucaadapopa
OpenAI 描述了披露前约两个月的协同修复过程。该补丁需要对 PHP 引擎进行重大变更,并涉及维护者、研究人员、安全服务商及政府机构的多方协调。参与的研究人员确认,其与 PHP 基金会合作,以支持和强化该补丁。@OpenAI、@itszn13
Cloudflare 在计划发布的补丁之前部署了初始 WAF 缓解措施。其 CTO 表示,相关规则覆盖了已知的利用向量,所有客户(包括免费层)均可使用,且随着早期攻击的出现,规则正在不断更新。他明确将这些规则称为临时措施,并指导运营商在 UTC 14:00 时应用补丁。@dok2001
所提供的 NSA 账号内容建议立即准备更新——若无法及时缓解,应将系统下线。OpenAI 随后的消息表示升级补丁已可用;另有报道称细节在补丁发布前已泄露。所提供的材料无法确切说明泄露了什么、何时泄露,以及发布时间表是否因此改变。@NSACyber、@OpenAI、@TheRundownAI
还原时间线
1. 发现与私下协调:大约在公开披露前两个月。
OpenAI 将这项工作归入 Patch the Planet 项目,称其牵头组建联盟准备修复与防护措施。其安全研究员 Eric Wallace 补充说,内部团队不只是提交漏洞报告,而是参与打补丁和构建检测方案,并提前向政府和外部机构做了保密通报。Greg Brockman 也重申了两个月的协调周期。以上均为参与者自述,并非经独立审计的事件时间线。@Eric_Wallace_、@gdb
项目名称的区分很重要:相关帖子将漏洞归功于 Patch the Planet,而研究人员则认为 Daybreak 模型的访问权限才是安全研究得以开展的关键。两者角色相关——一个是修复计划,一个是访问机制——但并非同一项目的可互换说法。@OpenAI、@S1r1u5_
2. 提前公开预警与预定补丁窗口期。
日语帖子提醒运营人员,预计将在10月21日23:00 JST发布补丁,这与 Cloudflare 在14:00 UTC的通报一致。其中一条帖子正确地强调,核心 PHP 漏洞无法仅靠等待插件开发者更新来修复。另一条帖子则将事件描述为补丁发布后"15分钟"的竞赛,但这一数字是预测值,并非武器化时间的实测数据。@ds_nakajima、@expokun
3. 发布前的过滤与观察到的攻击活动。
Cloudflare 的帖子是现有记录中最有力的第一手运维证据:缓解措施已部署,已知向量已覆盖,且"早期攻击"开始出现。该帖子未说明是否有成功入侵、请求数量、受害者数量、载荷来源,也未区分流量是源于原始漏洞利用开发还是泄露信息的再利用。@dok2001
4. 研究披露、政府警告与补丁获取。
研究人员的公开帖子描述了漏洞利用演示及错误处理的根本原因。NSA 的帖子呼吁紧急准备并在必要时关闭服务。OpenAI 随后表示所有 PHP 站点均可安全升级。但现有材料中缺少 PHP Foundation 的直接发布公告、确切的已修复版本矩阵、发行包标识或补丁提交记录。这一关键一手来源的缺失,使得无法给出可靠的"升级至版本 X"的指导。@sagitz_、@NSACyber、@OpenAI
5. 指控的过早暴露与广泛的服务中断。
The Rundown 报道称相关细节提前泄露。随后疯传的一份汇总材料称,根据 Censys 的数据,约有 150 万台服务器运行着未修复的版本;并报道了荷兰机构、欧洲其他地区政府网站、Wikipedia、Archive.org、Asana、GOG 及其他站点发生的关停事件,以及日本首相在凌晨 05:55 发出的警告。但在所提供的材料中,这些具体说法均未获得其底层公告、测量数据或状态页的证实。记录中也无法确定每次停机是出于预防措施、补丁更新导致的中断、无关故障,还是已被入侵。@TheRundownAI、@fiveoutofnine
SemiAnalysis 另据报道,日本首相敦促 PHP 运营商立即打补丁,若无法做到则暂时断开连接。其报道将这一反应置于日本此前一波数据泄露事件的背景下,而非证明 PHP2Shell 导致了那些早期事件。@SemiAnalysis_
6. 披露后提供了暴露检查辅助
OpenAI 发布了一个代码仓库,其中包含一个旨在引导运营商检查其站点是否受影响的 Codex skill。这是一个辅助工作流,不能替代厂商公告、包验证或证明所有易受攻击的运行时已被替换的证据。@OpenAI
AI 的角色:可信证据、荣誉归属之争以及未解决的因果性
这一肯定性论证比仅凭基准测试的说法更有说服力。研究人员描述了完整的可利用漏洞链、协同的补丁工程、检测器和补丁验证工作。一位参与研究的研究者称,PHP2Shell 是他们协助发现过的最重大的漏洞。OpenAI 将其视为“防御者窗口”的一个案例:先进模型在攻击者之前发现漏洞,为防御方争取了准备时间。值得注意的是,OpenAI 的措辞是“据我们所知”——这并不能证明此前没有攻击者知晓这些漏洞。 @itszn13, @OpenAI
这项成果的功劳分布在人类、模型和基础设施提供商之间。Calif/OpenAI 与 Wiz/Gemini 各自提供了独立的发现记录;PHP 维护者提供了上游修复路径;Cloudflare 则在漏洞披露前提供了过滤防护。Google 还宣传了 Wiz 的一项测试,其中 Gemini 4 Argon 发现的漏洞数量是基准模型的两倍多,但该宣传贴并未公开数据集、基准设置、算力预算或误报统计,因此并不构成对 PHP2Shell 发现能力的独立对比评估。 @TheRundownAI, @ralucaadapopa, @Google
研究人员访问政策褒贬不一。有研究者表示,得益于 OpenAI 的 Daybreak 访问权限,他们在 PHP、GitLab、Chrome、WordPress 及其他目标中发现了大量漏洞。另一位则鲜明对比了 OpenAI 的审核制访问与 Anthropic 的限制性政策;尽管后者被认为对此次安全事件“毫无价值”,但这是该作者的主观论断,并非基于 PHP 漏洞事件的事实记录。另有帖子批评 Astra 访问限制,主张为 1,000 名经过审核的研究人员提供最强可用的模型并加强监控,而非僵化地划分红蓝对抗界限。@S1r1u5_,@migtissera,@S1r1u5_ 相反的安全考量体现在报道中:Anthropic 为强化网络安全防护,将 Mythos 级别模型的广泛访问权推迟了四个月。这解释了访问受限的动机,但无法证明这种实施方式是助力还是阻碍了此次特定的漏洞修复工作。@kimmonismus 集中爆发的信息披露本身,并不构成 AI 导致安全事件激增的证据。提供的信息源混合了防御性发现、供应链攻击、凭证窃取、预防性关停以及无关的漏洞。Ethan Mollick 认为,攻防节奏正在超越人类反应速度;John Allard 则描述了一种能力“相变”,同时承认许多近期发现来自白帽项目。两者均是对模式的现象学解读,而非针对具体事件的因果归因。@emollick,@john__allard操作复杂性:补丁、关停及“全面修复”的诱惑
这场紧急事件的核心挑战,一半在漏洞发现,另一半则在漏洞的分发与修复责任落实。运维人员需要在托管环境、容器、专用设备、后台工作进程以及遗留应用等复杂场景下定位 PHP 实例,获取适用的补丁包,完成部署,重启或替换受影响的进程,并验证当前运行的构建版本。有运维人员表示,由于要维护大量的 PHP 和 WordPress 站点,他们在测试和更新工作中已感到力不从心;另一位则指出,补丁的分发与协调效率低下。@ostrisai、@jd_pressman
部署 WAF 确实能降低短期暴露面,但同时也带来了过度自满的潜在风险。Cloudflare 官方早期的声明其实比后续“将所有面向互联网的服务置于其防护之后”的建议更为克制:当时 WAF 仅覆盖了已知的攻击向量,防护能力仍在演进中,而直接修补漏洞始终是强制性要求。运维人员不应想当然,而应主动核查代理覆盖范围、备用入口路径以及源站的实际暴露状态。@dok2001、@threepointone
官方发布的停机指导是附带条件的,并非意味着整个互联网应当全面断网。NSA 的建议仅指出:在无法立即完成更新、且具备全面缓解措施前,才应考虑让相关系统下线。对具体运维人员而言,真正需要评估的是受影响版本的当前状态、暴露面大小、可用的缓解手段以及继续运行的实际后果,而非被某条耸人听闻的帖子所左右。@NSACyber
“用 RCE 自动给所有服务器打补丁”只是一种提议,并非经授权的修复方案。Marc Köhlbrugge 提出了这个想法,J. D. Pressman 则建议为尝试这么做的实验室或白帽团队争取总统赦免。但未经授权的漏洞利用仍然存在越权访问、服务中断、修复出错、破坏证据以及跨境司法责任等风险。一份假设性的赦免既不构成普遍授权,也无法消除民事和外国法律上的追责风险。@marckohlbrugge、@jd_pressman
更新速度与供应链安全之间存在权衡。一条被广泛转发的帖子道出了这个两难:频繁更新可能让用户暴露在被投毒的软件包之下,而延迟更新又会留下已知漏洞。Pressman 认为,除非新漏洞和高风险版本的出现速度降下来,否则无休止的打补丁是不可持续的;他还指出,比起收到过多更新,收不到补丁、事后才发现被盗显然更糟。@xeophon、@jd_pressman、@jd_pressman
关于长期替代方案,问题仍悬而未决。Sarah Guo 报道 CVE 数量自四月以来从每月约 4,000 个激增至 15,000 个,并提出了关于形式化验证、更安全发行版以及缺乏红队机制的组织如何应对等问题。这些统计数据在此处未经独立核实,且漏洞披露数量并不能直接等同于成功利用的数量。其他文章探讨了完整代码库安全扫描的成本,并将挑战重新定义为强化常规基础设施,而非仅仅争论抽象的灾难性后果。 @saranormous, @saranormous, @teortaxesTex, @mimi10v3
对于事故响应团队而言,可防御的操作顺序应为:获取权威的 PHP 及发行版安全公告,清点暴露的运行时环境,在合理情况下应用临时防护措施,部署已认证修复的软件包,验证运行中的进程,并单独调查是否存在被利用的证据。更新补丁只能关闭漏洞,并不能证明凭据或数据从未泄露。
公众反应:务实的谨慎与缺乏依据的升级
谨慎型观点强调,相互交织的服务体系十分脆弱,且修复成本高昂。Joshua Achiam 将当下类比为 2020 年 3 月的时刻,他猜测互联网可能面临封锁,建议备份有价值的互联网资料,并提议打印重要记录。Pressman 表示,修复成本超出了他的预期。这些属于备灾判断,并非系统即将崩溃的证据。纸质副本或许有助于业务连续性,但本身并非不可篡改的日志。@jachiam0,@jachiam0,@jachiam0,@jd_pressman
怀疑型观点则要求论述更具具体性。Alex Johnson 认为,关于银行账户可能被任意清空的警告混淆了“未授权转账”与“客户授权付款的诈骗”之间的区别。他援引了美国《电子资金转账法》中关于及时报告的保护条款;但这些保护取决于管辖权、账户类型及具体情境,并非普遍性保障。Kelsey Piper 则单独警告,长期生活在“世界末日”式的叙事框架下会带来心理负担。@AlexH_Johnson,@KelseyTuoc
泛泛的个人信息安全建议需要与 PHP 修复问题区分开来。密码管理器、独立凭据、强 MFA、及时打补丁、运营商防携号转网保护,以及美国特有的信用或税务身份防护措施,确实能减少后续损失。但开启 2FA 并不能阻止对 PHP 引擎未认证漏洞的利用。同样,第二天就回避所有线上支付这类疯传的建议,也缺乏可靠的范围评估支撑。@peterwildeford、@StillMare_
更宏观的威胁背景确实存在,但不能与 PHP2Shell 混为一谈。据 SemiAnalysis 报道,自 9 月 25 日以来已有 18 家日本公司披露数据泄露,涉及约 660 万 Times Car 账户、1118 万 Burger King Japan 应用记录,以及可能多达 2250 万条 Sourcenext 记录。关于 AI 辅助扫描和 API 攻击的发现,该报道归因于 JPCERT/CC。另有一条帖子引用了 8 月 19 日的一份公告,内容涉及针对暴露在互联网上的 Siemens PLC 的 AI 辅助攻击工具。这些都是独立的事件报道和公告,均未证实 PHP2Shell 是它们的入侵入口。@SemiAnalysis_、@AndrewCurran_
尚未解决的关键证据缺口非常具体:确切的受影响版本和修复版本;CVSS 向量;利用该漏洞所需的部署前提;各方独立发现的时间线;漏洞披露前是否有泄露;是实际利用成功还是仅扫描探测;经过验证的受影响数量;以及每起已报告停机事件的原因和持续时间。仅仅把 PHP、GitLab、LiteLLM、Railway、证书机构故障和政府警告拼凑在同一个叙事里,那些疯传的事件汇总并不能回答上述任何问题。@fiveoutofnine
其他新闻
Flint 与自动化研究:本地编程模型、更小的团队与科学工作流
Flint 正式发布,具备强大的本地服务能力:Recursive 推出了一款采用 Apache-2.0 许可协议的 MoE 编程模型,总参数量约 40B,激活参数 2.5B,上下文窗口达 262K token。LM Studio 指出其本地运行需约 24GB 显存。Recursive 将 Flint 定位为前沿云端智能体的端侧互补品,而非替代者(发布,规格)。
官方宣称的性能:Recursive 报告其在 Terminal-Bench 2.1 上得分 54.9%,SWE-bench Pro v2 上得分 89.7%,SWE-bench Verified 上得分 74.2%。这些均为发布时的官方数据,尚未经过独立复现验证(结果)。
推理速度:官方宣传的短上下文场景下,MacBook Pro 可超过 125 tokens/s,RTX Spark 可达 150 tokens/s。另有用户实测在 M5 Max 上使用 int4 MLX 精度时,输出速度为 114–132 tokens/s。该数据可作为速度侧参考,但不等同于受控条件下的能力评估(本地实测)。
研究贡献:Recursive 表示,其 Eureka Machine 参与了从构思、实现到验证的全流程,贡献了稀疏架构设计、低比特训练策略及核心算子开发。官方称该模型在几乎不损失质量的前提下实现了 71% 的体积缩减,且从零开发到完成用时不足四个月(方法)。
获取方式:发布当日即支持本地框架集成及托管 API 访问。vLLM 报告在单张 GB200 显卡、使用 NVFP4 量化且未开启投机解码的情况下,于 100K 上下文长度下可达 500 tokens/s;OpenRouter 提供免费的发布期访问(vLLM,OpenRouter)。
DeepInfer 公开了生产级调度技术:DeepSeek 发布的这套框架结合了投机解码、动态 prefill 尺寸调整、按请求数和 KV 长度平衡解码,以及 CPU 调度与 GPU 执行的重叠。其中一个特别值得复用的思路是:基于预测的 draft 接受率和实测硬件吞吐量来调整投机验证长度,让 batch 更规律,而不是让慢副本决定整体完成时间(技术分析)。
缓存核算:一份部署报告摘要提到,每个 prefill 加速器含缓存命中可达 150 万 input tokens/s,而不含命中时为 6 万,缓存命中率高达 96%;解码则为每加速器 1.4 万 output tokens/s。这几个吞吐量数字口径差别很大(报告摘要)。
经济性提醒:同一份摘要指出,每加速器小时约 38 美元是收入而非利润,服务器、电费、制冷和人力成本都未计入其中。
独立基准测试仍存争议:SemiAnalysis 称 DeepInfer 未进入 InferenceX,原因是其缺少关键的 serving 组件,补齐它们需要太多假设。随后 SemiAnalysis 做的盈利能力对比也遭到批评,被指混用了不同代次的硬件、峰谷电价,以及收入与利润口径。不过这些批评本身也只是转述的观点,并非已验证的复现结论;实际要比经济性,前提是对齐硬件、工作负载、缓存假设、SLO 和定价(基准局限,对比批评)。
TorchTPU 为 PyTorch 开辟了原生路径:谷歌开源了 TorchTPU,让用户能通过熟悉的 PyTorch 工具链进行训练和推理。据称,SGLang 的插件正在支撑 Meta 的生产级推理,并支持多个当前流行的开源模型;其定制的 MegaKernel 在 8K 输入/1K 输出、批次大小为 1 的场景下,Muse Spark Open 模型的解码速度达到了 770 tokens/s。vLLM-TorchTPU 则集成了前缀缓存、推测解码和分离式服务(谷歌、SGLang、vLLM)。
GTC 重点关注部署速度与功耗利用率:NVIDIA 的 DSX POD 将 AI 基础设施封装为容器化的模块化组件,宣称可在数天内(而非数月)完成容量扩展。更具体地说,Lambda 展示了 19 个 HGX B200 节点在 DSX MaxLPS 技术下,于 16 个节点的功耗预算内运行。建议将部署周期视为产品宣称,将节点运行结果视为概念验证,而非已实现的大规模集群能力(DSX POD、Lambda 演示)。
评测完整性与智能体工程:衡量测试框架,而不仅是模型本身
医疗推理暴露了完整性与准确性之间的权衡:Artificial Analysis 修订了 MLCR-AA 的提示词、参考答案以及由三个模型组成的评审面板。Sonnet 5.5 和 GPT-6 Astra 在 41.7% 上持平,在结合完整性与准确性要求的评估中,没有模型超过 42%。Claude 在完整性方面领先;OpenAI 在基于记录的准确性方面领先。修订后的分数与旧方法的结果不具备直接可比性(结果,方法论)。
长度混淆因素:一项跨基准测试的分析发现,Claude 的回答长度大约是 OpenAI 的 4–6 倍;每增加一个论点,就多了一次与记录相矛盾的机会。因此,原始评分标准分数、完整性和长度调整后的质量会产生不同的排名(对比)。
SWE-bench Multimodal 面临消融挑战:一项独立调查认为 v2 并没有实质性地需要图像;另一位研究人员指出,在不使用图像的情况下运行该基准测试是关键性的健全性检查。这是对基准测试所衡量内容的实质性批评,而非证明其底层编码任务没有价值(调查,消融讨论)。
演化的框架和界面提升了固定执行器:两篇论文强化了对代理周围的环境进行优化的观点。
SuperMimic 主打更便宜的人形机器人训练:研究者在单块 GPU 上用三小时完成了 129,514 个动作的训练,而引用的最先进方案需要 128 块 GPU 跑七天。其原理是将可微分的、学习得到的世界模型代理与时间反向传播相结合。所谓超过 1000 倍的 GPU 时数节省,仅针对这套动作控制训练流程,并非机器人学习的普遍情况(结果,原理)。
Agent 产品、检索模型与 API 分发
Claude Duet 开启研究预览:Anthropic 为由 Opus-5.5 驱动的主动式助手开放了等候名单;据报道首批开放给美国的 Pro 和 Max 用户。示例场景包括监控 Slack、准备问题,以及在用户请求后完成购物。Stripe 描述了 Link 钱包支付,以及基于 MCP 的开票、退款和营收分析。目前处于预览阶段,相关帖子中未披露单独定价(Anthropic 高管,访问权限,支付集成)。
检索发布聚焦精准度与上下文成本:Cohere 推出了 Pro 和 Fast 层级的 Rerank 5。其可选的 Context Focus 功能直接返回经过评分的段落而非完整文档,在保持准确率的同时,号称可将 token 消耗降低多达 41%。另外,ParseBench 报告显示,NVIDIA 的 Nemotron 3.5 Parse(参数量低于 1B)在文档理解基准测试中夺得第一(Cohere 功能特性,可用状态,ParseBench)。
Kling 4.0 推广至 API 接入:fal 最初宣布提供 UI 和 Agent 接入,API 支持随后跟进;Kling 随后官宣其正式 API 上线。宣称的改进主要集中在复杂动作稳定性、参考一致性以及电影级控制方面。后续的官宣取代了早期“API 即将上线”的状态(fal 发布,API 上线)。
企业级模型访问范围扩大,Claude 对其 API 进行版本化:OpenAI 宣布其前沿模型和 Codex 工作流将登陆 Google Cloud Model Garden。另方面,Anthropic 的 API 版本 2026-10-21 从 Messages 中移除了 temperature、top_p 和 top_k 参数;新版 SDK 默认使用该版本,而 2023-06-01 版本仍受支持。升级 SDK 的团队应明确审查迁移行为(Google Cloud 分发,版本变更,SDK 默认设置)。
Latent Space 的读者群体包括负责部署智能体、模型和基础设施的专业人士。如需赞助此广告位,请垂询。
business@latent.space →行业与治理:研究者发声与公共利益监督
不贬损条款引发审查:引用BBC报道的帖子声称,Google的雇佣合同无限期限制对公众的批评言论,从而抑制了关于AI安全和军事用途的讨论。前员工和研究人员的表述描述了这种“寒蝉效应”。这些被归为合同和工作场所方面的指控;提供的材料中不包含公司回应或法律裁定(报道摘录,研究人员陈述)。
Anthropic 更新公共利益治理架构:Anthropic 发布了年度公共利益报告,并任命实验物理学家、前哈佛科学与艺术学院院长 Christopher Stubbs 进入其长期利益信托委员会。这是一项治理层级的动态,独立于该公司的模型评估和产品发布(报告,信托任命)。
热门推文(按互动量排序)
NSA:准备更新PHP;若无法实施缓解措施,请将系统下线 — 80,000
OpenAI:协调发现并修复 PHP2Shell 漏洞 — 19,600
OpenAI:检查 PHP2Shell 暴露面的 Codex 技能 — 10,500
NVIDIA:Microduck sim-to-real 演示 — 7,800
Richard Socher:Flint 本地编程模型发布 — 7,600
OpenAI:GPT-Rosalind 提出神经退行性疾病假说 — 7,500
AI Reddit 精选回顾
/r/LocalLlama + /r/localLLM 回顾
1. 开源推理加速:DeepInfer、EAGLE-4、RTX 3090 解锁 BF16
DeepSeek 新作:DeepInfer - (热度:441):该图片是 DeepSeek 在 X 上宣布其自研大规模推理框架 DeepInfer 正式开源的截图:图片、GitHub 仓库、X 帖子。DeepSeek 将 DeepInfer 描述为支撑 DeepSeek-V4.1-Flash 的生产级推理栈,旨在优化高吞吐、低延迟的服务性能,从而降低计算成本与能耗;一篇链接的知乎文章称,单一集群日处理量可达 155 万亿 token,且在不忙时段每张卡每小时能产生约 38 美元的收益。评论者认为,与 Anthropic、OpenAI 或 Meta 相比,此次开源动作格外大胆,有人甚至表示那些实验室“绝不可能这么做”。部分用户仍不清楚该框架的实际作用,仅简单询问:“它到底干什么用的?”
链接的一则知乎来源称,DeepInfer 为 DeepSeek V4.1 Flash 提供高吞吐、低延迟的推理能力,报告称单集群吞吐量达每日 155 万亿 token,并在非峰值时段实现每卡每小时 38 美元的收益:

https://zhuanlan.zhihu.com/p/2095560295930508953
. 评论者强调,与 OpenAI、Anthropic 或 Meta 等公司相比,这种公开披露方式显得异常激进。
一个技术担忧是:DeepInfer 究竟是真正通用的推理框架,还是主要适配 DeepSeek 自家模型架构?有评论指出,与旗舰模型捆绑发布的炫酷框架往往隐藏着架构特定的优化,这些优化未必能顺畅迁移到其他 LLM 上。
帖子中提到的一个性能指标约为 256 tokens/s × 100 用户,评论者认为这代表了极高的并发服务吞吐量。这意味着 DeepInfer 的目标可能是生产级多用户推理,而不仅仅是单请求延迟基准测试。
Eagle-4 发布:速度超越 DFlash2 & DSpark(热度:306):EAGLE-4 是一个开放源码的推测解码框架,采用针对硬件和工作负载校准的草稿树,并集成了 SGLang、vLLM 和 TokenSpeed 的适配方案;目前的报告和支持基准主要围绕 Qwen3.8-27B 模型。帖子引用数据显示,与标准解码相比,MTP 加速比为 2.22 倍,DSpark 为 2.57 倍,DFlash 2 为 2.80 倍,而 EAGLE-4 达到了 3.59 倍。其代码仓库报告称,在单请求并发下,4 块 NVIDIA B300 上的 SPEED-Bench 增益分别为 SGLang 3.42 倍、vLLM 2.83 倍、TokenSpeed 3.09 倍;据称在更高并发下增益会缩小(EAGLE-4)。评论者还提到了 Nemotron Bolt 使用的 LiLiCorr,认为它是具有更细致基准报告的竞争性推测解码器(论文)。评论者质疑 DSpark/DFlash 的比较是否具有代表性,因为平均值可能掩盖对特定工作负载的敏感性——例如 MTP 在代码/JSON 等结构化输出上可能表现更好——并要求按工作负载类型进行细分。另一个顾虑在于实用性:据称 EAGLE-4 的草稿模型比 DFlash2 大约 3 GB,这使得其在显存受限的部署中吸引力下降。
多名评论者质疑 Eagle-4 相对于 DFlash2 和 DSpark 报告的加速比在不同工作负载中是否具有代表性。有人指出,平均结果可能掩盖较大的方差,因为 MTP 在代码或 JSON 等结构化输出任务中表现可能更佳,因此要求按工作负载类型细分加速比,而非仅看整体基准测试。
针对实际部署提出了显存占用问题:据称 Eagle-4 的草稿模型比 DFlash2 大 3 GB,这可能使其不适合那些显存已接近上限的本地推理环境。
评论者提到了其他竞争或相近的 speculative decoding 工作,尤其是被 Nemotron Bolt 使用的 LiLiCorr,据说其论文提供了更细粒度的 benchmark 分析:https://arxiv.org/pdf/2608.20530。也有人希望把 Eagle-4 和 HyperQwen 做对比,或者探讨 HyperQwen 能否集成它:https://github.com/syv-ai/HyperQwen。
现在回头看,当初那篇“3090 狂热”警告帖说得有道理。(热度:405):图片是一张 X/Twitter 帖子的截图,声称 RTX 3090 的 “gpu-unlock” 内核/模块可以大幅提升 BF16 tensor 计算吞吐,例如 BF16 tensor pipe 从 82 提升到 155 TFLOPS,cuBLAS BF16 GEMM 从 64 提升到 99 TFLOPS,据称原理是解除了 NVIDIA 对 FP32 累加 tensor 运算施加的限制。结合上下文,Reddit 楼主发帖询问这是否解释了之前的“3090 狂热”警告,以及旧的防挖矿限制或产品分级限制是否仍在影响 LLM 工作负载,但评论者指出,合成 benchmark 上的 BF16/GEMM 提升未必能转化为实际的推理/训练加速。对于市场炒作的说法,评论者持怀疑态度:有人称“二手 3090 会比 5090 还贵”的预测是妄想,另有人贴出此前的反驳文章,指出该 hack 尚未在实际工作负载中体现出收益。主流观点比较谨慎:benchmark 数据固然有趣,但“1.9 倍速度”最终落到端到端上的提升可能小得多。
多位评论者认为,关于 RTX 3090 “破解”的传闻被过度炒作,因为实测收益仅限于狭窄的工作负载场景:预填充(prefill)阶段约有 10–12% 的提升,而非广泛的实际 LLM 推理性能翻倍(1.9 倍)。有人引用了先前帖子中的驳斥意见,强调这种低层 BF16 性能增益尚未转化为端到端实际工作负载的收益。
技术层面的担忧在于,BF16 操作可能仅占推理时间的一小部分。除非瓶颈确实出在 BF16 计算而非内存带宽、KV 缓存访问、采样或其他内核(kernel)上,否则在 RTX 3090 上加速或解锁 BF16 路径的影响将十分有限。另一位评论者指出,该修改方案能否被广泛采用,取决于它是否能安全实施,并在 CUDA 和 NVIDIA 驱动更新中保持稳定性。
在价格方面,评论者对此消息能显著推动二手 RTX 3090 涨价表示怀疑。他们认为,GPU 定价更多受行业整体供应合同和新卡市场定位的影响,而非小众 LLM 爱好者需求。有人举例称,一张新款 Radeon RX 9700 级别、32 GB 显存的显卡售价约 2 千美元,可能比被炒高的二手 3090 更具性价比,尽管该帖子并未对具体型号和价值主张进行深入基准测试。
2. 新开源模型:Ornith-1.5、Flint 及小型语音克隆 TTS
ornith-ai/Ornith-1.5-122B (Qwen finetune) (活跃度: 438):Ornith AI 发布了 Ornith-1.5-122B,这是一款基于 Qwen 3.5 和 Gemma 衍生谱系、从 Ornith-1.0 微调/继续训练的 122B MoE 推理模型。该模型通过强化学习(RL)构建自我改进闭环,联合优化任务生成、脚手架构建和解决方案生成,而不再依赖固定的人工策划任务。发布产物包括 GGUF、unsloth GGUF 和 NVFP4 变体;模型卡片宣称其具备强大的编码和智能体基准测试性能,支持 262K 上下文及可选的 YaRN 缩放至约 1M,并可通过 vLLM/SGLang/OpenAI 兼容 API 以及 llama.cpp/Ollama 风格的 GGUF 路径进行部署。评论者质疑为何选择 Qwen 3.5 122B 作为基座模型,而非更新的“Next Flash”风格基座,认为其架构可能已落后。还有一个技术担忧是推理速度:由于基于 Q3.5 122B(A10B 激活参数)且缺乏稀疏注意力,有评论者估计其速度比 A6B 激活参数的 Q3.8fn 风格模型慢约 2 倍。
一位评论者指出,该微调基于 Qwen 3.5 122B,意味着对于 q3.8fn 用户而言,其行为模式将是 A10B 而非 A6B,且没有稀疏注意力,预计这会使该配置下的推理速度慢约 2 倍。
对基座模型的选择存在技术层面的质疑:有评论者询问为何不基于 Ornith Next Flash 构建,并辩称虽然 Qwen 3.5 是强劲的基座,但相比最新替代品已被远远抛下。
RecursiveSI/flint (40B A2.5B) · Hugging Face(活跃度:784):RecursiveSI/flint 是一个发布在 Hugging Face 上的 Apache-2.0 协议 decoder-only MoE 编码智能体模型,总参数量 39.8B,但每个 token 仅激活约 2.5B 参数。模型共 49 层,每个 MoE 层有 256 个路由专家、每个 token 选中 6 个,采用滑动窗口与全注意力混合机制,官方标称 262k 上下文;Recursive 报告其在 Terminal-Bench 2.1 上得 54.9%、SWE-bench Pro v2 上得 89.7%、SWE-bench Verified 上得 74.2%,目标部署环境是 B300/H200 GPU 上的 SGLang 推理,并支持 OpenAI 兼容的工具调用。评论区有人认为它大致就是大家原本期待 Qwen 3.8 能给出的“35B-A3B”级别模型,但同时指出 Qwen3.8-27B 的存在让这次发布显得没那么惊艳;除此之外,评测截图是讨论的主要技术焦点。
评论者将 Recursive Flint 定位为一个仅激活 2.5B 参数的 40B MoE 模型,大致符合部分用户期待的“35B-A3B”级稀疏模型,但如今它要面对 Qwen3.8-27B 这类更新的小激活量 MoE 的竞争。讨论帖指出,如果没有 Qwen 的近期发布,这次发布本会被视为分量重得多的作品。
NVIDIA 在 GTC Berlin 的一份技术公告将 Flint 定位为针对 RTX Spark 优化的本地编码模型,声称在 64GB RTX Spark 上速度超过 220 tokens/s,并在 SWE-Bench Pro v2、Terminal-Bench 2.1、SWE-bench Verified 等智能体编码基准上表现出色:https://blogs.nvidia.com/blog/local-ai-gtc-rtx-dgx-spark-station-sync/
NVIDIA 表示 Flint 是用 Recursive 的 Eureka Machine 构建的,这是一个自动化的 AI 研究循环系统,会自主提出想法、实现、跑实验并决定后续方向。相关帖子称,该系统生成了专用 kernel,在不改动模型权重的情况下将 Flint 在 RTX Spark 上的生成速度提升了 55%,并提到模型采用 Apache 2.0 开源权重,支持通过 NeMo Automodel 的 SFT/LoRA 以及 NeMo RL 的 GRPO 进行后训练。

