
Science封面丨微软团队利用语言模型,在临床诊断中顺序推理
编辑丨&
临床诊断并不是一道信息完整的选择题。医生通常只能从患者最初的主诉和有限的体征出发,先形成几种可能的诊断,再决定追问哪些病史、安排什么检查,并根据结果不断修正判断。每一次检查都需要考虑诊断价值、经济成本和患者负担;什么时候继续收集证据或是下达结论,也同样重要。
2026 年 10 月 22 日,微软研究团队论文「Sequential diagnosis with language models」登上《Science》封面,介绍了一个用于评估分步诊断能力的基准 Sequential Diagnosis Benchmark(SDBench),以及名为 Diagnostic Orchestrator(DxO) 的诊断协调系统。
这项研究针对传统医学 AI 评测的一个局限:许多基准会直接提供完整病历、检查结果甚至关键线索,模型只需输出诊断。但这样的测试很难评估系统是否主动问对问题、避免不必要的检查,或能否在证据不足时继续调查。SDBench 把诊断重新设计成一场分阶段的信息收集过程,并同时记录最终诊断与检查开销。
论文链接:https://www.science.org/doi/10.1126/science.aeh7930
SDBench
为克服传统静态病历评测的局限,SDBench 将诊断重新设计成了一场分阶段的信息收集与决策过程。
研究团队引入了两大高质量病例来源:
第一组(304例): 来自《新英格兰医学杂志》(NEJM)临床病理病例讨论的复杂疑难病例,侧重极高的诊断难度与教学价值。
第二组(325例): 来自 MIMIC-IV-ED 数据库、由急诊就诊后收治入院的患者记录整理而成的病例,更贴近常规急诊的真实场景。
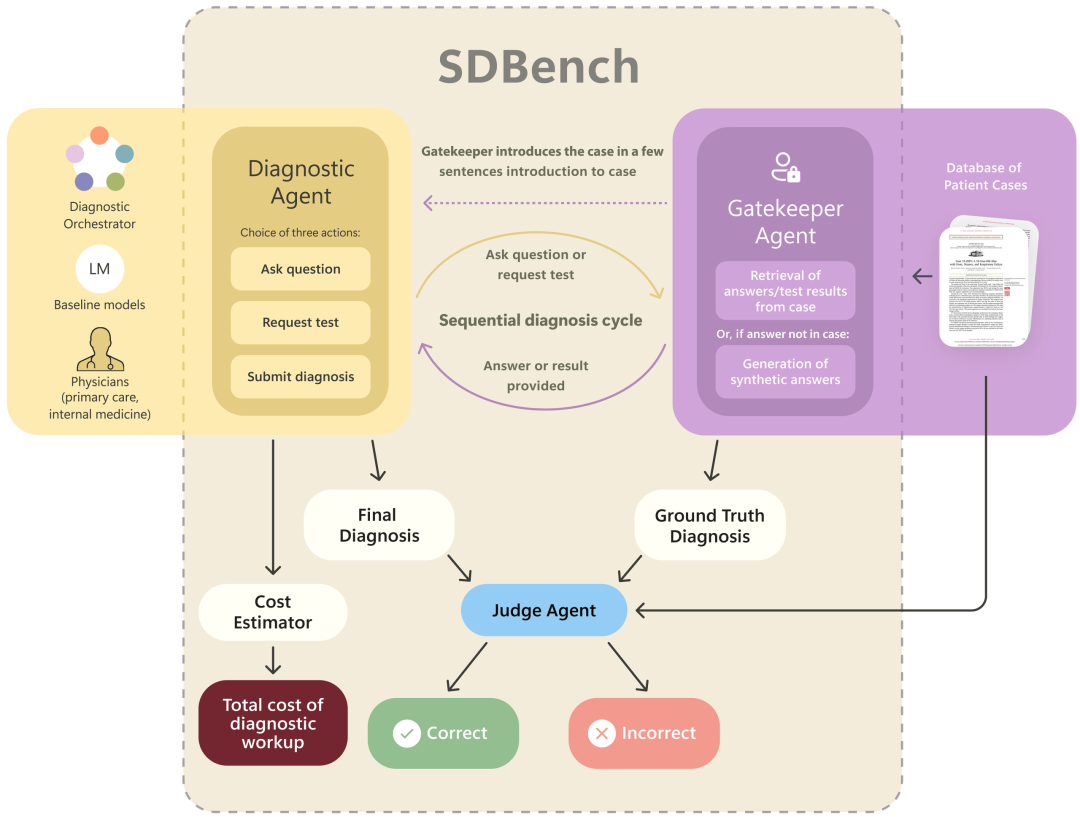
图 1:SDBench 中的编排。
每个病例都会先转换成一段不包含最终诊断的简短描述。随后,诊断者可以选择追问病史或体格检查信息、申请实验室和影像等检查,或直接给出诊断。
一个称为 Gatekeeper(信息把关智能体)的模型负责根据请求释放对应的病例信息,避免诊断者提前看到完整病历和答案。对于原始病例中没有记载的检查,系统也可以生成与病例背景一致的合理模拟结果,减少因某项信息缺失而泄露线索的风险。
DxO
DxO 是一种模型无关的编排器,通过模拟一群互补角色的临床专家,在每个步骤中融入成本意识的测试管理,并在独立运行中汇总诊断,实现顺序诊断。
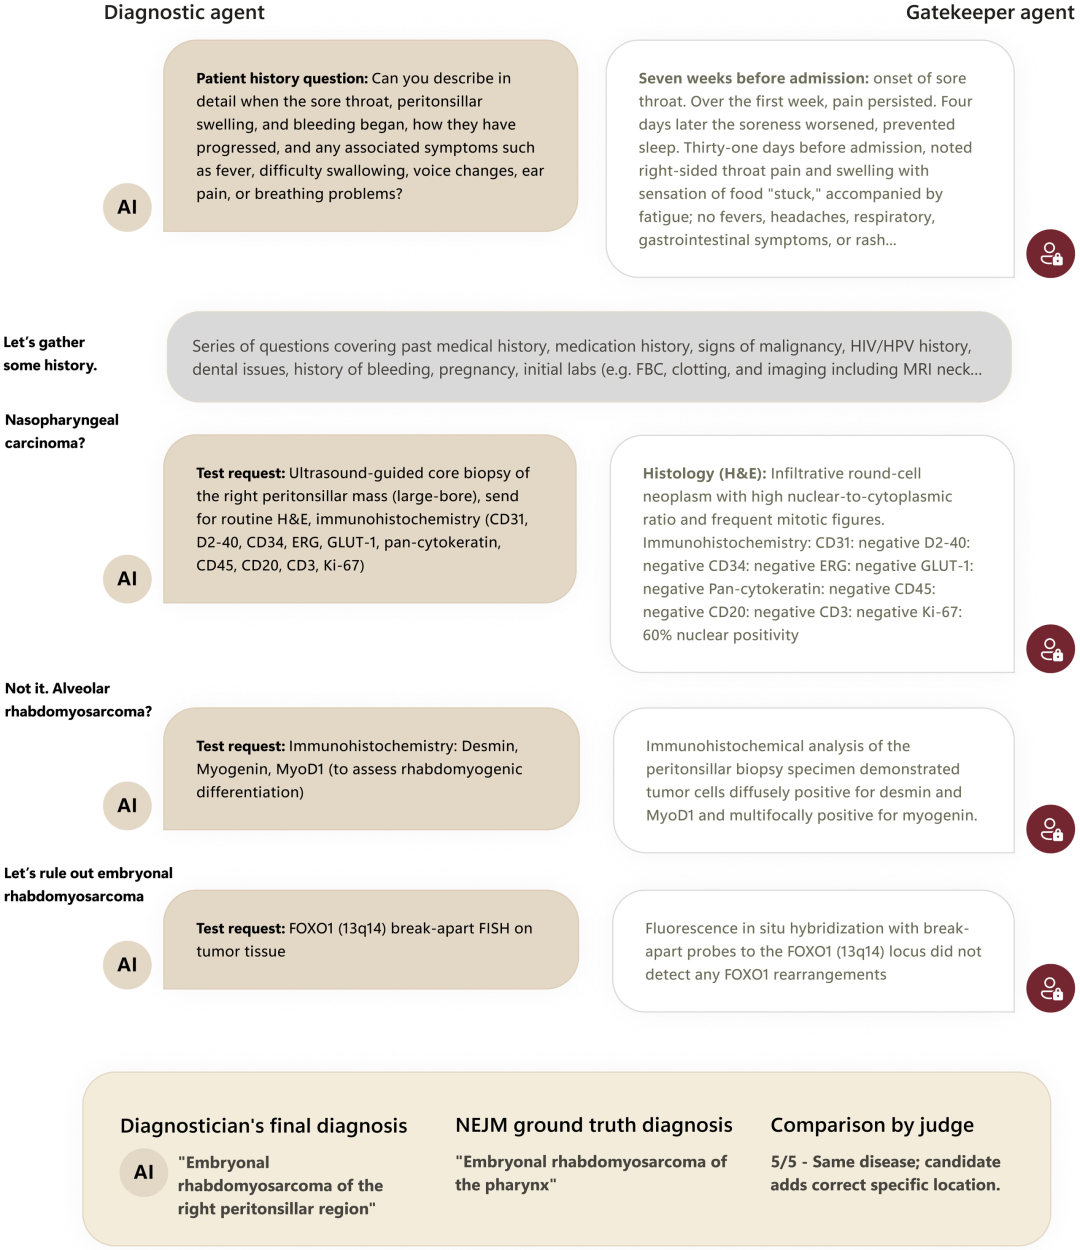
图 2:DxO 解决顺序诊断推理问题的示例。
研究中的主要结果使用 GPT-5 作为底层模型,并通过协调机制模拟多种临床推理职能:维护并更新鉴别诊断、选择有助于区分候选疾病的检查、质疑当前占主导地位的判断,并评估检查的成本与价值。
系统在获得新信息后更新诊断判断,再决定是否继续提问、申请检查或提交最终诊断。它还跟踪检查开销,使准确率与成本之间的取舍可以被明确评估。
这种编排方式希望缓解单次推理中容易出现的问题。例如,一旦系统过早倾向某种疾病,后续信息就可能被解释为支持原有判断;持续提出反证、重新比较候选诊断,可以帮助检查这种倾向。同时,如果两项检查的诊断价值相近,成本信息也能影响最终选择。
两类病例中的诊断准确率
在 304 例 NEJM 复杂病例评测中,DxO 的诊断准确率为 83.2%。参与比较的医生在不使用外部参考资料时,平均准确率为 22.3%;允许使用搜索和参考资料时为 36.1%。
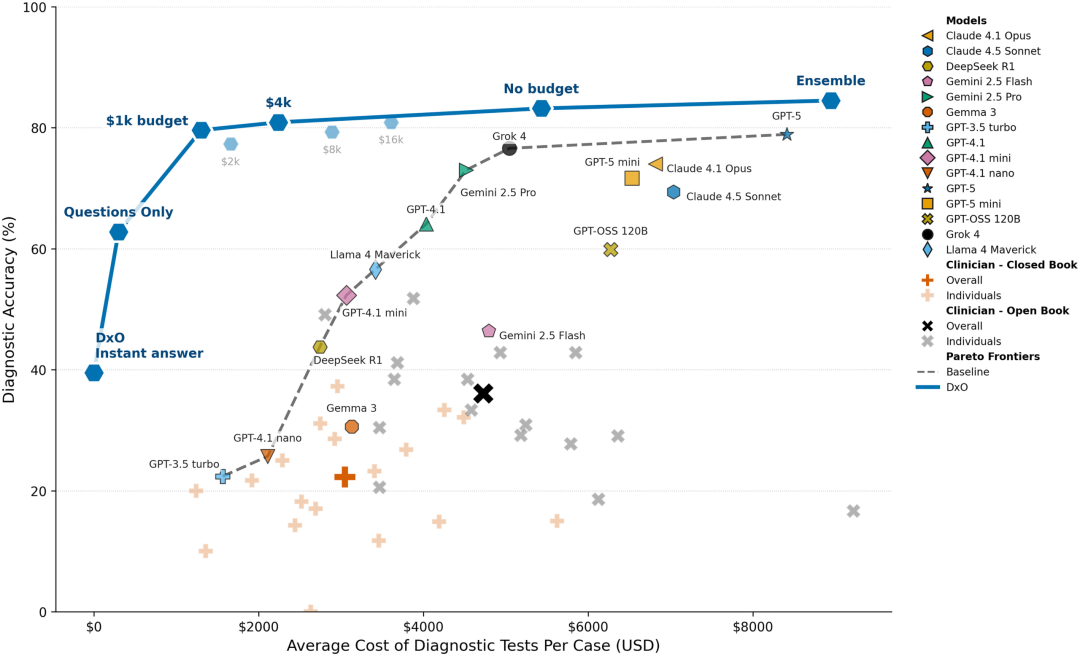
图 3: CPC 案例的性能与帕累托最优边界。
在另一组 325 例急诊就诊后住院记录中,DxO 的准确率为 80.3%,参与比较医生的平均准确率为 46.8%。在 NEJM 病例中,单名医生的最高准确率为 51.8%;在急诊病例中,表现最好的医生达到 62.5%。
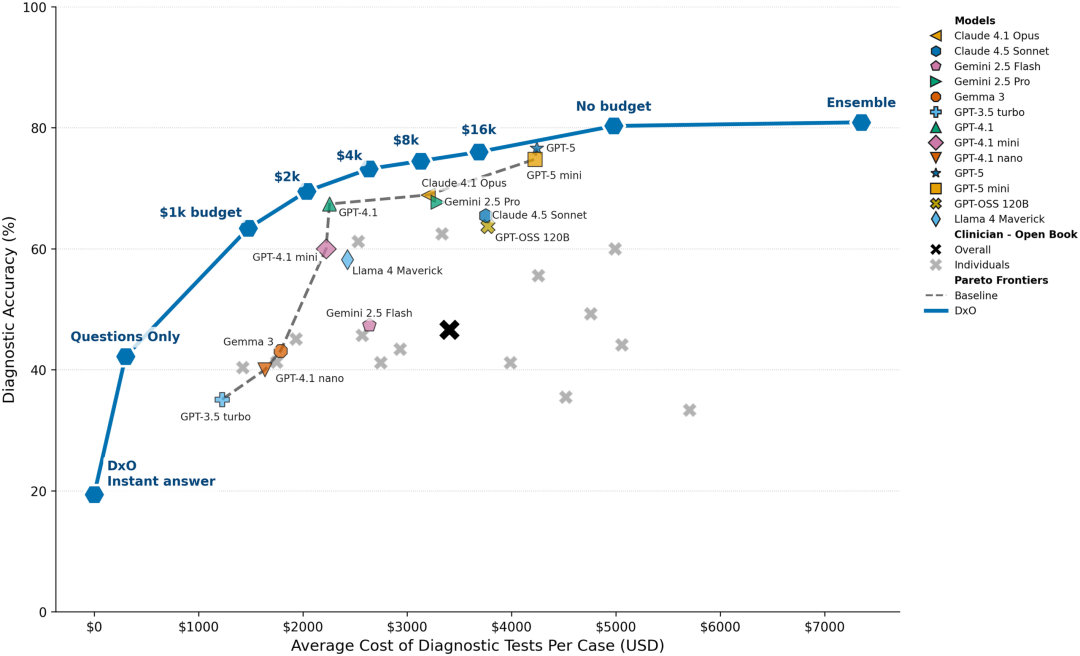
图 4:ED 案例的性能与帕累托最优边界。
在研究设定的分步诊断任务中,DxO 能够利用连续收集的信息,在两组病例上取得较高的诊断准确率。与一次性回答不同,系统必须主动决定哪些线索值得追查,因此评测同时涉及医学知识和信息获取策略。
但比较结果仍需结合实验条件理解。NEJM 病例经过选择,具有较高的教学价值和诊断难度,并不代表日常门诊中所有常见疾病的分布;MIMIC-IV-ED 这组数据也特指急诊后住院的病例。参与比较的是独立执业医生,不是针对每个病例组成的专科会诊团队。由此得到的准确率不能直接外推为系统在真实医疗环境中的整体表现。
准确率与费用之间的权衡
研究还表明,DxO 的检查费用取决于是否设置预算约束。在不限制预算的配置中,NEJM 病例的平均检查估算费用约为每例 5,431 美元,高于医生的 4,725 美元;急诊病例中,DxO 约为 4,979 美元,医生约为 3,400 美元。
设置预算后,系统会减少部分检查,并以一定的准确率下降换取更低的开销。在 NEJM 病例中,一种配置达到 80.9% 的准确率,平均费用约为 2,241 美元;另一种配置的准确率为 79.6%,费用约为 1,303 美元。在急诊病例中,预算配置分别达到 73.2% 的准确率和 2,634 美元费用,以及 69.5% 的准确率和 2,037 美元费用。
因此,研究并没有证明 DxO 在所有设置下都同时拥有最高准确率和最低成本。系统只是能在不同预算约束之下调整诊断策略,并展示准确率与检查开销之间的取舍。
前瞻性验证
SDBench 将诊断的中间过程纳入评测,让研究人员可以比较模型获取信息和选择检查的方式,这是医学 AI 评估的重要拓展。不过,它目前仍以文本病例为主,没有完整覆盖临床中常见的各类多模态信息,也无法完全重现患者遗漏病史、表述不清或检查结果延迟等现实情况。
此外,这项研究评价的是诊断阶段的表现,没有证明系统能够改善后续治疗方案、患者安全或最终健康结局。DxO 能够在回顾性病例中提出较准确的诊断,并不意味着它已经具备独立承担临床决策的能力。
微软表示,下一步将与 Beth Israel Deaconess Medical Center 合作,在医院环境中开展前瞻性研究,让患者直接与系统交互,并将系统表现与医生的独立评估进行比较。在多种测试环境中,该系统比人工响应者更准确,且总成本更低,展示了其作为辅助医生工具的潜力。