
介绍动态任务打包与 Ultracache
Coding agents 产生的变更量,已经超出了 CI 原本的承载能力。Anthropic 每天合并的变更从 5 月的约 2,500 个增长到 9 月的 30,000 多个,半年内测试数量增长了 10 倍,CI 任务增长了 25 倍。在 Linear,测试套件自 1 月以来几乎翻了四倍,每周新增的约 2,000 个测试大多出自 agent 之手。
用更快的机器来解决 CI 太慢的问题,确实有效,也是最省事的办法。但代码库越大,计算开销就越高。
你真正需要的,是基于真实执行数据来调度和缓存任务的 CI:
- Dynamic task packing - 把任务分配到任意数量的机器上,并让每台机器都跑满。
- Ultracache - 一个全自动的计算缓存,从实际运行中学习任务的输入和输出。
从今天起,这两项功能对所有用户开放。
VM 分钟数与机器利用率
给 CI 机器选配置时,你希望在保证运行稳定的前提下尽可能提高并行度。每次运行都有峰值,而峰值决定了并行度上限,也决定了机器需要多大。
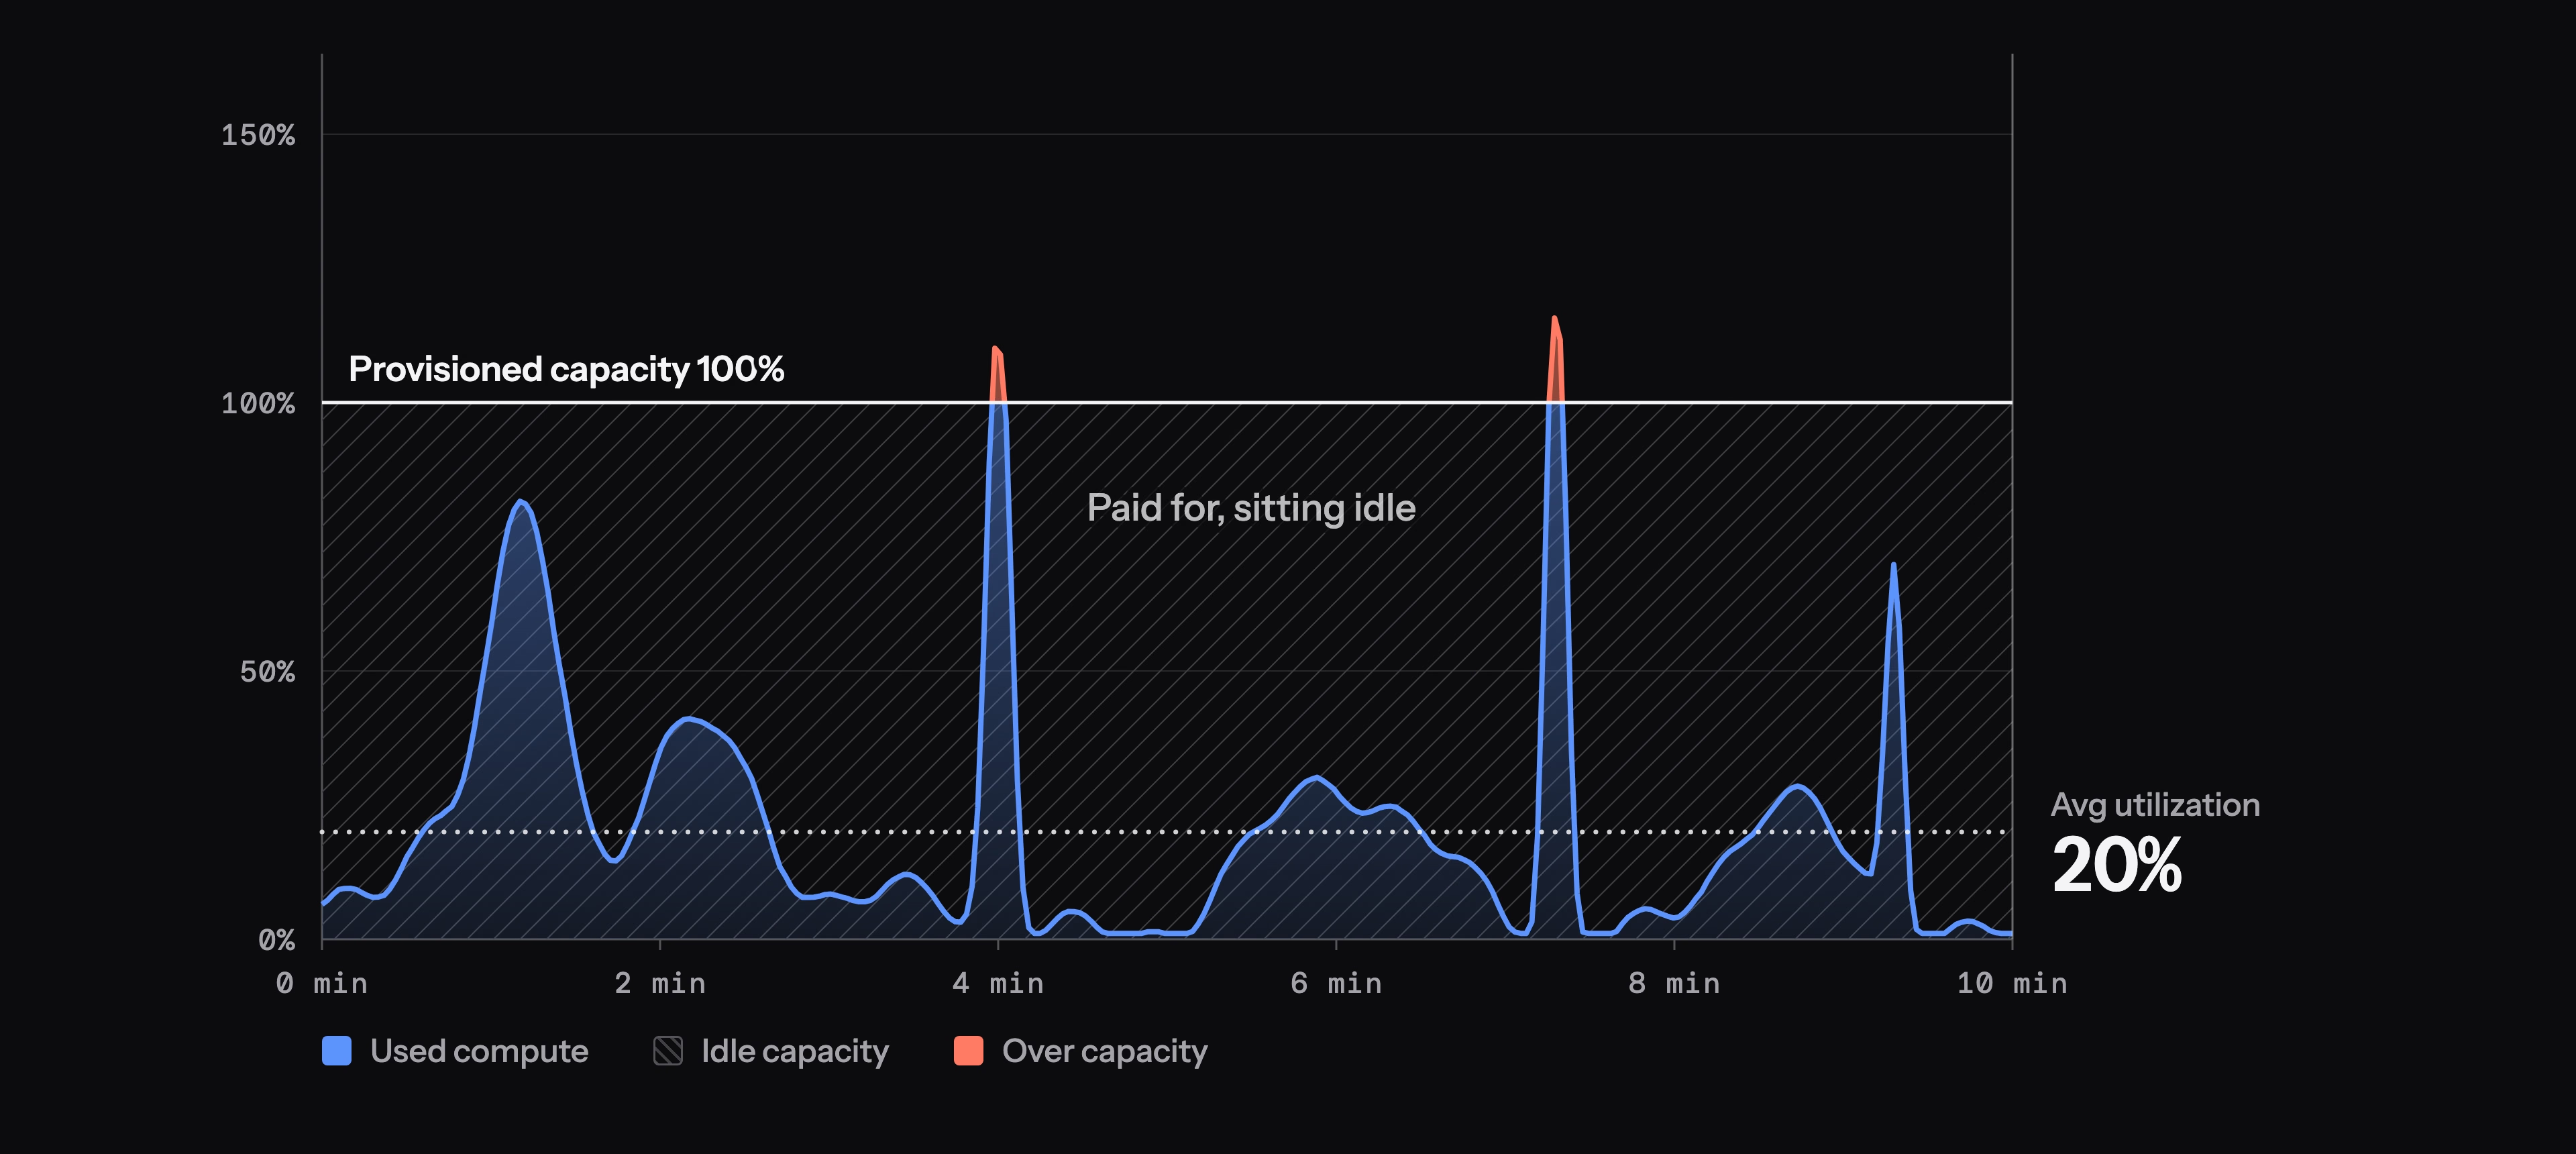
峰值并不是均匀分布的,所以大部分时间机器都处于低利用率状态。换更快的机器能整体缩短 CI 时间,但解决不了利用率问题。结果就是你为一台大部分时间都在闲置的高配机器买单。
这里需要理解的一点是:你付费的不是算力,而是 VM 分钟数。所以目标是把尽可能多的计算塞进你已经在付费的 VM 分钟里。
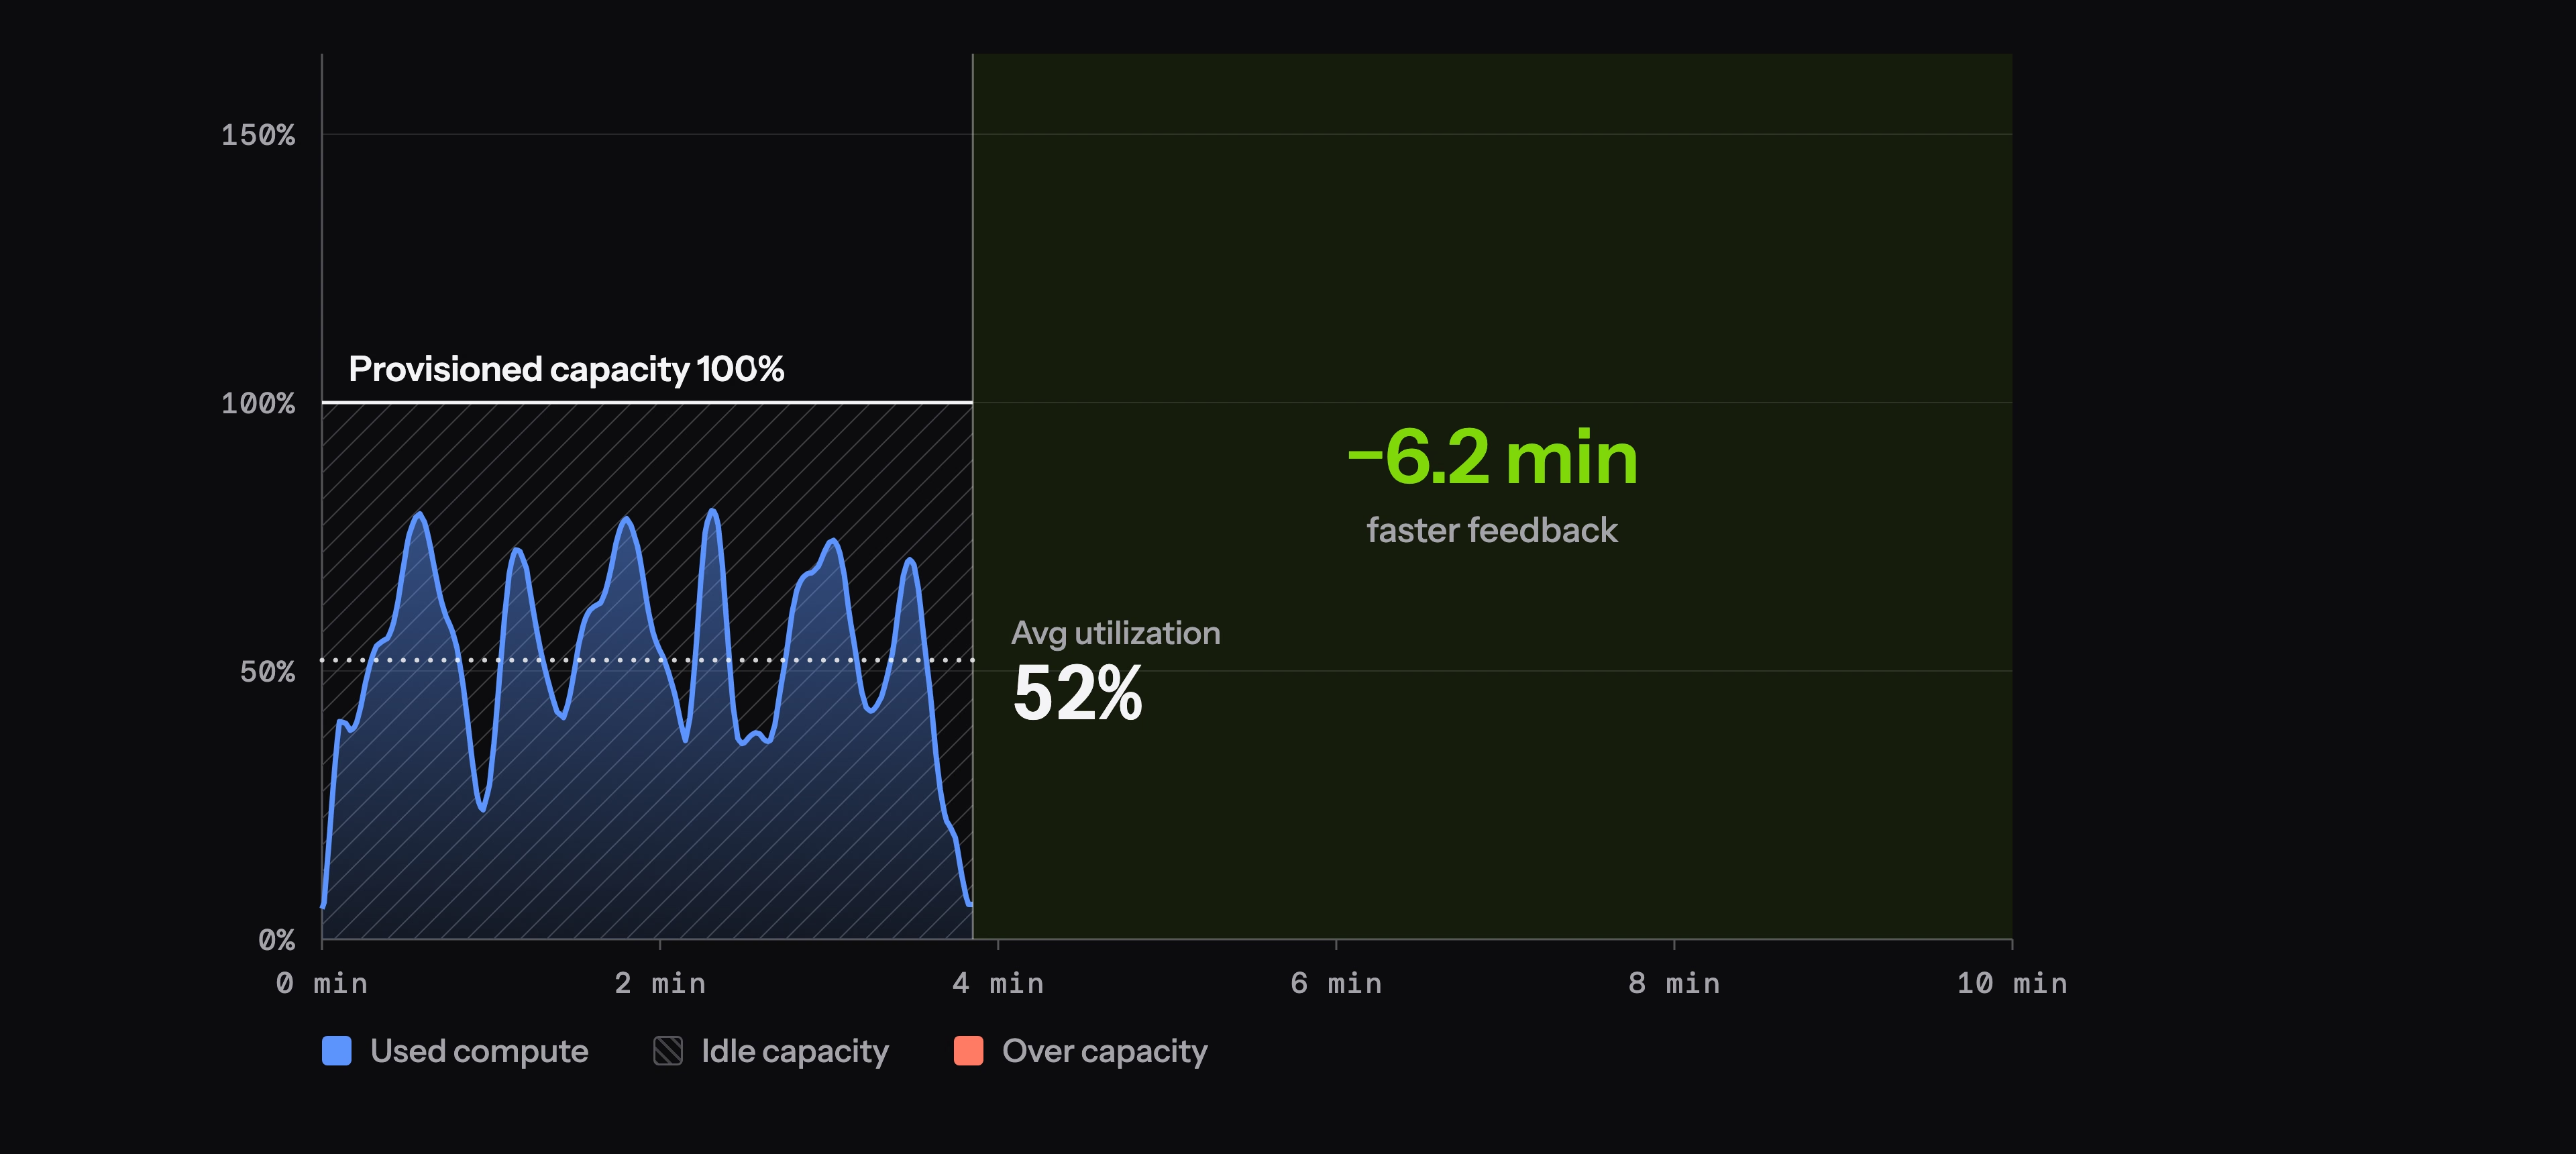
动态任务打包
大多数任务分发方案会预先把任务分配给机器,通常按类型划分:端到端测试分配给一台机器,单元测试另一台,构建再一台。这种方案是静态的——代码库变化时它不会自适应,也无法应对一个 PR 跑 10 个任务、下一个 PR 跑 200 个任务的情况。
动态任务打包则把整个 CI 运行当作整体来看待:
- 收集该次 CI 运行中所有需要执行的任务。
- 基于历史运行分析这些任务的资源特征(每个任务需要多少 CPU 和内存)。
- 根据任务的匹配程度和每台 worker 当时的可用容量,把它们打包到 CI worker 上。
- 按依赖关系确定任务优先级。能解锁其他任务的任务先跑,这样端到端测试所依赖的构建会被尽早调度,e2e 测试也能更早启动。

在一些真实的客户代码库(本身已针对 CI 深度优化过)中开启动态任务打包后,VM 分钟数减少了 35% 到 50%。
想深入了解动态任务打包的工作原理,请阅读文档。
减少工作量
提升利用率的作用有限。想更进一步,就得让 CI 少干活,有两条路可走:
- Affected(受影响检测)- 不可能被改动影响的任务就不跑。
- Remote caching(远程缓存)- 依赖没有变化时,任务就不重复跑。
昨天发布的 Nx 24 已将基于任务的 affected 设为默认行为。它会查看任务及其读取的输入和写入的输出,据此判断哪些内容受到了影响。
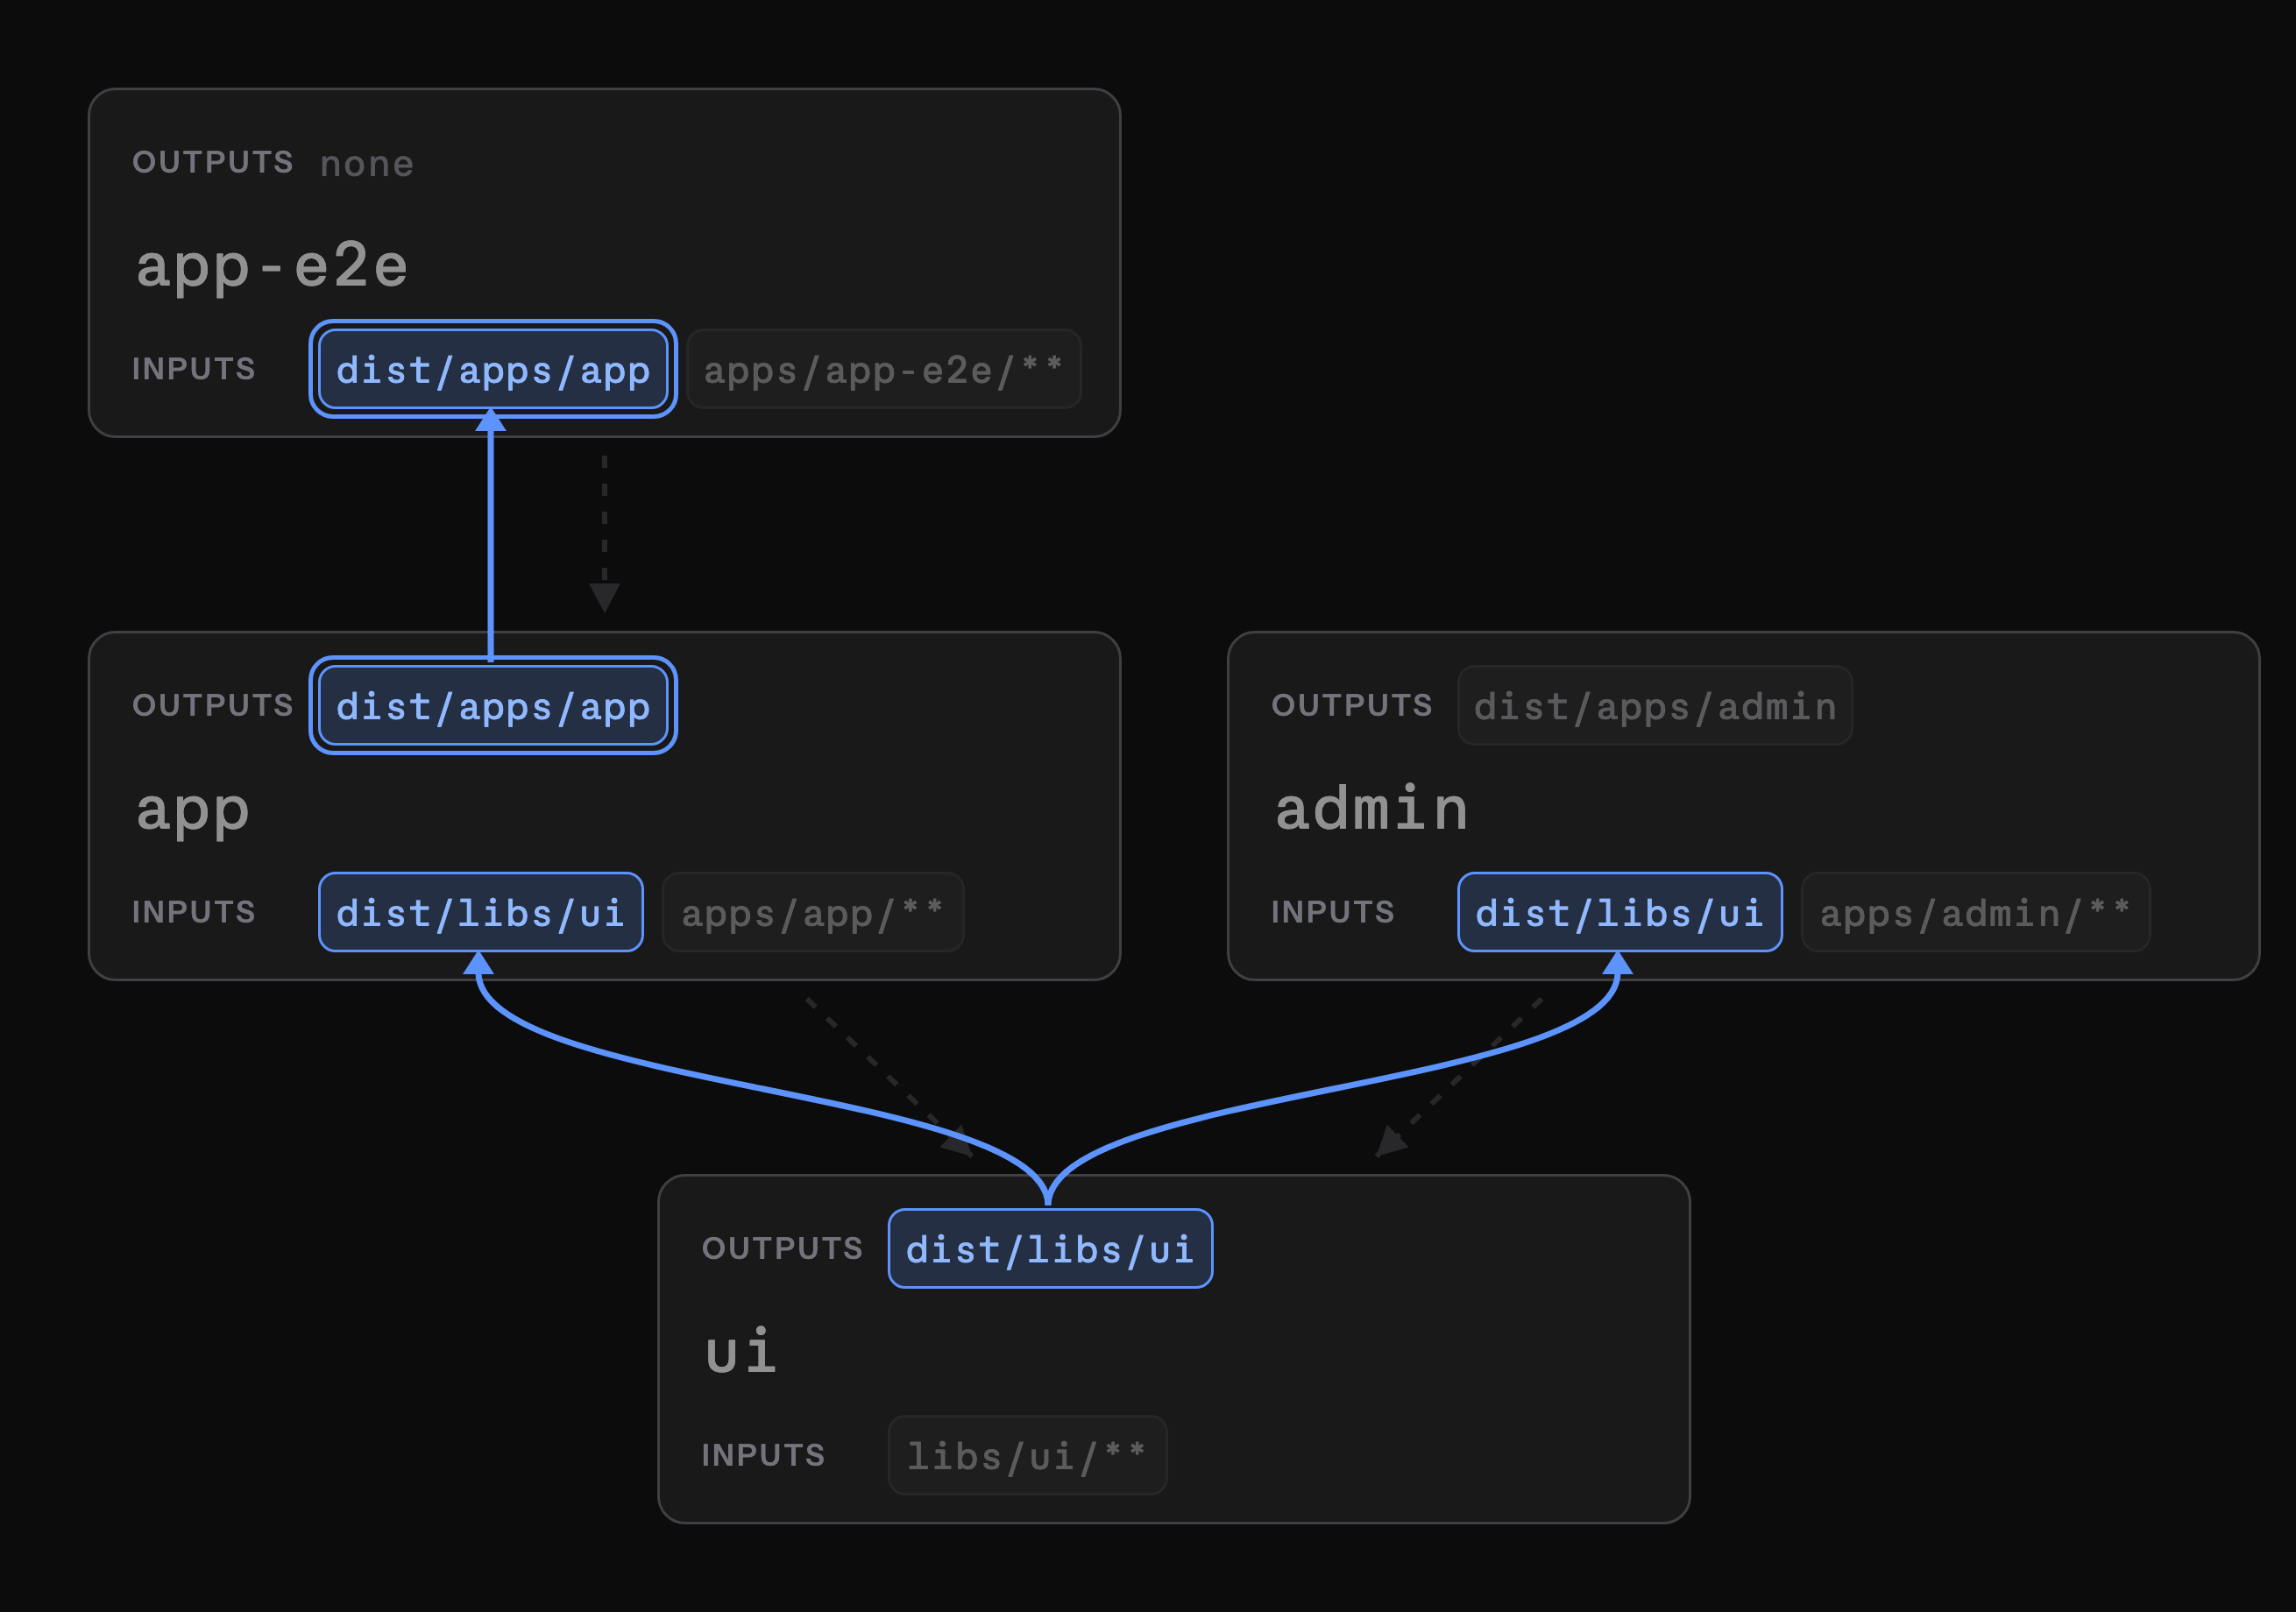
缓存计算哈希时用的正是同样的信息。如果你改动了共享项目里的一个 spec 文件,只有该项目的测试任务会失效,其余全部命中缓存。
而远程缓存是另一半拼图,我们刚把它做到了更好。
Ultracache
如今大多数缓存都是静态的:要么由工具从项目图谱推导出缓存配置,要么由你手动定义并微调每个任务的输入和输出。
这带来两个问题。
- 缓存命中率很大程度上取决于代码库的结构,以及配置的输入输出与任务实际读取内容之间的吻合程度。
- 更糟的是,可能出现误报——也就是本不该命中却命中了的缓存。
Ultracache 是一个全自动、确定性的计算缓存。它从实际运行中学习缓存配置,不仅带来更高的命中率,还从设计上保证了正确性。
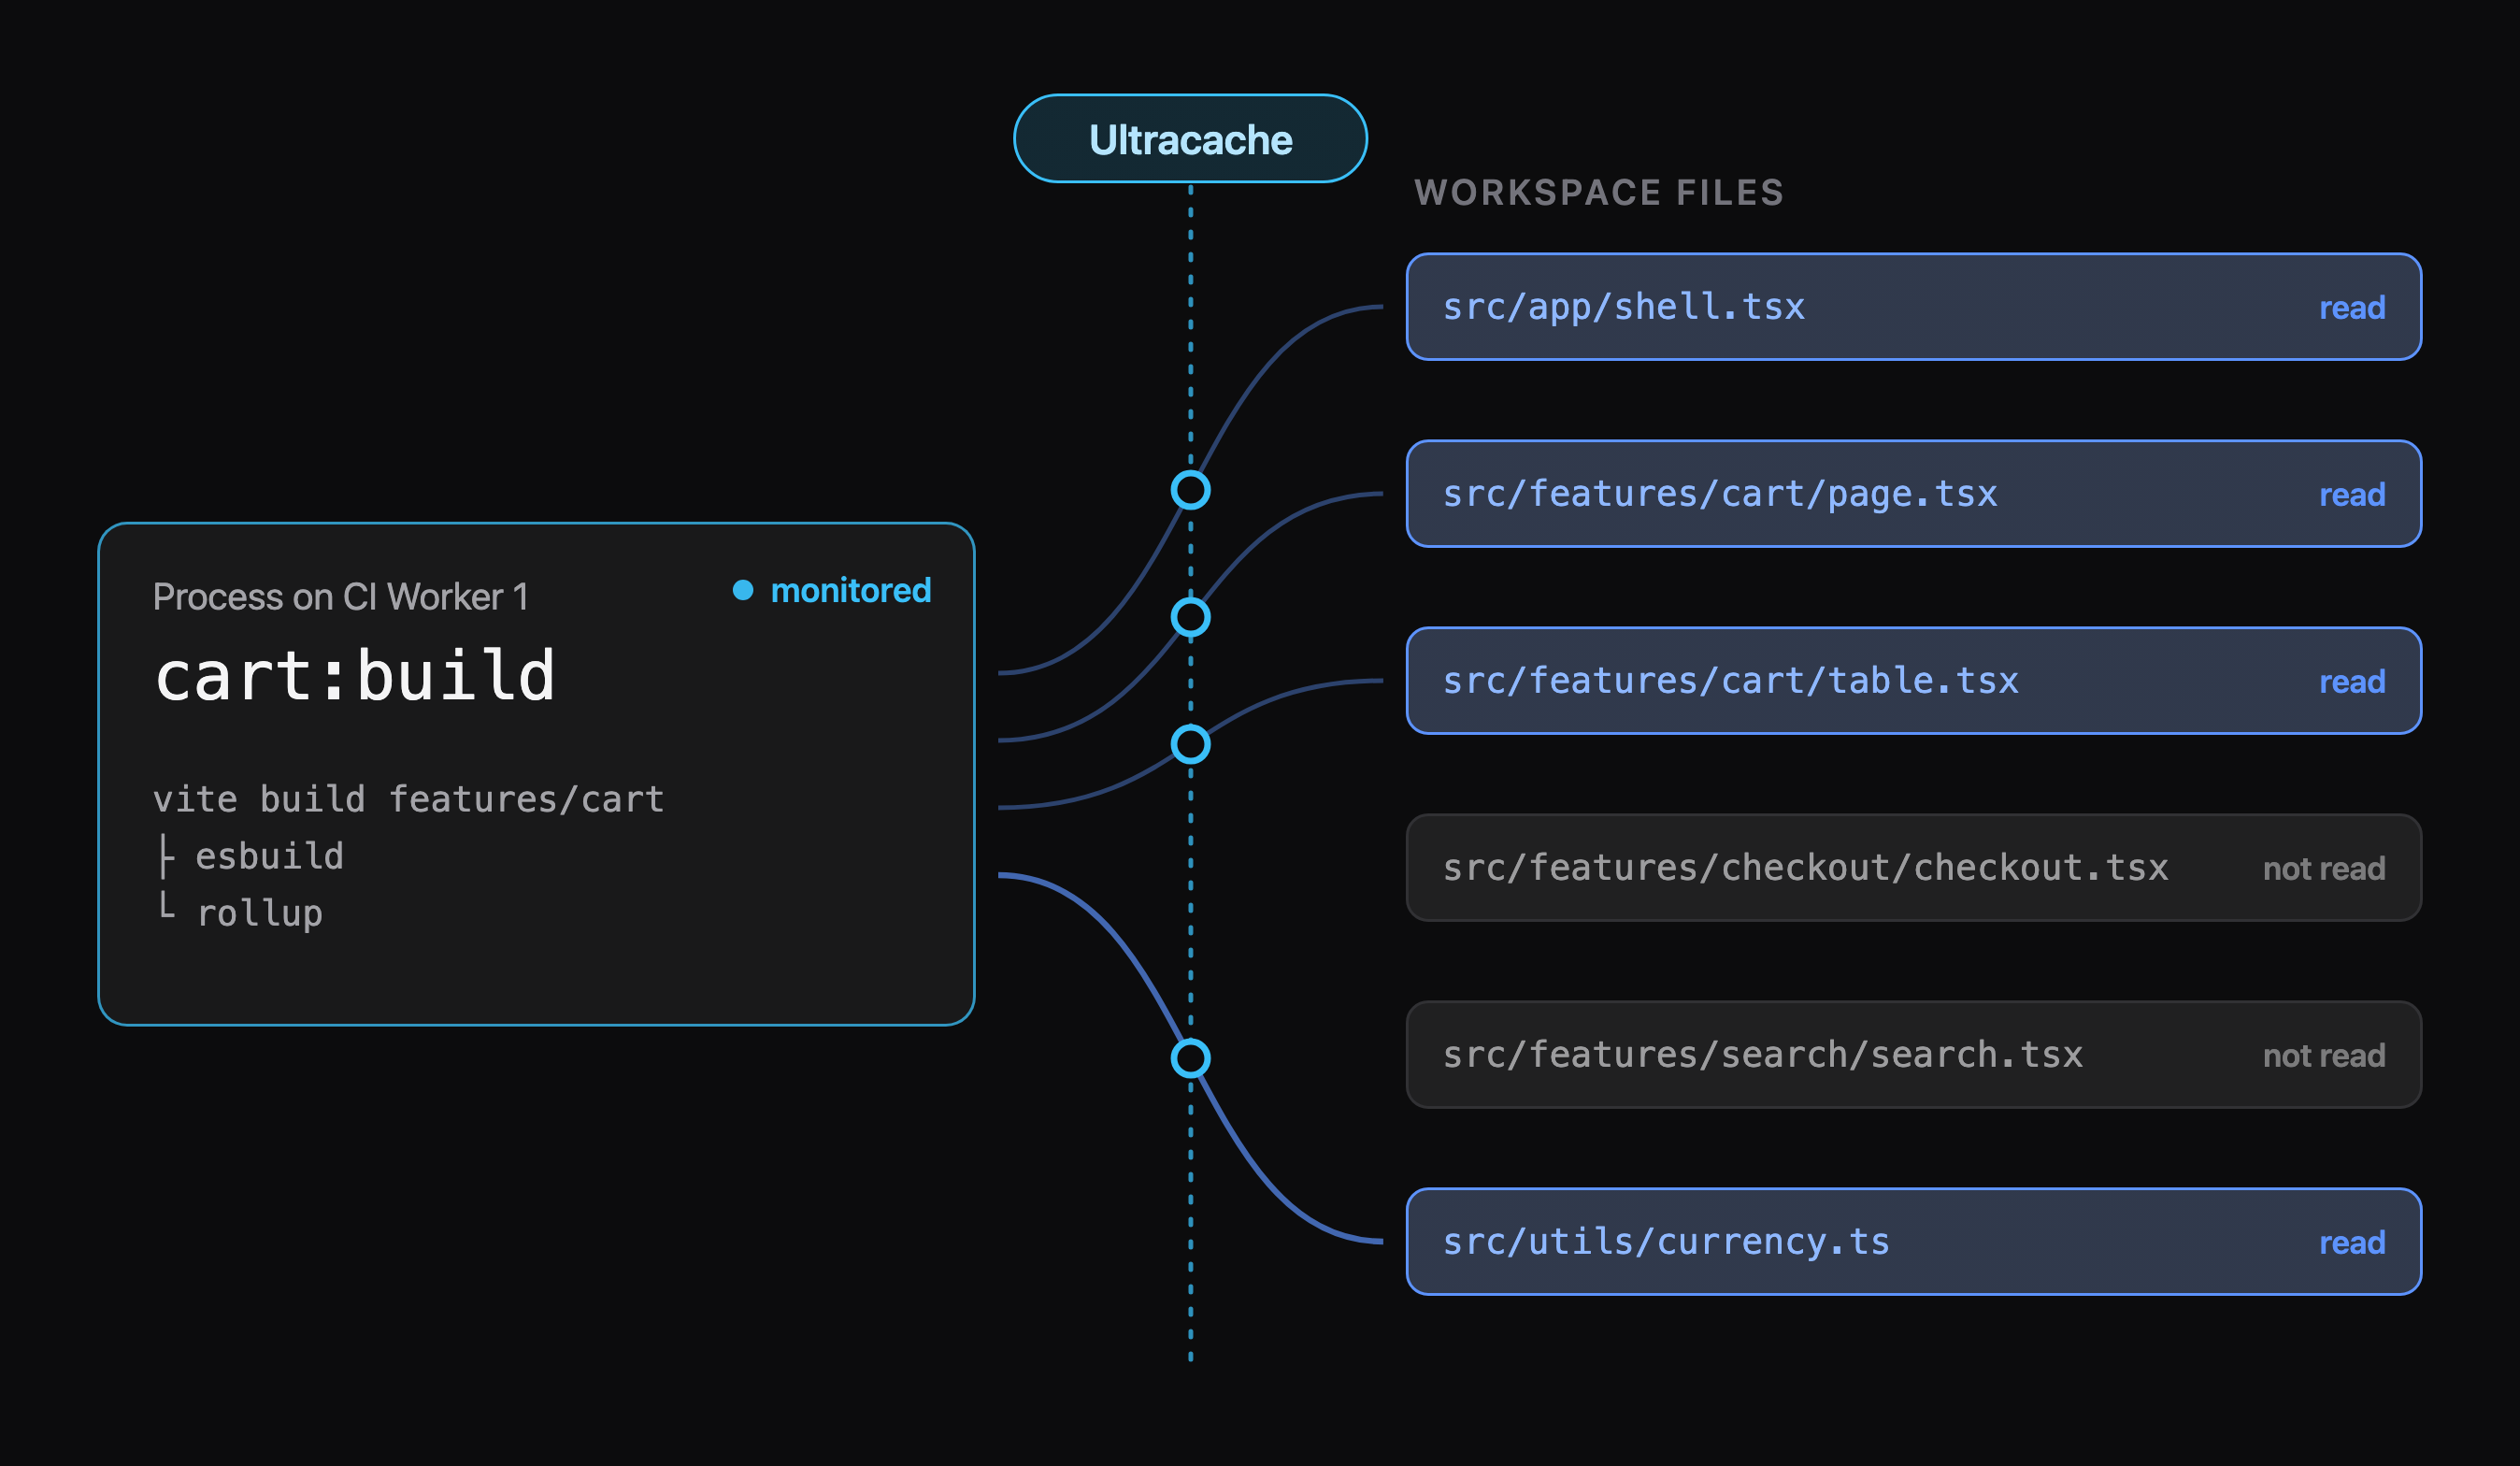
Ultracache 会在任务执行时监控它读写了哪些内容,把这些输入输出记录下来,并与之前运行中积累的信息合并。你的缓存配置会随着每次运行不断优化,无需任何手动微调。
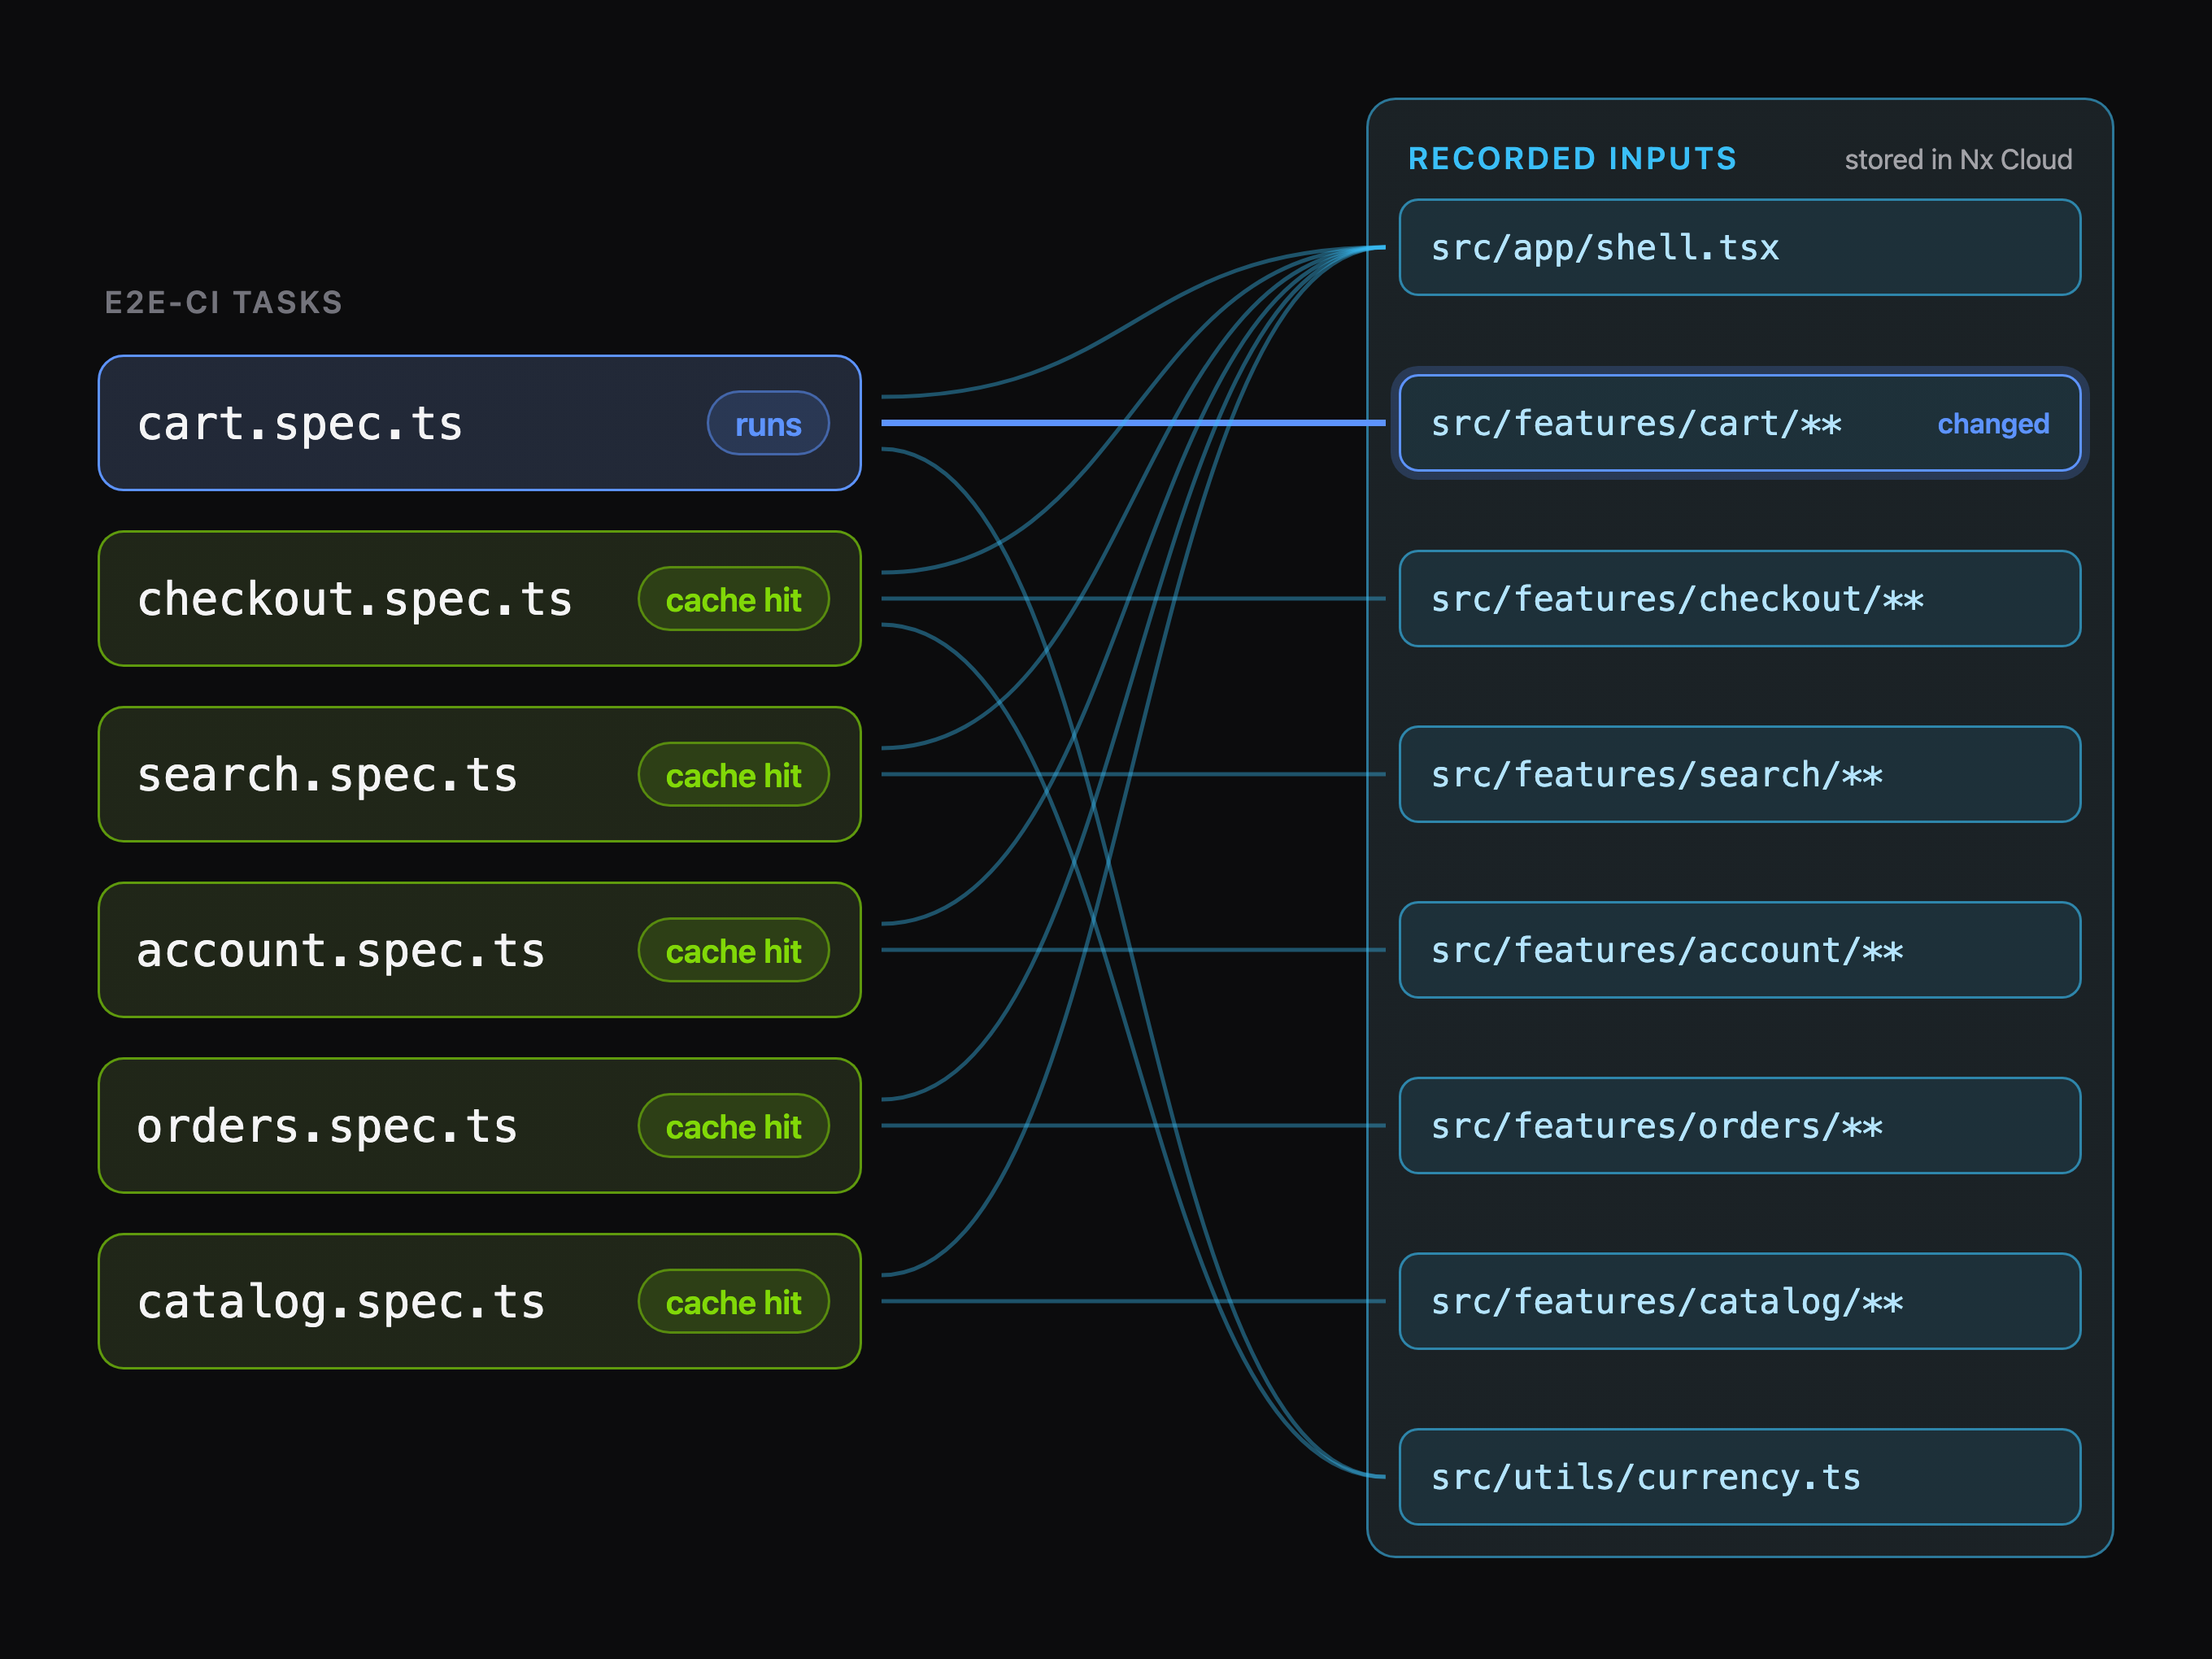
如今 AI agent 会写大量测试,尤其是端到端测试,这让这件事变得更加重要。Nx Cloud 已经能把一个大型端到端测试 target 拆分成按 spec 文件为单位的独立任务。Dynamic task packing 会把这些任务分配到各个 CI worker 上,保证高利用率;Ultracache 则会逐一缓存每个任务的结果——这样一旦有变更,只有依赖它的 spec 文件会重新运行,其余全部命中缓存。
结合基于任务的 affected、dynamic task packing 和 Ultracache,我们那个包含 511 个项目的 monorepo 基准测试中,CI 提速 9.2 倍,算力消耗降低 52%。
由于 Ultracache 依赖真实的执行数据,它与代码的组织方式无关。如果你的仓库里只有一个大型应用,项目级缓存帮不上什么忙,因为任何变更都会让整个项目的缓存失效。我们在一个约 30 万行代码的 React 单体应用上跑了同样的配置,结果 CI 提速 11.7 倍,算力消耗降低 78%。
新建的 workspace 默认启用 Ultracache。已有 workspace 可以在 workspace 设置中开启,详情请阅读文档。
面向 AI Agent 的真正智能 CI
Dynamic task packing 和 Ultracache 都建立在同一个理念之上:由真实执行数据驱动的 CI。Packing 让同样的算力跑在更少的 VM 分钟里,Ultracache 则从设计上让缓存更精准、更可靠。最终效果是 CI 更快,而你的算力账单不会膨胀。
这两项功能现已在 Nx Cloud 上线。