
使用 IBM Granite 时间序列模型进行集成预测
四个开源的 Granite 模型,一个可扩展的预测接口,从此省去猜该用哪个模型的麻烦。
预训练时间序列模型无需在你的数据上训练就能直接预测,但前提是你得选出一个合适的。擅长处理平稳工业信号的模型,在处理嘈杂的零售需求或长期季节性预测时可能就会水土不服,而最佳选择取决于具体的序列和任务。
Granite Timeseries Ensemble 将这种选择简化为一个合理的默认选项。该配方融合了四个互补的 Granite 架构,直接返回中位数和分位数预测,无需重新训练,也不涉及任何拟合后的集成权重。你可以从概率集成(等概率池化)起步,对比自适应的 IQR(四分位距)集成,再用兼容的预测器在同一接口上做扩展。该集成配方及其默认的 Granite 成员均采用宽松许可证发布。
熟悉天气预报的话,对这种思路并不陌生。像 集合预报这样的方法,会探索多种可能的结果;北美多模式集成(North American Multi-Model Ensemble)等系统也会结合不同模型来做季节预测。时间序列预测同样受益于此:互补的模型对“接下来会发生什么”提供不同视角,集成则把这些视角融合成一个预测结果。
试用 Granite Timeseries Ensemble
安装 Granite TSFM,然后直接从 Hugging Face 加载推荐的四模型配方:
pip install "granite-tsfm>=0.3.11"
import pandas as pd

from tsfm_public.models.ensemble.modeling_ensemble import QuantileEnsembleForecaster

df = pd.read_csv(
    "https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv",
    parse_dates=["date"],
)

ensemble = QuantileEnsembleForecaster.from_pretrained(
    "ibm-granite/granite-timeseries-ensemble-r1",
)

result = ensemble(
    df.tail(1024),
    timestamp_column="date",
    target_columns=["OT"],
    context_length=1024,
    prediction_length=24,
)

print(result.prediction_outputs) # point forecast
print(result.quantile_outputs)   # quantiles
该配方存储的是集成配置,而非合并后的模型权重。它会在运行时下载四个成员检查点,因此首次运行时需要预留额外时间。关于完整配置、成员检查点、评估细节及局限性,请参见模型卡片。
result.prediction_outputs 包含点预测值,而 result.quantile_outputs 包含分位数预测值,默认范围从 0.1 到 0.9。应用可以将点值用作中心预测,并选择特定分位数来表述预测区间。例如,0.1 和 0.9 分位数定义了一个具有 80% 名义覆盖率的中心预测区间。
集成成员
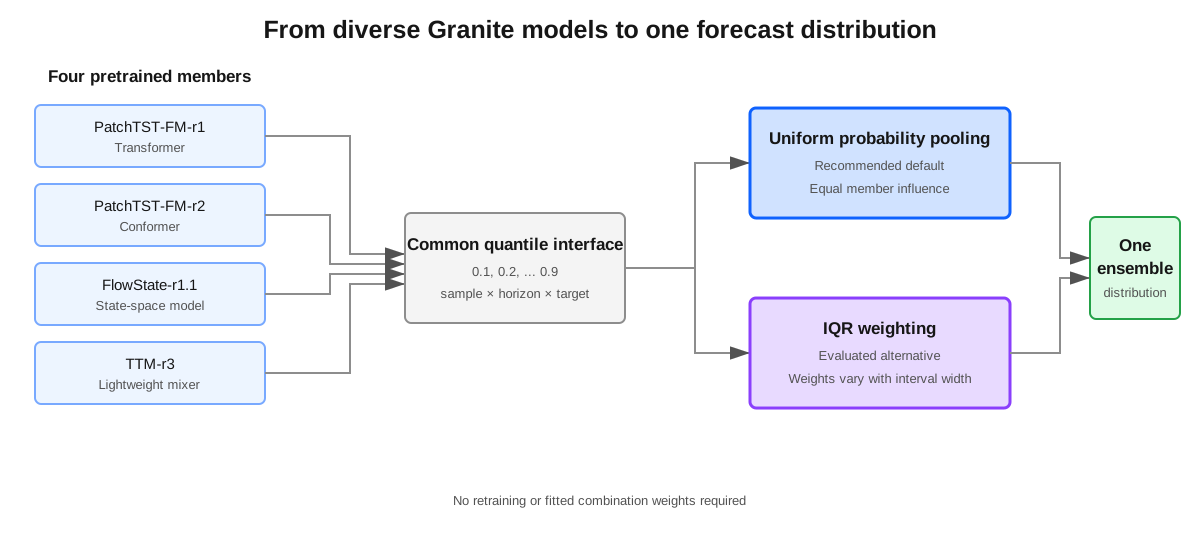
默认配方结合了四个具有不同架构的预训练 Granite 模型:
| 模型 | 架构 |
|---|---|
| Granite PatchTST-FM-r1 | Patched Transformer |
| Granite PatchTST-FM-r2 | Patched Conformer |
| Granite FlowState-r1.1 | 状态空间模型 |
| Granite TTM-r3 | Tiny Time Mixers (MLP mixer) |
有关背景信息,参见PatchTST-FM-r1 论文、 PatchTST-FM-r2 架构概览、 FlowState 论文以及 Tiny Time Mixers 论文。
这些架构以不同方式捕捉趋势、季节性和局部变化,因此它们的误差未必重合。一篇关于预测组合的 50 年综述描述了预测组合如何降低选错单一模型的风险,同时强调成员质量和多样性仍然至关重要。
两种组合预测结果的方式
每个成员模型都会输出分位数预测。两种主要方案采用不同的规则,把这些预测整合成一个预测分布及其中位数。
概率集成(Probabilistic Ensemble):推荐的默认方案
概率集成(即等概率池化)让每个成员拥有相同的话语权,在概率空间中对各成员的分位数预测进行池化,再从合并后的值中提取所需的分位数。由于权重是固定的,既不需要拟合步骤,也没有需要针对新序列调节的权重超参数。
预测组合悖论(forecast combination puzzle) 提供了一个很好的思路来源:在点预测中,简单的等权组合往往能与基于估计权重的方法相抗衡。这一方案把同样的等权思想应用到了概率预测上。它也是上面示例中默认加载的方案。
IQR 集成:一种自适应的替代方案
IQR 集成根据各成员的预测离散程度来分配权重,区间越窄权重越大。它会用 25% 和 75% 分位数附近最接近的可用分位数来近似每个成员的四分位距。权重会随样本、目标和预测步长而变化,而且和概率集成一样,不会基于历史预测误差做任何拟合。等保序回归(isotonic regression)则确保合并后的分位数不会出现交叉。
但区间更窄并不一定意味着预测更准确或校准更好,IQR 加权可能会偏向过度自信的成员。如果你想尝试这个方案,它提供了一个 temperature 参数(值越大,权重越趋向均匀),还可以选择为单个成员的权重设置上限。
只需修改子文件夹即可加载经过评估的 IQR 方案:
ensemble = QuantileEnsembleForecaster.from_pretrained(
    "ibm-granite/granite-timeseries-ensemble-r1",
    subfolder="recipes/granite-iqr",
)
该选哪种方法?
| 你的目标 | 建议从……入手 | 原因 |
|---|---|---|
| 简单默认配置 | 概率集成(Probabilistic Ensemble) | 各成员影响力相等,不拟合权重 |
| 基于预测离散度的自适应加权 | IQR 集成 | 影响力随各成员的预测离散度变化 |
建议从概率集成入手。如果预测的离散度在你的应用场景中具有较高的参考价值,请在代表性数据上对比 IQR 集成的表现,因为预测精度和校准度取决于具体的时间序列及预测周期。
集成效果是否优于单模型成员?
我们在 97 项 GIFT-Eval 数据集配置上对两种集成方法进行了评估。模型未做微调,且测试目标数据未用于筛选或拟合集成方法。此处对比了官方集成提交结果与四个基础模型的成绩,排名依据 2026 年 10 月 20 日截取的公开排行榜数据。
GIFT-Eval 使用 MASE 评估点预测,使用 CRPS/MWQL(基准测试中的 mean_weighted_sum_quantile_loss 指标)评估概率预测。分数经过季节朴素法归一化,并在各配置间取几何平均值。数值越低代表表现越好。
| 预测模型 | MASE ↓ | MASE 排名 ↓ | CRPS / MWQL ↓ | CRPS 排名 ↓ |
|---|---|---|---|---|
| Granite Ensemble R1 — 概率版 | 0.683★ | 47.175★ | 0.471 | 50.948 |
| Granite Ensemble R1 — IQR 版 | 0.684 | 48.773 | 0.471 | 47.619★ |
| Granite PatchTST-FM-r2 | 0.685 | 51.371 | 0.467★ | 48.918 |
| Granite FlowState-r1.1 | 0.701 | 66.474 | 0.490 | 69.485 |
| Granite PatchTST-FM-r1 | 0.717 | 74.794 | 0.488 | 68.134 |
| Granite TTM-r3 | 0.724 | 83.062 | 0.520 | 88.959 |
★ 表示上述预测模型中的最佳值。数值越低越好。
排名列计算的是相对于完整 GIFT-Eval 参考排行榜各配置的平均排名,而非仅基于上述六种预测结果,因此随着排行榜新条目的增加,排名数值可能会发生变动。
两种集成方法在总体 MASE 和平均 MASE Rank 上均优于四个单独成员。概率集成(Probabilistic Ensemble)取得了六项预测中最低的 MASE 值:0.683,略低于 PatchTST-FM-r2 的 0.685。较低的平均 MASE Rank 表明在 GIFT-Eval 多样化的数据集配置下,相对点预测性能更强。总体而言,这些结果支持将集成方法作为实用的起点,无需开发者提前选定最强的单个架构。相对于最佳单个成员的 MASE 优势并不显著,因此集成的主要优势在于鲁棒性:无需预先知道哪种架构适合你的数据,即可获得同等甚至更优的总体精度。
PatchTST-FM-r2 仍保持最低的总体 CRPS/MWQL 得分。在上述六项预测中,IQR 集成取得了最低的平均 CRPS Rank,而概率集成在该指标上排名落后于 PatchTST-FM-r2。因此,总体误差和平均排名分别倾向于不同的选择。
在 2026 年 10 月 20 日的对比中,集成方法在 MASE Rank 和 CRPS Rank 上均排名第三(在合格系统中)。下图展示了这两种集成方法以及每个指标下排名前十的合格参考系统。部分系统(包括被排除的微调或非宽松许可条目)得分优于两种集成方法,因此集成的价值并非在于登顶排行榜。其价值在于,通过单一默认设置即可在多个序列上提供强大且一致的结果,无需选择特定成员。

图:2026 年 10 月 20 日 GIFT-Eval 平均排名情况,展示了两种 Granite 集成以及每个指标下排名前十的合格参考系统。合格系统具备复现代码且未声明测试数据泄露;微调条目及存在已知非宽松许可或成员依赖的系统已被排除。排名数值直接取自发布的总体排行榜快照;过滤机制改变的是显示的系统,而非其排名数值。
将方案扩展至其他预测器
默认配方使用四个 Granite 模型,但通用的 Forecaster 接口同样支持兼容的外部模型。你可以调整成员组合或聚合方式,下游预测格式保持不变,无需合并或重新训练成员 checkpoint。这让集成方案更容易接入现有的预测体系,也能随着需求变化加入适合你业务领域的预测器。
仓库中还包含扩展配方,加入了 IBM Research 的 checkpoint。这些模型附带单独的许可条款,包括非商业和研究用途限制,使用前请务必查看各成员的模型卡片。
无论采用哪种新组合,都应评估预测兼容性、准确率、校准、延迟和许可情况。
在你的应用中评估配方
GIFT-Eval 是一个覆盖面很广的基准测试,但整体提升并不意味着每条序列都能受益,平均排名也无法证明校准效果。想了解这些配方在你的应用中的实际表现,最直接的方法就是在有代表性的数据上做回测:
- 贴合你的用例。使用能反映各预测起点可用数据的历史预测窗口、你所需的预测跨度,以及你预计要服务的序列。
- 公平对比。在相同的窗口上运行 Probabilistic Ensemble、IQR Ensemble 和一个较强的单模型(如 PatchTST-FM-r2)。
- 不要只看点误差。除 MASE 外还要评估 quantile loss,并检查 0.1 到 0.9 区间的实际覆盖率是否达到名义上的 80%。
- 衡量成本。记录运行时间和内存占用,判断四个模型组合带来的收益是否值得为你的工作负载付出这些代价。
还有两点局限需要留意。当前配方对各多变量通道独立预测,没有利用跨通道信息;同时它需要加载四个成员 checkpoint,相比单一模型会增加推理时间和内存占用。各成员的上下文长度限制、预测跨度、预处理方式和缺失值处理也不尽相同,而且两种聚合方法都无法保证在分布偏移下的校准或鲁棒性,因此部署后仍需持续监控预测结果。
在你的数据上试用
建议从默认的四模型配方入手:
加载默认配置,通过单次调用即可获取四种 Granite 架构的中位数和分位数预测结果,并根据实际需求调整该配置。