
什么是模型蒸馏?开发者入门指南
纵观历史,知识的传承形式多种多样。在古代美索不达米亚(今伊拉克地区)发明文字之前,法律、历史、神话、歌曲等各类信息都依靠口耳相传的方式在代际间延续,主要手段是指令传达或讲故事,尤其是民间传说和历代发生的重大事件。
另一种常见的知识传递方式是师生之间的传授,无论正式或非正式。历史上有许多这样的例子:《圣经》记载,耶稣在传道生涯期间,日复一日地教导他的十二名门徒。苏格拉底教导了柏拉图,柏拉图后来在雅典创立了学园,并在此教导亚里士多达二十年。亚里士多德随后革新了科学、逻辑学和政治学,而这样的传承并未就此止步。
二十一世纪的一个例证就是深度学习 AI 的发展谱系。在二十世纪的人工智能寒冬期,当神经网络被认为是一条死路时,正是这种师生传承保持了这一梦想的延续。
被誉为“AI 之父”的 Geoffrey Hinton 曾主持一个实验室,培养了 Yann LeCun、Ilya Sutskever 等人。Yann LeCun 后来发明了卷积神经网络(CNN),而 Ilya Sutskever 联合创立 OpenAI,之后离开并创立了 Safe Superintelligence Inc。
虽然人类之间的知识传递概念广为人知,那么机器到机器的知识传递又该如何理解?这就是“模型蒸馏”。
本文将对模型蒸馏的原理进行详细拆解,探讨其常用技术,并带你逐步使用 PyTorch 从零开始实现模型蒸馏。
通过本文,你将学会如何训练更小型、高效的模型,并了解蒸馏技术与量化、剪枝等其它压缩技术的对比。
本文将涵盖
前置要求
要跟随本文进行实践,你需要具备以下条件:
GitHub 仓库:项目的完整代码可在这里找到,请克隆仓库以便逐步跟进。
熟悉 Python 基础及面向对象编程概念(例如操作类)。
了解深度学习基础。你需要理解 epoch(训练轮次)、前向传播、损失函数等概念。
PyTorch 基础:虽然我会解释代码的每个部分,但熟悉 PyTorch 张量和训练循环会更有帮助。
开发环境:你的机器上应已安装 Python。我使用 Visual Studio Code 作为编辑器,但你也可以任选其他编辑器或 IDE。
硬件:由于本项目使用相对较小的数据集,标准 CPU 即可满足运行需求。
什么是模型蒸馏?
模型蒸馏(或称知识蒸馏)是一种方法,旨在将大型、高准确率模型学到的行为传递给更小、计算效率更高且更适用于实际部署的模型。
蒸馏是一种模型压缩技术:让一个小模型(学生模型)学会模仿更大、更复杂的模型(教师模型)的输出,目标是让学生模型在参数量大幅减少的情况下,达到接近教师模型的性能,从而更容易部署。(来源)
为什么需要模型蒸馏?
截至撰写本文时,无论是闭源还是开源模型,其训练参数都达到了数万亿级。这些参数是模型在训练数据中自动学习到的内部配置变量。如此庞大的参数量,使得模型的运行在没有充足资金支持的情况下既困难又昂贵——它们消耗大量能源,还需要昂贵的硬件。
借助蒸馏,我们可以把这些前沿模型学到的知识迁移到更小、更高效的模型上,让它们使用起来更简单、更便宜。
模型蒸馏技术
具体采用哪种蒸馏技术,取决于要迁移的知识类型:有的方法只迁移最终预测结果,有的则迁移内部表示、注意力图、推理步骤,甚至教师模型的完整行为。
以下是几种常见的技术:
基于响应的蒸馏
这是由 Geoffrey Hinton 在论文 Distilling the knowledge in a neural network 中首次提出的经典师生蒸馏方法。在深入讲解其原理之前,你需要先了解两个模型训练中的概念:硬标签和软标签。
硬标签严格对应固定的分类目标。比如向模型输入一张狗的图片,让它判断是狗、猫还是马,模型会直接输出狗,结果表示为 Dog(1)、horse(0)、cat(0)。它不会给出图片在多大程度上像猫或马的概率。
而软标签则基于概率。同样的图片用软标签的方式输入模型,模型可以预测出这张图有 0.85 的概率是狗、0.10 的概率是猫、0.5 的概率是马。
基于响应的蒸馏方法中,学生模型不仅学习教师的硬标签,还从教师输出结果的概率分布(即软标签)中学习。模型不仅能识别出图片中是一条狗,还能意识到它略微像猫,但几乎不像马。
这种额外信息被称为“暗知识”。它让小模型能够模仿大型教师模型的行为,同时保持较高的性能。
基于响应的蒸馏方法实施简单、稳定性高,且在图像分类任务中表现良好。但它也有缺点,最大的问题在于它忽略了网络内部的结构。
也就是说,基于响应的蒸馏只关注输出层(概率值),因此学生模型与教师模型之间是“黑盒”关系。学生只能学到教师的决策结果,而无法理解其推理过程。套用前面的例子,模型能学习到狗、猫、马的特征概率,但并不理解得出这些结论的底层原理和运作机制。
基于特征的蒸馏
这种技术传递的是大模型内部的特征表示,而不仅仅是最终输出。
可以这样理解:假设你是一位优秀数学导师的学生。导师给你一道题并展示最终答案,你虽然可能猜出正确的公式,但主要是在死记硬背输出结果。
但如果导师让你查看他的草稿本,观察他的解题过程,你学到的就是他具体的思维路径。
在基于特征的蒸馏中,训练过程中要求学生模型生成与教师模型匹配的隐藏层激活值,使用均方误差(MSE)作为衡量标准。通过均方误差,学生模型不仅因正确预测最终输出而获得奖励,若其内部函数系统与教师模型不匹配,也会受到惩罚。
这种方法在卷积神经网络、视觉Transformer和目标检测等领域得到广泛应用。
这种方法的主要缺点是,由于学生模型在每次训练迭代中都必须提取并存储教师模型的内部特征图,内存和能耗会迅速攀升。这使得实际运行成本极高。
注意力蒸馏
在这种方法中,学生模型不再复制教师模型的所有神经元,而是观察大模型在哪些部分投入注意力,并据此复制相应的神经元。
在 Transformer 模型中,这类模型试图理解整个句子的语义,而非仅关注单个单词,其注意力图(attention maps)指明了模型在做出预测时最重视哪些输入 token 或区域。学生模型试图复现这些图或教师模型的分布,从而知道在解决问题时应“看”向哪里。
注意力蒸馏的缺点在于训练时间和硬件资源都面临巨大开销。这是因为需要计算均方误差(MSE)和库尔背-莱布勒(KL)散度等指标。这些指标作为损失函数,精确衡量模型预测或内部表示与教师模型之间的差异。在大规模注意力张量上进行此类计算,会显著增加资源消耗。
自蒸馏
模型也能通过自身进行训练。这通常涉及从早期版本向后期版本的知识迁移,也可以是网络内部不同层之间的知识转移。
这种方法的一个优势是,模型无需增大尺寸就能变得更好,从而降低了使用更大模型来训练学生模型的成本。
如何在 PyTorch 中实现知识蒸馏
为了展示模型蒸馏的实际工作流程,我们将使用 MNIST 数据集和 PyTorch 分类器,先训练一个教师模型,再训练一个学生模型。
该数据集包含约 70,000 张手写数字的灰度图像。我们先训练教师模型,然后将其参数冻结,再利用教师模型提供的硬标签(hard labels)和软目标(soft targets)来训练学生模型。
需要注意的是,MNIST 是一个相对较小的数据集,因此蒸馏带来的收益可能有限。但此项目完整展示了蒸馏的工作流程,能为你处理更大型的数据集打下良好基础。
运行本项目需要安装以下 Python 包:
| 包 | 用途 |
|---|---|
torch |
核心深度学习框架,用于构建和训练神经网络。 |
torchvision |
提供 MNIST 等数据集及图像处理工具。 |
numpy |
数值计算和数组操作。 |
matplotlib |
绘制图表、可视化图像和结果。 |
tqdm |
在训练过程中显示进度条。 |
本项目我用的是 Visual Studio Code,你也可以选择任意其他代码编辑器。
下面是我们的项目结构,稍后讲解代码时会一并介绍其中的文件夹和文件。
knowledge-distillation/
│
├── data/
│
├── models.py
│
├── engine.py
│
├── losses.py
│
├── train_teacher.py
│
├── train_student.py
│
├── train_distilled_student.py
│
├── evaluate.py
│
├── visualize.py
│
├── utils.py
│
├── plots.py
│
├── requirements.txt
│
└── README.md
项目结构中首先是 data 文件夹,用于存放 MNIST 数据集。
models.py 文件定义了项目中所有神经网络的架构,包含教师网络和学生网络两个类。每个类都定义了网络层、前向传播以及数据在网络中的流动方式。
import torch
import torch.nn as nn
import torch.nn.functional as F

class TeacherNet(nn.Module):

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 1024)
        self.fc2 = nn.Linear(1024, 512)
        self.fc3 = nn.Linear(512, 256)
        self.fc4 = nn.Linear(256, 128)
        self.fc5 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = F.relu(self.fc3(x))
        x = F.relu(self.fc4(x))

        logits = self.fc5(x)

        return logits

class StudentNet(nn.Module):
    """
    Smaller neural network (Student)
    """

    def __init__(self):
        super().__init__()

        self.flatten = nn.Flatten()

        self.fc1 = nn.Linear(28 * 28, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):

        x = self.flatten(x)

        x = F.relu(self.fc1(x))

        logits = self.fc2(x)

        return logits
utils.py 文件负责准备数据集,并回答“数据集从哪来”这个问题。在这里,我们下载 MNIST 数据集,对图像进行归一化,并创建训练集和测试集的数据加载器。
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

def get_dataloaders(batch_size=64):
    """
    Downloads MNIST (if needed) and returns
    training and testing DataLoaders.
    """

    transform = transforms.ToTensor()

    train_dataset = datasets.MNIST(
        root="data",
        train=True,
        download=True,
        transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data",
        train=False,
        download=True,
        transform=transform
    )

    train_loader = DataLoader(
        train_dataset,
        batch_size=batch_size,
        shuffle=True
    )

    test_loader = DataLoader(
        test_dataset,
        batch_size=batch_size,
        shuffle=False
    )

    return train_loader, test_loader
engine.py 文件包含可复用的学习算法,并处理训练过程。它接收来自 model.py 的模型代码并对其进行训练。
import torch
from tqdm import tqdm

def train_one_epoch(
    model,
    dataloader,
    criterion,
    optimizer,
    device,
):
    model.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        outputs = model(images)

        loss = criterion(outputs, labels)

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"Loss {loss.item():.4f}"
        )

    return running_loss / len(dataloader)

def evaluate(model, dataloader, device):

    model.eval()

    correct = 0
    total = 0

    with torch.no_grad():

        for images, labels in dataloader:

            images = images.to(device)
            labels = labels.to(device)

            outputs = model(images)

            _, predicted = torch.max(outputs, dim=1)

            total += labels.size(0)

            correct += (predicted == labels).sum().item()

    accuracy = 100 * correct / total

    return accuracy

def predict(model, images, device):

    model.eval()

    with torch.no_grad():

        images = images.to(device)

        outputs = model(images)

        _, predictions = torch.max(outputs, dim=1)

    return predictions

def train_distillation_epoch(
    teacher,
    student,
    dataloader,
    optimizer,
    device,
    loss_fn,
    temperature=4.0,
    alpha=0.5,
):
    """
    使用冻结的教师模型训练学生模型。
    """

    teacher.eval()
    student.train()

    running_loss = 0

    progress = tqdm(dataloader)

    for images, labels in progress:

        images = images.to(device)
        labels = labels.to(device)

        optimizer.zero_grad()

        # 教师模型预测(不计算梯度)
        with torch.no_grad():
            teacher_logits = teacher(images)

        # 学生模型预测
        student_logits = student(images)

        # 组合损失
        loss = loss_fn(
            student_logits=student_logits,
            teacher_logits=teacher_logits,
            labels=labels,
            temperature=temperature,
            alpha=alpha,
        )

        loss.backward()

        optimizer.step()

        running_loss += loss.item()

        progress.set_description(
            f"Distill Loss {loss.item():.4f}"
        )

    return running_loss / len(dataloader)
losses.py 文件定义了模型如何衡量自己的错误。神经网络的训练本质上就是最小化损失,因此 baseline 版本使用 CrossEntropyLoss,而知识蒸馏则引入了 distillation_loss()。
在这个文件里,我们用交叉熵和 KL 散度把硬标签和软目标结合起来。Geoffrey Hinton 的算法就体现在这里。
import torch
import torch.nn as nn
import torch.nn.functional as F

cross_entropy = nn.CrossEntropyLoss()

def distillation_loss(
    student_logits,
    teacher_logits,
    labels,
    temperature=4.0,
    alpha=0.5,
):
    """
    Geoffrey Hinton's Knowledge Distillation Loss

    Parameters
    ----------
    student_logits : output from student model
    teacher_logits : output from teacher model
    labels         : ground-truth labels
    temperature    : controls softness of probability distribution
    alpha          : weight between hard and soft losses
    """

    # Hard Label Loss
    hard_loss = cross_entropy(student_logits, labels)

    # Teacher Soft Targets
    teacher_probs = F.softmax(
        teacher_logits / temperature,
        dim=1
    )

    # Student Soft Predictions
    student_log_probs = F.log_softmax(
        student_logits / temperature,
        dim=1
    )

    # KL Divergence
    soft_loss = F.kl_div(
        student_log_probs,
        teacher_probs,
        reduction="batchmean"
    )

    # Final Distillation Loss
    loss = (
        alpha * hard_loss
        +
        (1 - alpha)
        * (temperature ** 2)
        * soft_loss
    )

    return loss
train_teacher.py 用于训练教师网络。第一次运行之后,就不再重复训练教师模型了。
import torch
import torch.optim as optim

from models import TeacherNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

optimizer = optim.Adam(
    teacher.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        teacher,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        teacher,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    teacher.state_dict(),
    "teacher.pth",
)

print("\nTeacher saved successfully.")
train_student.py 文件用于训练学生模型。它与 train_teacher 几乎一致,区别在于学生模型的网络结构更小,且此阶段未引入教师模型的指导。通过这一步,我们可以获得学生模型在没有教师引导下的基线准确率。
import torch
import torch.optim as optim

from models import StudentNet
from utils import get_dataloaders
from engine import train_one_epoch, evaluate
from losses import cross_entropy

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_one_epoch(
        student,
        train_loader,
        cross_entropy,
        optimizer,
        device,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_baseline.pth",
)

print("\nBaseline student saved.")
train_distilled_student.py 是这套代码的核心。在这里,我们结合真实标签和教师模型的知识来训练学生模型,即基于响应的知识蒸馏。
import torch
import torch.optim as optim

from models import TeacherNet, StudentNet
from utils import get_dataloaders
from engine import (
    train_distillation_epoch,
    evaluate,
)
from losses import distillation_loss

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

train_loader, test_loader = get_dataloaders()

# Load Teacher
teacher = TeacherNet().to(device)
teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

teacher.eval()

# Student
student = StudentNet().to(device)

optimizer = optim.Adam(
    student.parameters(),
    lr=0.001,
)

epochs = 10

for epoch in range(epochs):

    loss = train_distillation_epoch(
        teacher,
        student,
        train_loader,
        optimizer,
        device,
        distillation_loss,
        temperature=3,
        alpha=0.7,
    )

    accuracy = evaluate(
        student,
        test_loader,
        device,
    )

    print(
        f"Epoch {epoch+1}/{epochs}"
        f" | Loss: {loss:.4f}"
        f" | Accuracy: {accuracy:.2f}%"
    )

torch.save(
    student.state_dict(),
    "student_distilled.pth",
)

print("\nDistilled student saved.")
evaluate.py 用于评估已训练模型的性能。在这里,我们只需加载模型和测试数据,进行预测并计算准确率。
import torch

from models import TeacherNet
from utils import get_dataloaders
from engine import evaluate

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

_, test_loader = get_dataloaders()

teacher = TeacherNet().to(device)

teacher.load_state_dict(
    torch.load(
        "teacher.pth",
        map_location=device,
    )
)

accuracy = evaluate(
    teacher,
    test_loader,
    device,
)

print(
    f"Teacher Accuracy: {accuracy:.2f}%"
)
visualize.py 文件用于直观展示我们的发现。我们使用 Python 的 matplotlib 库,将教师模型、基线学生模型和蒸馏后学生模型的结果可视化。
import matplotlib.pyplot as plt

models = [
    "Teacher",
    "Baseline\nStudent",
    "Distilled\nStudent"
]

accuracy = [98.20, 97.86, 97.91]

plt.figure(figsize=(7,5))
plt.bar(models, accuracy)

plt.title("知识蒸馏性能对比")
plt.ylabel("准确率 (%)")

for i, v in enumerate(accuracy):
    plt.text(i, v + 0.02, f"{v:.2f}%", ha="center")

plt.ylim(97.5, 98.5)

plt.tight_layout()
plt.savefig("accuracy_comparison.png", dpi=300)
plt.show()
下面是整个程序的工作流程,帮你理清各部分是如何组合起来的:
                       utils.py
                          │
                 加载 MNIST 数据集
                          │
                          ▼
                     models.py
             TeacherNet / StudentNet
                          │
                          ▼
                     losses.py
  交叉熵 + 蒸馏损失函数
                          │
                          ▼
                     engine.py
    通用训练与评估函数
             ┌────────────┼────────────┐
             │            │            │
             ▼            ▼            ▼
  train_teacher.py  train_student.py  distilled_student.py
             │            │            │
             ▼            ▼            ▼
   teacher.pth  student_baseline.pth  distilled.pth
                          │
                          ▼
                     evaluate.py
              计算最终准确率
                          │
                          ▼
                    visualize.py
     生成图表与实验示意图
如何评估结果
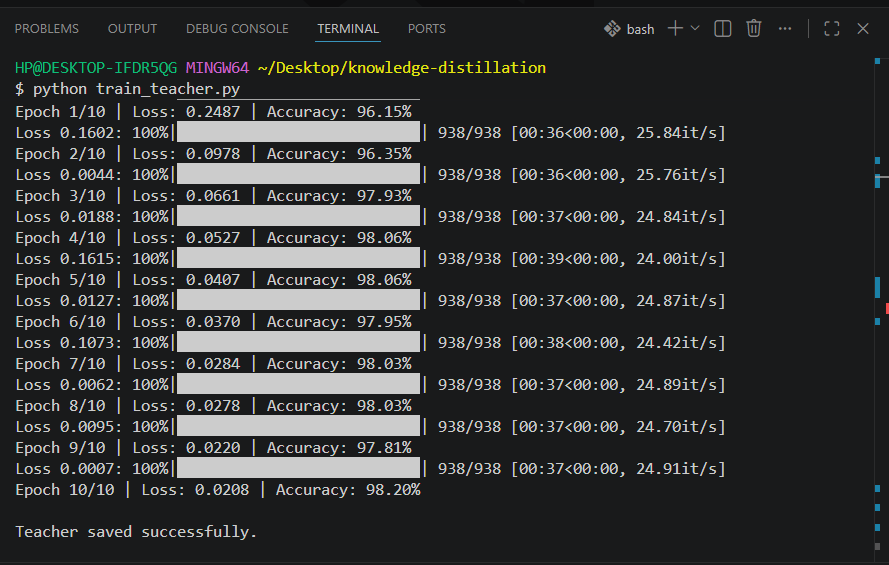
现在来看看我们的实验结果。以下是教师网络、学生网络和蒸馏学生网络各训练 10 个 epoch 后的截图:
教师网络:10 个完整 epoch 后,准确率达到 98.20%。
学生网络:10 个完整 epoch 后,准确率为 97.74%。对于一个小型网络来说,在没有教师模型的情况下,这个成绩已经相当不错了。

蒸馏后的学生网络:完成 10 轮完整训练后,准确率达到 98.20%。相比未使用教师模型知识时取得的 97.74%,性能有所提升。

查看下方图表,了解各模型的表现:

缩减模型体积的其他方法
通过实际代码示例,我们已了解了模型蒸馏。接下来看看开发者为降低大型语言模型的体积、节省延迟、内存占用及计算成本而采用的其他方法,以及它们与蒸馏有何不同。
主要还有三种方法:
量化
量化通过严格降低存储神经网络数值权重和激活值的数据类型位宽来提升效率。它针对的是内存带宽瓶颈,而非模型架构。
简单来说,量化可以将 32 位数字转换为 8 位数字,从而节省约 75% 的文件体积。
用一个现实例子说明量化与蒸馏的区别:就像打印教材时节省油墨和纸张。蒸馏是对教材内容进行概括总结,而量化则是使用低分辨率字体打印原本内容,以节省油墨和纸张。
剪枝
剪枝基于大型语言模型通常包含大量冗余和低影响力参数这一原理。通过移除弱连接,模型可以变得更小、更快。
继续用教材作比喻,剪枝就像把教材中你认为不需要的章节撕掉。
低秩分解
这是一个利用线性代数简化矩阵乘法的数学过程,矩阵乘法主导了深度学习架构。
结合教科书中的例子,这个过程涉及将复杂的公式重写为含义相同但更简单、更短的公式。
选择哪种方法取决于你试图解决的瓶颈。量化通常能有效解决内存问题,而剪枝和蒸馏则旨在减少计算时间。
结论
知识转移之于人工智能,如同之于人类历史一样根本。正如亚里士多德在柏拉图的教诲基础上构建其思想一样,如今高效、可部署的神经网络依赖于从庞大且算力密集的教师模型中提取的基础"暗知识"。
虽然训练具有万亿参数的前沿模型需要巨大的硬件和财务资源,但知识蒸馏确保了这些进步的实际效益不会因巨大的计算瓶颈而被锁住。
正如我们在 PyTorch MNIST 实验中展示的那样,即使是简单的基于响应的蒸馏,也能通过从较大的教师模型的软概率中学习,使较小的网络"超越其重量级"表现。
当与其他优化技术(如量化和剪枝)结合时,蒸馏为在边缘设备、手机和消费级硬件上部署高能力 AI 提供了一条清晰的路径。
感谢阅读!请查看我的YouTube频道,我在上面发布关于 AI 相关内容。
参考文献:
AI 洞察:来自英国科学、创新与技术部的模型蒸馏
Geoffrey Hinton 的《蒸馏神经网络中的知识》