
利用奖励引导推理时搜索设计蛋白质:RFD4-Proteina 教程
RFD4-Proteina 是一款由 NVIDIA 与华盛顿大学医学院蛋白质设计研究所联合开发的 BioNeMo 开源模型。它利用从自然界习得的模式来导航这一空间,协同设计蛋白质序列与全原子结构,并通过奖励引导的推理时搜索(reward-guided inference-time search)机制,将算力集中到最有潜力的候选者上。
本教程面向计算生物学家、机器学习工程师及药物研发人员,展示如何利用奖励引导的推理时搜索,针对肿瘤学靶点 PD-L1 设计蛋白质结合剂候选物,并介绍跨设计任务的实验验证结果。
访问 RFD4-Proteina 有两种方式:
基于 Proteina-Complexa 的部分潜变量方法,RFD4-Proteina 将显式骨干坐标与通过学习获得的序列及原子变量潜表示相结合。其自编码器解码器能同时生成序列和全原子结构,从而免去了向 ProteinMPNN 等模型进行单独逆折叠交接的步骤。
前置要求
- 开源模型
- 需支持 Linux GPU 主机和 Python 3.12;请遵循仓库安装指南,并使用受支持的 NVIDIA GPU。
- 模型缓存:安装配置会自动下载 Hugging Face 资源包;仅当你希望使用不同的缓存目录时才需设置 HF_HOME。
- NIM
- 自托管:需满足 NIM 前置要求 的 x86_64 或 arm64 Linux 系统,并安装 Docker、NVIDIA 驱动、NVIDIA 容器工具包,以及配置 NGC API 密钥。
- NIM API 端点(不推荐用于生产环境):通过 Shell 和 Python 脚本经由 NVIDIA build.nvidia.com 进行 HTTP 访问,无需本地 GPU 或安装模型。
关于 RFD4-Proteina
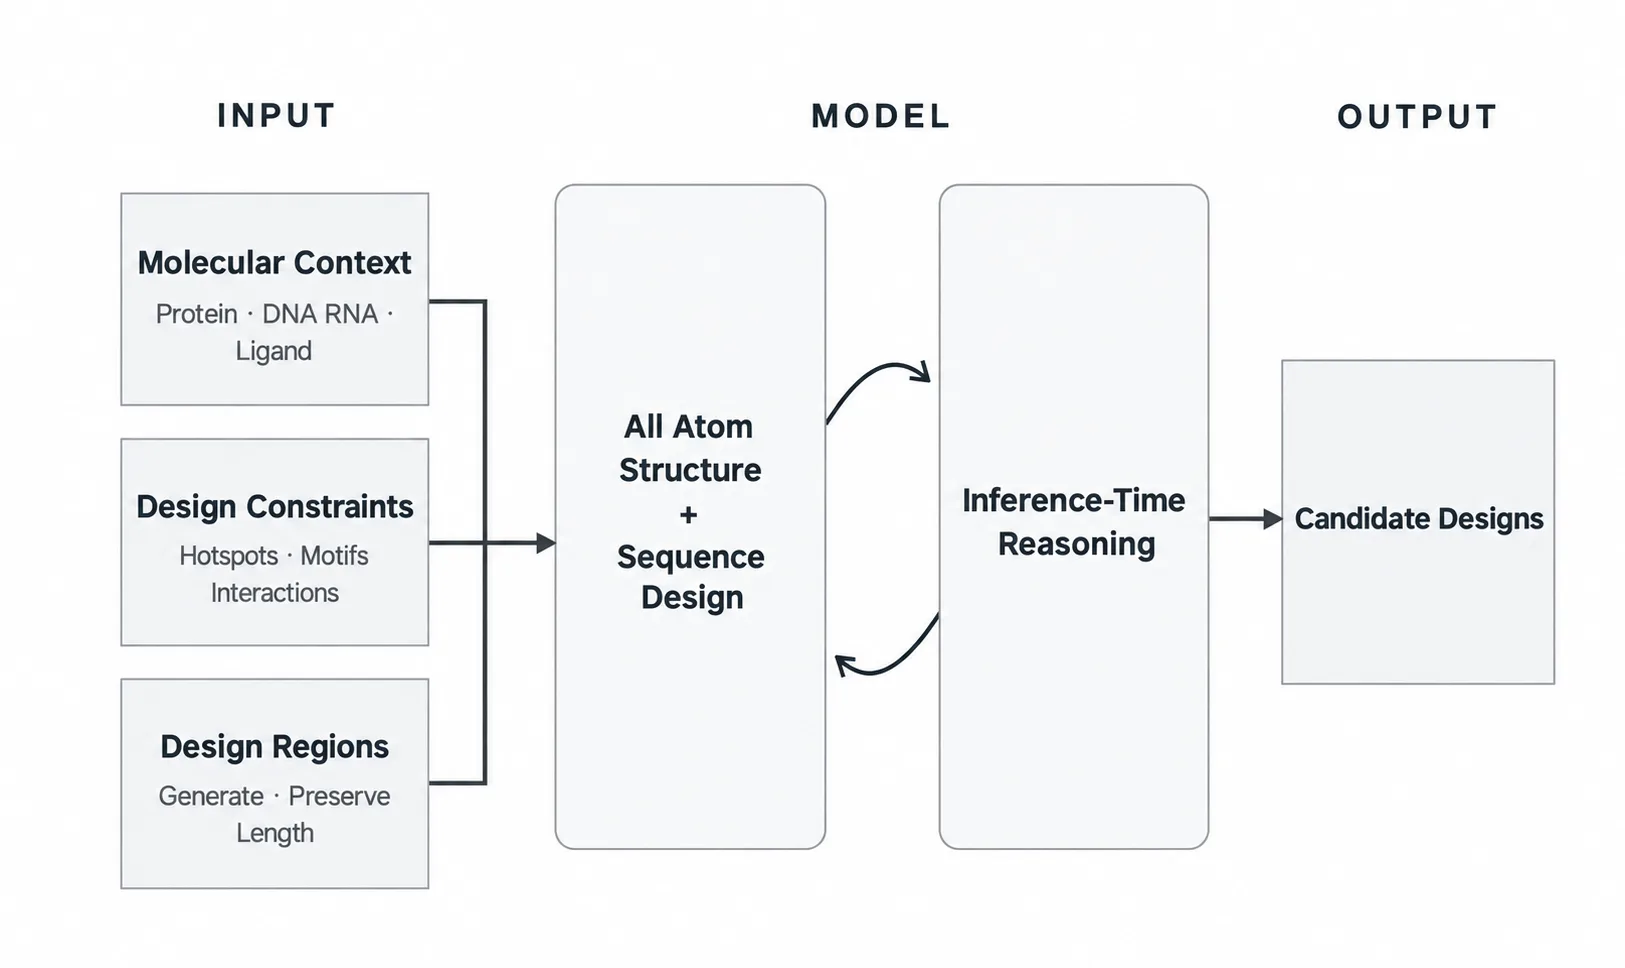
图 1 中所示的搜索循环是 RFD4-Proteina 集中计算资源的地方。
在推理时推理搜索期间,模型对生成轨迹去噪以获得结构,对这些设计进行评分,保留并分支出有前景的部分状态,并持续进行直到达到生成标准。
奖励机制可以衡量几何结构、相互作用或独立预测置信度。这种额外的搜索能根据特定目标优化设计,从而得出得分更高的设计方案。在本教程后续部分,你将看到用户如何通过开放模型和 NIM 启用此功能。
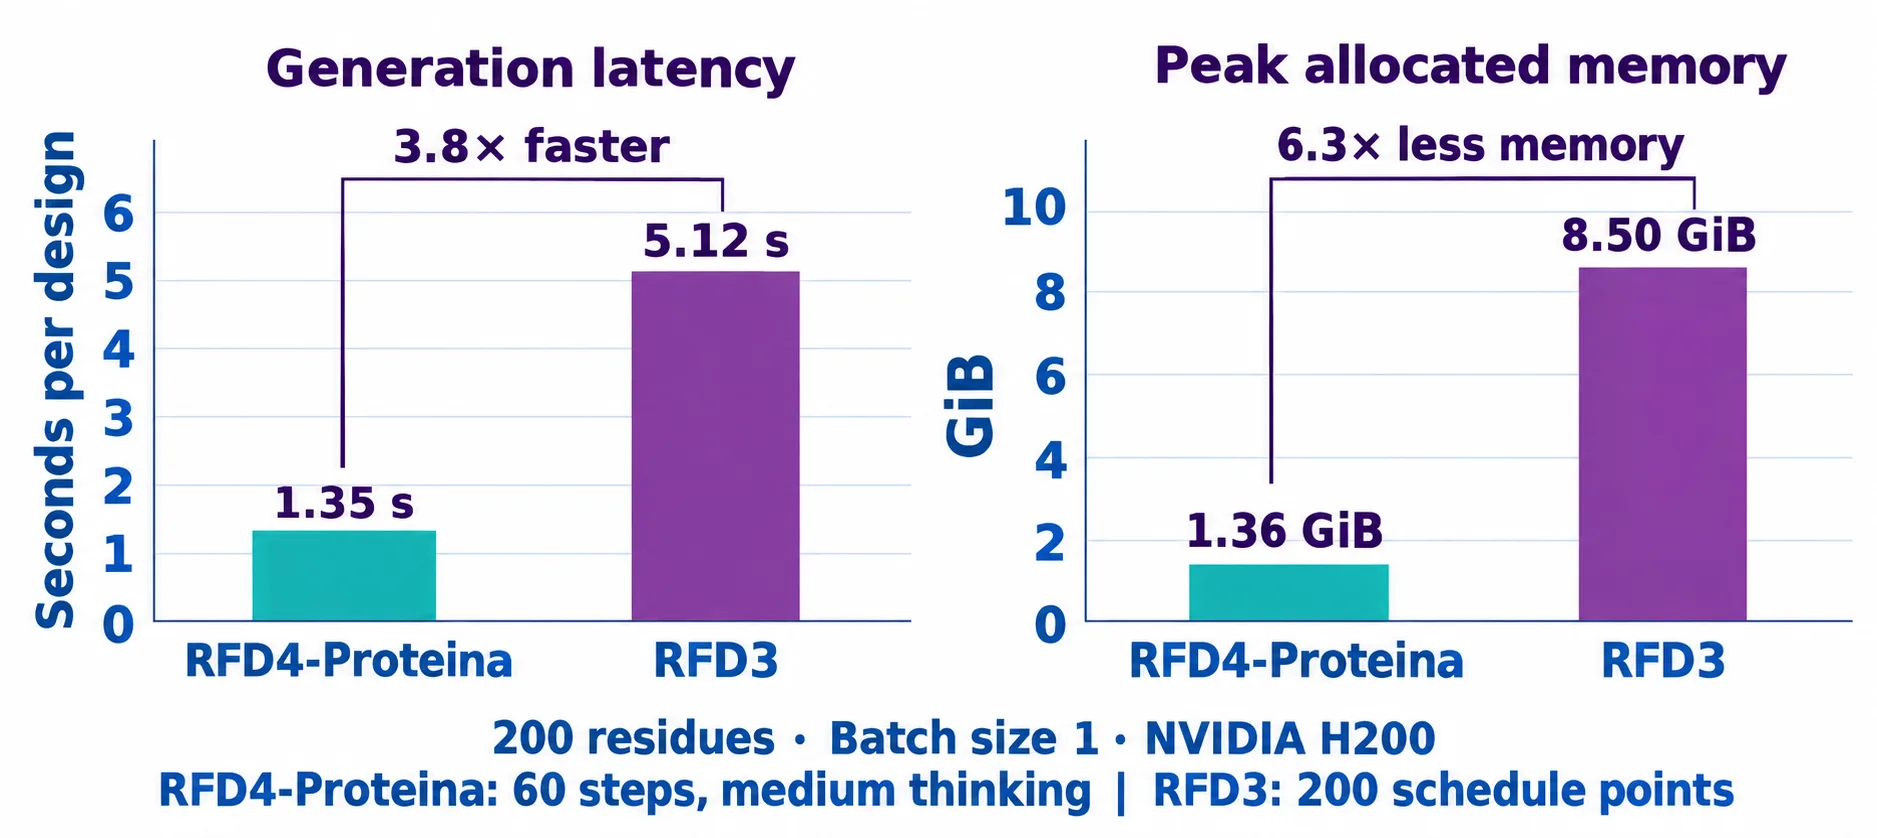
RFD4-Proteina 在多方面上比 RFD3 更快且占用内存更少:
- 它基于残基级别的潜在表示而非原子级别工作,从而避免了内存爆炸。
- 对扩散过程进行了工程优化,将 Proteina-Complexa 约需 400 步的采样缩减到 60 步,同时借助模型的推理能力,把计算集中在流程中最关键的部分。
- 推理时搜索也更快,因为 oracle(OF3 以及 tmol 等物理方法)都经过 CUDA 加速。
- 模型与 kernel 由 cuEquivariance 和 BioNeMo Inference Runtime(BIR)团队联合设计,兼顾速度与可扩展性。
从分子设计想法到候选设计方案
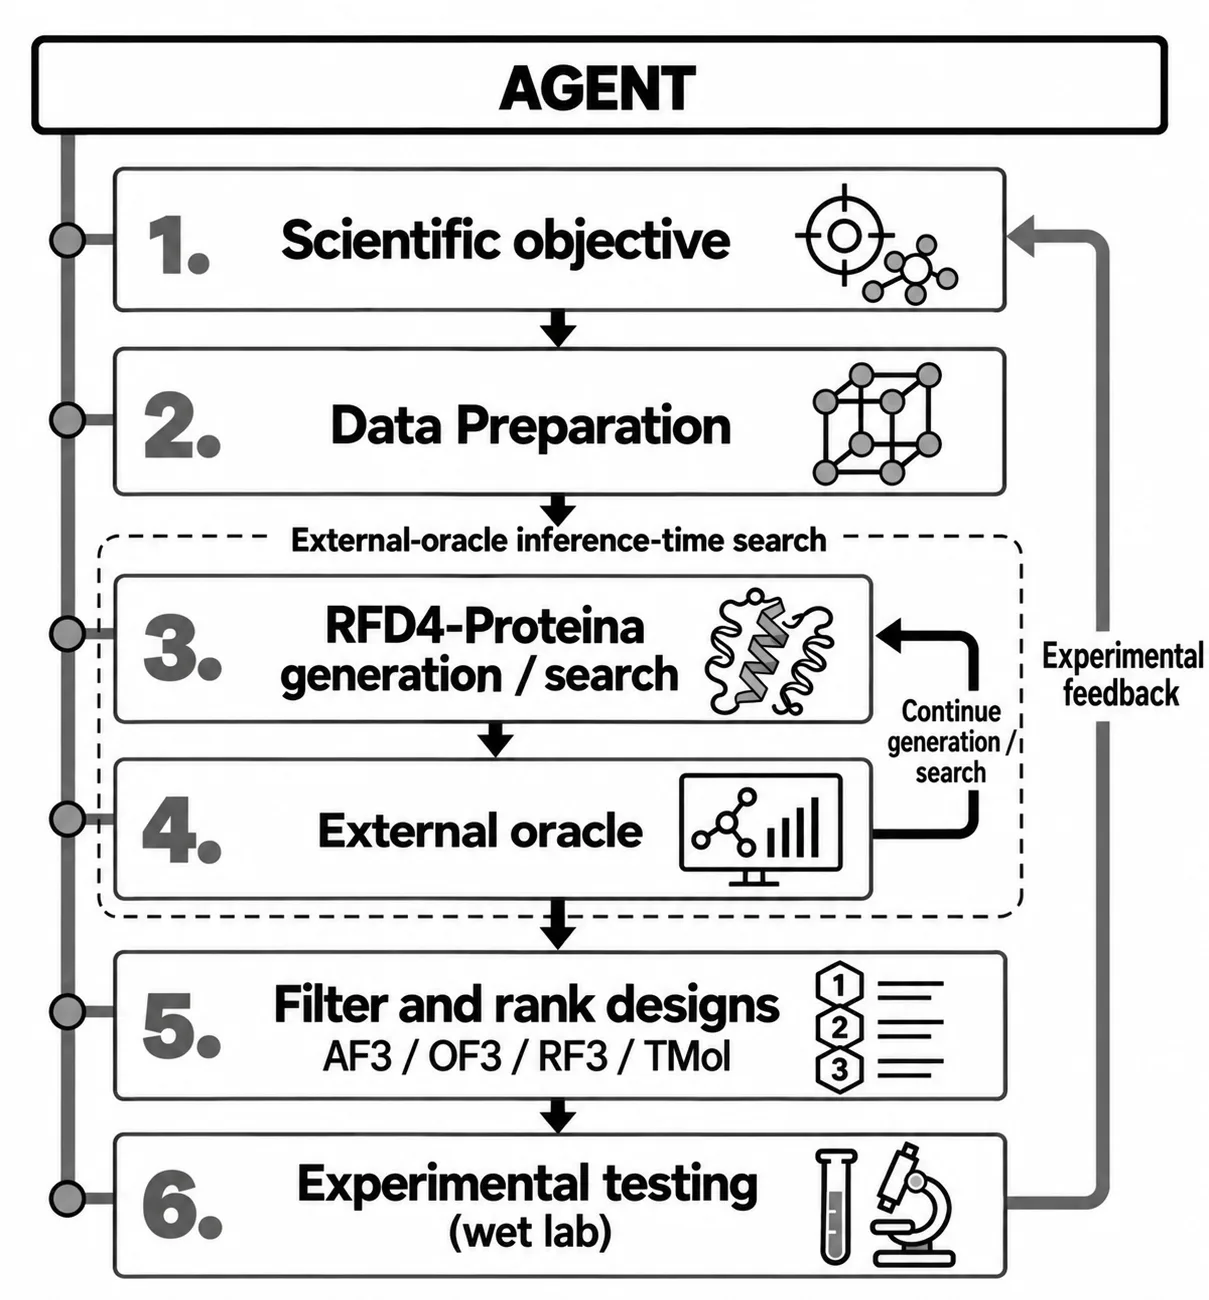
上述图 3 展示的工作流说明了如何使用 RFD4-Proteina 从科学目标推进到实验候选分子。Agent 可以协调这些工具并追踪结果,而科学家则负责定义目标,并利用实验证据指导下一轮迭代。
准备分子输入与环境
首先定义生成的标准和需求。例如,RFD4-Proteina 要求用户明确哪些部分可以改变,哪些必须保持固定,以及计算和实验的成功标准。
使用 AtomWorks 生成或操作输入数据。AtomWorks 是用于准备 RFD4-Proteina 结构和设计注释的分子数据层。其 Python 和 PyMOL 工作流用于准备固定原子、可设计残基、热点以及分子上下文。在设计周围蛋白质时,请保留所提供的配体或基序化学结构。
开放模型和 NIM 均接受带注释的 CIF 文件,或条件规范及其源结构。以下规范固定了目标,并定义了新的结合剂。
仓库中裁剪的 PDB 5O45 PD-L1 结构作为靶标。固定靶标的序列和骨架坐标,允许其侧链重新堆积,并将结合剂生成定向至 Tyr56、Met115 和 Tyr123 上的热点原子。新结合剂由 100 至 150 个残基组成,序列和坐标均自由。
克隆仓库后,在其根目录下运行示例脚本。该脚本会生成 pdl1.json 文件,两条路径均使用相同的靶点 CIF 文件和条件配置。
git clone https://github.com/RosettaCommons/RFD4-Proteina.git
cd RFD4-Proteina

cat > pdl1.json <<'JSON'
{
  "pdl1_binder": {
    "input": "docs/examples/inputs/5o45_cropped.cif",
    "contig": "100-150, /0, A17-131",
    "conditions": {
      "C_CRD": {"true": [{"select": "sel('A') and is_protein_backbone"}]},
      "C_SEQ": {"true": [{"select": "sel('A')"}]},
      "C_HOT": {"true": [
        {"select": "sel('A/*/56/[CG,OH]')"},
        {"select": "sel('A/*/115/[CG,SD]')"},
        {"select": "sel('A/*/123/[CD2,OH]')"}
      ]}
    }
  }
}
JSON
开放模型配置
在支持 Linux/CUDA 的系统上,使用当前的 uv 版本(已在 0.12.24 上验证)安装仓库环境。若已安装 uv,请先更新以使其识别 CUDA 13.2。配置过程会将 Hugging Face 模型捆绑包缓存到本地,包括配套的自编码器。由于模型仓库是私有的,请使用拥有访问权限的账户通过 hf auth login 完成身份验证。
bash setup.sh --native
source .venv/bin/activate
NIM 环境配置
要托管 NIM,请在已安装 Docker 和 NVIDIA Container Toolkit 的支持 GPU 的主机上,通过 Bash 运行以下代码块。
read -rsp 'NGC API key: ' NGC_API_KEY; echo
export NGC_API_KEY
printf '%s' "$NGC_API_KEY" | docker login nvcr.io \
  -u '$oauthtoken' --password-stdin
image=nvcr.io/nim/ipd/rfd4-proteina:latest
docker pull "$image"
export RFD4_NIM_IMAGE="$(docker image inspect \
  --format '{{index .RepoDigests 0}}' "$image")"
printf '%s\n' "$RFD4_NIM_IMAGE" > nim-image.txt
export LOCAL_NIM_CACHE="$HOME/.cache/nim"
mkdir -p "$LOCAL_NIM_CACHE"
docker run -d --rm --name rfd4-proteina \
  --runtime=nvidia --gpus 'device=0' -p 8000:8000 \
  -e NGC_API_KEY -v "$LOCAL_NIM_CACHE":/opt/nim/.cache \
  --shm-size=16g "$RFD4_NIM_IMAGE"
生成序列与结构
开放模型生成
将以下内容保存为仓库根目录下的 design.py。该脚本同时支持生成和搜索功能。Proteina.from_pretrained("nvidia/RFD4-Proteina") 用于加载当前的 Hugging Face 模型及配套的自编码器检查点。
import hydra
from rfd4_proteina import Proteina
from rfproteina.generate import run_generation

@hydra.main(config_path="configs", config_name="inference", version_base="1.3")
def main(cfg):
    model = Proteina.from_pretrained("nvidia/RFD4-Proteina")
    run_generation(cfg, model=model)

if __name__ == "__main__":
    main()
在仓库根目录下生成一个候选设计:
python design.py inputs=pdl1.json out_dir=runs/pdl1-open seed=42 compile_lengths=null
输出结果保存在 runs/pdl1-open/inference_samples/ 目录下。如需生成十个候选,可加上 num_replicates=10,并且每次运行都要指定一个新的 out_dir。下载的文件会缓存到 Hugging Face;如果希望复现某个特定版本的模型,可以在 from_pretrained 中加上 revision=”<commit>”。
使用 NIM 生成
将以下代码保存为 nim_client.py。它会把 PD-L1 条件规格和目标 CIF 文件发送给 NIM,然后保存生成的结构以及响应指标。
import json
from pathlib import Path
import requests

spec = json.loads(Path("pdl1.json").read_text())["pdl1_binder"]
target = Path(spec["input"])
spec["input"] = target.name
payload = {
    "task": "motif_scaffolding",
    "input": {"format": "condition_spec", "example_id": "pdl1_binder",
              "spec": spec, "files": [{"filename": target.name, "content": target.read_text()}]},
    "sampling": {"num_replicates": 1, "seed": 42},
    "metrics": {"tags": ["design", "hotspot_conditioning"]},
}

def submit(payload, out):
    out.mkdir(parents=True, exist_ok=True)
    response = requests.post("http://localhost:8000/biology/ipd/rfd4-proteina/generative",
                             json=payload, timeout=1800)
    response.raise_for_status()
    result = response.json()
    (out / "response.json").write_text(json.dumps(result, indent=2))
    for i, design in enumerate(result["designs"]):
        dest = out / f"design-{i}.cif"
        dest.write_text(design["structure"]["content"])
        print(design["design_id"], dest)

if __name__ == "__main__":
    submit(payload, Path("runs/pdl1-nim"))
先安装 requests 库,然后在仓库根目录运行客户端。注意要把 pdl1.json 放在目标 CIF 文件旁边。
python -m pip install requests
python nim_client.py
开源模型与 NIM 的性能优化
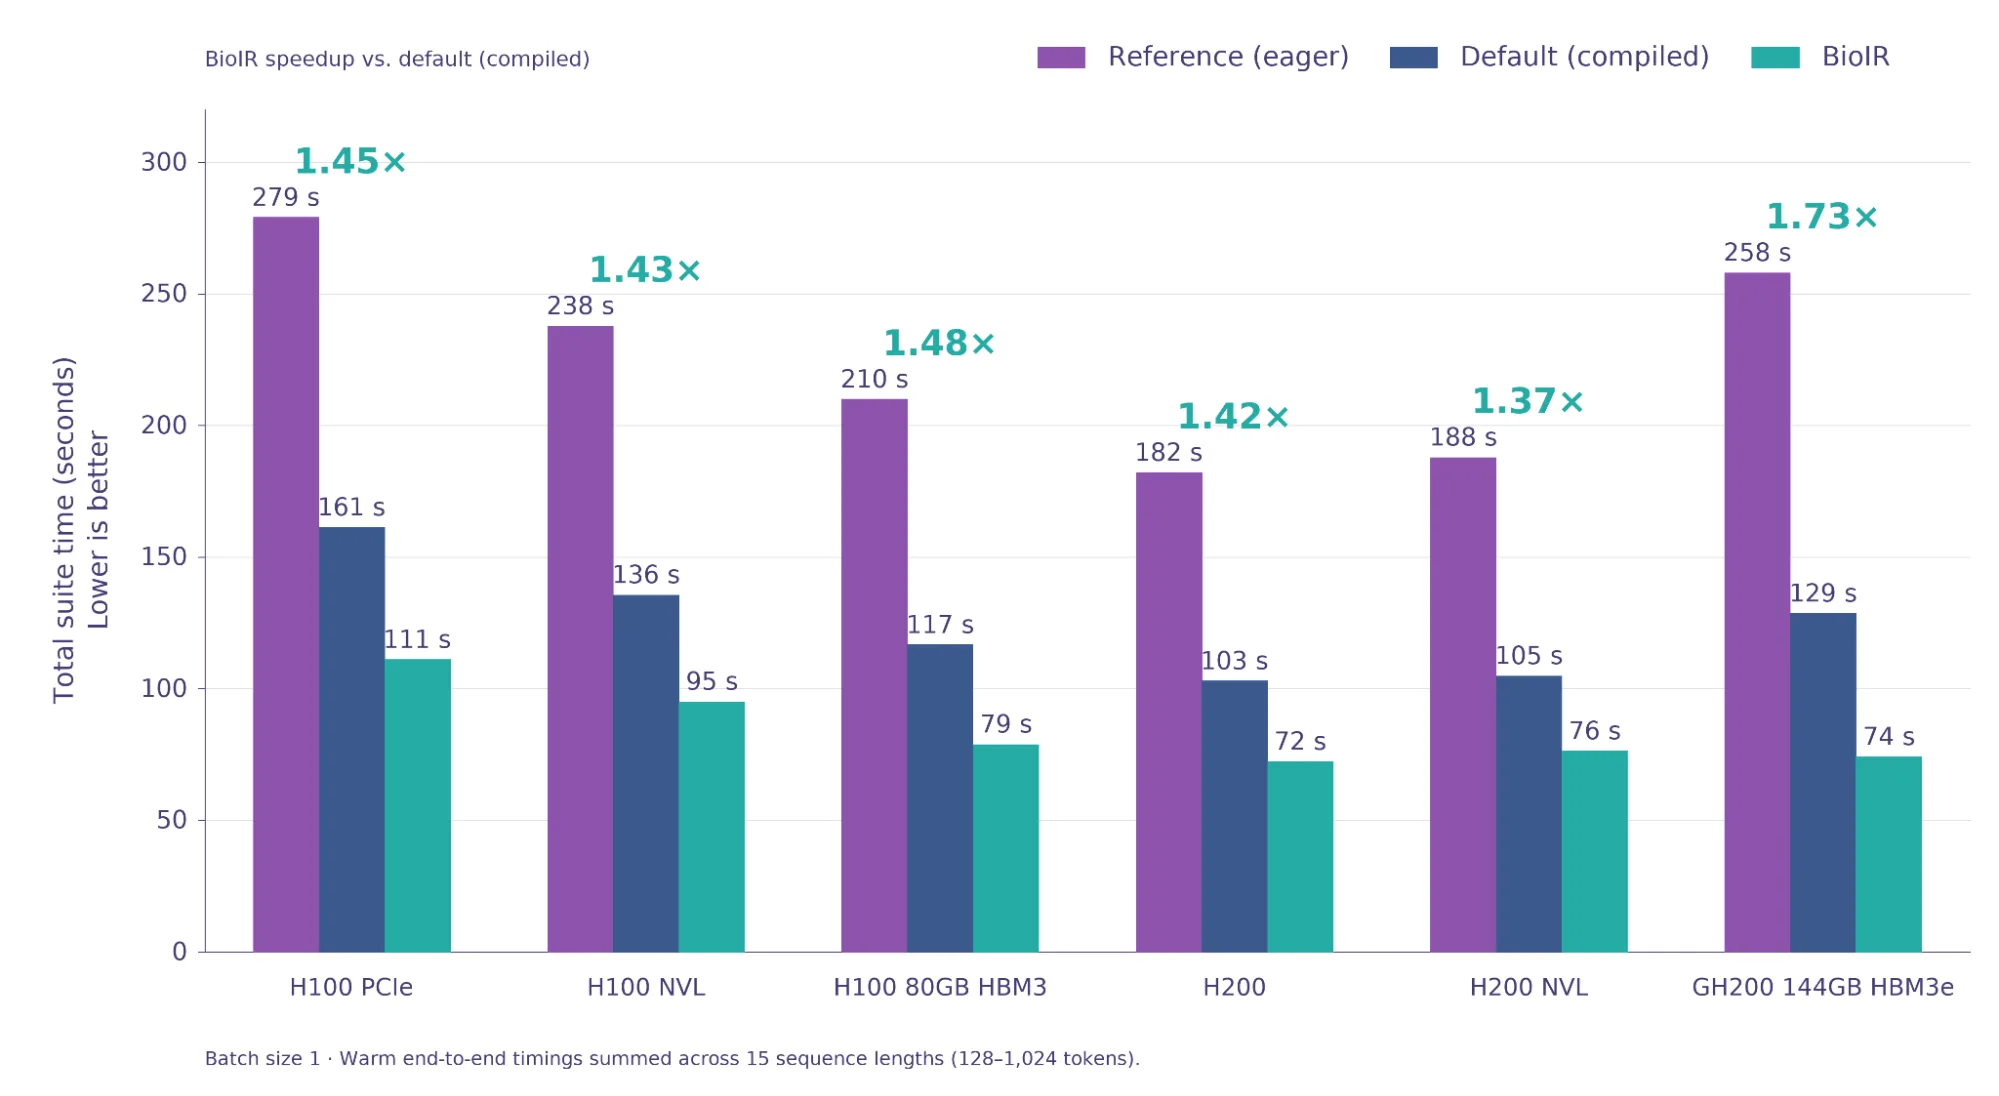
为了加快设计迭代,BioIR 后端在六种测试的 Hopper GPU 配置上,相比默认编译后端将 RFD4-Proteina 加速了 1.37–1.73 倍(见下文图 4)。在 H100 PCIe 上,完整测试套件的耗时从 161 秒降至 111 秒,运行时间缩短了约 31%。基准测试采用 batch size 为 1,统计了 15 种序列长度(128–1,024 tokens)下预热后的端到端总耗时。
基于外部 Oracle 的推理时搜索
基于 OpenFold3 的开源模型搜索
使用 ./scripts/download_example_data.sh ./data_path 安装可选的 OpenFold3 运行时及权重。将 OF3_IMAGE、OF3_MODEL_DIR 和 OF3_JAX_CACHE_DIR 设置为脚本输出的相应路径,然后运行 mkdir -p "$OF3_JAX_CACHE_DIR"。GPU 主机上必须已安装 Apptainer。
本示例使用了 AlphaFold3 代码库(已以开源的 Apache 2.0 许可证发布)以及 OpenFold3 模型权重(同样以 Apache 2.0 许可证发布)。
通过搜索预设复用 design.py:
python design.py inference_experiment=inference_beam_example \
  metrics/refolding_oracles=of3 inputs=pdl1.json subset_to_examples=null \
  num_replicates=1 out_dir=runs/pdl1-open-search seed=42 compile_lengths=null
预设配置采用两个分支,束宽为三,并分别在第 20、40、50 和 60 步进行评分。该配置奖励设计链的 OpenFold3 pLDDT(oracle.plddt_coi),下限设为 50,当奖励值达到 80 时保存合格轨迹。这衡量的是对结合体的置信度,而非结合的证据;界面和重折叠指标需单独检查。输出文件位于 runs/pdl1-open-search/ 目录下。
使用 OpenFold3 进行 NIM 搜索
将此代码保存为 nim_search_request.py。它复用 PD-L1 输入并提交一个奖励引导的 OpenFold3 搜索任务。
from pathlib import Path
from nim_client import payload, submit

key = "oracle_of3_nvcf.overall_plddt"
payload["sampling"]["num_steps"] = 60
payload["search"] = {
    "step_checkpoints": [0, 20, 40, 50, 60],
    "n_branch": 2, "beam_width": 3,
    "reward_metrics_tags": ["unconditional_refolding"],
    "weights": {key: 1.0}, "clip_values": {key: {"min": 50.0}},
    "intermediate_save_min_reward": 80.0,
}
payload["metrics"] = {"tags": ["design", "unconditional_refolding"]}
submit(payload, Path("runs/pdl1-nim-search"))
启用 NIM oracle
按照oracle 指南的描述,挂载 OpenFold3 的 reward.py 回调。它报告整个复合物的 oracle_of3_nvcf.overall_plddt;结合体界面需单独评估。
将 oracle 指南中的 OpenFold3 NVCF 回调保存为 reward.py,并使用 NVCF 调用凭证导出 OF3_NIM_API_KEY。使用此回调重新启动服务:
docker stop rfd4-proteina
docker run -d --rm --name rfd4-proteina \
  --gpus 'device=0' -p 8000:8000 --shm-size=16g \
  -e NGC_API_KEY -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
  -v "$PWD/reward.py:/opt/nim/reward.py:ro" \
  -e NIM_ALLOW_ORACLE_PLUGIN=true -e OF3_NIM_API_KEY \
  "$RFD4_NIM_IMAGE"
运行搜索脚本。它会在 runs/pdl1-nim-search/ 目录下保存设计结果和响应指标。
python nim_search_request.py
此请求使用两个分支,检查点 [0, 20, 40, 50, 60],束宽为三。奖励下限设为 50,得分至少为 80 的中间设计会被保存。这些是 OpenFold3 整体 pLDDT(衡量整个复合物预测置信度的指标)的示例阈值。搜索时的奖励标签与最终报告标签是分开的。
搜索输出的数量会因设置而异。在挑选候选设计前,请先检查生成的 CIF 文件及保留的各项指标。在对比计算成本时,也要把重折叠和打分的开销算进去。
过滤并排序候选设计
检查各项约束、motif 保留情况、原子碰撞、界面质量、重折叠一致性以及结构多样性指标。OpenFold3 和 RoseTTAFold3 可用于结构预测;TMol 则提供受 Rosetta 启发的全原子打分与优化。
常用指标包括来自 OpenFold 3 等蛋白质结构预测模型的 ipTM(接口预测模板建模得分)、ipSAE(基于对齐误差的相互作用预测得分)和 RMSD(均方根偏差),以及来自 TMol 等物理模型的作用能。
实验验证与迭代优化
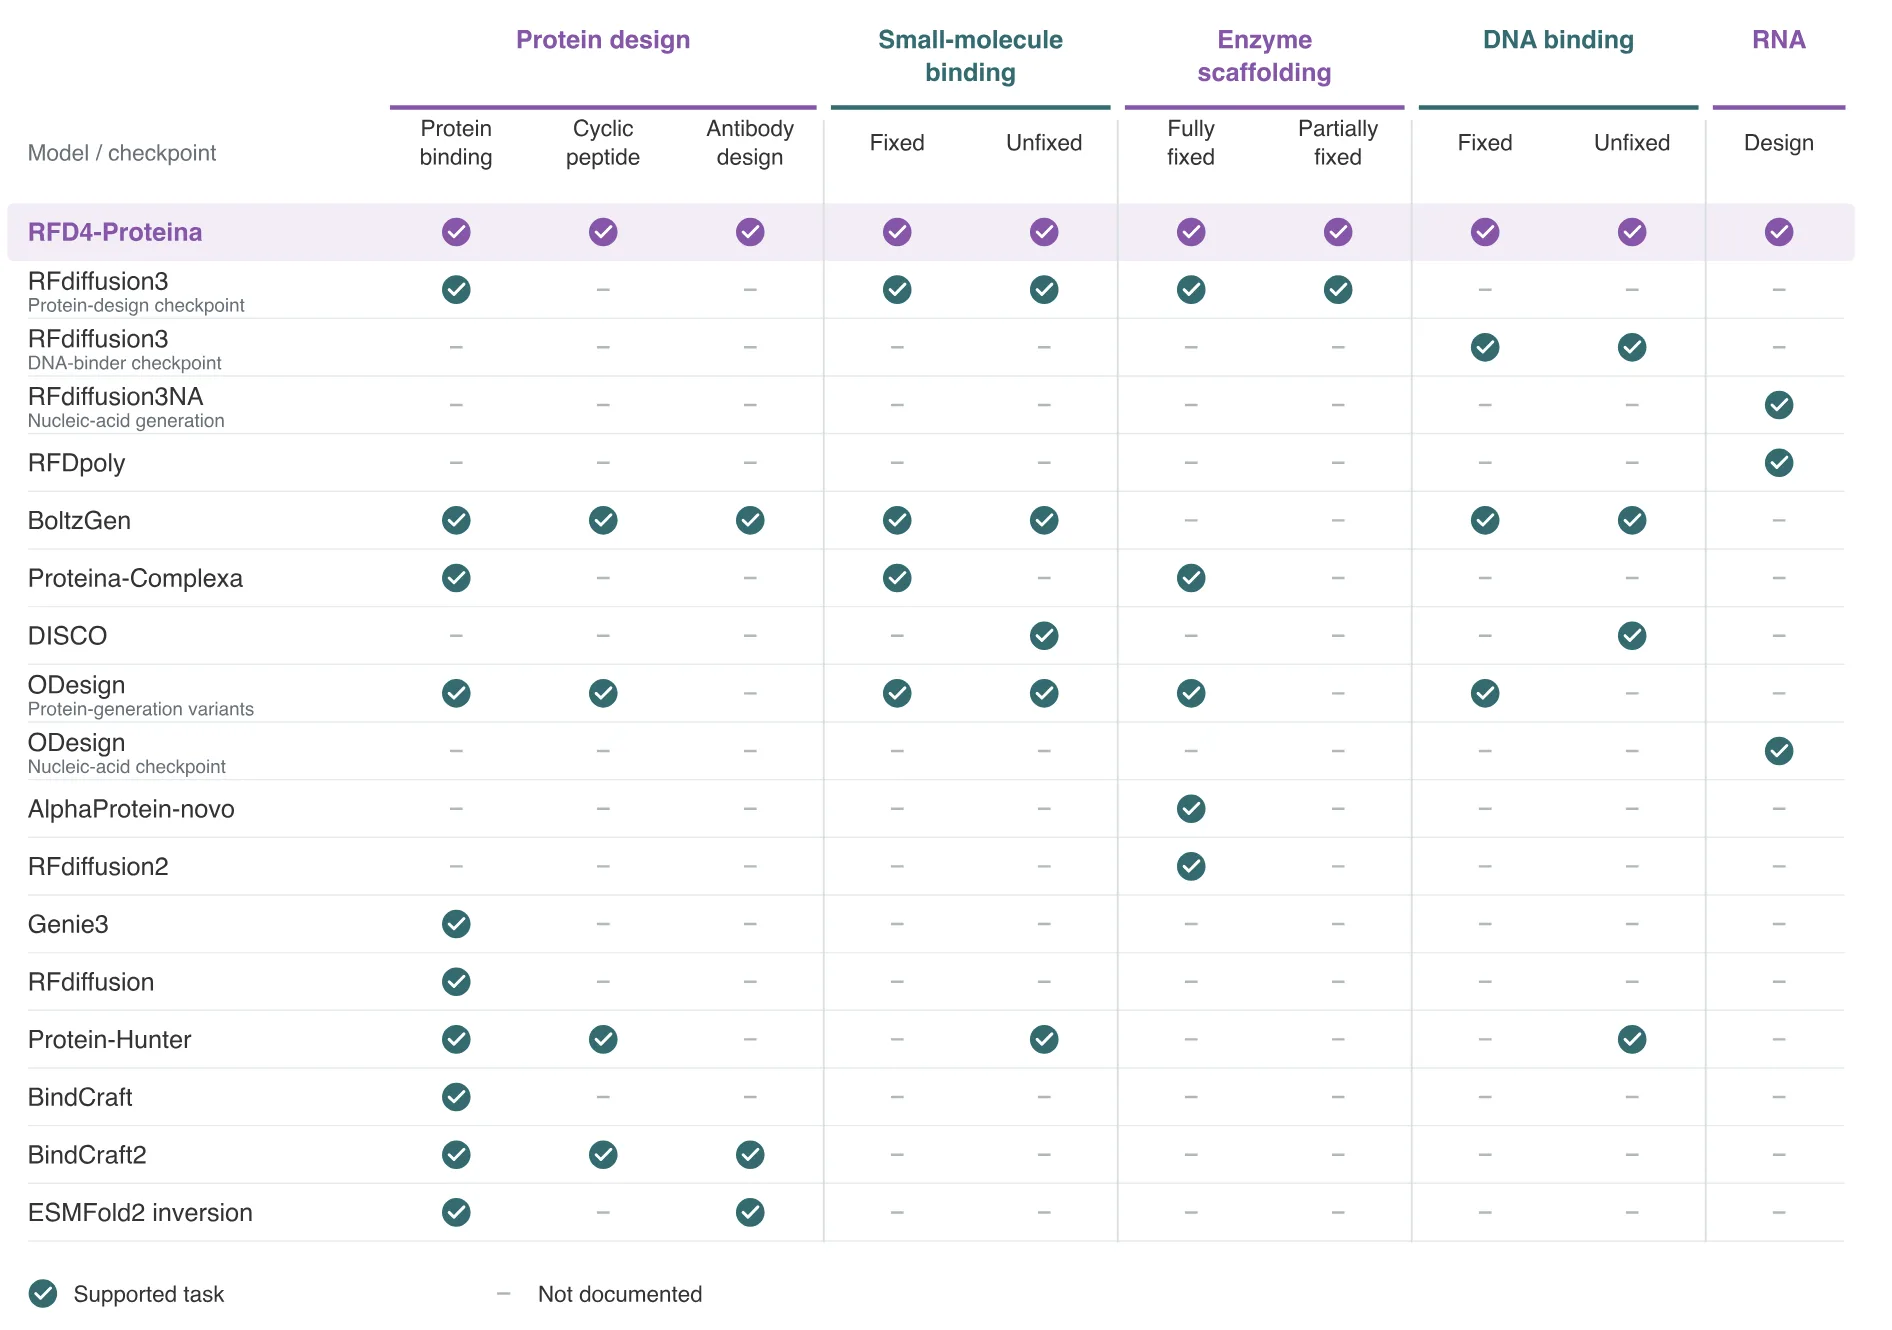
上表展示了 RFD4-Proteina 在各类分子任务上的广泛能力。它不仅支持如此多样的任务,其配套论文还证明,无论是输出质量还是吞吐量,该模型在这一系列分子任务上都达到了最先进水平。
要让这种吞吐量真正转化为科学进展,可以挑选多样化的候选设计进行合成、表达和针对具体任务的实验检测,再把实验结果反馈到下一轮的目标函数、约束条件和排序标准中。
用 AI agent 跑完整的设计流程
使用 rfd4-proteina-campaign 技能来协调生成、搜索和评估,并记录输入、模型版本及计算资源使用情况。rfd4-proteina-package 技能会生成结果归档,包含结构、指标以及过滤报告。
使用 rfd4-proteina-campaign 从 pdl1.json 设计 100–150 个残基的 PD-L1 结合剂,保持其目标及热点约束。使用 OpenFold3 和通过 from_pretrained 加载的 Hugging Face 模型。商定标准和计算预算,比较基于奖励的生成与搜索,并通过 rfd4-proteina-campaign 执行任务。返回最多 10 个多样化候选物及其得分和计算使用情况;使用 rfd4-proteina-package 打包结果。
将工作流应用于你的设计问题
RFD4-Proteina 在单一工作流中集成了快速生成、智能搜索和智能体可编程性。联合序列和全原子结构生成简化了候选物的创建过程,而基于奖励的搜索则使计算资源聚焦于特定任务目标。共享的条件规范将两种形态连接到共同的评估工具,NIM 的 HTTP API 允许智能体提交请求并检查结果。
使用开放模型进行方法开发,使用 NIM 进行应用集成(可选 BioIR 加速),将计算探索与实验反馈结合在一个迭代设计任务中。
从 RFD4-Proteina NIM 微服务、在 GitHub 上探索开放模型 或指导你的智能体使用 BioNeMo 智能体工具包技能 开始。