
用 TypeScript 从零构建 AI Agent 框架
许多 AI 智能体教程往往直接从语言模型入手,配上几个工具,然后运行循环直至得到答案。这套流程足以演示工具调用,但无法解答更关键的工程问题。
工具失败时该怎么办?谁来校验参数?如何防止智能体陷入无限循环、执行危险命令或耗尽上下文窗口?又该如何在不依赖模型不可预测响应的情况下测试这些场景?
这些问题由智能体框架(agent harness)负责处理:它是语言模型与其运行环境之间的软件层。
本教程将用 TypeScript 构建一个轻量、不绑定特定服务商的框架,以编码智能体为例。我们从基础执行循环入手,逐步加入工具校验、工作区隔离、执行预算、上下文管理、可观测性以及确定性失败测试。
本章大纲
前置要求
熟悉 TypeScript、对 AI agent 有基本了解会很有帮助。我们将使用 Node.js 24、TypeScript 及其内置测试运行器,依赖极少。
完整实现见配套仓库:agent-harness-from-scratch。每个章节对应一个 Git tag,你可以跟着项目的演进一步步学,而不是直接从最终代码开始。
1. 构建基础的 Agent 循环
要跟着做,先检出初始里程碑:
git clone https://github.com/gkoos/agent-harness-from-scratch.git
cd agent-harness-from-scratch
git switch --detach 01-model-loop
npm ci
npm run typecheck
npm test
npm run demo
detached checkout 会让你停留在本文讨论的精确快照上,不影响任何分支。进入下一节时,切换到对应的 tag 即可。你需要提前安装 Node.js 24 和 npm。
最重要的架构决策是模型负责提出行动,harness 负责执行。当模型请求调用工具时,它实际上还没有执行任何操作,只是生成了一个包含工具名称和参数的结构化请求。Harness 需要解析该请求,调用对应的实现,并将结果返回给模型。
交互过程如下:
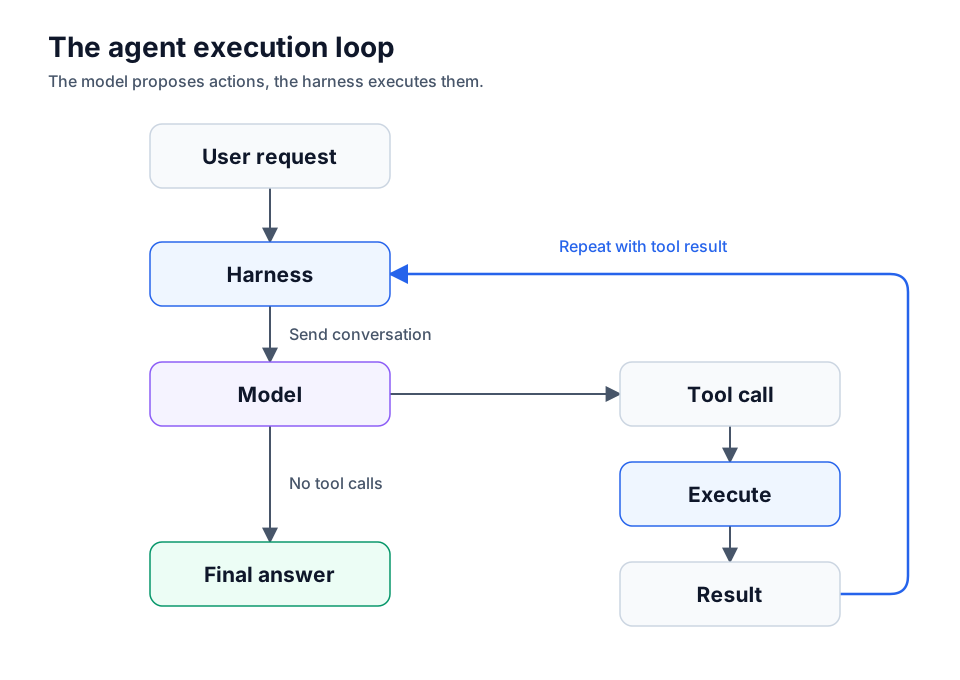
我们首先从定义 src/core/types.ts 中的接口契约开始。
export type ToolCall = { id: string; name: string; arguments: unknown };

export type Message =
  | { role: 'user'; content: string }
  | { role: 'assistant'; content: string; toolCalls?: ToolCall[] }
  | { role: 'tool'; callId: string; content: string; isError: boolean };

export interface ToolDefinition {
  name: string;
  description: string;
  parameters: Record<string, unknown>; // JSON Schema for the model
}

export interface Tool extends ToolDefinition {
  execute(argumentsValue: unknown, signal: AbortSignal): Promise<unknown>;
}

export interface Model {
  generate(input: {
    messages: readonly Message[];
    tools: readonly ToolDefinition[];
    signal: AbortSignal;
  }): Promise<{ content: string; toolCalls?: ToolCall[] }>;
}

export type AgentResult = {
  status: 'completed' | 'step_limit' | 'aborted';
  answer?: string;
  messages: Message[];
  steps: number;
};
Model 接口刻意不包含任何特定于 OpenAI、Anthropic 或其他提供商的具体细节。提供商适配器可以在其 API 和这些类型之间进行转换,而无需修改 harness。
请注意,工具参数类型是 unknown 而非 any。模型生成的数据属于不可信输入。我们将在下一节中在执行前对其进行验证。
src/core/agent.ts 中的 agent 循环遵循一个简单的顺序:
将对话历史和可用工具定义发送给模型。
把模型的回复追加到对话中。
若模型请求了工具,则执行这些工具并将结果追加进去。
循环执行,直到模型返回最终答案,或 harness 达到步数上限。
以下是 src/core/agent.ts 中完整的初始循环。模型接收工具定义,而 harness 保留可执行的实现:
import type { AgentResult, Message, Model, Tool } from './types.ts';

export async function runAgent(options: {
  model: Model;
  tools: readonly Tool[];
  prompt: string;
  maxSteps?: number;
  signal?: AbortSignal;
}): Promise<AgentResult> {
  const { model, tools, prompt, maxSteps = 10 } = options;
  if (!Number.isSafeInteger(maxSteps) || maxSteps < 1) {
    throw new RangeError('maxSteps must be a positive safe integer');
  }
  const signal = options.signal ?? new AbortController().signal;
  const messages: Message[] = [{ role: 'user', content: prompt }];
  const registry = new Map(tools.map(tool => [tool.name, tool]));
  if (registry.size !== tools.length) throw new Error('Duplicate tool names');
  const definitions = tools.map(({ name, description, parameters }) => ({ name, description, parameters }));

  for (let step = 0; step < maxSteps; step++) {
    if (signal.aborted) return { status: 'aborted', messages, steps: step };
    let response;
    try {
      response = await model.generate({ messages: [...messages], tools: definitions, signal });
    } catch (error) {
      if (signal.aborted) return { status: 'aborted', messages, steps: step };
      throw error;
    }
    if (signal.aborted) return { status: 'aborted', messages, steps: step };
    const calls = response.toolCalls ?? [];
    messages.push({ role: 'assistant', content: response.content, ...(calls.length ? { toolCalls: calls } : {}) });
    if (!calls.length) return { status: 'completed', answer: response.content, messages, steps: step + 1 };

    for (const call of calls) {
      if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
      const tool = registry.get(call.name);
      if (!tool) {
        messages.push({ role: 'tool', callId: call.id, content: `Unknown tool: ${call.name}`, isError: true });
        continue;
      }
      try {
        const result = await tool.execute(call.arguments, signal);
        if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
        messages.push({ role: 'tool', callId: call.id, content: JSON.stringify(result) ?? 'null', isError: false });
      } catch (error) {
        if (signal.aborted) return { status: 'aborted', messages, steps: step + 1 };
        messages.push({
          role: 'tool', callId: call.id,
          content: error instanceof Error ? error.message : String(error),
          isError: true
        });
      }
    }
  }
  return { status: 'step_limit', messages, steps: maxSteps };
}
如果响应中没有工具调用,本轮运行即结束。否则,harness 会查找并执行请求中的每个工具。
工具执行失败不会导致 agent 自动终止。相反,harness 会将一条错误消息与原始调用 ID 关联并记录。这使得模型可以在下一轮中针对缺失文件或失败的操作作出反应。
我们还设置了模型轮次的上限。模型可以持续请求更多任务,但它无法决定自己应获得多少执行时间或允许运行多少次迭代。
不使用真实模型进行测试
为了避免在测试中进行不可预测的 API 调用(同时浪费 token 或 GPU 算力),我们在 src/models/fake.ts 中引入了一个脚本化的模拟模型。它返回预定义的响应:先是工具请求,然后是最终答案。
该模拟模型依次遍历一个响应数组。一旦脚本耗尽即报错,因此若出现未预期的额外模型轮次,测试不会静默通过:
// src/models/fake.ts
import type { Model } from '../core/types.ts';

export function scriptedModel(
  responses: Array<Awaited<ReturnType<Model['generate']>>>
): Model {
  let index = 0;
  return {
    async generate() {
      const response = responses[index++];
      if (!response) throw new Error('Scripted model exhausted');
      return response;
    }
  };
}
以下是针对 tests/agent.test.ts 的最小测试用例。使用 npm test 运行:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { runAgent } from '../src/core/agent.ts';
import { scriptedModel } from '../src/models/fake.ts';

test('executes a tool and returns the final answer', async () => {
  const result = await runAgent({
    prompt: 'Say hello',
    tools: [{
      name: 'hello', description: 'Return a greeting',
      parameters: { type: 'object' },
      async execute() { return 'Hello'; }
    }],
    model: scriptedModel([
      { content: '', toolCalls: [{ id: '1', name: 'hello', arguments: {} }] },
      { content: 'Done' }
    ])
  });
  assert.equal(result.status, 'completed');
  assert.equal(result.answer, 'Done');
  assert.deepEqual(result.messages[2], {
    role: 'tool', callId: '1', content: '"Hello"', isError: false
  });
});
用 const registry = new ToolRegistry(tools) 创建注册表,并通过 registry.definitions() 获取给模型用的定义。当模型响应请求调用某个工具时,要在调用 execute 之前先校验传入的参数:
const tool = registry.get(call.name);
if (!tool) {
  messages.push({
    role: 'tool', callId: call.id,
    content: `Unknown tool: ${call.name}`, isError: true
  });
  continue;
}

const validationErrors = validate(call.arguments, tool.parameters);
if (validationErrors.length) {
  messages.push({
    role: 'tool', callId: call.id,
    content: `Invalid arguments: ${validationErrors.join('; ')}`,
    isError: true
  });
  continue;
}
这是一道关键防线。在 harness 校验之前,arguments: unknown 都视为不可信内容。一旦校验失败,工具就不会执行,模型只会收到一条与原调用 ID 关联的错误结果。
教程里的 validate 函数刻意只支持一小部分 JSON Schema 子集:基本类型和容器类型的 type 检查、对象的 properties、required 必填字段、additionalProperties: false、数组的 items 以及 enum。它会输出类似 $.flags[0] 这样的路径,方便定位格式错误的输入。注意它并非完整的 JSON Schema 实现,也不会在工具注册时校验 schema。
下面就是前文用到的校验器。它会先检查声明的类型,再递归校验对象属性和数组元素:
export function validate(value: unknown, schema: Record<string, unknown>, path = '$'): string[] {
  const errors: string[] = [];
  const type = schema.type;
  if (typeof type !== 'string') return [`${path}: schema must declare a type`];
  const matches = type === 'object' ? value !== null && typeof value === 'object' && !Array.isArray(value)
    : type === 'array' ? Array.isArray(value)
    : type === 'integer' ? typeof value === 'number' && Number.isInteger(value)
    : type === 'number' ? typeof value === 'number' && Number.isFinite(value)
    : type === 'null' ? value === null
    : type === 'string' || type === 'boolean' ? typeof value === type : false;
  if (!matches) return [`${path}: expected ${type}`];
  if (Array.isArray(schema.enum) && !schema.enum.some(item => Object.is(item, value))) {
    errors.push(`${path}: not an allowed value`);
  }
  if (type === 'object') {
    const obj = value as Record<string, unknown>;
    const properties = (schema.properties ?? {}) as Record<string, Record<string, unknown>>;
    for (const key of (schema.required ?? []) as string[]) {
      if (!Object.hasOwn(obj, key)) errors.push(`${path}.${key}: required`);
    }
    for (const [key, item] of Object.entries(obj)) {
      if (Object.hasOwn(properties, key)) errors.push(...validate(item, properties[key]!, `${path}.${key}`));
      else if (schema.additionalProperties === false) errors.push(`${path}.${key}: unexpected property`);
    }
  }
  if (type === 'array' && schema.items && typeof schema.items === 'object') {
    (value as unknown[]).forEach((item, index) => {
      errors.push(...validate(
        item, schema.items as Record<string, unknown>, `${path}[${index}]`
      ));
    });
  }
  return errors;
}
并非所有错误都意味着相同的事
第二阶段还明确区分了工具失败与模型失败。
未知工具、无效参数或工具抛出的异常,都会生成一条 role: 'tool' 且 isError: true 的消息。模型可以检查该结果,并在下一轮尝试其他操作。相比之下,如果 model.generate() 本身抛出异常,脚手架会终止执行并记录 status: 'model_error' 及相应的错误信息。
这不仅仅是记录操作。文件缺失或许可以补救,但模型提供商不可用则意味着没有模型响应来指导恢复过程。harness 不应将这两种情况混为一谈。
在循环现有的 model.generate() 的 catch 块中,用结构化结果替代抛出异常,并给 AgentResult 添加 'model_error' 以及可选的 error?: string 字段:
if (signal.aborted) return { status: 'aborted', messages, steps: step };
return {
  status: 'model_error', messages, steps: step,
  error: error instanceof Error ? error.message : String(error)
};
工具执行的 catch 块仍会记录错误信息并继续循环。
确定性测试让这种区别变得具体。在 tests/agent.test.ts 中,无效的 echo 参数会被拒绝而不调用工具,而工具抛出的异常仍允许脚本化的模型返回最终答案。tests/registry.test.ts 则检查嵌套参数验证和意外属性。
3. 赋予 Agent 工具,但不交付整个机器
目前,我们的 agent 可以请求工具,harness 也会验证其参数。但验证只能确保请求具有正确的格式。读取 ../../secrets.txt 的有效请求,依然是我们应该拒绝的请求。
查看配套仓库中的 里程碑 3:
git switch --detach 03-workspace-tools
本里程碑增加了工作区文件工具和一个受限命令工具。两者均不依赖特定的模型提供商。
将文件操作限制在工作区内
编码 agent 需要读取和编辑文件,但不应自动获得整个文件系统的访问权限。Workspace 类在创建时会解析出规范化的根目录:
const workspace = await Workspace.open('/path/to/project');
const tools = workspaceTools(workspace);
生成的 read_file 和 write_file 工具只接受相对于该根目录的路径。在打开文件之前,Workspace 会拒绝绝对路径、逃逸出根目录的路径,以及已有路径组件中的符号链接。写入操作要求父目录必须存在,该工具不会随意创建目录树。
Workspace 内部用这两个方法来执行路径检查。文件从 node:path 导入 isAbsolute、relative 和 resolve,从 node:fs/promises 导入 lstat 和 realpath。Workspace.open() 会把 await realpath(root) 的结果存入 this.root:
private lexical(path: string): string {
    if (!path || isAbsolute(path)) throw new Error('Expected a relative workspace path');
    const full = resolve(this.root, path);
    const rel = relative(this.root, full);
    if (!rel || rel === '..' || rel.startsWith(`..${process.platform === 'win32' ? '\\' : '/'}`) || isAbsolute(rel)) {
      throw new Error('Path is outside the workspace or refers to its root');
    }
    return full;
  }

  /** Reject symlinks in every existing component, not just the final file. */
  private async check(path: string, allowMissingFinal: boolean): Promise<string> {
    const full = this.lexical(path);
    const rel = relative(this.root, full);
    const parts = rel.split(/[\\/]/);
    let current = this.root;
    for (let i = 0; i < parts.length; i++) {
      current = resolve(current, parts[i]!);
      try {
        const stat = await lstat(current);
        if (stat.isSymbolicLink()) throw new Error('Symbolic links are not permitted');
        if (i < parts.length - 1 && !stat.isDirectory()) throw new Error('Parent is not a directory');
      } catch (error) {
        if (allowMissingFinal && i === parts.length - 1 && (error as NodeJS.ErrnoException).code === 'ENOENT') break;
        throw error;
      }
    }
    return full;
  }
read 在打开已有文件前会调用 this.check(path, false);write 则调用 this.check(path, true),只允许最后一个文件不存在,父目录缺失或路径中出现任何符号链接仍会导致检查失败。
边界控制由工具实现层负责,而不是靠要求模型自觉。模型可以请求读取 ../secret.txt,但工作区会拒绝打开该文件。随后,执行框架将此次失败作为可恢复的工具结果上报,处理逻辑与第二阶段中处理无效参数时完全一致。
为了加强校验,在系统支持的情况下,实现层使用 O_NOFOLLOW 标志打开文件,以避免跟随路径最后一级组件中的符号链接。但这无法消除所有竞态条件:目录组件在检查与打开之间可能发生变化。这一限制很有教育意义,但并非操作系统级别的沙箱。
让模型选择命令,而非自行创造
运行命令的风险更高。我们不接受模型生成的 shell 字符串,而是注册具名的命令预设:
const tool = commandTool(projectRoot, {
  test: {
    executable: process.execPath,
    args: ['--test', 'tests/example.test.js']
  }
});
模型可以请求 { "command": "test" },但无法指定其他可执行文件、添加额外参数或使用 shell 语法。命令工具的调度边界代码如下(位于其 execute(value, signal) 方法内部):
signal.throwIfAborted();
const name = (value as { command: string }).command;
if (!Object.hasOwn(presets, name)) throw new Error('Command not permitted');
const preset = presets[name]!;
const timeout = preset.timeoutMs ?? 10_000;
if (!Number.isSafeInteger(timeout) || timeout < 1) {
  throw new Error('Invalid timeout');
}

// Inside the Promise that collects the command's result:
const child = spawn(preset.executable, [...preset.args], {
  cwd, shell: false, signal, windowsHide: true,
  stdio: ['ignore', 'pipe', 'pipe']
});
const timer = setTimeout(() => child.kill(), timeout);
其中 spawn 来自 node:child_process,cwd 是配置的项目根目录,presets 则是上文所述的开发者提供的映射表。结果处理器负责收集标准输出和标准错误流;若任一捕获的字符串超过 65,536 个字符,则终止子进程;在发生错误或连接关闭时清除 timer。实现层测量的是 JavaScript 字符串长度,而非精确的字节数。
虽然这限制了模型可选择的命令数量,但并不意味着选定的命令就无害。测试脚本本身可能会读取文件、访问网络或启动子进程。即使杀掉因超时而终止的子进程,也不一定能可靠地终止其整个进程树。运行不受信任的代码仓库仍需要进程隔离机制,例如正确配置的容器或操作系统沙箱。
Milestone 3 的测试覆盖了正常的读写操作、路径遍历尝试、符号链接、可恢复的访问失败以及被拒绝的命令名称。
4. 为执行设置限制
现在的 Agent 可以调用经过验证的工具,包括感知工作区的文件操作和预定义的命令。但合法的操作未必意味着我们可以无限制地允许它。模型可能会发起数百次工具调用,或者某个命令可能挂起,而 Agent 仍在等待其结果。
在这个阶段,我们将执行限制视为 harness 的职责,而不是要求模型去遵守某些规则。
请按照确切的仓库版本进行操作:
git switch --detach 04-execution-limits
如果你还没有克隆该项目,请先运行 git clone https://github.com/gkoos/agent-harness-from-scratch.git 并 cd agent-harness-from-scratch。
分别统计轮次和工具调用次数
原始的 maxSteps 设置限制的是模型响应次数,而非工具调用次数。由于一次响应可能请求多个工具,仅设置轮次限制不足以约束实际工作量。
我们在 runAgent 中增加两个选项:
const result = await runAgent({
  model,
  tools,
  prompt: 'Check the project',
  maxSteps: 10,
  maxToolCalls: 30,
  timeoutMs: 15_000
});
每次请求的调用都会消耗工具调用预算,包括未知工具和参数无效的调用。这一点很重要,因为即使请求失败,harness 也会消耗资源。在循环开始前初始化 let toolCalls = 0,然后在查找每个被接纳调用的工具之前立即递增计数。这种位置安排确保了被拒绝的参数和未知工具也被计入。
模型还可能一次性返回多个工具调用。与其先执行前几个、然后才发现预算已耗尽,harness 会先检查整批调用是否还能放得下:
if (calls.length > maxToolCalls - toolCalls) {
  return { status: 'tool_limit', messages, steps, toolCalls };
}
这样可以避免因预算不足导致的半途执行。注意这并不意味着整批调用是事务性的:工具仍可能失败,执行也可能在中途被取消。
传递取消信号与截止时间
调用方可以传入一个 AbortSignal,而 timeoutMs 则会创建一个内部截止时间。harness 通过一个 AbortController 把两者合并,并把合并后的信号传给模型和工具。
下面的设置替代了初始循环中直接使用的信号:
const controller = new AbortController();
let timedOut = false;
const onAbort = () => controller.abort(options.signal?.reason);
if (options.signal?.aborted) onAbort();
else options.signal?.addEventListener('abort', onAbort, { once: true });
const timer = timeoutMs === undefined ? undefined : setTimeout(() => {
  timedOut = true;
  controller.abort(new Error('Agent deadline exceeded'));
}, timeoutMs);
const signal = controller.signal;
和原来的循环一样,把这个 signal 传给 model.generate() 和 tool.execute()。把循环包在 try/finally 里,这样无论是正常结束还是提前返回,都能释放定时器和监听器:
try {
  // The execution loop goes here, using controller.signal.
} finally {
  if (timer !== undefined) clearTimeout(timer);
  options.signal?.removeEventListener('abort', onAbort);
}
在各个执行边界处检查 signal.aborted,并以 timedOut ? 'timeout' : 'aborted' 作为状态返回。结果中还会带上 steps 和 toolCalls,让调用方了解终止前实际完成了多少工作。
这是协作式取消,不是强制终止。如果某个 adapter 忽略信号,未完成的操作可能会超出截止时间继续运行。同样,杀掉子进程也未必能终止它的后代进程。要实现硬性的执行边界,需要依赖进程或容器级别的隔离。
不用等真实故障也能测试边界情况
预算测试利用脚本模型发起一个超预算的请求,并验证没有任何工具被执行。其他测试则确认无效请求会消耗预算、预先中止的信号能阻止模型调用,以及协作型模型和工具在截止期限到来时会停止运行。
types.ts中的结果类型现在可以区分completed、step_limit、tool_limit、aborted、timeout和model_error。这些状态被刻意区分开:即使运行正确停止,也可能意味着用户的任务并未完成。
5. 掌控上下文
现在 Harness 限制了运行时长,但对话内容仍在不断增长。每次模型响应和工具结果都会作为新消息发回给模型。仅仅读取一个文件就可能返回数千行内容。在达到步数预算之前,仅仅几轮迭代就可能耗尽模型的上下文窗口。
里程碑 5 引入了两个概念的区别:我们保留的记录(transcript)和发送给模型的消息。查看具体实现:
git switch --detach 05-context
相关文件包括src/core/context.ts、src/core/agent.ts和tests/context.test.ts。
限制工具输出和面向模型的历史记录
新的context选项设置了两项独立的限制:
const result = await runAgent({
  prompt: 'Inspect the project',
  model,
  tools,
  context: {
    maxContextChars: 32_000,
    maxToolResultChars: 8_000
  }
});
maxToolResultChars在工具结果进入记录之前就对其长度进行限制。过大的结果会保留开头和结尾,中间用省略号标记。被截断的部分此后不可用,即使在result.messages中也无法获取。
截断辅助函数会先为标记预留空间,然后将剩余空间平均分配给消息的开头和结尾:
export function boundToolResult(content: string, limit: number): string {
  if (content.length <= limit) return content;
  const marker = `\n...[${content.length - limit} or more characters omitted]...\n`;
  if (marker.length >= limit) return marker.slice(0, limit);
  const remaining = limit - marker.length;
  const front = Math.ceil(remaining / 2);
  const back = Math.floor(remaining / 2);
  return content.slice(0, front) + marker + (back ? content.slice(-back) : '');
}
在记录成功结果和错误字符串时都应应用该函数:content: boundToolResult(content, context.maxToolResultChars)。这种紧凑实现显式处理了长度为零的尾部情况,防止 slice(-0) 意外保留整个结果。
maxContextChars 限制了传递给模型的消息数组序列化后的长度。框架会在返回的对话记录中保留旧消息,但 selectContext() 只会发送初始用户请求以及尽可能多的最近轮次。没有摘要机制:被省略的历史记录在当轮对话中模型无法获取。
这些是字符数限制,而非 Token 限制。它们衡量的是 JSON 序列化后的 JavaScript 字符串长度,不包含工具定义和特定服务商的额外开销。实际的 Provider 适配器需要支持 Token 感知计算,并为主模型响应预留空间。
不要将工具调用与其结果拆分
上下文裁剪并非简单地删除最旧的消息。助手的响应可能请求多个工具,每个工具由唯一的调用 ID 标识。只发送其中部分工具的结果会导致对话无效或产生误导。
因此,选择器将助手消息及其对应的所有结果视为一个不可分割的组。要么包含该组的全部内容,要么完全省略。对于孤立的结果或不完整的批次,选择器会直接拒绝,而不是静默构建不一致的上下文。
以下是来自 src/core/context.ts 的 selectContext() 实现,使用了第 1 节中定义的 Message 类型。第一个循环用于验证并分组对话记录;第二个循环则从后向前遍历完整的组,直到预算填满:
import type { Message } from './types.ts';

const size = (messages: readonly Message[]) => JSON.stringify(messages).length;

export function selectContext(messages: readonly Message[], maxChars: number): Message[] {
  if (!Number.isSafeInteger(maxChars) || maxChars < 1) {
    throw new RangeError('maxContextChars must be a positive safe integer');
  }
  if (!messages.length) return [];
  const groups: Message[][] = [];
  for (let i = 0; i < messages.length;) {
    const message = messages[i]!;
    if (message.role === 'assistant' && message.toolCalls?.length) {
      const ids = new Set(message.toolCalls.map(call => call.id));
      if (ids.size !== message.toolCalls.length) throw new Error('Duplicate tool call IDs in assistant turn');
      const group: Message[] = [message];
      i++;
      while (i < messages.length && messages[i]!.role === 'tool') {
        const result = messages[i]!;
        if (result.role === 'tool' && !ids.delete(result.callId)) throw new Error('Orphan or duplicate tool result');
        group.push(result);
        i++;
      }
      if (ids.size) throw new Error('Incomplete tool result batch');
      groups.push(group);
    } else {
      if (message.role === 'tool') throw new Error('Orphan tool result');
      groups.push([message]);
      i++;
    }
  }
  const first = groups[0]!;
  if (first[0]?.role !== 'user') throw new Error('Conversation must start with a user message');
  const recent: Message[][] = [];
  for (let i = groups.length - 1; i >= 1; i--) {
    const group = groups[i]!;
    const next = [...first, ...[group, ...recent].flat()];
    if (size(next) > maxChars) {
      if (recent.length === 0) throw new Error('Context budget too small for latest turn');
      break;
    }
    recent.unshift(group);
  }
  const selected = [...first, ...recent.flat()];
  if (size(selected) > maxChars) throw new Error('Context budget too small for required messages');
  return selected;
}
每次调用模型前,把 selectContext(messages, context.maxContextChars) 的返回值作为 messages 输入。如果初始提示词或最近必需的消息组放不下,选择器会抛出异常,harness 返回 context_limit。这是执行层面的决定,不是模型能通过工具调用恢复的错误。
确定性测试覆盖批处理保持、孤儿检测、输出截断以及面向模型的投影。这些测试不仅验证上下文确实变小了,还要确保其仍然代表连贯的对话。接下来,我们将使这些决策变得可观测。
6. 使 Agent 执行可观测
Agent 可能在最终给出正确答案的同时,中途执行了某些异常操作:重试失败的操作、发起不必要的模型调用,或花费大部分时间使用某个工具。仅凭最终答案无法还原执行过程。我们需要执行事件,同时避免将 harness 变成日志框架。
查看配套仓库中的此里程碑:
git switch --detach 06-observability
实现位于 src/core/events.ts,集成代码位于 src/core/agent.ts。
在执行边界处发出事件
我们在 runAgent 中添加可选的 onEvent 回调。harness 在模型调用前后发出 model_start 和 model_end,在工具分发前后发出 tool_start 和 tool_end,在模型操作失败时发出 model_error,在执行终止时发出 run_end。
每个事件包含运行 ID、递增序列号和时间戳。模型和工具完成事件还报告通过单调时钟测得的耗时。这些信息足以让我们重建操作顺序并识别慢调用。
const events: AgentEvent[] = [];

const result = await runAgent({
  prompt: 'Inspect the project',
  model,
  tools,
  onEvent: event => events.push(event),
});

console.log(result.runId, events);
从 src/core/events.ts 导入 AgentEvent。该回调是可选的:不需要遥测的调用方可以省略它。
一个容易被忽视的要求是:可观测性不得干扰执行流程。事件监听器中的异常不能导致一次成功的工具调用失败。事件发射器(emitter)会捕获监听器内的异常,并通过 onObserverError 进行可选的上报;而该处理器本身的失败也会被静默吞掉。回调是同步的,因此响应缓慢的监听器仍会拖慢 agent。
emitter 通过 node:crypto 中的 randomUUID() 初始化一次 runId,并将 sequence 的初始值设为 0。其 emit(event) 方法会为事件补充字段,并对两种回调分别做隔离处理:
const enriched = {
  ...event, runId, sequence: ++sequence,
  timestamp: new Date().toISOString()
};
try {
  options.onEvent?.(enriched);
} catch (error) {
  try { options.onObserverError?.(error); }
  catch { /* Observer failures cannot change the run outcome. */ }
}
在模型或工具的边界处,执行前保存 const start = performance.now(),执行后再发射 durationMs: performance.now() - start。共享的 finish() 辅助函数会在返回每个终止结果前发射 run_end,确保提前退出路径同样可观测。
统计模型用量,而非凭空捏造
我们也可以在模型响应中加入由提供商上报的可选 token 用量字段:
return {
  content: 'Done',
  usage: { inputTokens: 125, outputTokens: 20 },
};
harness 在 result.usage 中累加上报的 token 计数,同时维护 modelCallsWithUsage。这个字段很关键:如果上报的 token 数为 0 且没有任何带用量报告的模型调用,则说明是用量未知,而非这次运行是免费的。非法的计数会被直接拒绝,而不是悄悄污染累计总值。
累加器使用可选的输入和输出 token 计数,并对单个值及累计总值进行校验:
export type Usage = { inputTokens?: number; outputTokens?: number };
export type UsageTotals = {
  inputTokens: number; outputTokens: number; modelCallsWithUsage: number
};

export function addUsage(totals: UsageTotals, usage: Usage | undefined): void {
  if (!usage) return;
  for (const value of [usage.inputTokens, usage.outputTokens]) {
    if (value !== undefined && (!Number.isSafeInteger(value) || value < 0)) {
      throw new RangeError('Model usage must contain nonnegative safe integers');
    }
  }
  if (!Number.isSafeInteger(totals.inputTokens + (usage.inputTokens ?? 0)) ||
      !Number.isSafeInteger(totals.outputTokens + (usage.outputTokens ?? 0))) {
    throw new RangeError('Accumulated model usage exceeds safe integer range');
  }
  totals.inputTokens += usage.inputTokens ?? 0;
  totals.outputTokens += usage.outputTokens ?? 0;
  totals.modelCallsWithUsage++;
}
在运行开始时把统计值初始化为零。在模型响应的接口定义中加入 usage?: Usage,每次校验完响应后调用 addUsage(totals, response.usage),并在最终结果里附带一份统计值的副本。如果响应中没有 usage 数据,计数器保持不变。
事件负载刻意不包含提示词、工具参数和工具结果。错误信息字符串里可能仍含有敏感数据,导出时需要谨慎处理。这只是一套轻量的内存级埋点方案,并非分布式追踪,也不是持久化的审计日志。
tests/events.test.ts 中的测试覆盖了事件顺序、关联性、用量统计、observer 隔离以及终止事件。
7. 测试失败路径,而不只是正常流程
现在我们的 harness 已经具备了工具校验、执行限制、上下文管理和可观测性。但这些机制之间会相互作用:模型可能返回格式错误的工具调用,取消请求可能在批量处理进行到一半时到达,被拒绝的批次也可能把对话留在无法再发送给模型的状态。最后一个里程碑就是直接测试这些边界情况。
可以在配套仓库中查看最终里程碑:
git switch --detach 07-testing
新测试位于tests/failures.test.ts。测试采用与第一个里程碑相同的脚本化模型,因此即使没有 API key 也能复现失败场景。
信任前先校验模型响应
仅校验工具的参数是不够的。模型适配器还可能返回格式错误的响应,例如缺少content、toolCalls 非数组、参数缺失或调用 ID 重复。新的validateModelResponse() 会在 harness 记录响应或执行任何操作之前,先检查响应信封。
import type { Model, ToolCall } from './types.ts';

/** 在接受模型轮次或执行副作用之前,校验适配器边界。 */
export function validateModelResponse(value: unknown): asserts value is Awaited<ReturnType<Model['generate']>> {
  if (value === null || typeof value !== 'object' || Array.isArray(value)) {
    throw new TypeError('Model response must be an object');
  }
  const response = value as Record<string, unknown>;
  if (typeof response.content !== 'string') throw new TypeError('Model response content must be a string');
  if (response.toolCalls === undefined) return;
  if (!Array.isArray(response.toolCalls)) throw new TypeError('Model toolCalls must be an array');
  const ids = new Set<string>();
  for (const call of response.toolCalls as unknown[]) {
    if (call === null || typeof call !== 'object' || Array.isArray(call)) {
      throw new TypeError('Tool call must be an object');
    }
    const item = call as Partial<ToolCall>;
    if (typeof item.id !== 'string' || !item.id.trim()) throw new TypeError('Tool call id must be a nonempty string');
    if (typeof item.name !== 'string' || !item.name.trim()) {
      throw new TypeError('Tool call name must be a nonempty string');
    }
    if (!Object.hasOwn(item, 'arguments')) throw new TypeError('Tool call arguments are missing');
    if (ids.has(item.id)) throw new TypeError(`Duplicate tool call id: ${item.id}`);
    ids.add(item.id);
  }
}
在 model.generate() 之后、追加助手消息或执行工具之前,立即在 try 块中调用 validateModelResponse(response),然后执行 addUsage(usage, response.usage)。如果其中任何一个抛出异常,发出 model_error 并返回 finish('model_error', { error: message }),其中 message 为异常信息。
格式错误的响应将以 model_error 终止,且不会产生任何工具副作用。这与有效工具调用但参数无效的情况不同:后者会变为可恢复的工具错误,允许模型再次尝试。
将拒绝的批次排除在记录之外
测试还捕获了一个真实的集成 bug。此前,harness 在检查批次是否超过 maxToolCalls 之前 就追加了包含工具调用的助手消息。拒绝该批次会在转录中留下未响应的工具调用。
修复方案虽小但至关重要:在记录助手轮次之前检查预算。
if (calls.length > maxToolCalls - toolCalls) {
  return finish('tool_limit');
}
messages.push({
  role: 'assistant',
  content: response.content,
  ...(calls.length ? { toolCalls: calls } : {})
});
这使得预算拒绝操作对于转录而言是原子的。在已接受的批次中发生取消,仍可能留下不完整的终止转录。恢复此类运行需要协调机制。
使用可复现的变化
除了针对格式错误响应、取消和观察者故障的针对性测试外,我们将运行 150 个带有种子的工具批次场景,采用不同的批次大小和预算。固定的伪随机种子确保每次运行都生成相同的序列,从而使故障可复现。
以下示例属于 tests/failures.test.ts。它们共享一个无操作工具和创建格式良好调用的辅助函数:
import { test } from 'node:test';
import assert from 'node:assert/strict';
import { runAgent } from '../src/core/agent.ts';
import { scriptedModel } from '../src/models/fake.ts';
import type { Tool } from '../src/core/types.ts';

const noop: Tool = {
  name: 'noop', description: 'Return a fixed result',
  parameters: { type: 'object' },
  async execute() { return 'ok'; }
};
const call = (id: string) => ({ id, name: 'noop', arguments: {} });
第一组测试把预算从 0 变化到 8、批次大小从 0 变化到 12,检查工具执行次数、终止状态,以及被拒绝的调用是否没有进入对话记录:
test('seeded batches respect tool budgets', async () => {
  let seed = 0x12345678;
  const next = () => {
    seed ^= seed << 13;
    seed ^= seed >>> 17;
    seed ^= seed << 5;
    return seed >>> 0;
  };

  for (let i = 0; i < 150; i++) {
    const limit = next() % 9;
    const batch = next() % 13;
    let executed = 0;
    const result = await runAgent({
      prompt: 'test', maxToolCalls: limit,
      tools: [{
        ...noop,
        async execute() { executed++; return 'ok'; }
      }],
      model: scriptedModel([
        {
          content: '',
          toolCalls: Array.from({ length: batch }, (_, j) => call(`call-${j}`))
        },
        { content: 'done' }
      ])
    });

    const admitted = batch <= limit;
    assert.equal(executed, admitted ? batch : 0, `case ${i}`);
    assert.equal(result.toolCalls, admitted ? batch : 0, `case ${i}`);
    assert.equal(
      result.status, admitted ? 'completed' : 'tool_limit', `case ${i}`
    );
    if (!admitted) {
      assert.deepEqual(result.messages, [{ role: 'user', content: 'test' }]);
    }
  }
});
预算内的批次会执行全部请求的工具,超出预算的批次则一次都不执行。case 标签用来标识失败时对应哪个随机生成的场景,固定的随机种子则让我们能够复现该场景。
另外 60 次运行验证工具抛出的异常依然是可恢复的错误。这些测试用不同的错误信息重复走同一条失败路径,不使用随机种子变化:
test('tool exceptions remain recoverable', async () => {
  let executed = 0;
  for (let i = 0; i < 60; i++) {
    const result = await runAgent({
      prompt: 'test',
      tools: [{
        ...noop,
        async execute() {
          executed++;
          throw new Error(`failure ${i}`);
        }
      }],
      model: scriptedModel([
        { content: '', toolCalls: [call('1')] },
        { content: 'recovered' }
      ])
    });
    assert.equal(result.status, 'completed');
    assert.equal(result.answer, 'recovered');
    assert.ok(result.messages.some(message =>
      message.role === 'tool' && message.isError &&
      message.content === `failure ${i}`
    ));
  }
  assert.equal(executed, 60);
});
种子场景属于性质式检查,而异常测试则反复验证特定的恢复路径。这两者都无法证明系统完全正确,也替代不了操作系统级的沙箱隔离,但它们在无需调用实时模型的情况下运行,能为我们提供关于执行框架行为的可复现证据。
至此,我们已将执行框架从一个简单的模型/工具循环,构建为一个负责校验、权限、限制、上下文和遥测的执行层。模型依然负责提出行动建议,但决定实际发生什么的,始终是执行框架。
运行这些示例只需执行 npm test。仓库中包含了针对上述边界情况的额外测试用例,以及完整的里程碑实现代码。
下一步:接入真实的大语言模型
在整个教程中,我们使用的是脚本化模型,而非调用真实的 LLM。这是有意为之:确定性的响应让我们无需网络请求、API 密钥或不可预测的模型行为,即可测试执行框架,包括其失败路径。
但 Model 接口的设计初衷就是让不同提供商可以互换。接入 OpenAI、Anthropic 或其他提供商,并不需要重写智能体循环逻辑。我们只需要一个适配器,负责在提供商 API 和我们现有的类型之间进行转换。
例如,一个使用 Responses API 的 OpenAI 适配器可能长这样:
// src/models/openai.ts
import OpenAI from 'openai';
import type { Model } from '../core/types.ts';

export function openAIModel(client: OpenAI): Model {
  return {
    async generate({ messages, tools, signal }) {
      const response = await client.responses.create(
        {
          model: 'YOUR_MODEL',
          input: toOpenAIInput(messages),
          tools: toOpenAITools(tools),
        },
        { signal }
      );

      return {
        content: extractText(response),
        toolCalls: extractToolCalls(response),
        usage: extractUsage(response),
      };
    },
  };
}
这只是架构草图,并非完整的适配器。其中的转换函数负责将我们的消息和工具定义转为提供商的格式,并标准化其响应。特别是,必须保留工具调用 ID,解析工具参数,并在后续请求中将工具结果与正确的调用关联起来。
适配器还会转发 harness 的 AbortSignal,使取消操作能传递到 API 请求。Provider 的错误会转化为异常,harness 已将其作为 model_error 结果处理。
一旦适配器实现了 Model,系统的其余部分保持不变。无论哪个 provider 生成下一次响应,同一套工具注册表、参数校验、执行预算、上下文管理和可观测性机制都能照常工作。
还有进一步值得探索的改进方向:provider 专属的 token 计费、API 重试与限流处理、持久化会话历史,以及运行不可信代码时更强的进程隔离。这些本身就是复杂的工程难题,但它们能融入我们已确立的边界,无需改变整体架构。
完整实现可在 07-testing 里程碑获取。
我们构建的不仅仅是一个向模型发送提示词并执行函数的循环。我们构建的是一套机制,它决定哪些操作被允许、能执行多少工作量、模型接收何种上下文、以及故障如何被处理和观测。
这正是带工具的语言模型与 agent harness 之间的本质区别。