Hugging Face 携手 TorchTPU:让 TPU 成为 PyTorch 原生设备
如果你曾尝试在 TPU 上运行 PyTorch,多半是把代码移植到了 torch_xla,或者不得不转头去学 JAX。有了 TorchTPU 这个原生 PyTorch 后端,TPU 现在成了又一个普通设备。它让 Hugging Face 生态实现了对 TPU 的原生支持。Transformers、Diffusers 和 Kernels 都能直接在 TPU 上运行。从 Hub 挑个模型,把它放到 "tpu" 上,完事。
等等,TPU 是什么?🤔
TPU 即 张量处理单元。TPU 是 Google 自研的 AI 加速器。这些芯片只干一件事:矩阵运算,这正是神经网络大部分时间花在上面的活。Google 设计 TPU 已约十年,并用它们训练和部署自家模型,包括 Gemini。
TPU 可在 Google Cloud 上获取,从单芯片到由数千芯片组成的 Pod 集群均有。当需要海量算力来做训练或大规模推理时,TPU 最能发挥优势。
但麻烦一直出在软件上。TPU 的软件栈围绕 TensorFlow 和 JAX 构建,PyTorch 用户想上手得费点劲。
以前的路子
在此之前,在 TPU 上跑 PyTorch 得走 PyTorch/XLA (torch_xla)。虽然能用,但怪癖不少。张量是惰性的(张量惰,人别惰),所以代码并不总按你想象的时机运行。一点小改动就可能触发图重编译,调试起来很难理清因果。
为了让事情简单点,我们做了 Optimum TPU,为 Hugging Face 模型在 TPU 上提供推理和训练支持。现在 TorchTPU 带来了原生支持,用 Transformers 和 Diffusers 跑 Hugging Face 模型时,Optimum TPU 已不再必需。
TorchTPU 登场 🚀
TorchTPU 把 TPU 作为新后端加入 PyTorch。你照常用 PyTorch 写代码即可。它自带为 TPU 调优的 Pallas 内核,支持分布式训练,还有 torch.compile 集成供你追求更高速度时使用。在 TPU VM 上安装只需一条命令:
pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpu
额外指定 index 是为了拿 torch 的 CPU 构建版。不指定的话,pip 会拉取体积大得多的 CUDA 构建版,而 TPU 上用不着。
你常用的库,现在也能跑在 TPU 上
Transformers
Transformers v5 的核心理念只有一个:成为模型定义的唯一权威来源,让模型可以随处运行。而“随处”现在也包括 TPU。要在 TPU 上加载模型,只需传入 device_map="tpu",就这么简单。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.5-9B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu", # will load model directly on the TPU
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer("The future of AI is", return_tensors="pt").to("tpu")
out = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(out[0], skip_special_tokens=True))
模型默认以 eager 模式运行。你也可以使用 torch.compile 提升性能,或者在分布式环境下运行。
图像?视频?Diffusers 在 TPU 上作画 🎨
TPU 现已是 Diffusers 中的一等公民设备。原型开发或调试时,eager 模式只需一行 pipe.to("tpu")。部署时,编译模式只需额外加一次 compile 调用。你的 pipeline 和代码保持不变,也不用维护单独的 TPU 分支。
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-medium", dtype=torch.bfloat16
)
pipe.to("tpu")  # eager mode: that's the whole change
# optional: compiled mode
pipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False)

image = pipe("a corgi astronaut planting a flag on a pizza moon").images[0]
第一次调用会触发编译,之后相同尺寸的图片会直接复用已编译的计算图。
模型大到单芯片装不下?给 from_pretrained 传入一个 TensorParallelConfig,transformer 就会在加载时切分到多块芯片上,无需整个模型挤在一个设备里。许多常用 pipeline 开箱即用,不支持的也只需加上一个 tp_plan 即可。完整教程见 Diffusers TPU 指南。
以下是在 Cloud TPU v6e-4 上运行的一些示例:
TP=4(每个模型切分到四块芯片)· bf16 · batch 1
| MiniMax-H3(视频 + 音频) | Qwen-Image-2.1 | |
|---|---|---|
 |
 |
|
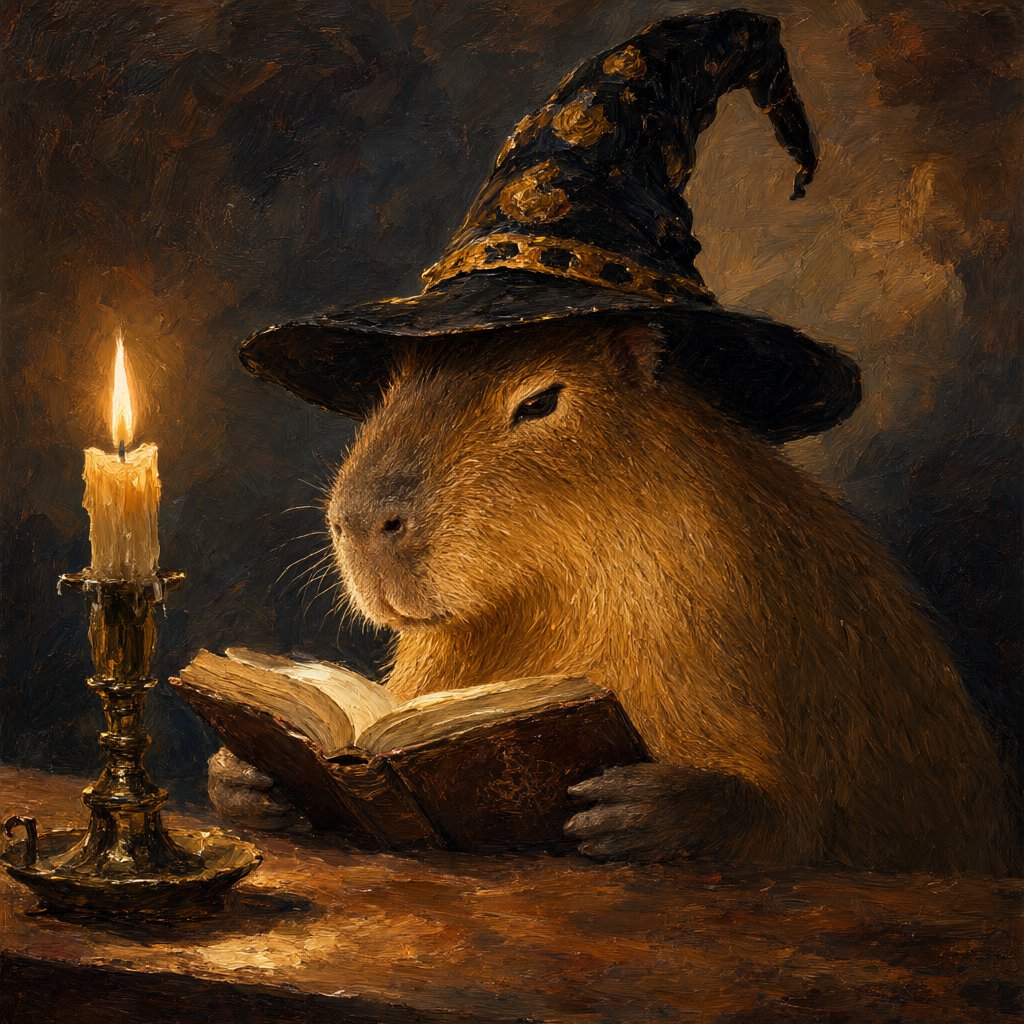
| “图片中那只毛茸茸的 Hugging Face 吉祥物——圆脸、笑眯眯、脸蛋红润、双手摊开——站在一艘古希腊三列桨座战船的船头[…] 海浪拍击声、木板吱呀声、索具中的风声、远处海鸥的鸣叫,以及一段低沉而宏大的管弦乐渐强。” · 1344×768,5.2 秒,49 步 · 编译后耗时 188 秒,纯 eager 模式耗时 262 秒 | “戴巫师帽的水豚,在烛光下读书,油画风格” · 1024×1024,40 步 · 编译后耗时 3.5 秒,纯 eager 模式耗时 8.0 秒 | “霓虹招牌上写着 'QWEN IMAGE 2.1',雨夜,湿漉漉的路面映出倒影” · 2048×2048,40 步 |
Kernels
Kernels Hub 提供了现成的 TPU kernel。通过 Kernels 库加载其中一个,即可让模型提速。
TPU kernel 使用 Pallas 编写,提供了对底层硬件的精细控制。你也可以引入 Tokamax 库中的 kernel。下面展示了一个来自 Tokamax 的 ragged-dot kernel 在 Mixture-of-Experts 模型中的应用:
from kernels import get_kernel
from transformers import AutoModelForCausalLM
from transformers.integrations.moe import ALL_EXPERTS_FUNCTIONS

repo_id = "tengomucho/ragged-dot-tpu"
kernel = get_kernel(repo_id, version=1, trust_remote_code=[repo_id])
ALL_EXPERTS_FUNCTIONS.register("tokamax_ragged_dot", kernel.experts_forward)
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-30B-A3B-Instruct-2507",
    experts_implementation="tokamax_ragged_dot",
)
批次越大,收益越显著。当 batch size 为 64 时,Qwen3-30B-A3B 的解码速度提升 21.5 倍,Gemma 4 26B-A4B 提升 12.8 倍。
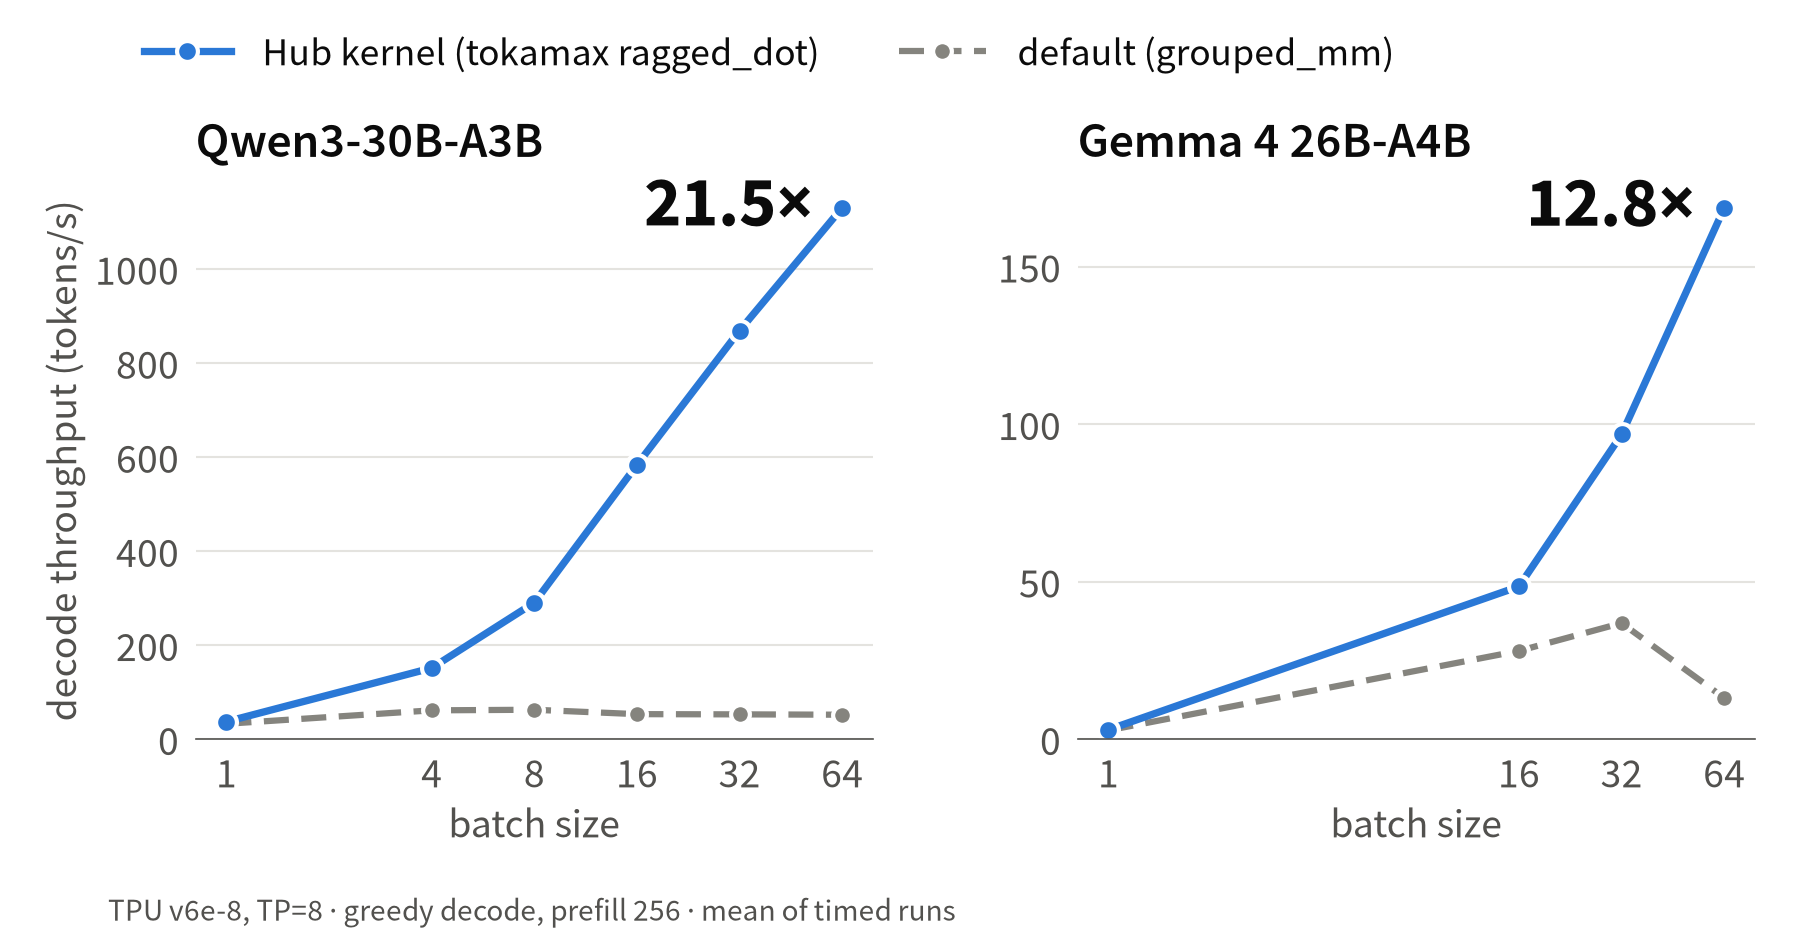 TPU v6e-8 上的解码吞吐量,Hub 内核与默认实现对比。
我们先测,省得你操心 🧪
我们通过运行库测试套件持续改进 transformers 对 TPU 的支持。目前正努力在 TPU 上添加夜间 CI(持续集成),并将结果呈现在 transformers 仪表盘 中。
 Transformers CI 仪表盘,TPU 结果与其他加速器并列展示。还在完善中!
目前还不是全绿,但这没关系。在 TPU 上运行的测试中,96.5% 已通过。我们发现的每个失败用例都会变成一个小的复现脚本,并在 TorchTPU 仓库中创建 issue。截至目前已报告 34 个问题,其中 19 个已修复。在 TPU 上运行还发现了几处 Transformers 自身的 bug,例如 StaticCache 和 Qwen3 张量并行方案中的问题,我们已在上游修复。
如果在 TPU 上出现问题,我们希望在用户之前先发现。
快速上手
TPU 不再是 PyTorch 用户的小众选项。安装 TorchTPU,从 Hub 获取模型,并将其发送到 "tpu"。
迫不及待想看看你会构建什么 🤗。如果遇到任何问题,请提交 issue 并告知我们。