
深度体验一周后,Nvidia RTX Spark 芯片的小身材大能量令我印象深刻
本月初,我有幸参加了 Nvidia 在旧金山举办的 RTX Spark 发布会,亲眼见识了这块“超级芯片”的诸多本领。此后的这段时间,我几乎把所有醒着的时间都花在了测试这款基于 ARM 的 RTX Spark 上,想弄清楚它到底和以往那些芯片有什么不同。
RTX Spark 是 Nvidia 首款系统级芯片(SoC),把 18 核 CPU 和 5120 个 CUDA 核心的 Blackwell RTX GPU 集成在一起(高配版则是 20 核 CPU 加 6144 核心显卡),整体思路与 Apple 的 M 系列芯片如出一辙。Apple 芯片一直以强劲著称,而得益于 Blackwell RTX GPU,RTX Spark 在游戏性能上同样不容小觑。
具体数据如何?这块芯片的内在确实大有乾坤——我拿到的 RTX Spark N1X 在 CPU 中塞进了 20 个核心。在 Geekbench 7.1 测试中,它的单核成绩为 2623 分,略低于 Apple M5 的 4288 分,但多核成绩高达 21989 分,远超后者的 17926 分。这意味着在内容创作、软件开发和 AI 等任务上,它能给你更充足的算力支撑。
Latest Videos FromTechRadar观看完整视频:既然 RTX Spark 在 agentic AI、创意工作流和游戏方面都颇有潜力,那我们就逐一看看它在这些领域的实际表现。
混合式 agentic AI
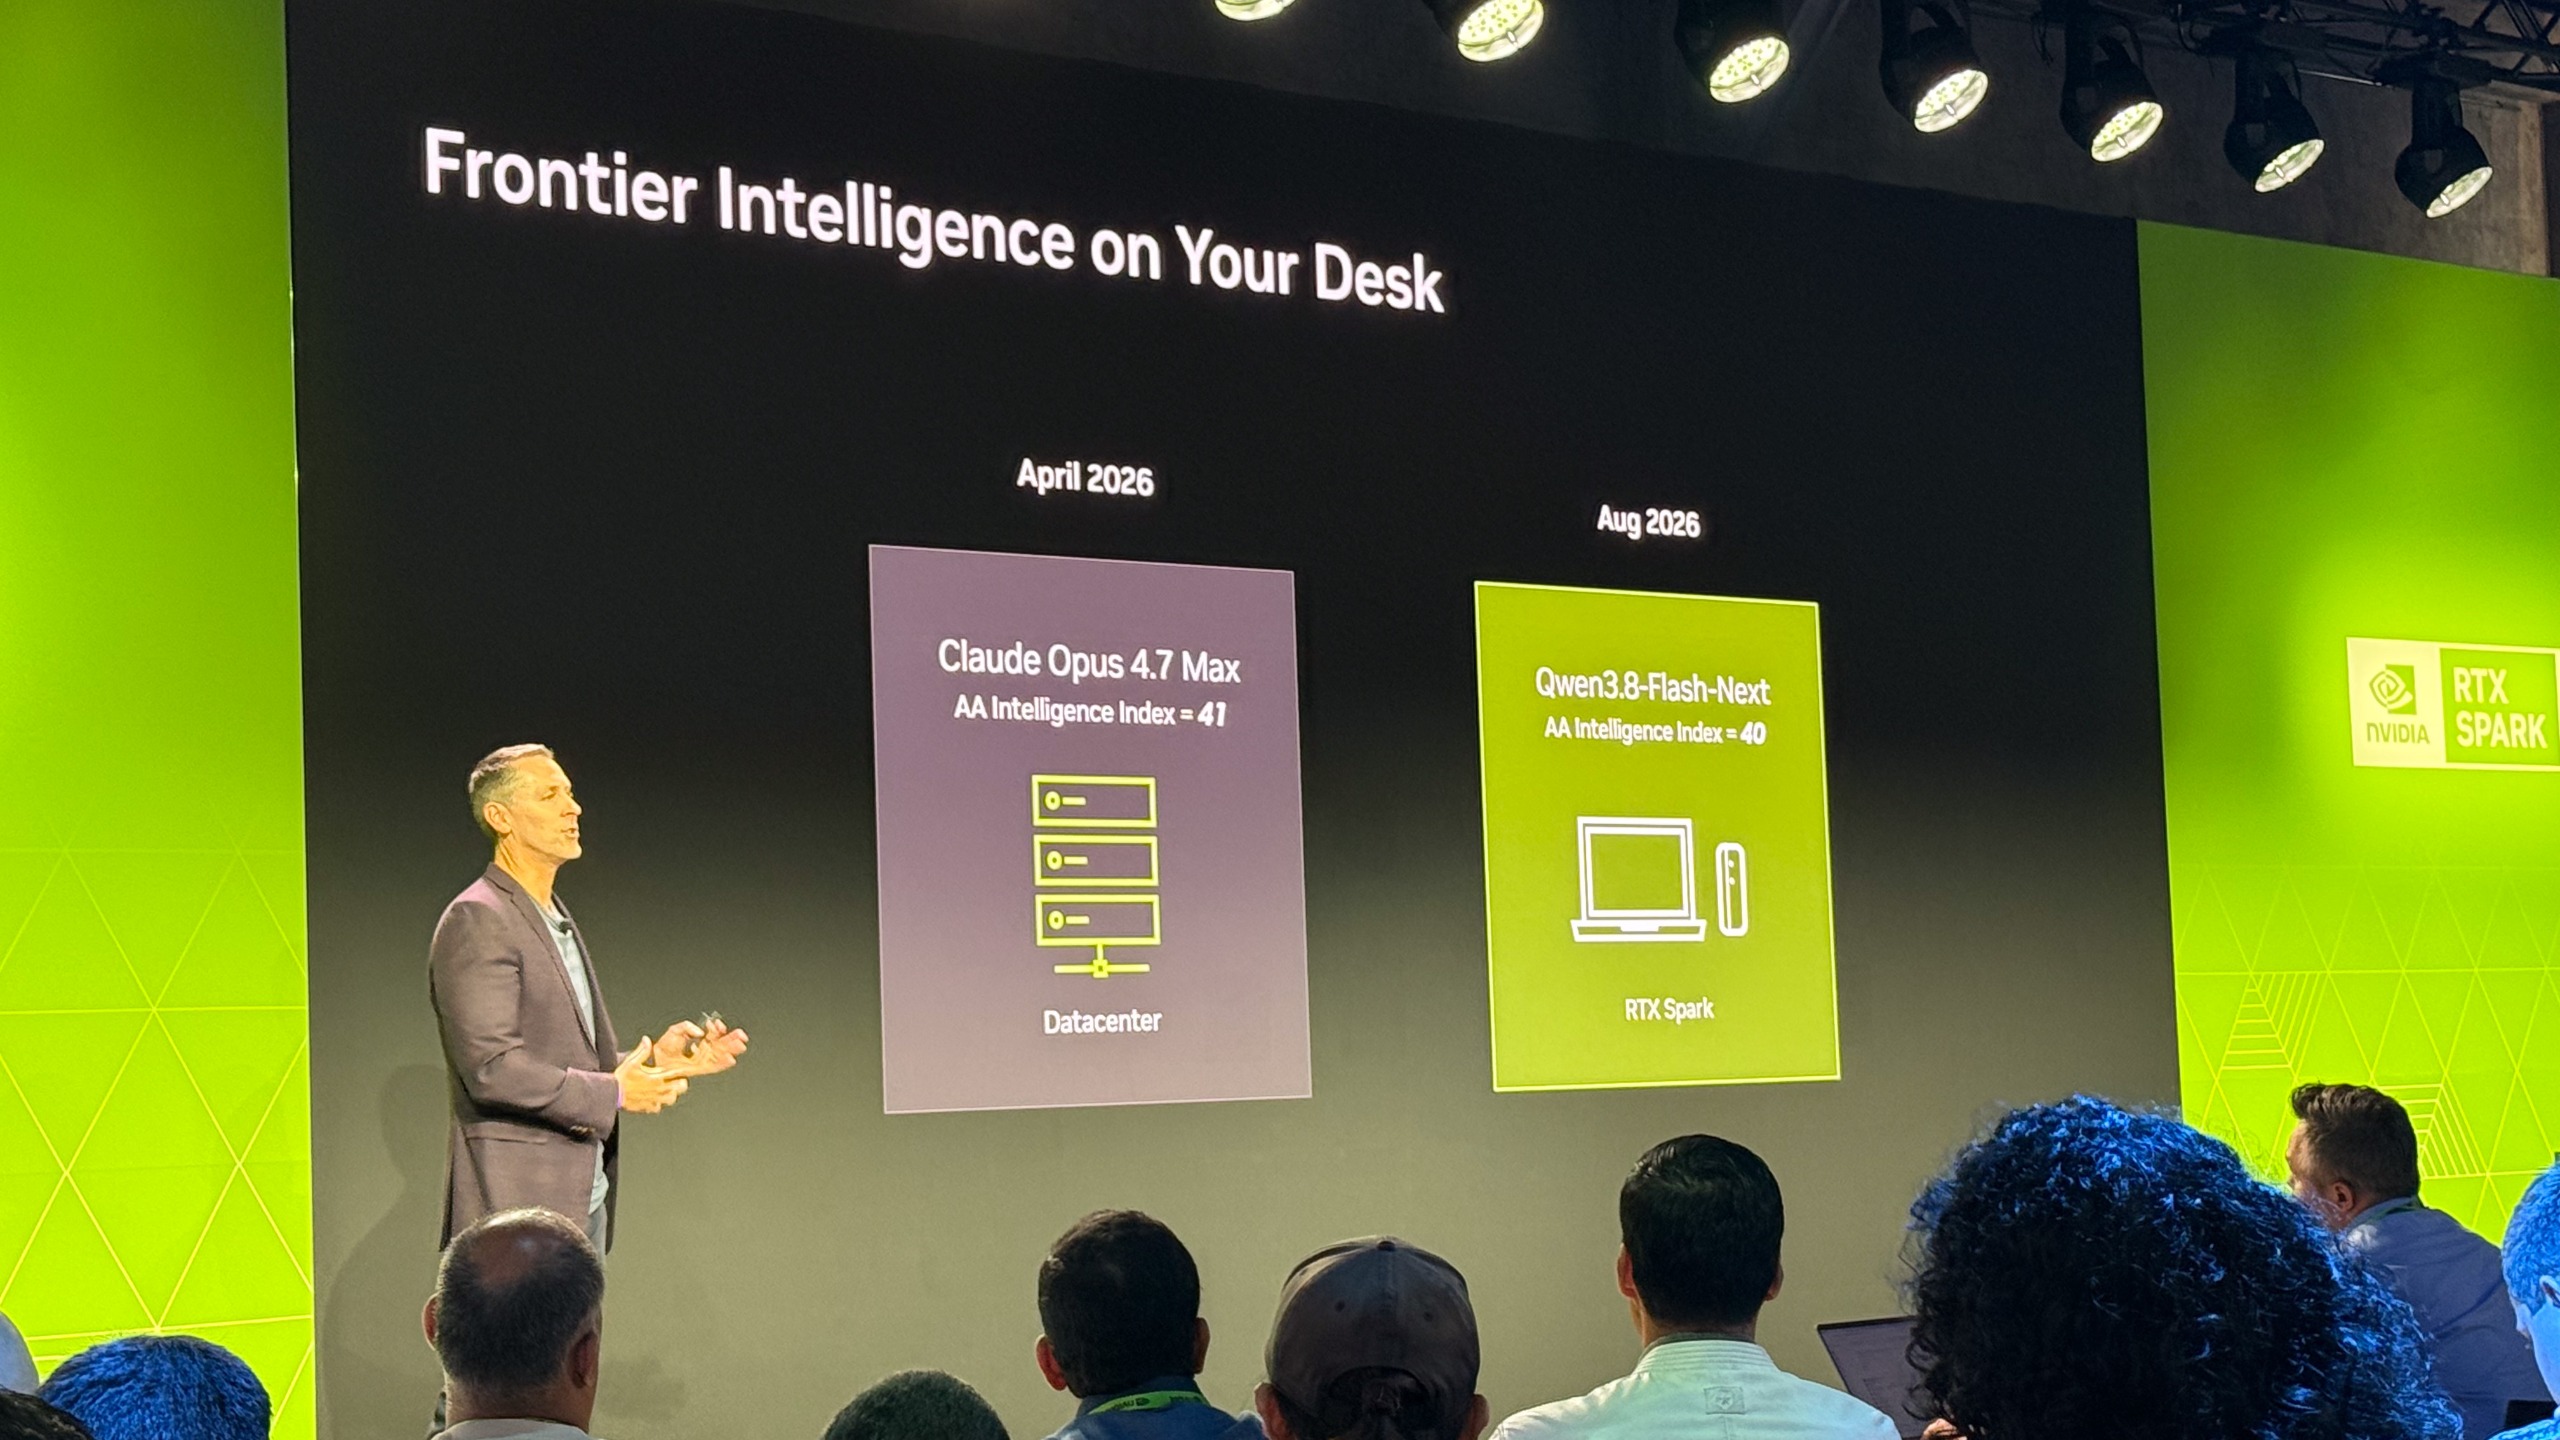
Nvidia 在 RTX Spark SoC 的发布会上重点强调了它在混合式 agentic AI 方面的潜力。诚然,云端 AI 模型非常强大,但把最私密的数据上传到云端,我在安全性上难免有所顾虑,而且对于这些模型背后的公司,我也不敢全然放心去信任。
使用本地开源模型,既能自主审查,又绝不会将敏感数据传出局域网,这显然是一种更安全的替代方案。但并非所有人都希望彻底切断与前沿模型的连接。因此,Nvidia 为 RTX Spark 引入了混合系统架构。
RTX Spark 支持的这种混合工作流程允许你选择特定的本地模型并将其限定在 agentic 工作流的某些环节,同时将高耗时的特定任务外包给云端前沿模型。这样一来,用户就能采取更精细化的策略,精确决定在公共模型和私有模型之间如何分配依赖程度。
对于热衷于通过 vibe-code 开发复杂产品或生成高要求 3D 场景的用户而言,不必在宽松的 YOLO 模式和彻底的封闭模式这两种二元安全选项中做取舍,这种灵活性将极具价值。
经过多日的 RTX Spark 实操体验,其 agentic 表现是否兑现了承诺?为了获得全面视图,我运行了 MLPerf Client 基准测试,模拟了使用 Qwen 3 8B 本地模型的数据分析师和 SWE agentic 工作流。测试显示,单次运行平均耗时分别为 63.7 秒和 50.8 秒,分别处理了 14,005 和 10,238 个 tokens。
我还利用 ComfyUI 测试了一些生成式图像和视频工作流。在测试使用 Flux2.Dev(NVFP4)和 Flux2.Klein 4B Base(NVFP4)模型进行图像生成时,耗时分别为 46.5 秒和 16.2 秒;而使用 LTX 2.5(Distilled)NVFP4 模型则耗时 88 秒。这与 Nvidia 此前承诺的表现大致相符,也展示了 RTX Spark 利用本地模型生成媒体内容的速度之快。
仅凭原始数据只能了解一部分信息。因此,我花了数天时间,使用 Hermes 和 Qwen3.8 27B 开源本地模型训练了自己的 AI agent,以探索 RTX Spark 的实际能力。
毫无疑问,在“额外高”设置下,它确实强悍地搞定了一些任务。我喂给它一批 CSV 格式的解析数据,让它整理电子表格、分析数据并呈现关键发现。经过 12 分钟的思考和微调,它顺利输出了一张数据透视表和一些数据观察结论。虽然它的分析结果让我没什么惊讶——毕竟我已经花了好几个月啃这份数据——但它在没有任何敏感信息离开笔记本电脑的情况下,就能精准锁定核心要点,这一点确实令人印象深刻。
不过,有些实验需要我多一点耐心,并不断调整 Agent 的工作流才能拿到最优结果。第一次我让 Hermes Agent 连接在线邮箱客户端,并生成当日邮件摘要时,它花了 75 分钟尝试各种方法与 Outlook 在线客户端交换 Token,最后意外崩溃。第二次我稍微主动一些,在它跑偏或遇到瓶颈时及时提供反馈,最终它在 70 分钟内成功完成了任务设置。
所以,只要有耐心并给出得当的提示词,利用本地模型完全能拿到不错的结果。而且,你不必每次都经历这一整套流程——让 Hermes 把某些操作保存为 Skill(技能),以后就能自动执行,甚至可以直接把它设置为定期触发的 Cron Job。你甚至可以让它研究如何优化现有技能的效率,这样未来运行所需的时间和资源就会进一步降低。
创意工作流
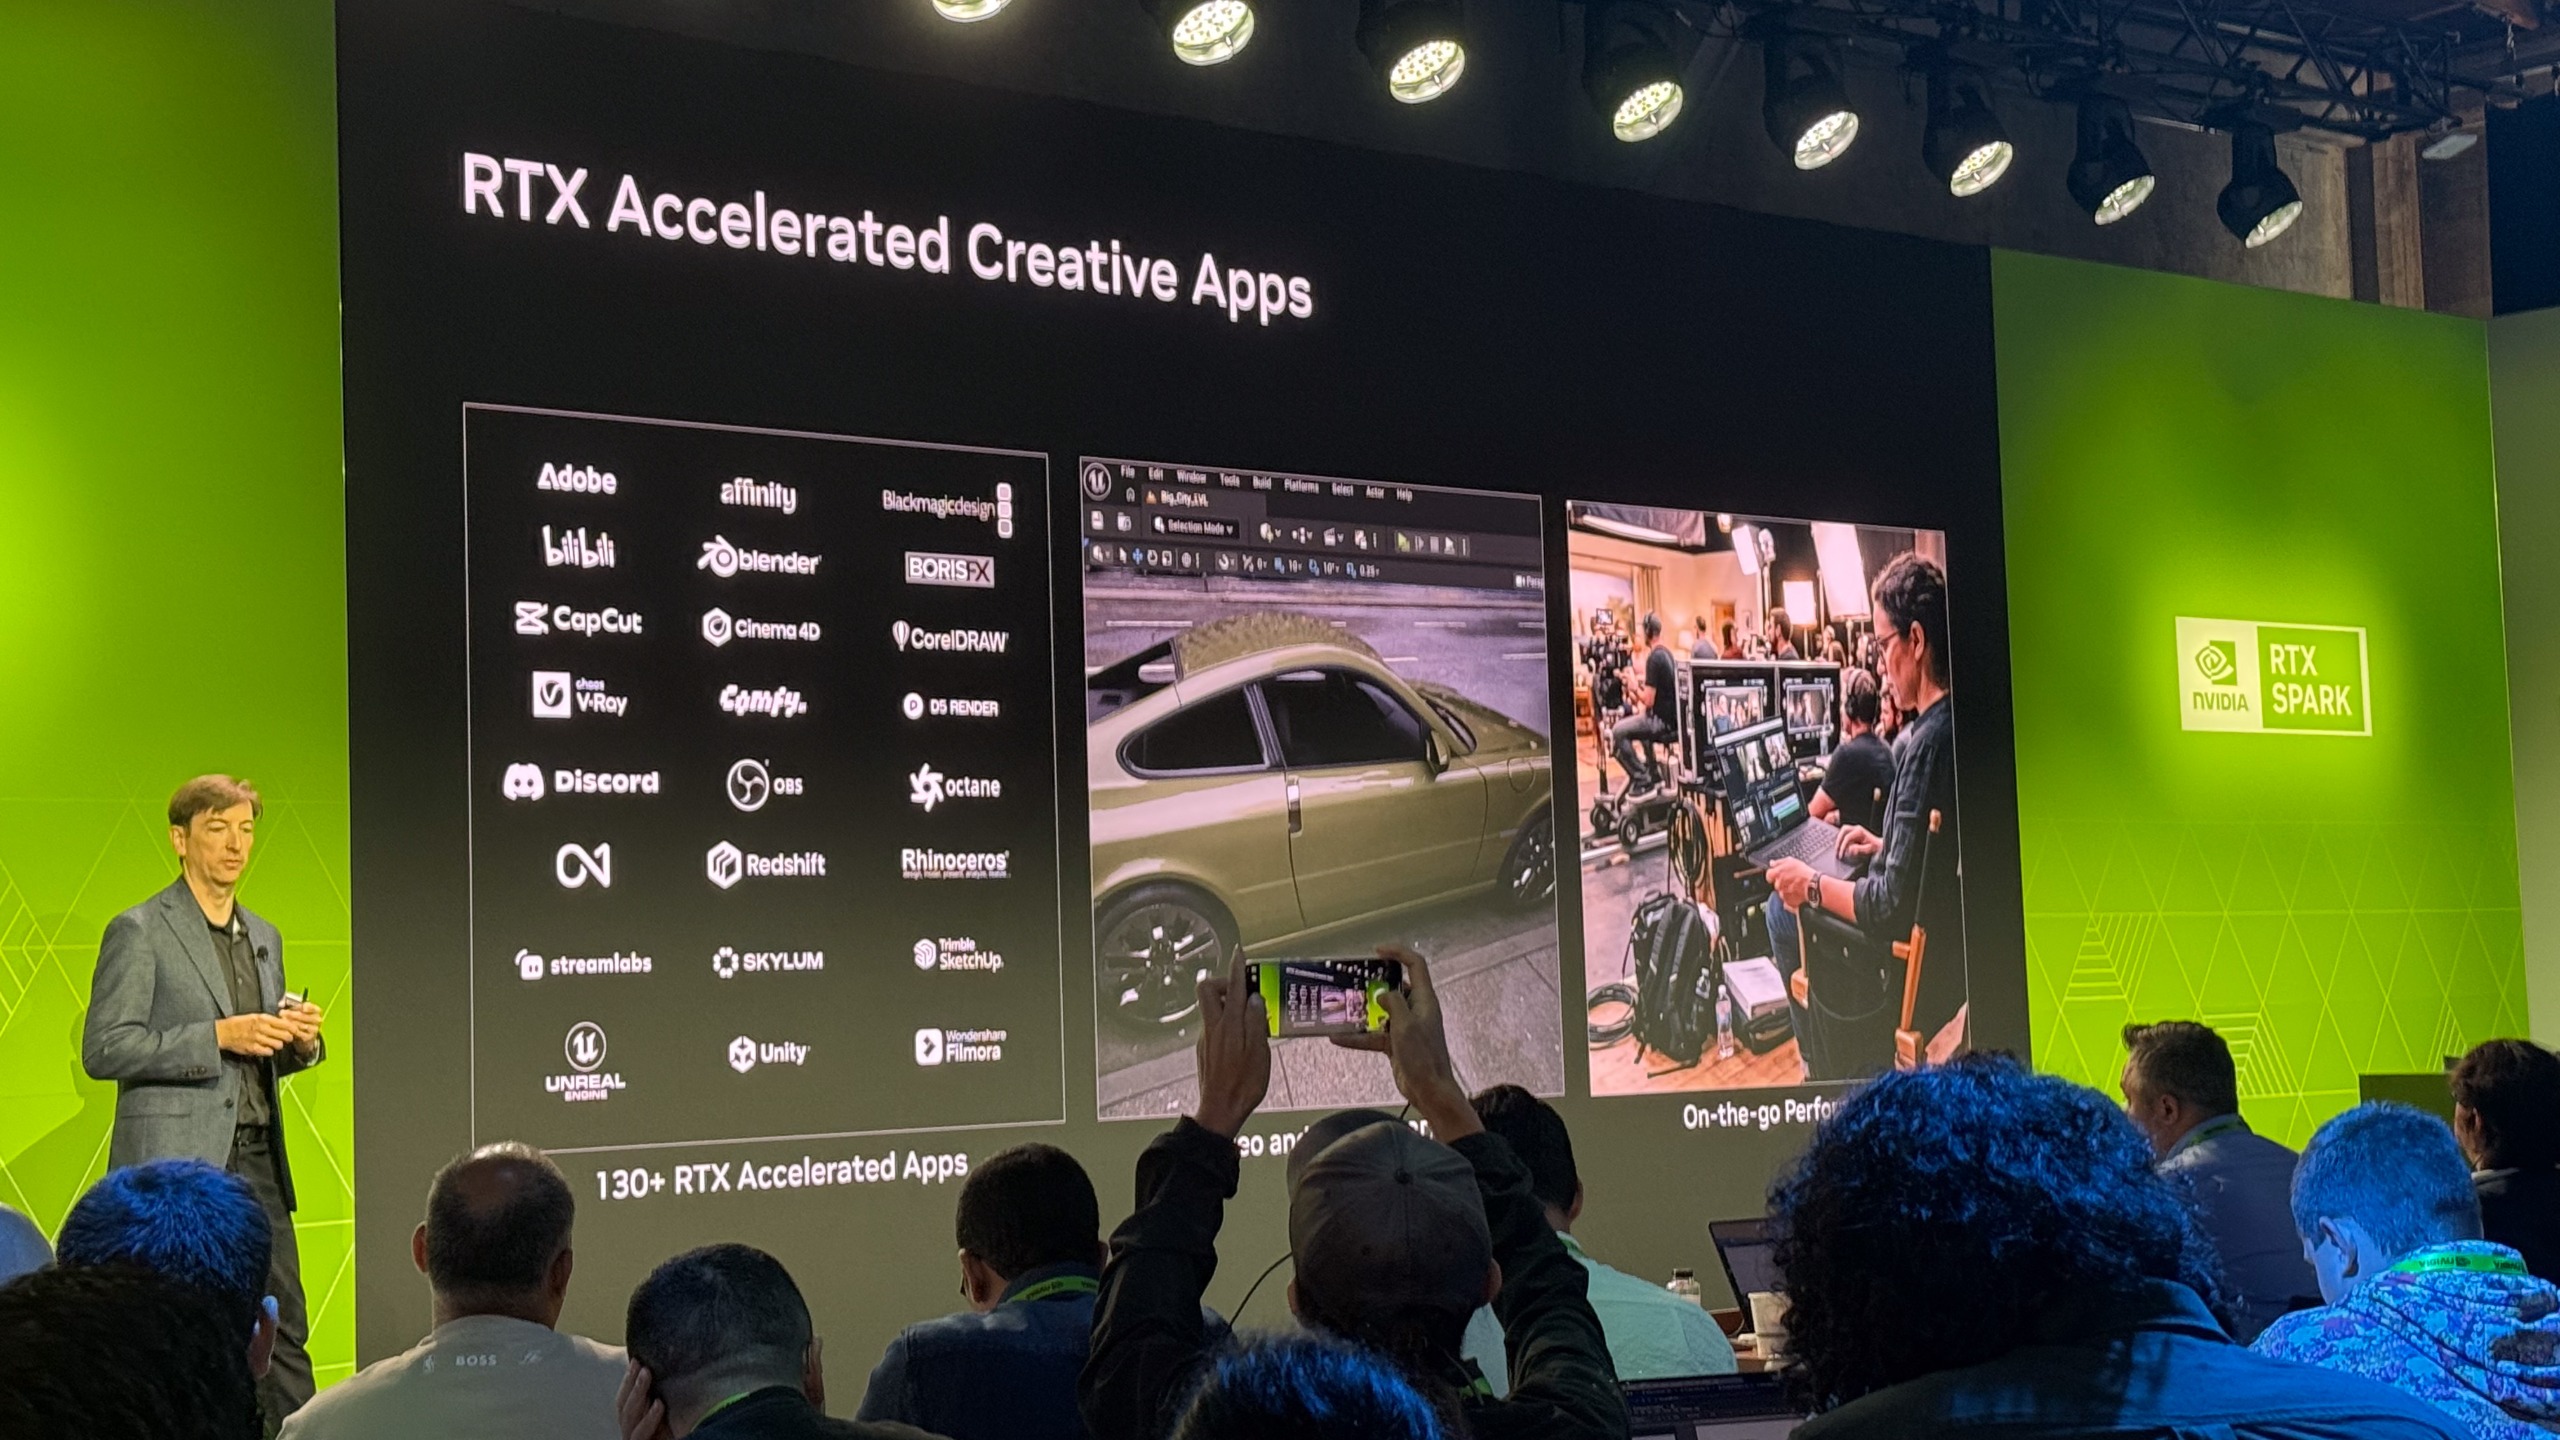
你大概会觉得,RTX Spark 笔记本电脑的重心完全在 AI 工具上。但事实恰恰相反:尽管围绕这款芯片的大量报道都在谈论它的 Agentic AI 能力,但这绝不是它唯一的亮点。
RTX Spark 被用在最新的 Asus ProArt P16 上,足见创作是这款新 SoC 的一大重点。即便你对它在生成式 AI 上的能力不感兴趣,光是支持 RTX 的创作软件数量——Blender、Adobe Creative Suite、Canva、Unity——就足以说明有多少创作领域巨头在为新 SoC 背书。
为了检验 RTX Spark 的创作性能,我用 PugetBench 在 Photoshop 和 Premiere Pro 中自动执行了一系列任务。PugetBench 的标准 Photoshop 工作流耗时 10.83 分钟,得分 11801;标准 Premiere Pro 流水线耗时 8.12 分钟,得分 76234,稳稳达到了真正的创作工作站水准。这个成绩大致与 Apple 的 M5 芯片处于同一区间——后者分别得分 13755 和 69887。RTX Spark 在复杂视频处理上胜出,但在静态图像方面还略逊一筹。
对于在工作中使用生成式 AI 的用户,我还用 ComfyUI 测试了一些生成图像和视频的工作流。使用 Flux2.Dev(NVFP4 和 Flux2.Klein 4B Base)NVFP4 模型生成图像时,分别耗时 46.5 秒和 16.2 秒;LTX 2.5 (Distilled) NVFP4 模型则耗时 88 秒。这与 Nvidia 此前的宣传基本一致,展现出 RTX Spark 用本地模型生成媒体内容的速度之快。
虽然我既不是摄影师也不是 Blender 高手,但折腾静态图片也有几十年了,于是翻出一个旧的 4K、300dpi 的 Photoshop 文件。它本来就相当庞大,包含大量高分辨率图层、剪贴蒙版和调整图层,我还把图层数量翻了三倍,又加了一堆滤镜和特效。结果处理时间仍不到一秒,即使把图像尺寸减半也只花了约五秒——考虑到我操作的图层和分组数量之多,这个表现相当惊艳。
借助Nvidia与Adobe近期公布的合作计划,RTX Spark甚至有望加速这些应用内置的AI工具。Adobe承诺通过优化软件以充分利用该芯片的GPU算力,搭载RTX Spark的笔记本电脑在AI处理、编辑、调色及特效方面可实现两倍的性能提升。对于将这些AI工具纳入日常工作流的用户而言,这无疑是一大利好。
游戏体验

鉴于Nvidia在游戏领域的深厚背景,RTX Spark芯片组自然也将游戏性能视为重点。由于大多数游戏运行在x86架构上,SoC(系统级芯片)过去并非游戏设备的理想载体。但Nvidia在这一领域的影响力足以推动众多开发商在10月16日芯片发布时同步推出支持RTX Spark的本地版本,例如《赛博朋克2077》、《毁灭战士:黑暗纪元》以及《007:初露锋芒》;而《使命召唤》系列则定于2027年登陆该平台。对于尚未适配的游戏,Prism模拟技术也能让用户以极小的CPU性能代价运行大量标题。
在游戏性能方面,RTX Spark的表现绝非平庸。其3DMark Port Royal得分为8,133,Steel Nomad得分为2,846,Speed Way得分为2,872。这一成绩略低于配备Nvidia GeForce RTX 5070 Ti的华硕Zephyrus G14,后者三项得分分别为10,119、3,488和4,031。但与大多数仅配备集成显卡的笔记本相比,它的优势非常明显——例如搭载RTX Spark之前的戴尔 XPS 16,其对应得分仅为3,888、1,488和916。
虽然这些模拟基准测试有助于了解游戏性能的大致情况,但实际游戏内的基准测试才是洞察真实游戏表现的最佳途径。在测试 RTX Spark 时,《赛博朋克 2077》在 1080p 分辨率、光线追踪“极致”画质下稳定运行在 30.16fps;《毁灭战士:黑暗纪元》在 1080p 下平均帧数为 48.58fps——这与搭载 Nvidia GeForce RTX 5060 的华硕 TUF Gaming A14 测得的 32.33fps 和 55.63fps 非常接近。
不过,没有什么比亲自动手玩游戏更直观的了,所以我启动了几款喜欢的游戏进行测试。说实话,《赛博朋克 2077》即使使用上述光线追踪“极致”设置也颇具可玩性,一旦切换到“中等”光线追踪设置,画面便能流畅地运行在 60fps。
与此同时,在“极致”画质下运行 战争机器:E-Day 体验极其顺滑,就像芝麻酱淋在大理石台面上一样流畅。在对抗兽群一波又一波的进攻时,即便在“极致”设置下也没有任何明显的卡顿,动作始终保持在 115fps 以上,流畅度极高。虽然它在绝对性能上可能无法匹敌 RTX 5090,但对于除顶尖电竞玩家外的任何人来说,这款芯片依然有着不少值得称赞之处。
尽管它自然无法达到像 MSI Vector A18 HX A9W 等专用游戏笔记本那样的性能水平,但我依然对 RTX Spark 芯片的游戏表现印象深刻。当你将其与类似的轻薄 SoC 系统对比时,这种优势会更加明显。虽然 MacBook Pro M5 在创意性能方面同样令人印象深刻,但它在《赛博朋克 2077》光线追踪“极致”设置下,帧率勉强只能达到 11.5fps。
因此,如果你寻找的是一款不仅能胜任某项特定任务,还能在所有操作中提供出色表现的芯片组,RTX Spark 已证明它是一个坚实的选择。
