TorchNeuron:让 HF 模型在 AWS Trainium 上运行更简单
TorchNeuron 为 AWS Trainium 上的 PyTorch 提供了全新的原生后端。Transformers、Diffusers 和 Kernels 原生支持该后端,使得在 Trainium 上运行模型以及在 HF 模型库上分享模型变得前所未有的简单。
TorchNeuron
TorchNeuron 是一个 PyTorch 插件,为 Trainium 引入了新后端,支持 eager 模式、torch.compile 以及 FSDP 和 TP 等原生分布式 API。阅读 PyTorch 博客 以了解 TorchNeuron 的更多细节。
自 2026 年 10 月 20 日起,TorchNeuron 将以公共测试版形式提供。研究人员和开发者可以通过 pip install torch-neuronx 安装它。
全新后端,HF 库的原生接口
迄今为止,在 AWS Trainium 和 Inferentia 上使用的 Hugging Face 体验(分别专为大规模成本效益训练和推理设计的 AI 芯片)一直通过 optimum-neuron 实现。该库依赖于基于 PyTorch XLA 的 torch-neuronx 包。在当时,这是一个自然的选择,但这意味着需要像编译器那样思考:使用惰性张量而非 eager 执行,仅支持静态形状,且每次遇到 graph break 都要重新编译。Optimum Neuron 的存在就是为了隐藏这些复杂性,并维护自定义代码(如 modeling 类和 trainers)来实现这一点。
TorchNeuron 改变了这一现状。它直接集成到 PyTorch 中,将 neuron 暴露为原生设备,支持 eager 执行、PyTorch 自身的分布式原语(DTensor、FSDP2)以及 torch.compile。
对于 Hugging Face 库而言,Trainium 变成了一个与其他设备无异的存在:Transformers、Diffusers、Accelerate、PEFT 和 TRL 可以直接在其上运行,使用与其他加速器相同的类和脚本。从现在开始,我们建议 Neuron 用户直接使用这些库,而不是通过 Optimum Neuron。
Transformers
推理
Transformers 现已原生支持多种模型的文本生成。借助 TorchNeuron,最受欢迎的前 100 种文本生成模型架构中有 89% 开箱即用,而 Optimum Neuron v0.4.5 仅为 46%。你只需在代码中传入 device_map=neuron 参数,模型即可部署到 Neuron 设备上。
下面展示一个结合张量并行(tensor parallelism)的文本生成示例,这有助于充分利用你的 Neuron 实例性能。请注意,示例中采用了静态缓存(static cache)进行生成,因为在 Neuron 上强烈建议使用静态缓存,以避免频繁的重编译。
import os

import torch
import torch.distributed as dist
import torch_neuronx  # noqa: F401
from torch.distributed import DeviceMesh
from transformers import AutoModelForCausalLM, AutoTokenizer, GenerationConfig
from transformers.distributed import DistributedConfig
from transformers.generation.configuration_utils import CompileConfig

MODEL_ID = "Qwen/Qwen3.8-27B"
MAX_SEQ_LEN = 1024
PREFILL_CHUNK_SIZE = 512

dist.init_process_group(backend="neuron")
world_size = dist.get_world_size()

model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    dtype=torch.bfloat16,
    distributed_config=DistributedConfig(tp_size=world_size),
    device_mesh=DeviceMesh("neuron", list(range(world_size))),
).eval()

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "left"

inputs = tokenizer.apply_chat_template(
    [{"role": "user", "content": "The future of AI is"}],
    add_generation_prompt=True,
    padding=True,
    tokenizer_kwargs={"pad_to_multiple_of": PREFILL_CHUNK_SIZE},
    return_tensors="pt",
)

generation_config = GenerationConfig(
    max_new_tokens=128,
    do_sample=False,
    use_cache=True,
    pad_token_id=tokenizer.pad_token_id,
    eos_token_id=tokenizer.eos_token_id,
    cache_implementation="static",
    max_cache_len=MAX_SEQ_LEN,
    prefill_chunk_size=PREFILL_CHUNK_SIZE,
    compile_config=CompileConfig(backend="neuron", fullgraph=False, dynamic=False),
)

with torch.no_grad():
    output_ids = model.generate(
        inputs["input_ids"],
        attention_mask=inputs["attention_mask"],
        generation_config=generation_config,
    )

if dist.get_rank() == 0:
    prompt_len = inputs["input_ids"].shape[1]
    print(tokenizer.decode(output_ids[0, prompt_len:], skip_special_tokens=True))
训练
如今 Neuron 已经成为 PyTorch 的原生设备,在 Trainium 上训练可以直接使用与其他加速器相同的 Hugging Face 库:Transformers、Accelerate、PEFT 和 TRL。你不再需要专门的训练器,也不再需要对模型代码做 Neuron 特定的分叉。标准的 TRL 微调脚本只需加上少量 Neuron 相关的配置,就能在 Trainium 实例上运行。
下面是一个基于 TRL SFTTrainer 的监督微调脚本。如果你以前用 TRL 在 GPU 上微调过模型,看到它应该会觉得很熟悉。
import os

import torch
from datasets import load_dataset
from transformers.distributed import DistributedConfig

from trl import ModelConfig, ScriptArguments, SFTConfig, SFTTrainer, TrlParser

def main(script_args, training_args, model_args):
    # Neuron 后端目前尚无法编译 Dynamo 的自动动态形状功能 (https://github.com/huggingface/trl/issues/7660)
    torch._dynamo.config.automatic_dynamic_shapes = False

    training_args.model_init_kwargs = {
        "revision": model_args.model_revision,
        "trust_remote_code": training_args.trust_remote_code,
        "attn_implementation": model_args.attn_implementation,
        "dtype": model_args.dtype,
        "device_map": None,
    }
    if int(os.environ.get("WORLD_SIZE", "1")) > 1:
        # 模型权重加载时会在 TP x FSDP 网格上进行分片
        training_args.model_init_kwargs["distributed_config"] = DistributedConfig(
            tp_size=int(os.environ.get("TP_SIZE", "1")),
            fsdp_size=int(os.environ.get("FSDP_SIZE", "1")),
        )

    # 准备数据集
    train_dataset = load_dataset(
        script_args.dataset_name,
        name=script_args.dataset_config,
        split=script_args.dataset_train_split,
    )
    # UltraChat 还包含一个字符串类型的 `prompt` 列,这会导致 TRL 将其视为 prompt-completion 数据集。
    train_dataset = train_dataset.select_columns(["messages"])

    # 训练
    trainer = SFTTrainer(
        model=model_args.model_name_or_path,
        args=training_args,
        train_dataset=train_dataset,
    )

    trainer.train()
    trainer.save_model(training_args.output_dir)
    trainer.end()

if __name__ == "__main__":
    parser = TrlParser((ScriptArguments, SFTConfig, ModelConfig))
    script_args, training_args, model_args = parser.parse_args_and_config()
    main(script_args, training_args, model_args)
并行化由 Transformers 原生处理。只需在 model_init_kwargs 中放入包含 tensor-parallel (TP) 和 FSDP 尺寸的 DistributedConfig,SFTTrainer 会将其传递给 from_pretrained,模型在加载权重时即完成分片。Trainer 检测到模型已分布式化,便不会再额外包装。因此,无需使用 --fsdp 参数或配置 Accelerate FSDP。
脚本中没有任何部分与 Trainium 绑定,同一份代码可运行在任意硬件上。若在 Trainium 上运行,有几点值得注意:
- 静态形状。该脚本禁用了
torch.compile中的自动动态形状功能,并采用 wrapped packing 策略生成最长 2048 个 token 的序列。由于 TRL ≥ 1.16 中 Neuron 上的批次会填充至 128 个 token 的整数倍,因此可限制输入形状的数量。对于相同形状的后续步骤,可直接复用编译好的计算图。 - 启用
torch.compile。只需传入--torch_compile true参数:在 Trainium 实例上,torch.compile会自动检测设备并选用 Neuron 后端,无需其他配置。 - 关闭异步权重加载。Transformers 内置的异步权重加载功能尚不支持 Neuron,因此目前我们通过
HF_DEACTIVATE_ASYNC_LOAD=1将其禁用。
下方命令使用 torchrun 启动训练,它会为每个 NeuronCore 创建一个进程。TP_SIZE 和 FSDP_SIZE 设定并行布局,二者的乘积即为进程数:此处为 4 × 8 = 32,与 --nproc_per_node 一致。这 32 个进程构成一个 4 × 8 的网格。张量并行将一个 TP 组内的 4 个核心用于切分每一层,而 FSDP 则将参数、梯度和优化器状态在 8 个 TP 组之间进行分片。
TP_SIZE=4 FSDP_SIZE=8 HF_DEACTIVATE_ASYNC_LOAD=1 uv run torchrun --nproc_per_node=32 sft_neuron_example.py \
    --model_name_or_path Qwen/Qwen3-8B \
    --dataset_name HuggingFaceH4/ultrachat_200k \
    --dataset_train_split train_sft \
    --output_dir Qwen3-8B-sft-tp4-fsdp8 \
    --dtype bfloat16 \
    --max_length 2048 \
    --packing true \
    --packing_strategy wrapped \
    --learning_rate 2e-5 \
    --warmup_steps 0.03 \
    --num_train_epochs 1 \
    --logging_steps 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 4 \
    --save_only_model true \
    --torch_compile true
我们在 8 颗 Trainium2 芯片(共 32 个 NeuronCore)上运行了该任务,相当于半台 trn2.48xlarge 实例。
训练顺利执行完毕,trainer.save_model 会生成标准的 Transformers 检查点。该检查点与 Neuron 无关:你可以直接将其推送到 Hugging Face Hub,并加载到任何其他硬件上。
Diffusers
推理
Diffusers 库中的许多 pipeline 都已兼容 TorchNeuron 的 eager 模式和编译模式。FLUX.1-dev、FLUX.2、Qwen-Image、Qwen-Image-2.1 和 H3 还支持张量并行(TP),可以充分发挥 Neuron 设备的性能。下面的示例展示了如何使用 TP:
import torch, torch.distributed as dist, torch_neuronx # TP
from torch.distributed.device_mesh import DeviceMesh # TP
from diffusers import QwenImage21Pipeline, QwenImage21Transformer2DModel, TensorParallelConfig

# 初始化分布式设备
dist.init_process_group(backend="neuron") # TP
dev = torch.neuron.current_device()
mesh = DeviceMesh("neuron", list(range(8))) # TP=8

# 初始化 pipeline
model = "Qwen/Qwen-Image-2.1"
transformer = QwenImage21Transformer2DModel.from_pretrained(
    model,
    subfolder="transformer",
    torch_dtype=torch.bfloat16,
    parallel_config=TensorParallelConfig(mesh=mesh), # TP
)
pipe = QwenImage21Pipeline.from_pretrained(
    model,
    transformer=transformer,
    torch_dtype=torch.bfloat16,
)
pipe.vae.to(dev)
pipe.transformer.compile_repeated_blocks(backend="neuron", fullgraph=True, dynamic=False)

# 图像生成
emb, mask, _ = pipe.encode_prompt(prompt="A capybara wearing a wizard hat, oil painting", device="cpu")  # text encoder 留在 CPU 上
image = pipe(
    prompt_embeds=emb.to(dev),
    prompt_embeds_mask=mask.to(dev) if mask is not None else None,
    height=1024,
    width=1024,
    num_inference_steps=40,
    generator=torch.Generator("cpu").manual_seed(0), # 每个 rank 上噪声一致
).images[0]
if dist.get_rank() == 0:
    image.save("out.png")
运行这段代码的命令是:NEURON_LOGICAL_NC_CONFIG=2 torchrun --nproc_per_node=8 run.py。
会有越来越多的 pipeline 支持 TP。如果你喜欢的某个 pipeline 暂不支持,也可以参考这份指南为它添加支持。
内核
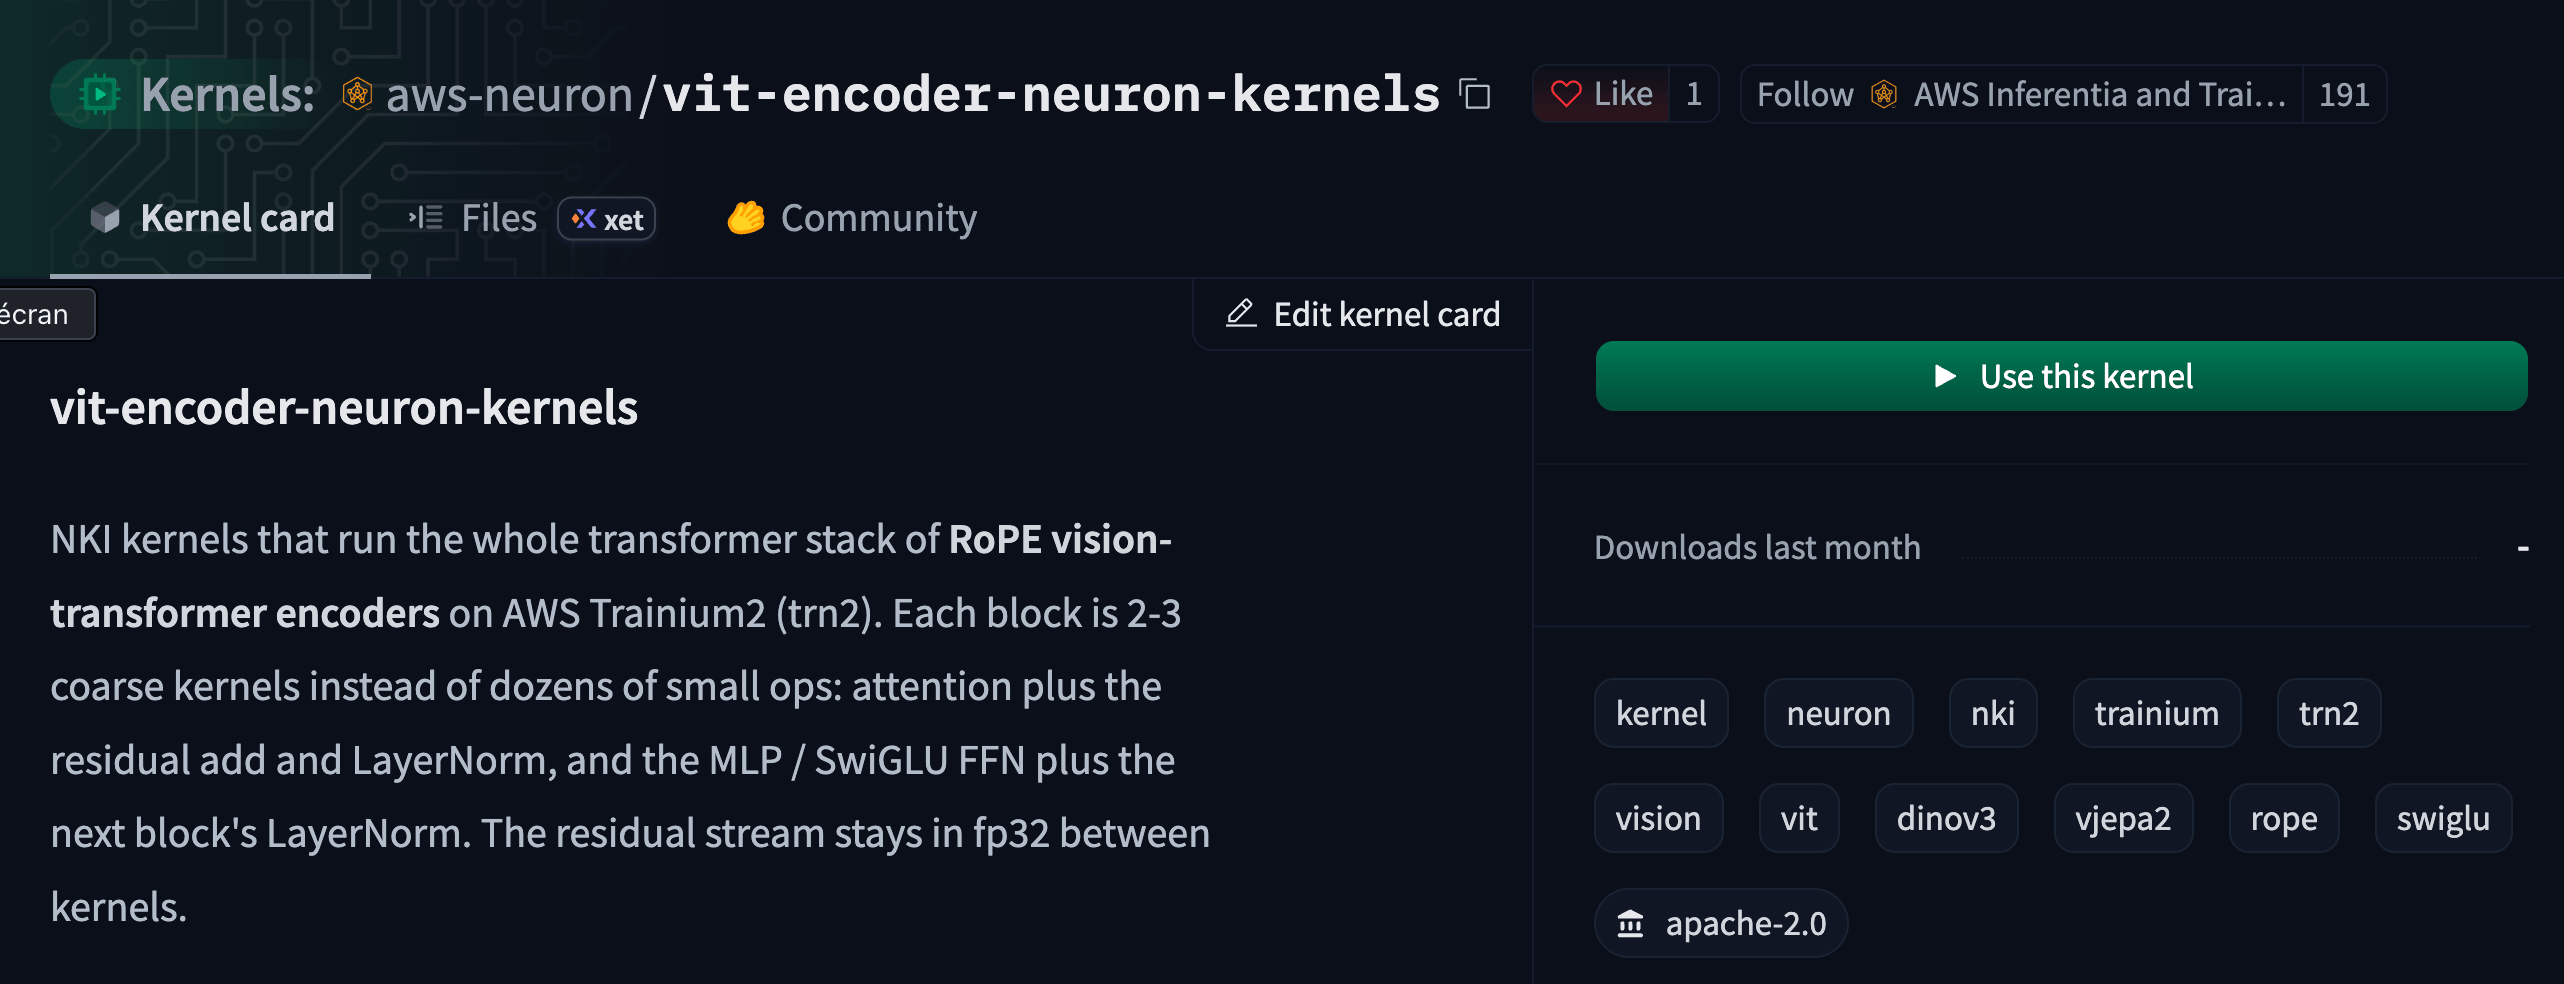
请多关注 Neuron 团队的 kernels,越来越多的 Neuron kernels 将上架 Hub 以加速你的模型。Neuron kernels 可以使用 Neuron Kernel Interface(NKI)编写,提供更低层的控制以优化算子。这样,用户就可以运行自己编写的自定义算子,并将其共享到 Hub。
例如,你可以使用 这个 kernel 来加速你的 vision transformers,在 Trainium 上最高可获得 2.4 倍的性能提升!