
基于 NVIDIA CUDA Tile 加速 Mamba-2 高性能前向传播内核
概述与前置条件
要使用 cuTile,请确保你的环境符合 cuTile Python 快速入门 指南中列出的要求。将包导入为 cuda.tile,并在本文展示的内核实现中将其简写为 ct。
序列建模的计算权衡
序列建模架构面临着计算上的权衡:传统的 Softmax Attention 可以利用 Tensor Cores 加速矩阵乘法,训练速度很快,但在推理阶段,计算量和内存需求会随序列长度线性增长。相比之下,循环神经网络(RNN)训练缓慢且无法并行化,但无论序列长度如何,其计算量和内存占用都保持恒定。
Mamba-2 架构
Mamba-2 架构源自一类旨在兼顾两者优势的模型。与 RNN 类似,它拥有固定大小的隐藏状态和递归更新,并且可以利用 Tensor Cores 以高效的计算方式分块(chunkwise)执行。
Mamba-2 的核心递归公式为:
\(h_t = \exp(A \cdot dt_t) h_{t-1} + dt_t B_t x_t\)
\(y_t = c_t^\top h_t + D x_t\)其中:
- \(x_t\)、\(dt_t\)、\(B_t\) 和 \(c_t\) 是 Mamba-2 层在第 \(t\) 个 token 处的输入(由该 block 的输入投影得到,类似于 attention 层中的 query、key 和 value)
- \(y_t\) 是第 \(t\) 个 token 处的输出
- \(h_t\) 是跨 token 传递的固定大小隐藏状态。它不像 RNN 那样是一个向量,而是一个矩阵(包含更多数值,表达能力更强)
- \(A\) 和 \(D\) 是可学习的模型参数
直观理解:
- \(dt_t\)(每个 head 一个标量)表示状态需要更新多少。\(dt\) 中所有值都是负数,因为前一个状态会乘以 \(\exp(Adt_t)\),当 \(dt_t = 0\) 时状态保持不变
- \(x_t\)(大小为 H 的向量)作用类似于 attention 中的 values
- \(B_t\)(大小为 S 的向量)作用类似于 attention 中的 keys
- \(c_t\)(大小为 S 的向量)表示如何混合状态以产生输出,作用类似于 attention 中的 queries
状态 \(h_t\) 是一个大小为 S,H 的矩阵(\(B_t x_t^\top\) 是外积)。为方便书写计算,令 \(a_t = Adt_t\),并记 \(b_t\) 为乘积 \(dt_t B_t\)。于是方程可以简化为:
\(h_t = \exp(a_t)h_{t-1} + b_t x_t^{\mathsf{T}}, y_t = c_t^{\mathsf{T}}h_{t-1} + Dx_t\)
这种循环形式非常适合顺序推理。但训练和 prefill 需要比 for 循环更快的方式。虽然线性状态更新可以采用并行扫描(parallel scan)算法,但这种方法需要物化一个巨大的隐藏状态张量,导致它主要受内存限制,无法利用 Tensor Cores。
另一种方案是通过矩阵乘法直接计算任意未来时刻的隐藏状态,从而利用 Tensor Cores。为简化起见,先忽略 \(\exp(a_t)\) 项,从 \(h_t\) 推进到 \(h_{t+T}\) 就是:
\(h_{t+T} = h_t + b_{t+1}x_{t+1}^{\mathsf{T}} + b_{t+2}x_{t+2}^{\mathsf{T}} + \cdots + b_{t+T}x_{t+T}^{\mathsf{T}}\)
如果把所有 \(b_{t+i}\) 堆叠成形状为 (T, S) 的矩阵 \(B\),把所有 \(x_{t+i}\) 堆叠成形状为 (T, H) 的矩阵 \(X\),那么上式就是 \(h_{t+T} = h_t + BX^T\):
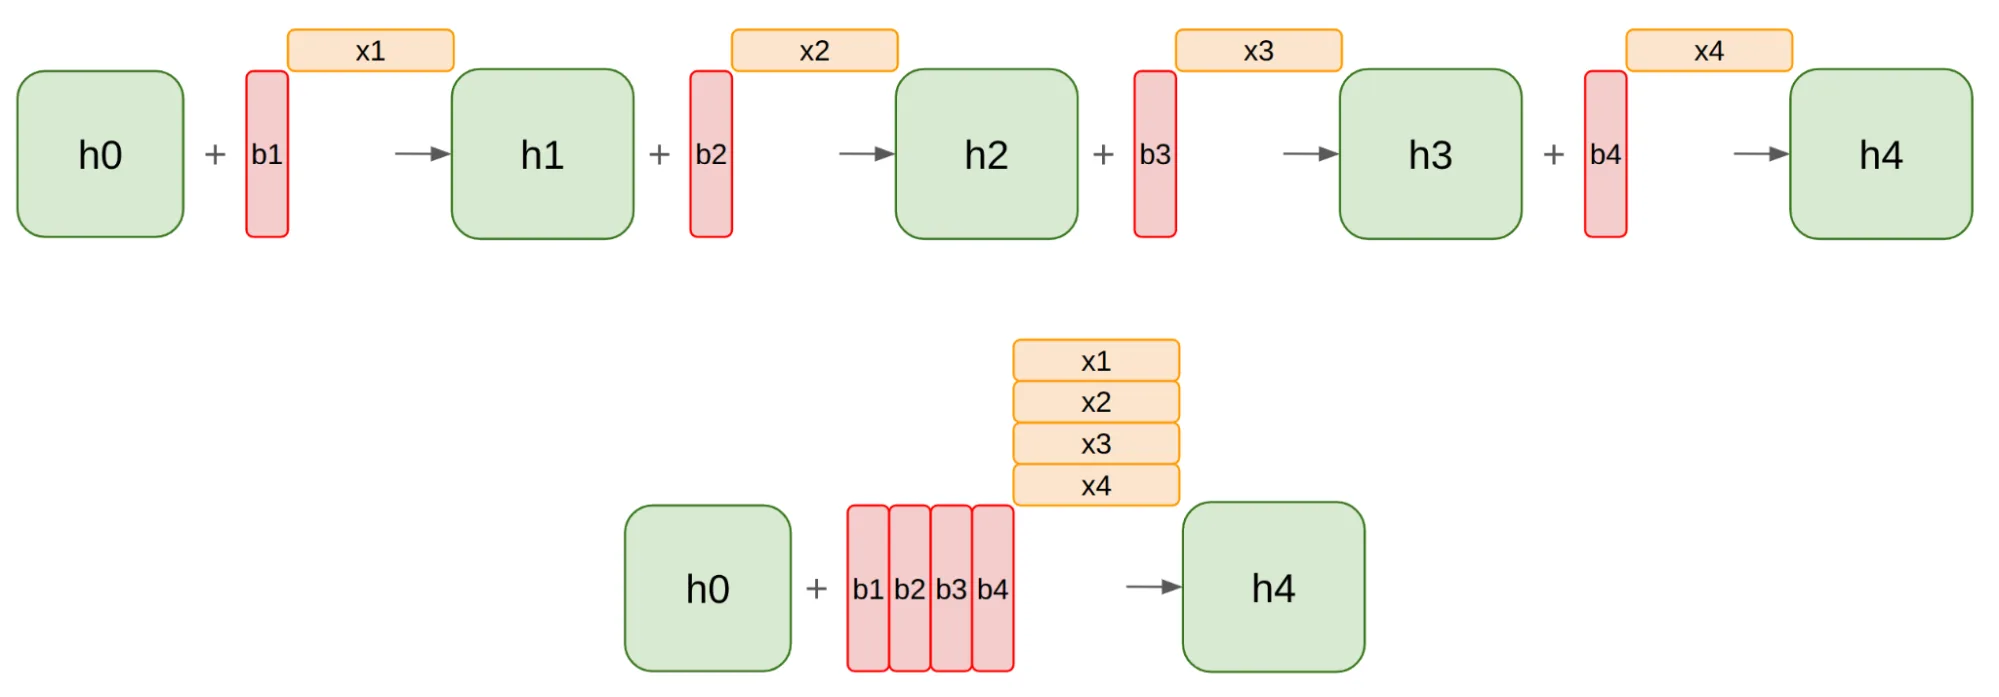
借助这个跳跃公式,可以高效地计算序列中各个分块“检查点”处的隐藏状态。下一步是如何在仅已知 \(h_0\) 的情况下,计算出输出 \(y_1\)、\(y_2\)、\(y_3\)、\(y_4\)。如果能直接计算 \(h_1\)、\(h_2\)、\(h_3\)、\(h_4\) 等,这件事就很简单,但那样做就违背了使用跳跃公式的初衷。
暂时先忽略衰减项 \(\exp(a_t)\),目标公式为:
\(y_{t+i} = c_{t+i}^{\mathsf{T}}h_{t+i} + Dx_{t+i} = c_{t+i}^{\mathsf{T}}\left(h_t + b_{t+1}x_{t+1}^{\mathsf{T}} + \cdots + b_{t+i}x_{t+i}^{\mathsf{T}} \right) + Dx_{t+i}\)
其中,前一个公式用于展开隐藏状态。跳跃连接项 \(Dx_{t+i}\) 比较容易理解。其他部分的形式如下:
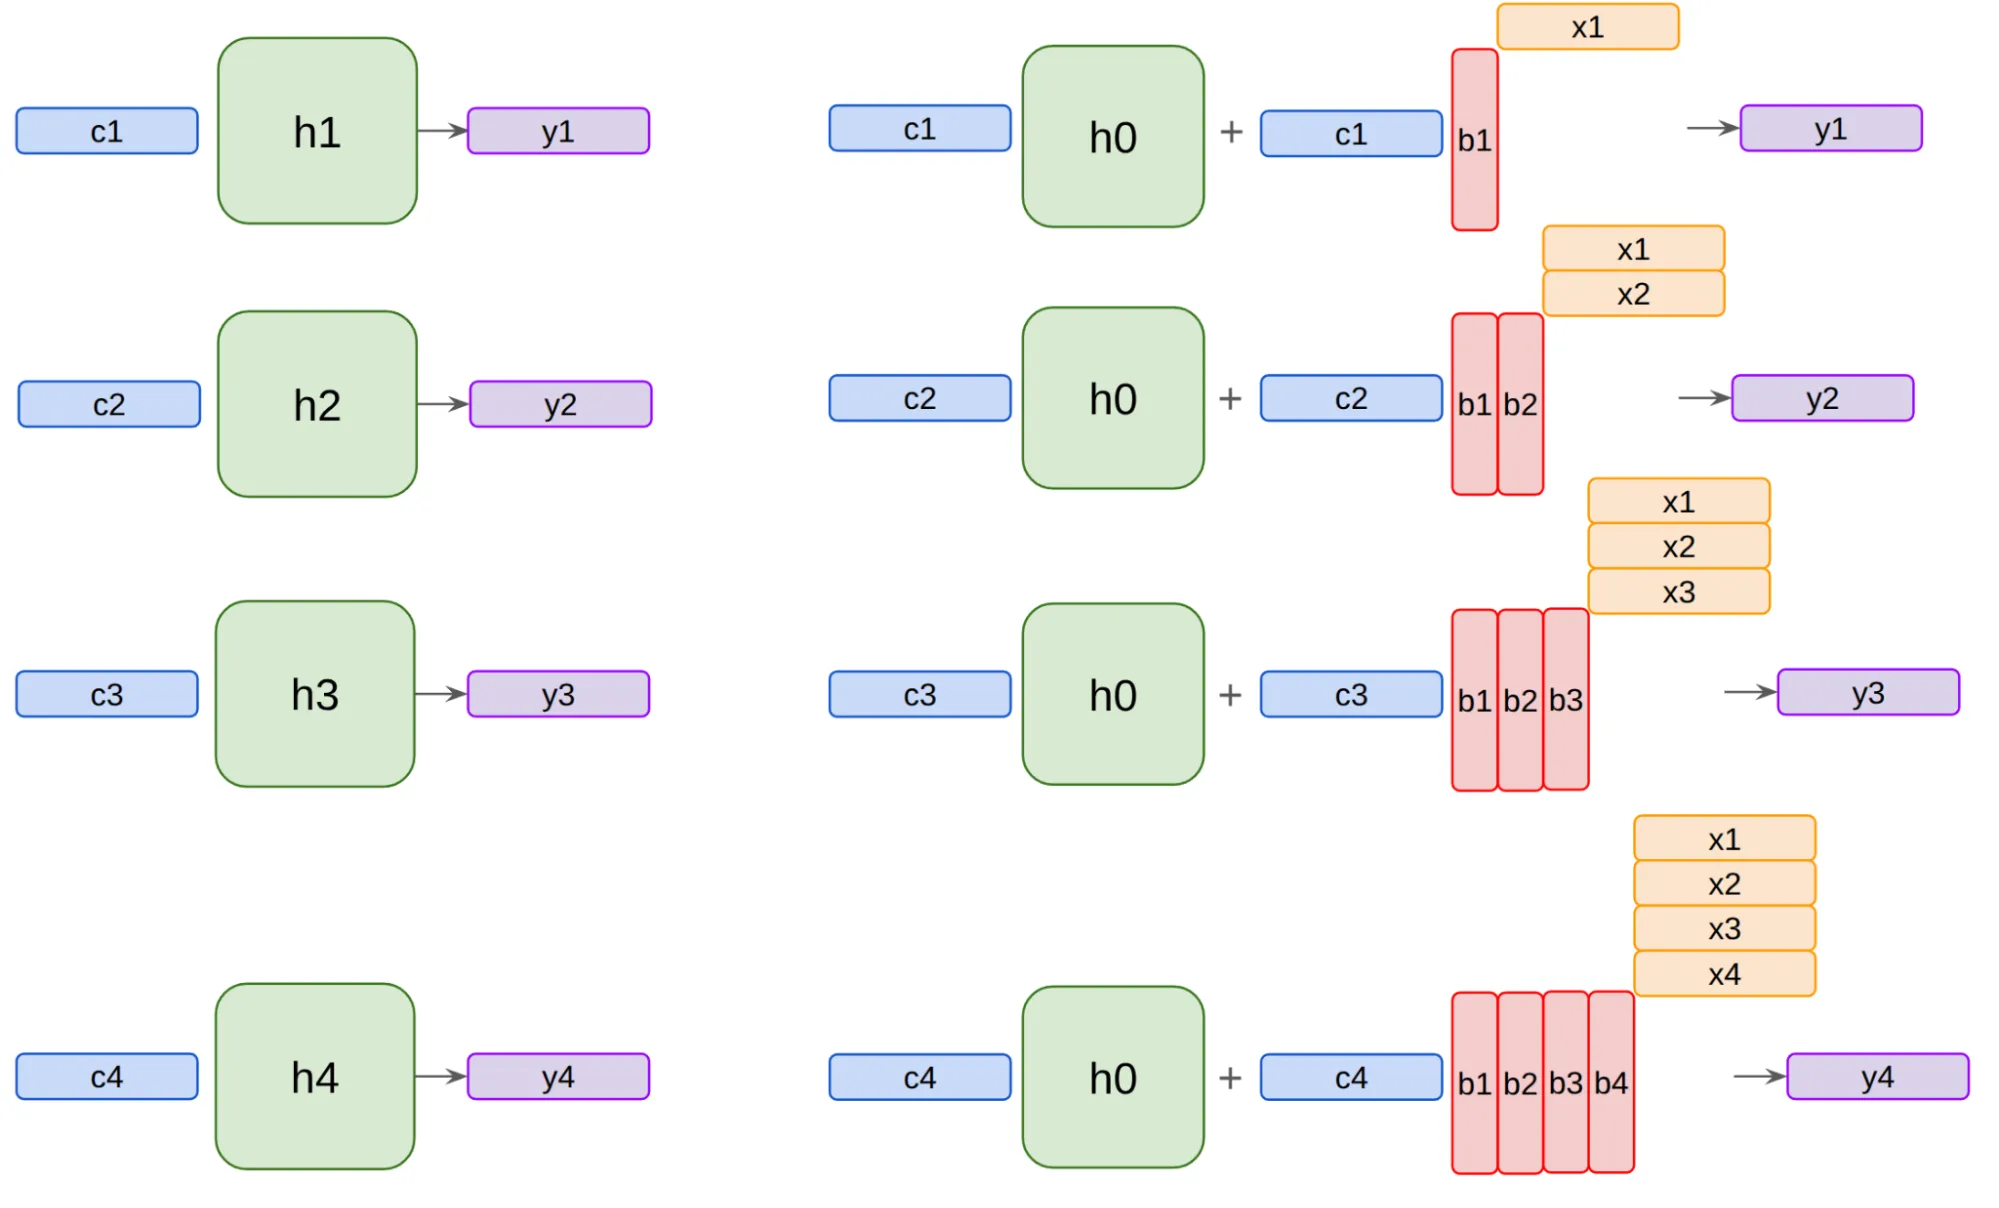
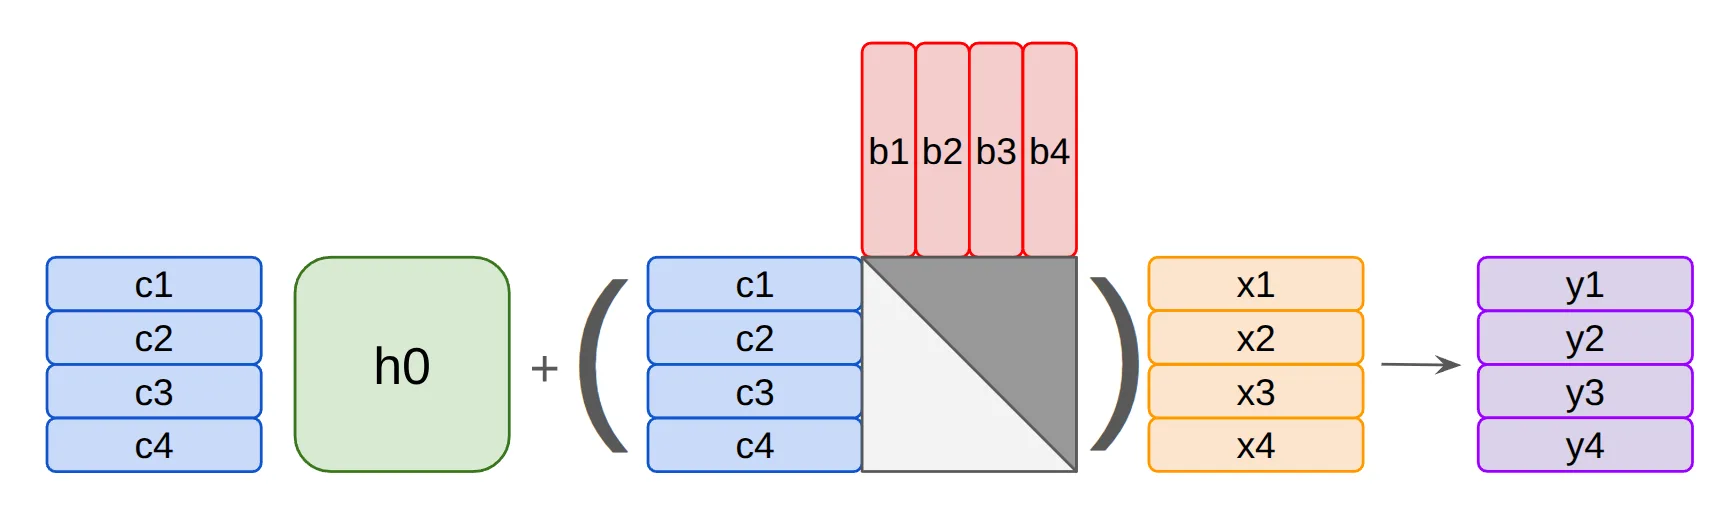
同样,将 \(x_t\)、\(b_t\)、\(c_t\) 和 \(y_t\) 按块分组为矩阵后,就可以用 Tensor Core 友好的矩阵乘法形式重新表达该过程(见图 3),其中 \(\mathit{C}\) 与 \(\mathit{B}\) 乘积中的三角形区域相当于因果掩码(类似于因果 Softmax 注意力机制)。
计算输出 \(y_{t+i}\) 时,需要 \(c_{t+i}\) 与所有 \(j \leq t + i\) 的 \(b_j\) 相乘。因此,在计算完整的矩阵乘积时,必须屏蔽未来部分(即对角线上方)的项。用数学公式表示如下(加回残差连接):
\(Y = Ch_t + \left((CB^{\mathsf{T}})\cdot M\right)X + DX\)
其中 \(M\) 是传统的因果掩码。
去除衰减项后,Mamba-2 本质上就是线性注意力(只是符号有所更改),因此上述公式与不带 softmax 的注意力机制非常相似。重新加入衰减项会让情况稍微复杂一些。递归式的展开如下:
\(h_(t+T)=exp(a_(t+1)+a_(t+2)+⋯+a_(t+T) ) h_t+exp(a_(t+2)+⋯+a_(t+T) ) b_(t+1) x_(t+1)+exp(a_(t+3)+⋯+a_(t+T) ) b_(t+2) x_(t+2)+⋯+b_(t+T) x_(t+T)\)
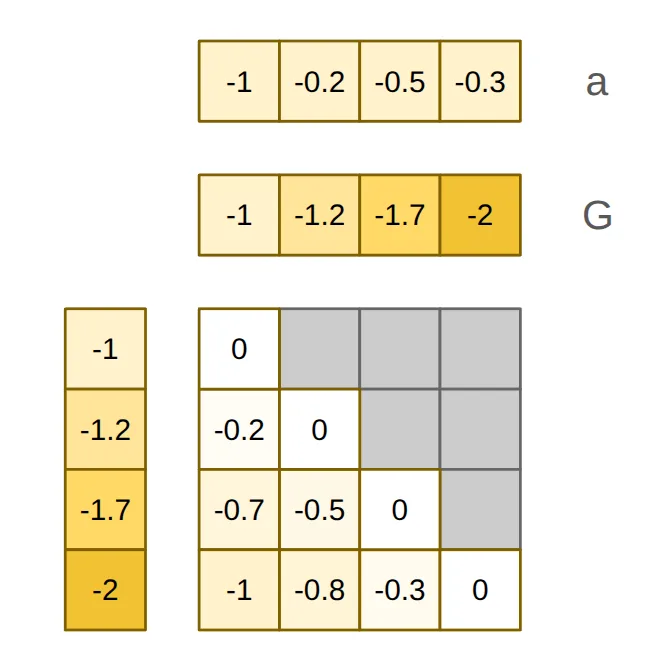
在-log-space 中重新表述,可以用累积和替代顺序乘法。如果预先用指数项乘以 \(B\)(或 \(X\))的行,结果仍然保持为矩阵乘法。通过张量 \(G\) 来记录 \(a_t\) 的累积和,由此得到以下新方程:
\(h_{t+T} = \exp(G_{last})h_t + \left(\exp(G_{last} – G)\cdot B\right)X^{\mathsf{T}}\)
将新的隐藏状态跃变代入输出计算公式,得到:
\(Y = \exp(G)Ch_{kT} + \left(\exp(G – G^{\mathsf{T}})\cdot (CB^{\mathsf{T}})\cdot M\right)X + DX\)
其中矩阵 \(\exp(G – G^{\mathsf{T}})\) 在 \((i, j)\) 位置包含项 \(\exp(g_i – g_j)\)。注意,所有 \(i < j\) 的项都会被因果掩码屏蔽,因此只需保留 \(g_i\) 中 \(a_t\) 求和项数多于 \(g_j\) 的那些项。由于构造上所有 \(a_t\) 均为负值,使得 \(g_i – g_j\) 为负。任何正数的指数项都不会被保留,从而保证了数值稳定性。
这将拆分为三个 kernel:
chunk_cumsum:计算每个 chunk 内 \(a_t\) 的累积和。fwd_pass_state:用上面的跳跃公式计算每个 chunk 起始处的隐藏状态。compute_out:利用上一步算出的 chunk 初始隐藏状态,计算每个 chunk 的输出。
Kernel 1:计算累积和
第 2 步和第 3 步都需要 \(a_t = Adt_t\)(即前文公式中的 \(G\))的累积和。为了避免重复计算,第一个 kernel 只算一次 \(a_t\) 并存下来。注意这里不是全局累积和,而是每个 chunk 内部的累积和。
这个 kernel 的输入是每个 head 的标量衰减 a 和每个 token 的时间步 dt。token t 在 head h 上的有效衰减为 a[h] * dt[t, h],kernel 沿 chunk 维度对乘积累加。这些累积和都在 log 空间中,之后总会对它们取指数(或取其某种线性组合)。由于计算 exp2 比 exp 便宜得多,结果会先乘以 log2(e)。
这个 kernel 引入了三个 kernel 都会用到的 cuTile 原语:ct.bid、ct.load / ct.store 和 ct.cumsum。
完整代码很短:
@ct.kernel
def chunk_cumsum_kernel(
    a: torch.Tensor,        # [num_heads]
    dt: torch.Tensor,       # [batch_size, num_tokens, num_heads]
    output: torch.Tensor,   # [batch_size, num_tokens, num_heads]
    chunk_size: ct.Constant[int],
    BLOCK_H: ct.Constant[int],
) -> None:
    chunk_idx, head_tile_idx, batch = ct.bid(0), ct.bid(1), ct.bid(2)
    dt_tile = ct.load(dt, index=(batch, chunk_idx, head_tile_idx),
                          shape=(1, chunk_size, BLOCK_H),
                          padding_mode=ct.PaddingMode.ZERO).astype(ct.float32)
    a_tile = ct.load(a, index=(head_tile_idx,),
                        shape=(BLOCK_H,),
                        padding_mode=ct.PaddingMode.ZERO).astype(ct.float32)

    d_tile = ct.cumsum(a_tile * dt_tile, axis=1) * LOG2E
    ct.store(output, index=(batch, chunk_idx, head_tile_idx), tile=d_tile.astype(output.dtype))
该 kernel 在一个网格 (num_chunks, num_head_tiles, batch_size) 上启动,首行代码利用 ct.bid 确定当前线程块在网格中的位置。a_tile(形状 [BLOCK_H])与 dt_tile(形状 [1, chunk_size, BLOCK_H])的广播乘积,计算出了该 tile 内每个 token、每个 head 的有效衰减量。接着 ct.cumsum(..., axis=1) 沿 chunk 内部的 token 维度执行前缀和扫描,最终结果按 fwd_pass_state 和 compute_out 预期的布局存储。
Kernel 2: fwd_pass_state
fwd_pass_state 负责计算每个 chunk 的初始隐藏状态,以及最后一个 chunk 结束后的最终隐藏状态。它不直接计算输出,而是准备由 compute_out 后续投影到输出中的传递状态。核心逻辑仍是前述的 chunk 顺序循环。每次 kernel 启动加载隐藏状态的一个 (batch, head, head_tile, state_tile) 切片,如下所示。在该切片中,hid_tile 的形状为 [BLOCK_HEAD, BLOCK_STATE],包含每个 chunk 的初始隐藏状态 tile。
head_tile_idx, state_tile_idx, batch_head = ct.bid(0), ct.bid(1), ct.bid(2)
batch = batch_head // x.shape[2]
head = batch_head % x.shape[2]
group = head // num_heads_per_group

hid_tile = ct.load(
    init_state,
    index=(batch, head, head_tile_idx, state_tile_idx),
    shape=(1, 1, BLOCK_HEAD, BLOCK_STATE),
).reshape((BLOCK_HEAD, BLOCK_STATE))
在循环的每次迭代中,首先存储隐藏状态:
num_chunks = ct.cdiv(b.shape[1], chunk_size)
for chunk_idx in range(num_chunks):
    ct.store(
        hiddens,
        index=(batch, head, chunk_idx, head_tile_idx, state_tile_idx),
        tile=hid_tile.reshape((1, 1, 1, BLOCK_HEAD, BLOCK_STATE)).astype(hiddens.dtype),
    )
循环的其余部分负责加载 x、b、dt 和 decay_cumsum 中的一个块数据,以计算下一个块的初始隐藏状态。如前所述,相应的数学表达式为:
\(h_{t+T} = \exp(G_{last})h_t + \left(\exp(G_{last} – G)\cdot B\right)X^{\mathsf{T}}\)
ct.extract 用于从已加载的衰减 tile 中获取最后一个 token(以计算 \(G_{last}\))。出于性能考虑,使用 exp2 代替 exp,如前文所示。ct.mma 是执行矩阵乘加(matrix-multiply add)并利用 Tensor Cores 的 API。
 x_tile = ct.load(
        x, index=(batch, chunk_idx, head, head_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_HEAD),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_HEAD))
    b_tile = ct.load(
        b, index=(batch, chunk_idx, group, state_tile_idx),
        shape=(1, chunk_size, 1, BLOCK_STATE),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size, BLOCK_STATE))
    dt_tile = ct.load(
        dt, index=(batch, chunk_idx, head),
        shape=(1, chunk_size, 1),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size,))
    d_tile = ct.load(
        decay_cumsum, index=(batch, chunk_idx, head),
        shape=(1, chunk_size, 1),
        padding_mode=ct.PaddingMode.ZERO,
    ).reshape((chunk_size,))
    d_last = ct.extract(d_tile, index=(chunk_size - 1,), shape=(1,))

    b_dt_d = b_tile * (dt_tile * ct.exp2(d_last - d_tile))[:, None]
    hid_tile = ct.exp2(d_last) * hid_tile
    hid_tile = ct.mma(x_tile.transpose(), b_dt_d.astype(b.dtype), hid_tile)
处理完最后一个 chunk 后,hid_tile 中保存的就是最终隐藏状态,随后会将其存储。推理时,这个值可以作为下一次调用的 init_state 传入;训练时通常直接丢弃。
ct.store(
    final_state,
    index=(batch, head, head_tile_idx, state_tile_idx),
    tile=hid_tile.reshape((1, 1, BLOCK_HEAD, BLOCK_STATE)),
)
顺序依赖被限制在单个 grid 点(program 实例)内部,而相互独立的 (batch, head, head_tile, state_tile) 分片则在 grid 上并行执行。
Kernel 3:compute_out
compute_out 是前向传播的最后一个 kernel。它接收 fwd_pass_state 生成的各 chunk 初始隐藏状态,计算 token 输出,也就是实现前面推导出的输出方程:
\(Y = \exp(G)Ch_{kT} + \left(\exp(G – G^{\mathsf{T}})\cdot (CB^{\mathsf{T}})\cdot M\right)X + DX\)
如果直接用 PyTorch 实现,这三项要分开计算,并需要在全局内存中完整生成 [B, n_chunks, chunk_size, chunk_size] 的交互矩阵 C @ B.T。而 compute_out 把它们融合进一个分块 kernel,并将该矩阵保留在寄存器中。
每次 kernel 启动负责一个 (batch, chunk, head, head_tile) 输出分块,工作分两个阶段。阶段 1 循环遍历状态分块,用 ct.mma 同时构建交互矩阵 cb_tile = C @ B.T,并累加携带状态项 C @ H.T。
第二阶段将衰减系数和因果掩码应用于 cb_tile(通过 ct.arange 和 ct.where 构造下三角掩码 M,无需实例化掩码张量),随后累加所有项以得到最终输出块。两个累加器均以 ct.full 寄存器块初始化,最终的 ct.mma 操作转换为 ct.tfloat32 类型,借助 Tensor Cores 在接近 FP32 精度下运行。
# 第 2 阶段:衰减 + 因果掩码,然后进行最终计算
d_tile  = ct.load(decay_cumsum, index=(batch, chunk_idx, head),
                  shape=(1, chunk_size, 1), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size,))
dt_tile = ct.load(dt, index=(batch, chunk_idx, head),
                  shape=(1, chunk_size, 1), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size,))
x_tile  = ct.load(x, index=(batch, chunk_idx, head, head_tile_idx),
                  shape=(1, chunk_size, 1, BLOCK_HEAD), padding_mode=ct.PaddingMode.ZERO).reshape((chunk_size, BLOCK_HEAD))
d_val   = ct.load(d, index=(head,), shape=(1,))

cb_tile  = cb_tile * ct.exp2(d_tile[:, None] - d_tile[None, :])  # 成对衰减
idx      = ct.arange(chunk_size, dtype=ct.int32)
cb_tile  = ct.where(idx[:, None] >= idx[None, :], cb_tile, 0.0)  # 因果掩码
out_tile = out_tile * ct.exp2(d_tile[:, None])                   # 对携带状态进行衰减

dt_x     = dt_tile[:, None] * x_tile
out_tile = ct.mma(cb_tile.astype(ct.tfloat32), dt_x.astype(ct.tfloat32), out_tile)
out_tile = out_tile + d_val * x_tile                            # D * x 残差
ct.store(out, index=(batch, chunk_idx, head, head_tile_idx),
         tile=out_tile.reshape((1, chunk_size, 1, BLOCK_HEAD)).astype(out.dtype))
如前所述,虽然 `ct.exp2(d_tile[:, None] - d_tile[None, :])` 这一行计算了一些数值上不稳定的指数(其中包含正数),但会立即应用掩码将其屏蔽,以防止潜在的上溢污染后续计算。
Mamba-2 性能优化
在 cuTile-Python DSL 中定义 Mamba-2 工作负载时,引入了几项关键性能优化:
- 延迟提示:cuTile 允许为 `ct.load` 和 `ct.store` 操作添加延迟提示,以建模 DRAM 流量。编译器利用这些提示优化指令调度和流水线缓冲区深度。
- 交换 A/B 操作数:在 NVIDIA Blackwell 第五代 Tensor Core 上,MMA 操作数是非对称的:操作数 A 可以位于 Tensor Memory,但操作数 B 必须位于 Shared Memory。针对
fwd_pass_state中 SIMT 操作 + 点积操作这类输入融合模式,利用恒等式 \(B^{\mathsf{T}}A^{\mathsf{T}} = (AB)^{\mathsf{T}}\),将融合操作数(b_dt_d)路由至操作数 A,从而缓解共享内存争用。 - GMEM 布局:
decay_cumsum和dt默认采用跨步式内存访问,会生成对缓存不友好的 LDG 指令。转置为[batch, head, token]布局可保证访问连续,从而启用 TMA。 - cuTile-Python 自动调优器:性能瓶颈会随输入形状变化,没有一种优化策略适用于所有模型配置。因此,这些优化与 cuTile 参数(
block_size、occupancy)一起纳入统一的搜索空间,借助 cuTile 的exhaustive_search自动为每种输入形状找到最优配置。
Mamba-2 前向传播性能基准测试
该 Mamba-2 前向传播 kernel 的实现已通过 TileGym 开放,完整示例如下。
import torch
import tilegym
from tests import common
from tests.ops.test_mamba2 import Mamba2ProblemSpec

tilegym.set_backend("cutile")
num_tokens, state_size = 16384, 128

torch.manual_seed(0)
spec = Mamba2ProblemSpec(batch_size=4, num_tokens=num_tokens, num_groups=1,
num_heads=8, state_size=state_size, head_size=64,
chunk_size=128, dtype=torch.bfloat16, state_dtype=torch.float32)
fwd_inputs = spec.get_sample_inputs(with_reference=False, with_backward=False)
fwd = common.benchmark(
    lambda: tilegym.ops.mamba2_chunk_forward(**fwd_inputs),
    use_cupti=True,
)
print(f"Forward: {fwd['forward']['median'] * 1000:.2f} us")
我们在以下软硬件配置下,将该 Mamba-2 前向传播实现与用 Triton 编写的开源 Mamba-2 kernel 实现进行了性能对比:
软件
- mamba_ssm 2.3.2.post1(NVIDIA Dynamo-Triton 参考实现)、Triton 3.7.1
- cuTile:
cuda-tile1.5.0 - TileIR 汇编器(
tileiras)13.4 - PyTorch 2.13.0、CUDA 13.3(Driver 和 Runtime API,NVCC V13.3.33)、驱动 595.58.03
- cuda-python / cuda-bindings 13.3.1
- Python 3.12.3、Ubuntu 24.04.4 LTS、内核 6.8.0-107
硬件
- 单块 NVIDIA B300 SXM6,计算能力 10.3(NVIDIA Blackwell Ultra)
- SM 最大频率 1920 MHz,功耗上限 1100 W,268 GiB HBM
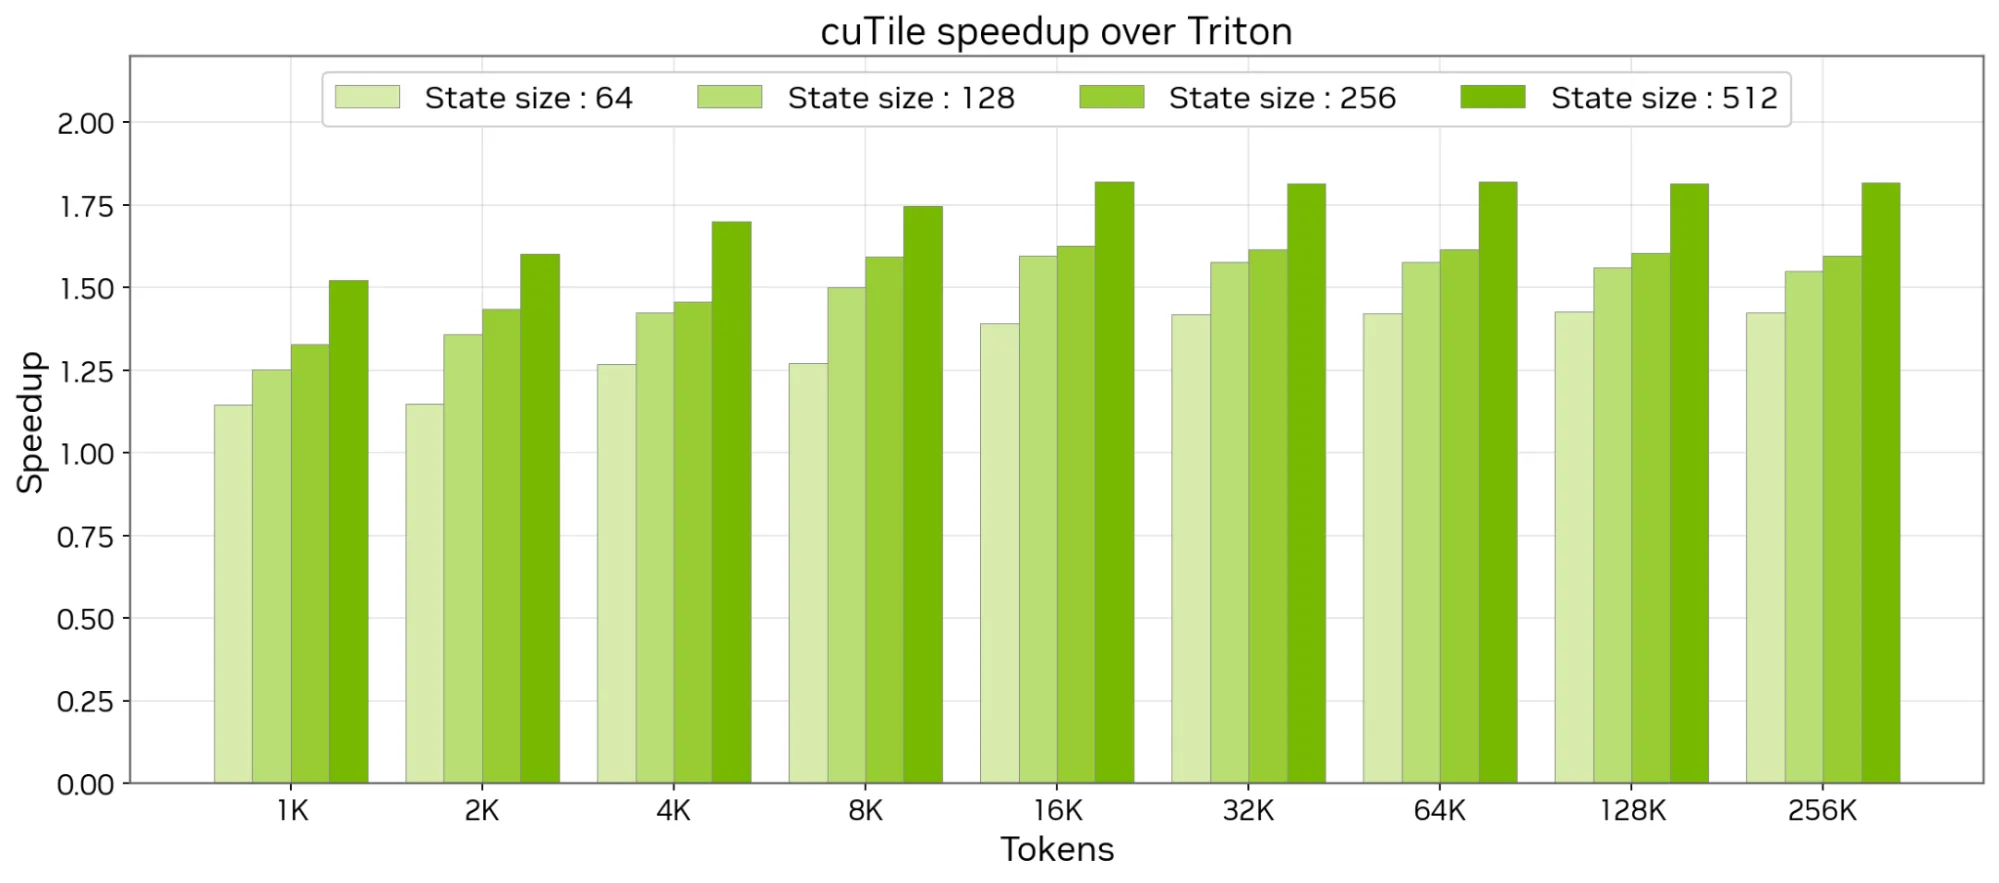
结果显示,优化后的 cuTile 前向传播 kernel 比 Triton 快 1.14 至 1.82 倍,且随着序列长度和状态尺寸的增大,加速比进一步提升。需注意的是,上述数据仅为 kernel 层面的加速效果,端到端训练性能还需考虑反向传播的实现。
cuTile 入门指南
cuTile 允许你用 Python 编写结构清晰、可读性强且高性能的 kernel。敬请关注后续文章,我们将介绍 cuTile 中反向传播的具体实现。
立即开始使用 cuTile,并查阅官方文档、GitHub 仓库以及示例代码。