
实测 Gemini Omni 1.1 Flash:40秒视频生成全记录与成本分析
先给不想往下看的人一个简短版。Gemini Omni 1.1 Flash 是 Google 的"一个模型包办一切"视频模型:输入文字、图片或一段视频,输出带音轨的视频。1.1 版(2026 年 8 月 27 日)补上了实际工作中最关键的两项:场景延展到 40 秒,以及 1080p/4K 输出。现在已在 Popcraft 上线。我们用了一天,最有用的发现是:从一段 5 秒的素材选择"延展到 20 秒",你会得到 25 秒。
| Google 的说法 | 我们的实测 | |
|---|---|---|
| 最长时长 | 通过场景延展可达 40 秒,每次增 10 秒 | 一次提示词生成 40.0 秒,实际耗时 23 分钟 |
| 延展 | "最多分析前 10 秒的上下文" | 5 秒素材 → 25.0 秒文件,原片逐帧保留 |
| 分辨率 | 360p 到 4K,"达到专业制作水准" | 1080p 预告片、720p 测试片段;4K 连续延展卡在 30 秒 |
| 音频 | 语音、音乐、音效随画面生成 | 预告片配了管弦乐,延展段配了暴风雨环境声 |
| 物理 | "对重力、动能、流体动力学等力学有直观理解" | 一段 30 秒的水墨入水视频,三种流体表现合理,见下文 |
| 镜头 | 合作方评价:"动态镜头运动" | 无人机和环绕镜头次次成功;甩镜、升降和推轨变焦会被柔化处理 |
周三上午 10:41。上线了。
Batch AI 头天晚上在他们的测试网关上开了这个模型。先说两条他们那边给出的关键信息,因为这两条直接决定了你怎么用模型:分辨率参数填 "4K" 就真的会返回 3840×2160,而且延展在 API 层面是一个正式模式,不是靠提示词凑出来的。以下其余内容都是我们自己按按钮试出来的。
第一个任务故意选了个无聊的:螺旋楼梯上的灯塔守夜人,竖屏,5 秒,720p。大约两分钟后返回了 5.01 秒的视频,还自带了一段没人要求的风雨声。这就是 Omni 的默认行为:Google 的开发者文档说模型"会尝试为视频生成合适的音轨",确实如此,每次都会生成,除非你明确禁止。
11:20 比要求多出 5 秒的扩展
这是本系列中最值得投入的一环。我们附加了那个 5 秒片段,输入了一行提示词(“船长走上灯廊,点亮灯塔”),请求总时长为 20 秒。
返回的文件时长为 25.0 秒。
这不是 Bug。Google 的发布文章指出,扩展功能以“每次增加 10 秒为步长,累计最长不超过 40 秒”的方式运作,且必须是整数步长:5 + 10 + 10。新文件的前 5 秒与原始素材逐字节一致,风暴音效在拼接点无缝过渡。效果很赞,只是时长不是 20 秒。
因此,给所有基于此模型开发者的建议,也是 Popcraft 的 Extend 面板为何对 5 秒源素材显示 15、25 和 35(而非整齐的 10/20/30/40)的原因:你只能落在“源时长 + 整数步长”的时间点上。 我们按实际返回的秒数计费,而非你输入的数值。
“以每次增加 10 秒为步长扩展视频,累计最长不超过 40 秒。” —— Google,Omni 1.1 Flash 发布文章
12:05 一次提示词生成 40 秒
接着是我们真正想要的:一部好莱坞预告片,《蔓越莓海盗》,16:9,1080p,40 秒,单次请求。Popcraft 会自动为你串联扩展流程:输入一个提示词,输出一个 40 秒的文件。
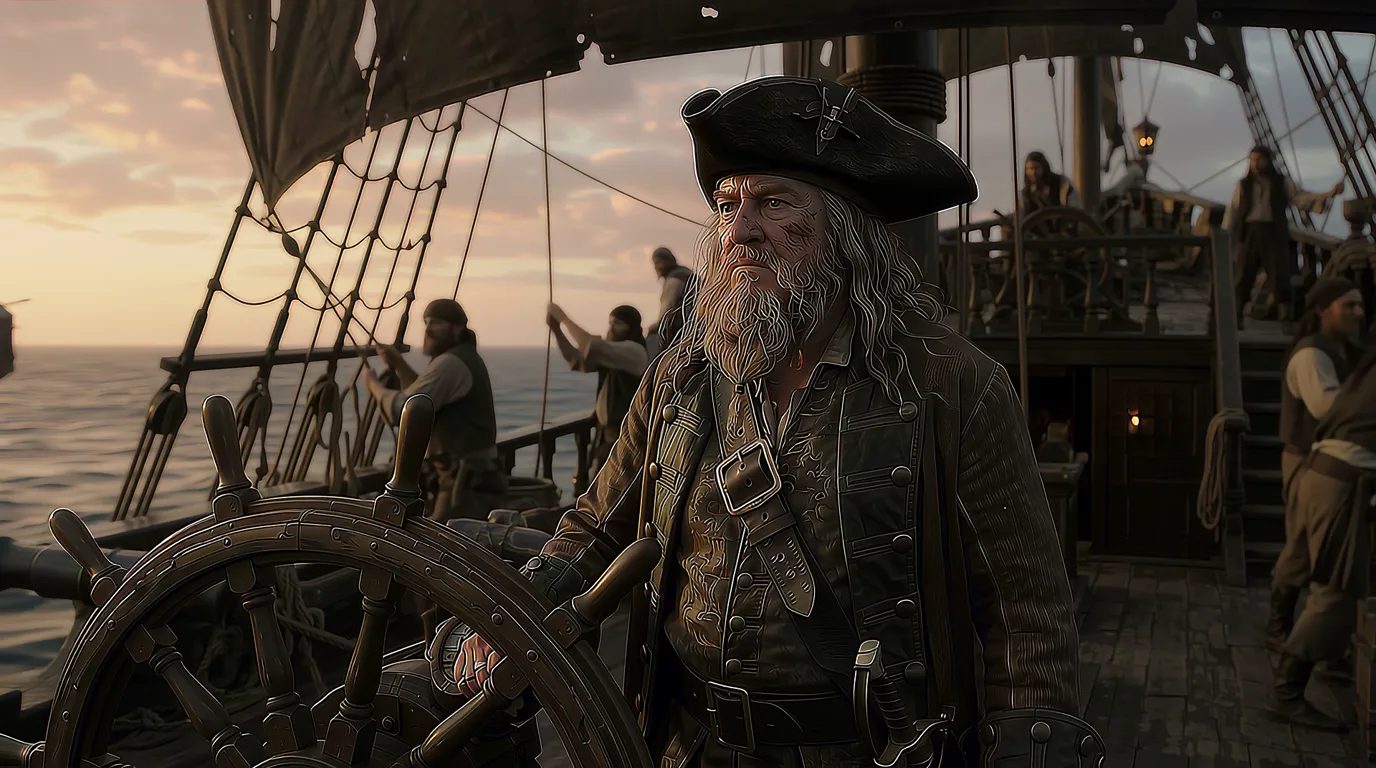
耗时 23 分钟。我们原本的预估是 15 分钟,所以需要校准。结果恰好是 40.0 秒,1920×1080 分辨率,配有的管弦乐配乐在恰当的时刻增强。同一位船长、同一艘船,贯穿所有四个片段的青色调与琥珀色调色一致。这种连贯性正是发布文章中提到的 10 秒上下文窗口在发挥作用,也是支持该模型的最有力论据。
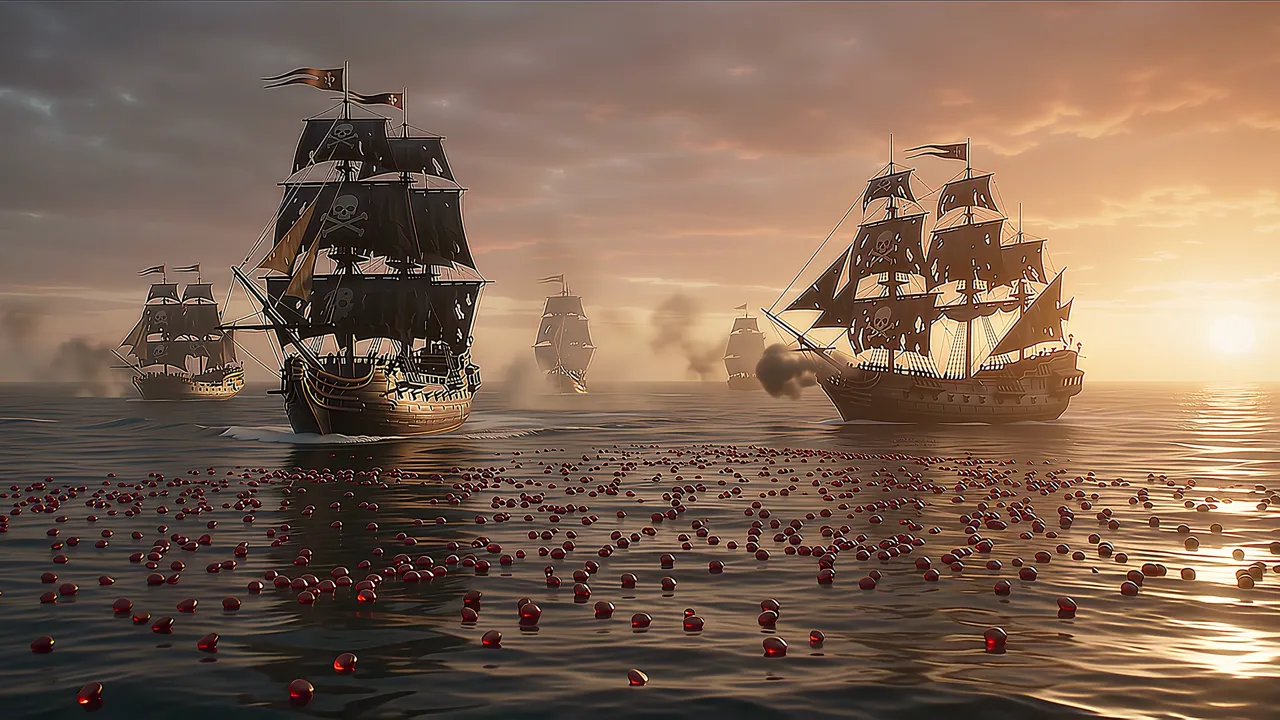
以下是它出错的地方,以及为何这是我们的责任。提示词是一个密集的 240 词段落,包含五个情节节拍:风暴、船长、装满蔓越莓的宝箱、敌船、大炮决战。Omni 保留了所有元素,但重新安排了顺序。蔓越莓飞溅出现在第 8 秒,早于原本应释放它的宝箱,且宝箱从未清晰打开。在该模型上,密集提示词不会导致失败,它们会被压缩。
15:10 好吧,我们来正式测试物理效果声明
这段预告片是个糟糕的物理测试:发生的事太多,没人能断定一颗蔓越莓的弹跳是否符合物理规律。于是我们写了全天最枯燥的提示词。一个装满静止黑水的容器。每 10 秒一段流体:一滴橙色颜料落下,一缕靛蓝色墨迹扩散,然后是一团被逆光照亮的白色颜料云。没有人,没有故事,只有一个缓慢的摄像机弧线,1080p 分辨率,耗时 30 秒,单次请求。
这是该模型全天生成的最佳作品。液滴落入时激起皇冠状水花,随后按水的特性回落。靛蓝色墨迹在其后翻滚涌入,与橙色颜料交织而互不晕染模糊。当白色颜料云出现时,逆光穿透其中,底部的早期流体依然存在且仍在流动。摄像机弧线贯穿全部三段,从未重置。请留意第 10 秒和第 20 秒的衔接点:我们找不到任何痕迹。
先展示我们成本更低的草稿,因为这是我们建议的工作流。四个 10 秒、720p 的变体(墨水、蜂蜜、多米诺骨牌、牛顿摆),每个耗时约两分钟。墨水和牛顿摆表现不错,蜂蜜显得有点过激,多米诺骨牌倒下的顺序对了但缺乏重量感。墨水胜出,我们据此编写了 30 秒版本,结果比草稿更好。这在预告片中并非如此,那里篇幅增加意味着故事被压缩得更厉害。既然没有故事可压缩,延长时长就是纯粹的收益。
基于这些证据,谷歌关于流体动力学的描述并非营销话术。
16:40. 关于摄像机的说法
谷歌发布资料中另一个我们反复阅读的说法涉及摄像机。模型页面上的一条合作伙伴引言称赞其“动态摄像机运动”,Vertex 提示词指南列出了模型被训练掌握的词汇:无人机、移镜、摇摄、俯仰、跟拍、摇臂、环绕、甩镜,以及被标记为高级且官方不支持的“推变焦”(dolly zoom)。
因此,我们要求在同一个 30 秒镜头中包含所有上述运镜,使用上午那座灯塔,提示词的每一拍对应一种运镜。
逐运镜对照提示词评分:
- 无人机接近。 成功。掠过波浪顶端,爬升玄武岩面,恰在指定秒数抵达灯室。这是该模型全天给出的最佳 10 秒摄像机表现。
- 环绕。 成功。最后 10 秒从看守者背后绕至侧面,再到远侧的广角镜头,灯塔始终保持一致。
- 快速横摇到船上。没做到。船在那里,地平线上很小的一个点,但镜头是慢慢漂过去的,而不是猛地一甩。模型把快动作放缓成了慢动作。
- 升起越过灯笼。做了一半。上升发生在第一段,而提示词并没有要求;第二段要求了,反而没做。
- 低角度推进加变焦点。没做到。最后收在一个大远景上。
- 滑动变焦(Dolly zoom)。我们故意没把它放进 30 秒的提示词。在之前 10 秒的测试里,它出来就是一个普通的推进,而且 Google 自己的指南也把它归在“官方不支持”里,所以这条算不上翻车。
还有两个没人要求的“惊喜”。第一段和第二段之间,镜头直接穿过了灯笼的玻璃,找到守塔人,然后跟着她走出房门来到回廊上。整个文件里没有任何剪切点(我们用场景检测器扫过),也就是说模型自己发明了一个转场,从无人机的位置接到她的位置。这个发明还挺不错的。不太好的是:她在灯笼里是盘着头的,几秒后到回廊上头发却披下来了。Google 的模型卡把“跨剪辑的一致性”和“复杂运动”列为已知局限,这就是实际表现。
综合 10 秒和 30 秒两次测试来看,规律很明显:缓慢的大范围运镜(无人机、环绕、弧线、推轨)很可靠,而快速或光学类的运动(快速横摇、滑动变焦)会被“磨平”成更温和的版本。如果你的镜头需要爆发感,就单独生成一个短片段再剪进来。
提示词的心得和预告片那部分一样:用 Google 官方指南里的运镜词汇,每个节拍点名一个动作,慢动作就会准时出现。如果只描述一种感觉(比如“恢弘”“有动感”),那不管怎样都只会得到一个缓慢的推进。
相比 Omni Flash 1.0 到底改了什么?
Google 的模型页面给两个版本用的是同一张能力表,所以这次的差异格外真实可信:
| 能力 | Omni Flash(2026 年 5 月) | Omni 1.1 Flash(2026 年 8 月) |
|---|---|---|
| 文本生成视频 | 支持 | 支持 |
| 图像生成视频 | 不支持 | 支持 |
| 参考图 / 参考视频 | 不支持 | 最多 10 张图、3 个视频 |
| 首尾帧控制 | 不支持 | 支持 |
| 视频编辑 | 支持 | 支持 |
| 视频延长 | 不支持 | 支持,最长 40 秒 |
| 输出分辨率 | 仅 720p | 360p、720p、1080p、4K |
| 声音生成 | 语音、音乐、音效 | 语音、音乐、音效 |
| 来源标识 | SynthID, C2PA | SynthID, C2PA |
原初“Introducing Gemini Omni”推文中关于物理和世界知识的宣称(“对重力、动能和流体动力学等力的直观理解得到提升”)依然有效,我们特意回去测试了这一点,详见下文。不过,Google 主打的是记忆能力:“每条指令都建立在前一条之上。角色保持一致,物理规律稳固,场景会记住之前发生的一切。”看完预告片后,我们发现自己对后半句的信任程度远超预期。
没有模式切换,如何指示它执行动作?
不用切换,这需要花点时间适应。Google 的指南建议:“主要依赖提示词,仅在提示词无效时才使用 task 参数。”你附加的内容和书写的文字,就是那个切换开关。
- 未附加内容:文本生成视频。
- 一张图片:作为首帧。
- 两张图片,并加上“first frame”和“last frame”字样:生成插帧。若无这些字样,两张图片将作为主体参考。
- 最多十张图片:主体参考,人物和物体保持一致。
- 一段视频加上“make it snow”:保留镜头、时长和构图的编辑。
- 一段视频加上“extend this video”:场景延伸。
最后两条容易让人踩坑。如果附加一段剪辑并描述续写,但未使用extend一词,模型会将其视为编辑,并返回相同时长的视频。Popcraft 在“Extend Video”面板中会自动为你添加该关键词;若通过 API 或 MCP 操作,则需自行编写。
在同事首次渲染 40 秒视频前,我们会告诉他们的三件事
这不是提示清单,而是三件事,按照它们“咬你”的先后顺序排列。
每个腿段执行一个动作。Google 的指南记录了时间码语法,它完美对应 10 秒的腿段。这是我们本该提交的预告片提示词:
黄昏风暴中的海盗大帆船,骷髅旗,撕裂的黑色帆。一镜到底,不切场景。 [0-10秒] 船在浪中穿行;镜头向上摇至甲板。 [10-20秒] 留胡子的船长在舵轮前大声下令;船员齐声回应。 [20-30秒] 他在船头打开一个铁箱;里面溢出大量红色蔓越莓。 [30-40秒] 敌舰开火;蔓越莓在慢动作中散开,他举起弯刀。 要求:宽幅镜头光晕,青琥珀色调,管弦乐配乐,无字幕。
想说什么就说什么,包括“什么都没有”。 沉默也是一种请求。“无对白”、“无音乐,仅风声和水声”是官方指南中给出的简单否定式示例,且有效。提示词里没提声音,不等于要求无声。
用比直觉认为更少的词来修改。 Google 原话:“视频剪辑时,简洁的提示词效果最好。描述过多可能导致非预期的修改。” 说明改动,加上“其他保持不变”,然后停止输入。
与 Seedance 2.5 和 Veo 3.1 的对比
我们托管多个视频模型,因为没有哪个能赢遍所有场景。Omni 的优势在于单次请求即可生成一段自带声音的长视频,最长 40 秒,最高 4K 分辨率。Seedance 2.5 需要更多参考素材(30 张图片、10 段视频),并支持区域精确编辑。Veo 3.1 提供 8 秒视频的精细帧级控制。如果一个简报只要一条主视频加配乐:从 Omni 开始。如果产品必须在 12 个镜头中保持一致:从 Seedance 开始。
Popcraft 按交付的每秒成本计价,并按分辨率区分:720p 用于草稿,1080p 用于交付,4K 用于主打位置,且链式生成上限为 30 秒。在滑块上选择 3 到 40 秒之间的任意时长;Popcraft 在后台自动进行链式扩展,滑块只提供模型可达的时长,生成前看到的数字就是你要付的钱。
亲自去打破它
Gemini Omni 1.1 Flash 已经上线视频生成器,同时支持 Canvas 看板和 MCP 连接器。注册即送 100 积分,无需绑卡,可以直接上手。建议按我们的做法来:先跑一段 10 秒的 720p 视频,看看效果,再决定是否延长,或者拿一段你已有的满意片段来延长。预告片和延长版都放在模型页面,未经剪辑,含完整音轨;你刚才看到的两段 30 秒测试视频也在那里。
资料来源:Google 的「Introducing Gemini Omni」和「Gemini Omni 1.1 Flash lets you build with more control」两篇博文、Google DeepMind 的 Gemini Omni Flash 模型卡、Gemini Enterprise Agent Platform 上 Omni Flash 和 Omni 1.1 Flash 的模型页面,以及 Gemini API 开发者指南。文中测量数据为作者于 2026 年 9 月 3 日自行测得。