
中科大机器科学家 2.2:AI 不再只是做实验,而是自主创制新物质
5 年前,看到机器人做实验,很多人会觉得好智能。
现在再看到机器人做实验,会问:就这?
中国科学技术大学科学智能物质创制中心主任江俊,一语道破了这种心态变化:「因为人工智能大模型给人们带来了更高的期待」
10 月 18 日,合肥。智能科学家生态联盟第四届年会上,中科大正式发布了机器科学家 2.2 系统。
一提AI 做科研,多数人的第一反应还是自动化流水线:机械臂按设定好的流程配试剂、做实验、出数据。这个印象没错,但已经过时了。
2.2 走的是更远的一步 —— 它不只是做实验,而是开始做科研。
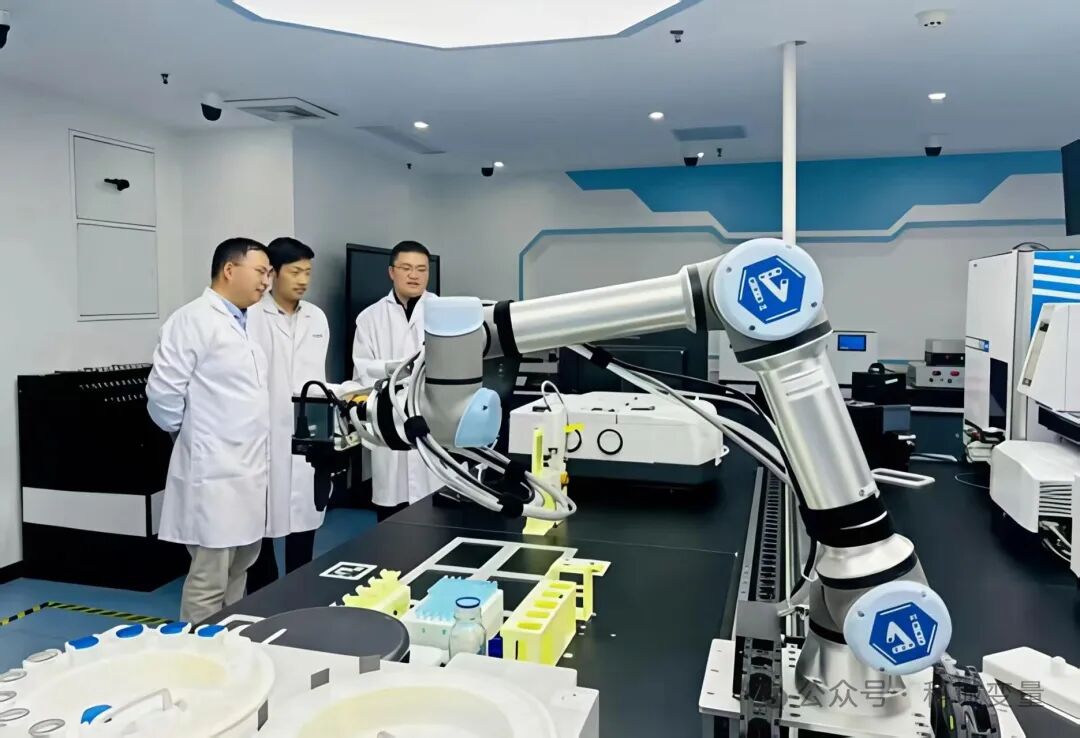
中科大机器科学家实验平台,科研人员观测机械臂开展自动化物质创制实验 | 图片来源:中国科学技术大学
自动化实验室,早就有了
传统自动化解决什么问题?按固定指令,更快、更稳地完成一件事。这个逻辑,自动化生产线已经用了很多年。
AI 带来的变化完全不同:让系统根据运行结果自主发现问题、动态调整方案。
江俊的原话是:「我们在做的事情,就是让自动化与思考深度融合,让机器不仅能读、会算、勤做,还具有创造力」
2.2 就是这套思路的最新产物。官方定义是「新一代智能物质科学基础设施」,融合大模型的「大胆假设」、小模型的「小心求证」与科研机器人的精准实验,目标是让机器自主创造新物质、发现新知识。
所以,真正值得问的问题不是它多能干,而是:
这套 "自主",是怎么被造出来的?
三层分工:大脑负责想,小脑负责算,机器人负责干
2.2 把科研能力拆成了三层,各干各的活。
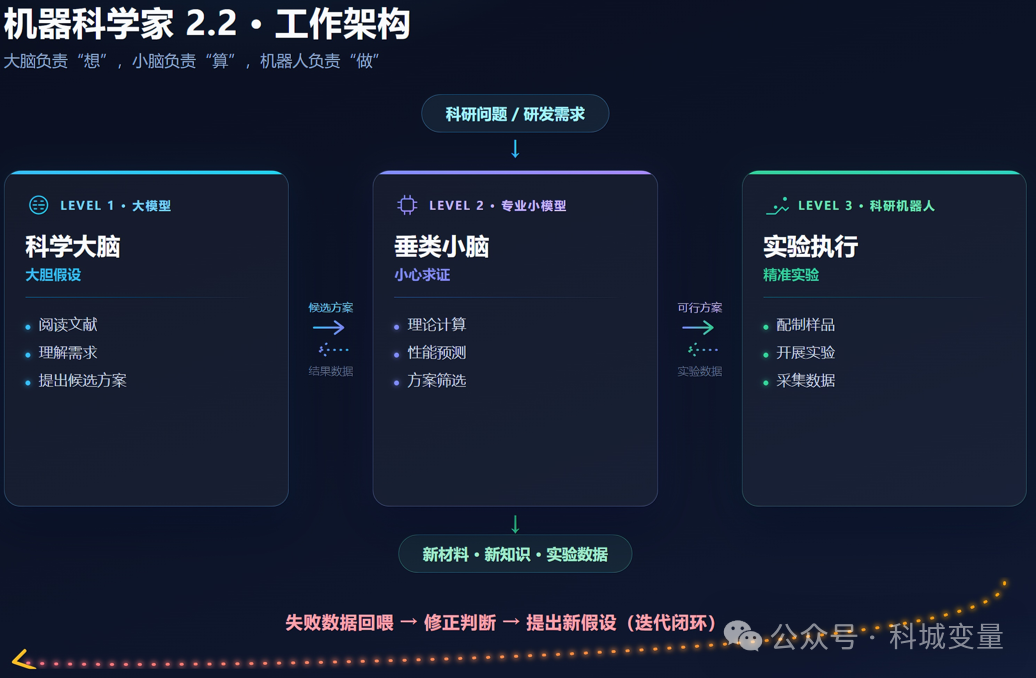
大模型是「科学大脑」。
它负责的第一件事是读文献。不是简单搜关键词,而是把跨领域、跨语言的论文拉通理解,从海量既有知识里找出没人试过的缝隙。
第二件事是理解研究需求 —— 研究者抛来一个模糊的问题,大模型把它翻译成可以执行的科研任务。第三件事是提出候选设想:几十种、上百种地往外给,发挥的是想象力。
但大模型有个毛病:容易天马行空。让它直接指挥实验,大概率会给你一个物理上根本做不出来的方案。
所以有了第二层 ——
专业小模型是「垂类小脑」。 面向化学、材料、生物医药等领域的专用模型,负责计算、预测、筛选。它受科学规律约束,提供的是推理力。大模型给出一个 "看起来有道理" 的分子结构,小模型会先跑一遍计算:这个结构热力学稳不稳定?合成路径现不现实?反应条件实验室能不能满足?
一句话:小模型是大模型的刹车。没有这层刹车,大模型的脑洞越大,实验事故越多。
第三层是科研机器人,负责执行力—— 把虚拟空间里的方案,变成真实的样品。
中科大的机械臂能稳定抓起 0.1 毫米厚的碳纸,比人手还稳;一台机器人日均约 2000 次精准操作,相当于五六个科研人员的工作量。它不挑时间、不喊累、不手抖,把方案从理论上成立变成瓶子里真有这个东西。
三层串起来,就是官方口径的那句话:大模型大胆假设、小模型小心求证、机器人精准实验。
闭环:失败的数据,也会回喂给模型
光有分工还不够。真正让 2.2 区别于自动化的,是它跑通了一个完整闭环:
需求理解 → 文献阅读 → 实验设计 → 自动计算 → 机器实验 → 迭代优化
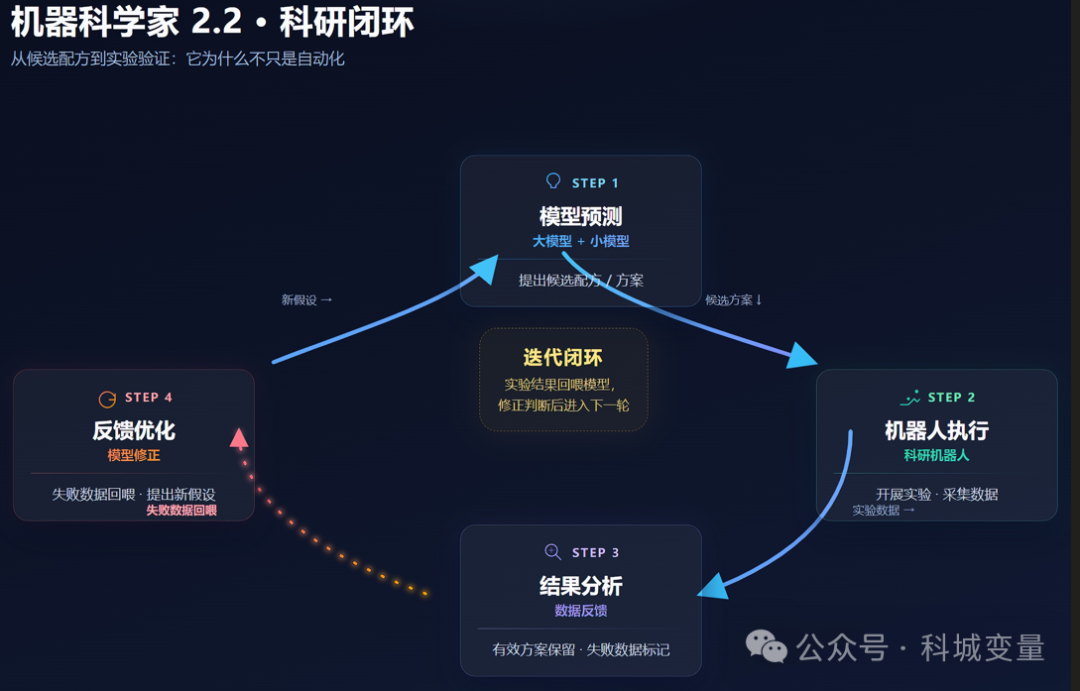
关键在最后一步:实验结果会重新反馈给模型。
有效的方案,持续迭代优化;失败的数据,用来修正模型的判断依据。这意味着每一次实验都不是终点,而是下一轮推理的输入。
小临(上一代机器科学家)就靠这个能力逆风翻盘过。
一次实验中,它试了上百种配方全部失败。如果换成传统自动化流程,这上百次失败只是浪费掉的试剂和时间。但小临做的事不一样:它把每一次失败都拆开分析 —— 是哪个变量把反应带偏了?哪些条件组合必然走向死胡同?通过分析失败数据,它锁定了关键变量,最终找到了解法。
这就是从失败里学习—— 人这么干,机器也开始这么干。
更进一步,这套闭环还能自己定义 "下一步该试什么"。实验结果回到模型后,模型不是简单地在旧方案上打补丁,而是重新评估整个搜索空间:哪些方向已经被数据排除,哪些方向值得加大投入。搜索效率因此是指数级提升,而不是线性堆算力。
从这个意义上说,2.2 已经不是按指令执行的工具,而是一个会自我修正的科研主体。
自主发现,带来了什么
自主不是口号,得看它产出了什么。
最出名的是火星制氧催化剂。
376 万种潜在配方组合,人工一一验证要 2000 年。小来自主阅读了 5 万篇论文,融合实验与理论计算数据,6 周找到最优解。成果发表在《自然・合成》上。6 周对 2000 年,这不是提速,是换了一种解题方式 —— 人靠经验慢慢逼近答案,机器靠搜索空间压缩直接锁定答案。
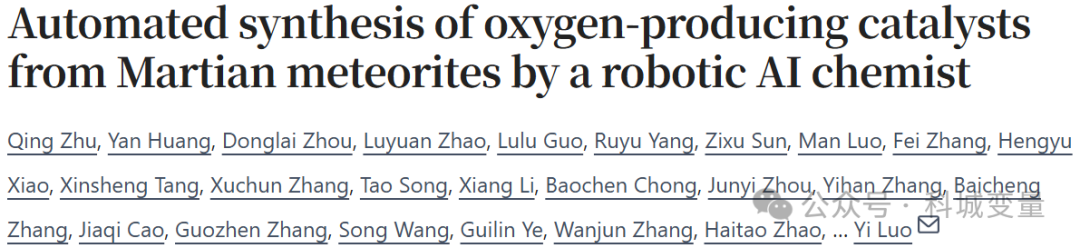
论文标题:Automated synthesis of oxygen-producing catalysts from Martian meteorites by a robotic AI chemist
论文链接:https://www.nature.com/articles/s44160-023-00424-1
新能源电池的吸能材料,是另一个例子。
要在 1400 度喷枪下不塌不燃,用于新能源汽车电池包。按传统试错法,光筛配方就要 10 年;小临 7 个月给出了最优解。材料要在极端工况下同时满足隔热、阻燃、结构稳定,靠人工经验配方,每换一个变量就要重跑一轮高温测试,10 年是最保守的估算。
还有跨学科的尝试:蛋白质设计。
团队搭建了「谱 — 构 — 效」一体化框架,在光谱特征、分子结构、功能表现之间建立关联,构建起蛋白质谱学大模型并嵌入系统。依托它,清华、中科大、安徽大学团队已创制出 6 种多功能超级抗菌肽、4 种能与小分子强力结合的靶标蛋白,以及针对阿尔茨海默病的靶标蛋白。这一步的意义在于:机器科学家不止会做化学合成,还能进入生命科学最核心的设计环节。
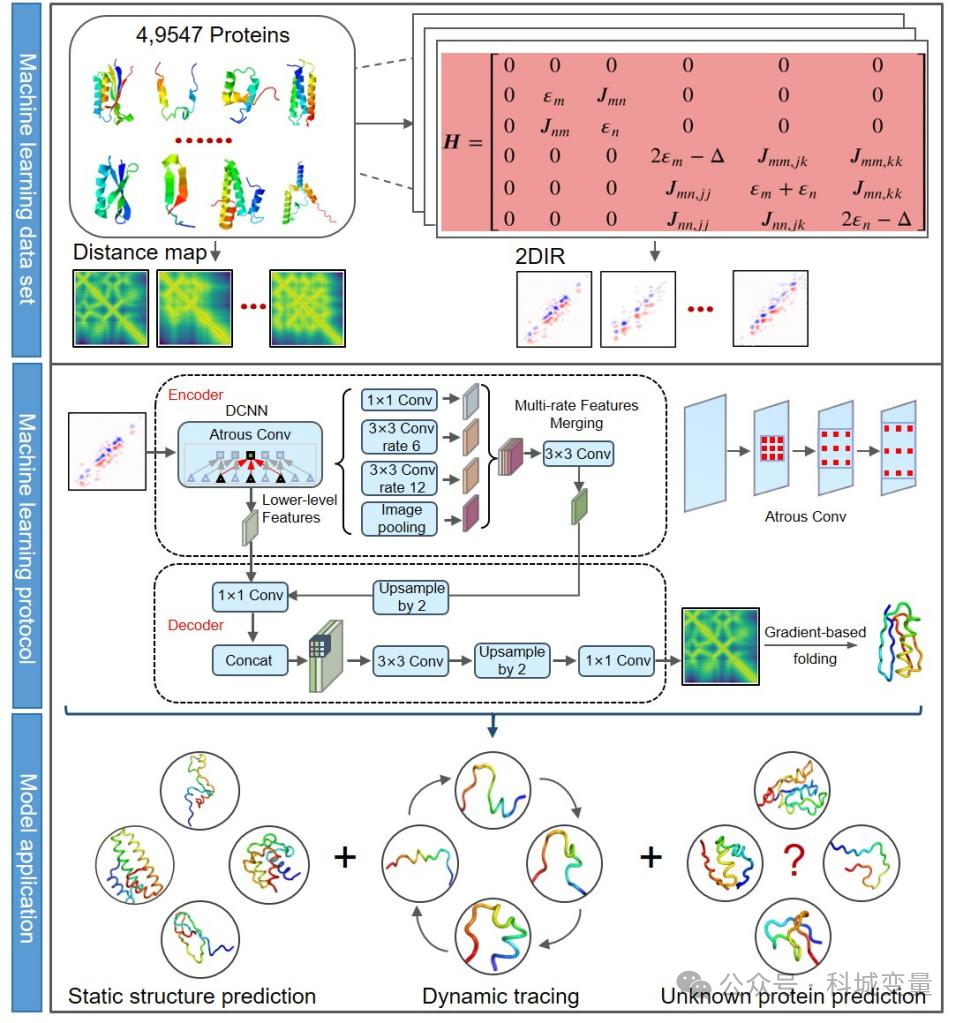
AI 从 2DIR 光谱预测蛋白质结构|图源:安徽大学 × 中国科大团队,PNAS
单原子铜杀菌剂 ——2 个月完成原本需要上千年的配方筛选;相变阻燃材料量产、用于新能源车电池包与特种消防服;大分子绿色农药推广超 300 万亩…… 成果还在持续往外冒。
按官方说法,这套系统把实验效率提升了百倍以上;今年 1 到 8 月,灵境造物 平台累计完成约 5 万项机器实验任务,服务近百家单位、580 位科研及产业用户。
为什么是合肥
这台机器长在合肥,不是偶然。
中科大有精准智能化学全国重点实验室,有江俊团队十几年的积累。2013 年的一个念头 ——能不能用大数据革新化学—— 后来长成了这套系统。
一个细节能看出积累的分量:团队为了给机器科学家喂数据,十几年里持续做实验数据标准化、做仪器接口改造。这些活儿不性感、不容易出论文,但没有这些地基,今天的大模型再强也指挥不动实验室里的机械臂。
2023 年 9 月,中科大牵头组建智能科学家生态联盟,成员覆盖北大、清华、中科院相关院所,以及华为、中石化、国家能源集团等产业龙头。
2025 年 9 月起,科研机器人指令集、接口函数、操作系统、科研模板库全球免费开源。江俊的说法是书同文、车同轨—— 设备接口不统一、数据格式不兼容,是自主实验室最大的拦路虎,中科大选择用开源先把标准立起来。
目前,系统已云端互联 19 个分布式创新设施、80 个 AI 驱动的化学与材料实验平台,覆盖约 80% 的化学与材料实验类型。
中科大还在建 AI 物质科学中试基地:9 层楼,规划 500 台以上多模态机器人、1000 余个工作站,日均试验上万次。从实验室走向中试基地,意味着这套系统正在从证明可行迈向规模化产出。
自主发现,不等于取代科学家
写到这里,得踩一脚刹车。
这套系统再能干,也不等于AI 取代科学家。官方口径一直是科研搭档—— 机器解决重复劳动,人做判断和创造。
但真正要解决的问题,明摆着有三个。
一是数据。 高质量数据是这套系统的燃料。但眼下数据孤岛林立;大量优质化学数据随论文发表在海外期刊,数据产出在国内、资产在海外,系统自己也面临数据饥饿。机器科学家能读论文、能跑实验,但读不到完整实验原始记录 —— 论文里只写了成功的配方,失败的过程往往被省略。这些沉默数据,恰恰是训练模型最缺的部分。
二是验证。 效率提升百倍更多是特定任务上验证过的数字,能不能在不同学科、不同实验室稳定复现,还需要更长时间检验。火星制氧、电池材料、蛋白质设计,每一个都是精心选择的标杆案例;换一批更冷门、数据更稀少的课题,系统还能不能保持这个效率,目前没有答案。
三是规则。 机器做实验、做发现之后,谁做最终判断、谁背责任、成果怎么署名?这些规则都还没成型。一篇论文的作者列表里,机器科学家该排在哪个位置?一个由机器主导发现的新药,出了事故谁来担责?这些不是技术问题,但迟早会成为制约技术落地的真问题。
接下来该看什么
对关注 AI 赛道的人来说,后面有三件事值得盯。
第一,2.2 之后,联盟会不会把更多学科(不只是化学材料)的科学家经验做成指令集 —— 这决定了能力边界能不能扩大。
第二,首期 3 亿的灵境造物基金,投出的第一批项目长什么样,能不能跑出真正的商业化产品。
第三,开源之后,海外科研机构到底用不用 —— 如果机器科学家真被全球用起来,那它就不只是中国故事,而是全球科研基础设施的故事。
从按指令执行到自主发现,这条路已经不是在论证能不能,而是在拼谁先跑通。