
不部署自己的 LLM 代理,你怎么知道背后发生了什么?
我觉得标题已经精准概括了核心思想,但此处不像 Twitter 那样简短,所以我会深入探讨一下。
你可能正专注于某个创意、一段代码,或者一个年营收数十亿的 SaaS 应用,哪怕它真的在拯救世界也没关系。也许你正在自动化抓取新发售的 Labubu 图片克隆流程,通过 ComfyUI 将 2D 图像转换为 3D CAD 模型,以便在春节全球制造业停工前加快复刻生产。又或者,你喜欢利用 token 搜索最强计算机软件,只为查一下麦辣鸡翅的宏量营养素信息,或者是其他荒诞的需求。
你很可能正在使用某种连接付费订阅服务的前端界面,无论那是 TUI、GUI 还是语音通话。你的数据进去,他们的数据出来,这就是他们卖的东西,我现在就很乐意买。为了证明工作正在进行,他们可能会展示类似这样的画面:
天呐,各位
这只是个视觉干扰项。这不是包含时间序列数据、专为工程师设计的 token 使用统计。面对这种粗制滥造的信息,我根本无法做出任何决策。那些大型实验室应该会洞察到好奇用户深入 Analytics 面板的需求,从而分享有价值的见解吧。
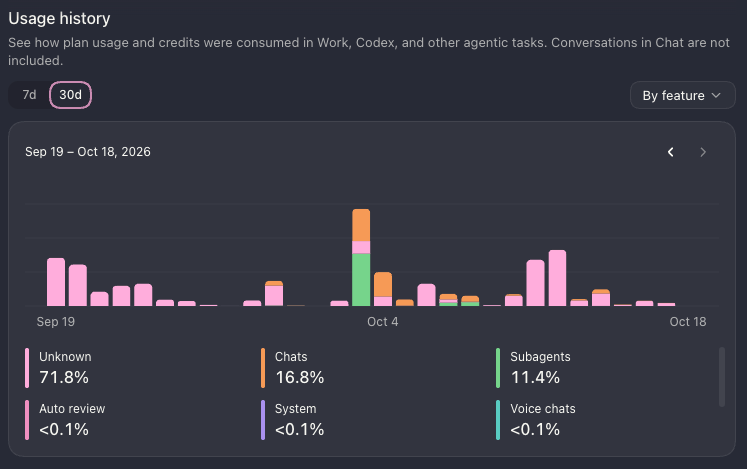
拿着这种数据,我依然无法做决策。我知道你们已经在喊了,“有 OTel 导出选项啊!!”。好吧,听起来不错。但这只是一个原因,我随手列出另外五个:
- 在单一且由你控制的端点上,同时支持多提供商和多模型
- 记录哪个 key 在什么时间通过什么客户端调用了什么模型及其状态
- 使用虚拟 API 密钥,避免把你的主密钥散落在各种工作流、agent 和 harness 里
- 基础设施由你掌控
- 你可以极速切换模型和提供商,无需再次从头搭建一切(反正你大概已经重建过第三回了)
我不打算推荐具体的代理服务,只想说你应该在自己掌控的环境里自己跑一个。选好之后,别忘了可以根据实际需求去改它。我就给自己的做了改造,方便洞察细节、支持自定义 MCP server 端点,还加了不少功能。不管你选哪个,都应该能拿到类似这样的数据。
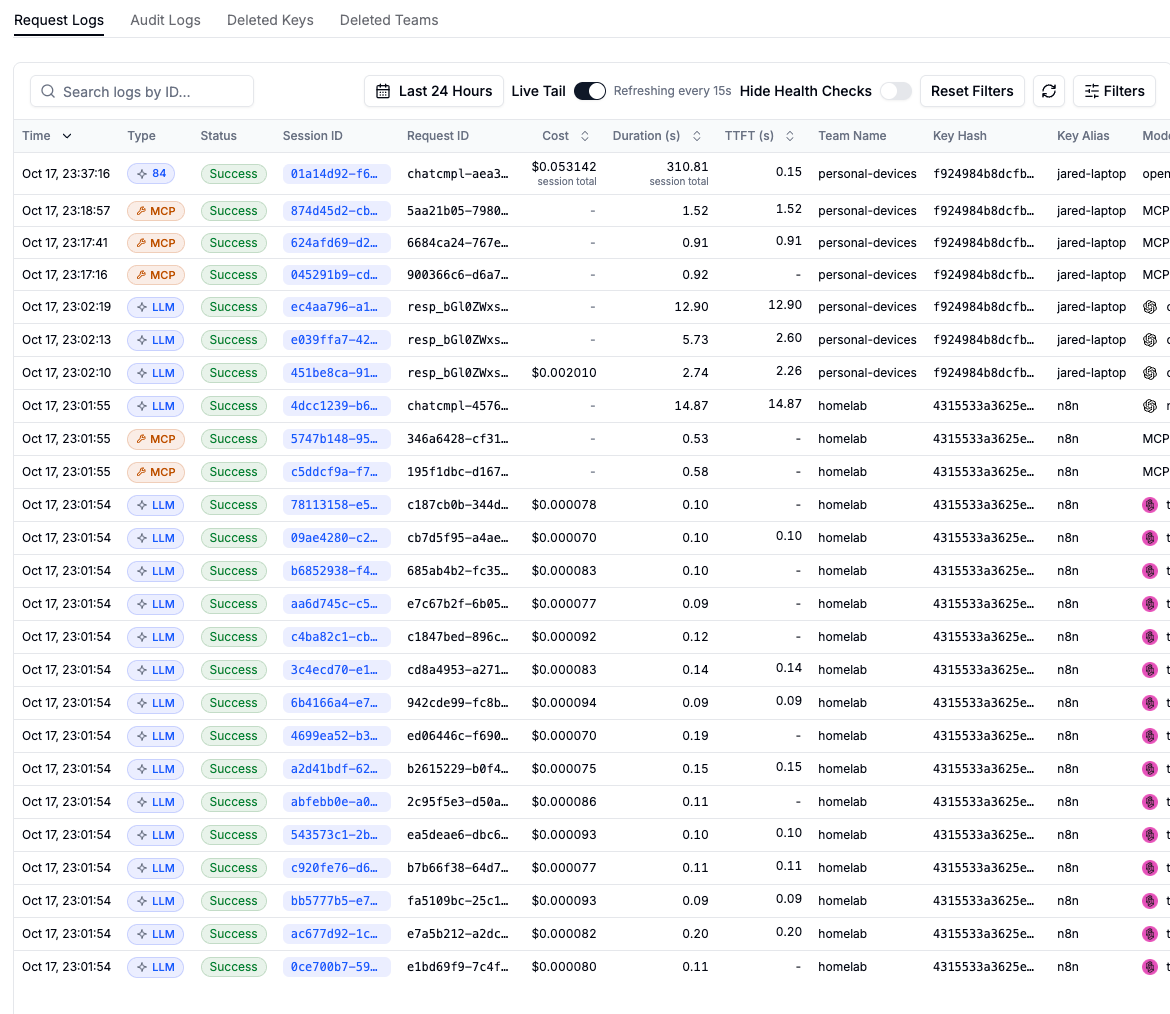
写代码时如果看到 cache miss,我手工排查 20 秒就能定位原因。虽然还没自动化,但我用的代理提供了 API,所以完全可以做成自动的。
把基础设施、应用可观测性、数据流转和存储都握在自己手里。在家里这么做是因为有趣,也是我喜欢的学习方式;在工作中这么做是因为不这样做就算没把工作做好。我可能永远无法把大语言模型的原理理解到能在面试白板上画清楚的程度,但我可以把它驯服,确保它在提供推理服务时被充分监控。