
TokenSpeed:面向智能体工作负载的光速 LLM 推理引擎
智能体编程正迅速从有前景的演示阶段,演变为重塑软件开发方式以及前沿 AI 系统构建与部署方式的一股力量。Claude Code、Codex、Cursor 等系统已获得海量用户采用,如今产生了惊人的 token 生成量。为了应对这一增长,需要建设消耗数十吉瓦电力的大型数据中心,背后是数千亿美元的投资。
在如此规模下,负责编排模型推理的系统效率变得至关重要。即使是每 GPU 吞吐量上的微小改进,一旦应用到整个生产集群,就能在满足不断增长的需求的同时,带来可观的容量节省。
TokenSpeed 概述
TokenSpeed 专为智能体推理场景从零开始设计,实现面向智能体工作负载的“光速”推理,具备编译器支持的并行建模机制、高性能调度器、安全的 KV 资源复用限制、支持异构加速器的可插分层 kernel 系统,并集成 SMG 以实现低开销的 CPU 端请求入口点。
建模层 采用本地 SPMD(单程序多数据)设计,在性能与易用性之间取得平衡。TokenSpeed 允许开发者在模块边界处指定输入/输出位置标注。一个轻量级静态编译器随后在模型构建时自动生成所需的集合通信操作,从而省去手动实现通信逻辑的麻烦。
TokenSpeed 调度器将控制面与执行面解耦。控制面用 C++ 实现为一个有限状态机(FSM),借助类型系统在编译期(而非运行时)强制实现安全的资源管理,包括 KV cache 的状态转移与使用。请求生命周期、KV cache 资源和 overlap 时序都通过显式的 FSM 状态转移和所有权语义来表示,因此正确性由可验证的控制系统保证,而非依赖约定。执行面则用 Python 实现,以保持开发效率,让研究人员和工程师能够更快地迭代功能,认知负担也更低。
TokenSpeed kernel 层将算子从核心引擎中分离出来,作为一个独立的一等模块化子系统。它提供了可移植的公共 API、集中式的注册与选择机制、有条理的实现组织、面向异构加速器的可扩展插件机制、精选的依赖项,以及支持快速迭代的统一基础设施。我们还在 NVIDIA Blackwell 上投入了大量精力做性能优化——例如,我们构建了面向 agentic 工作负载的最快的 MLA(Multi-head Latent Attention)kernel 之一。在 decode kernel 中,我们将 q_seqlen 和 num_heads 分组,以充分利用 Tensor Core,因为在这类场景中 num_heads 往往较小。binary prefill kernel 则包含了精调过的 softmax 实现。TokenSpeed MLA 已被 vLLM 采纳。
性能预览
今天我们分享 TokenSpeed 的性能预览。项目于 2026 年 3 月中旬启动开发。引擎和 kernel 仍在积极开发中,预计下个月进行生产化加固。未来几周还会有更多 PR 合入。
编码智能体带来了极其苛刻的推理负载。上下文通常超过 50K tokens,对话往往跨越数十个回合。大多数公开基准测试无法完全捕捉这种场景。我们与 EvalScope 团队合作,使用 SWE-smith 轨迹评估 TokenSpeed,这些轨迹高度模拟生产环境中的编码智能体流量。由于生成速度对智能体的用户体验至关重要,我们的目标是在保持每位用户 TPS(每秒 token 数)底线的前提下,最大化每 GPU TPM(每分钟 token 数) —— 通常为 70 TPS,有时甚至达到 200 TPS 或更高。
我们将< a href="https://github.com/lightseekorg/tokenspeed/tree/main/test/agentic_benchmark">我们的设计与 TensorRT-LLM——目前在 NVIDIA Blackwell 上最先进水平——进行了基准测试,并在我们认为针对智能体工作负载存在更优权衡的地方偏离了其方法。
注: 本博客聚焦于单节点(非分离式)部署。PD 分离支持正在清理中,我们将在后续专门文章中详细介绍。
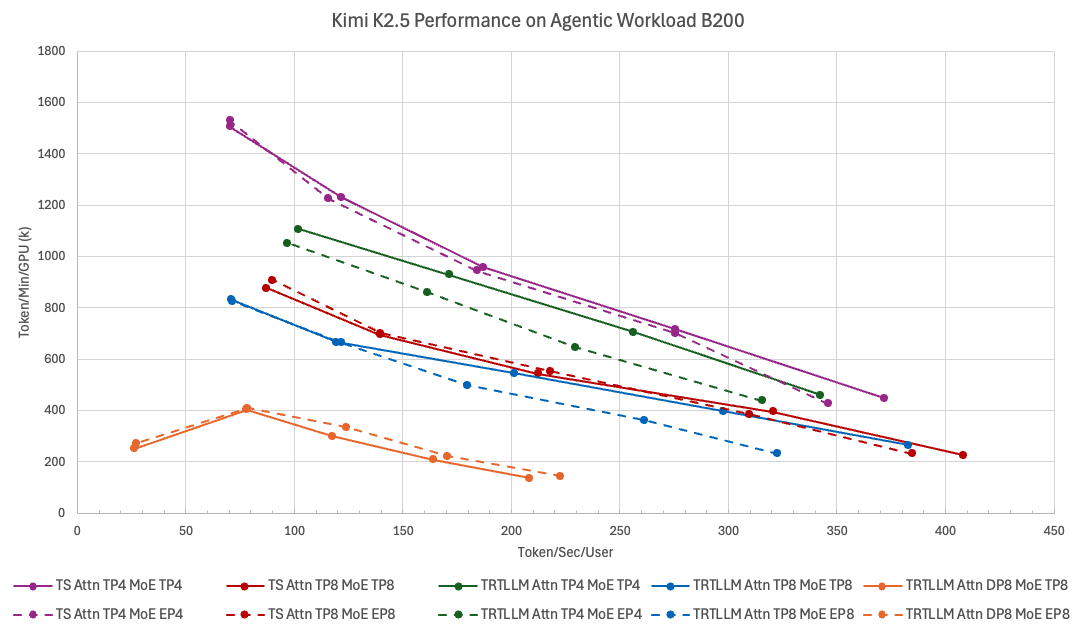
下图展示了不同部署配置下(不含 PD 分离)TokenSpeed 与 TensorRT-LLM 在 Kimi K2.5 上的性能帕累托曲线。每条曲线以 TPS/User(x 轴)作为延迟指标,以 TPM/GPU(y 轴)作为吞吐量指标,通过扫描并发数得出。对于编码智能体(高于 70 TPS/User),最佳配置为 Attention TP4 + MoE TP4,TokenSpeed 在整个帕累托前沿上均优于 TensorRT-LLM:在最小延迟场景(batch size 为 1)下快约 9%,在 100 TPS/User 附近的吞吐量高约 11%。
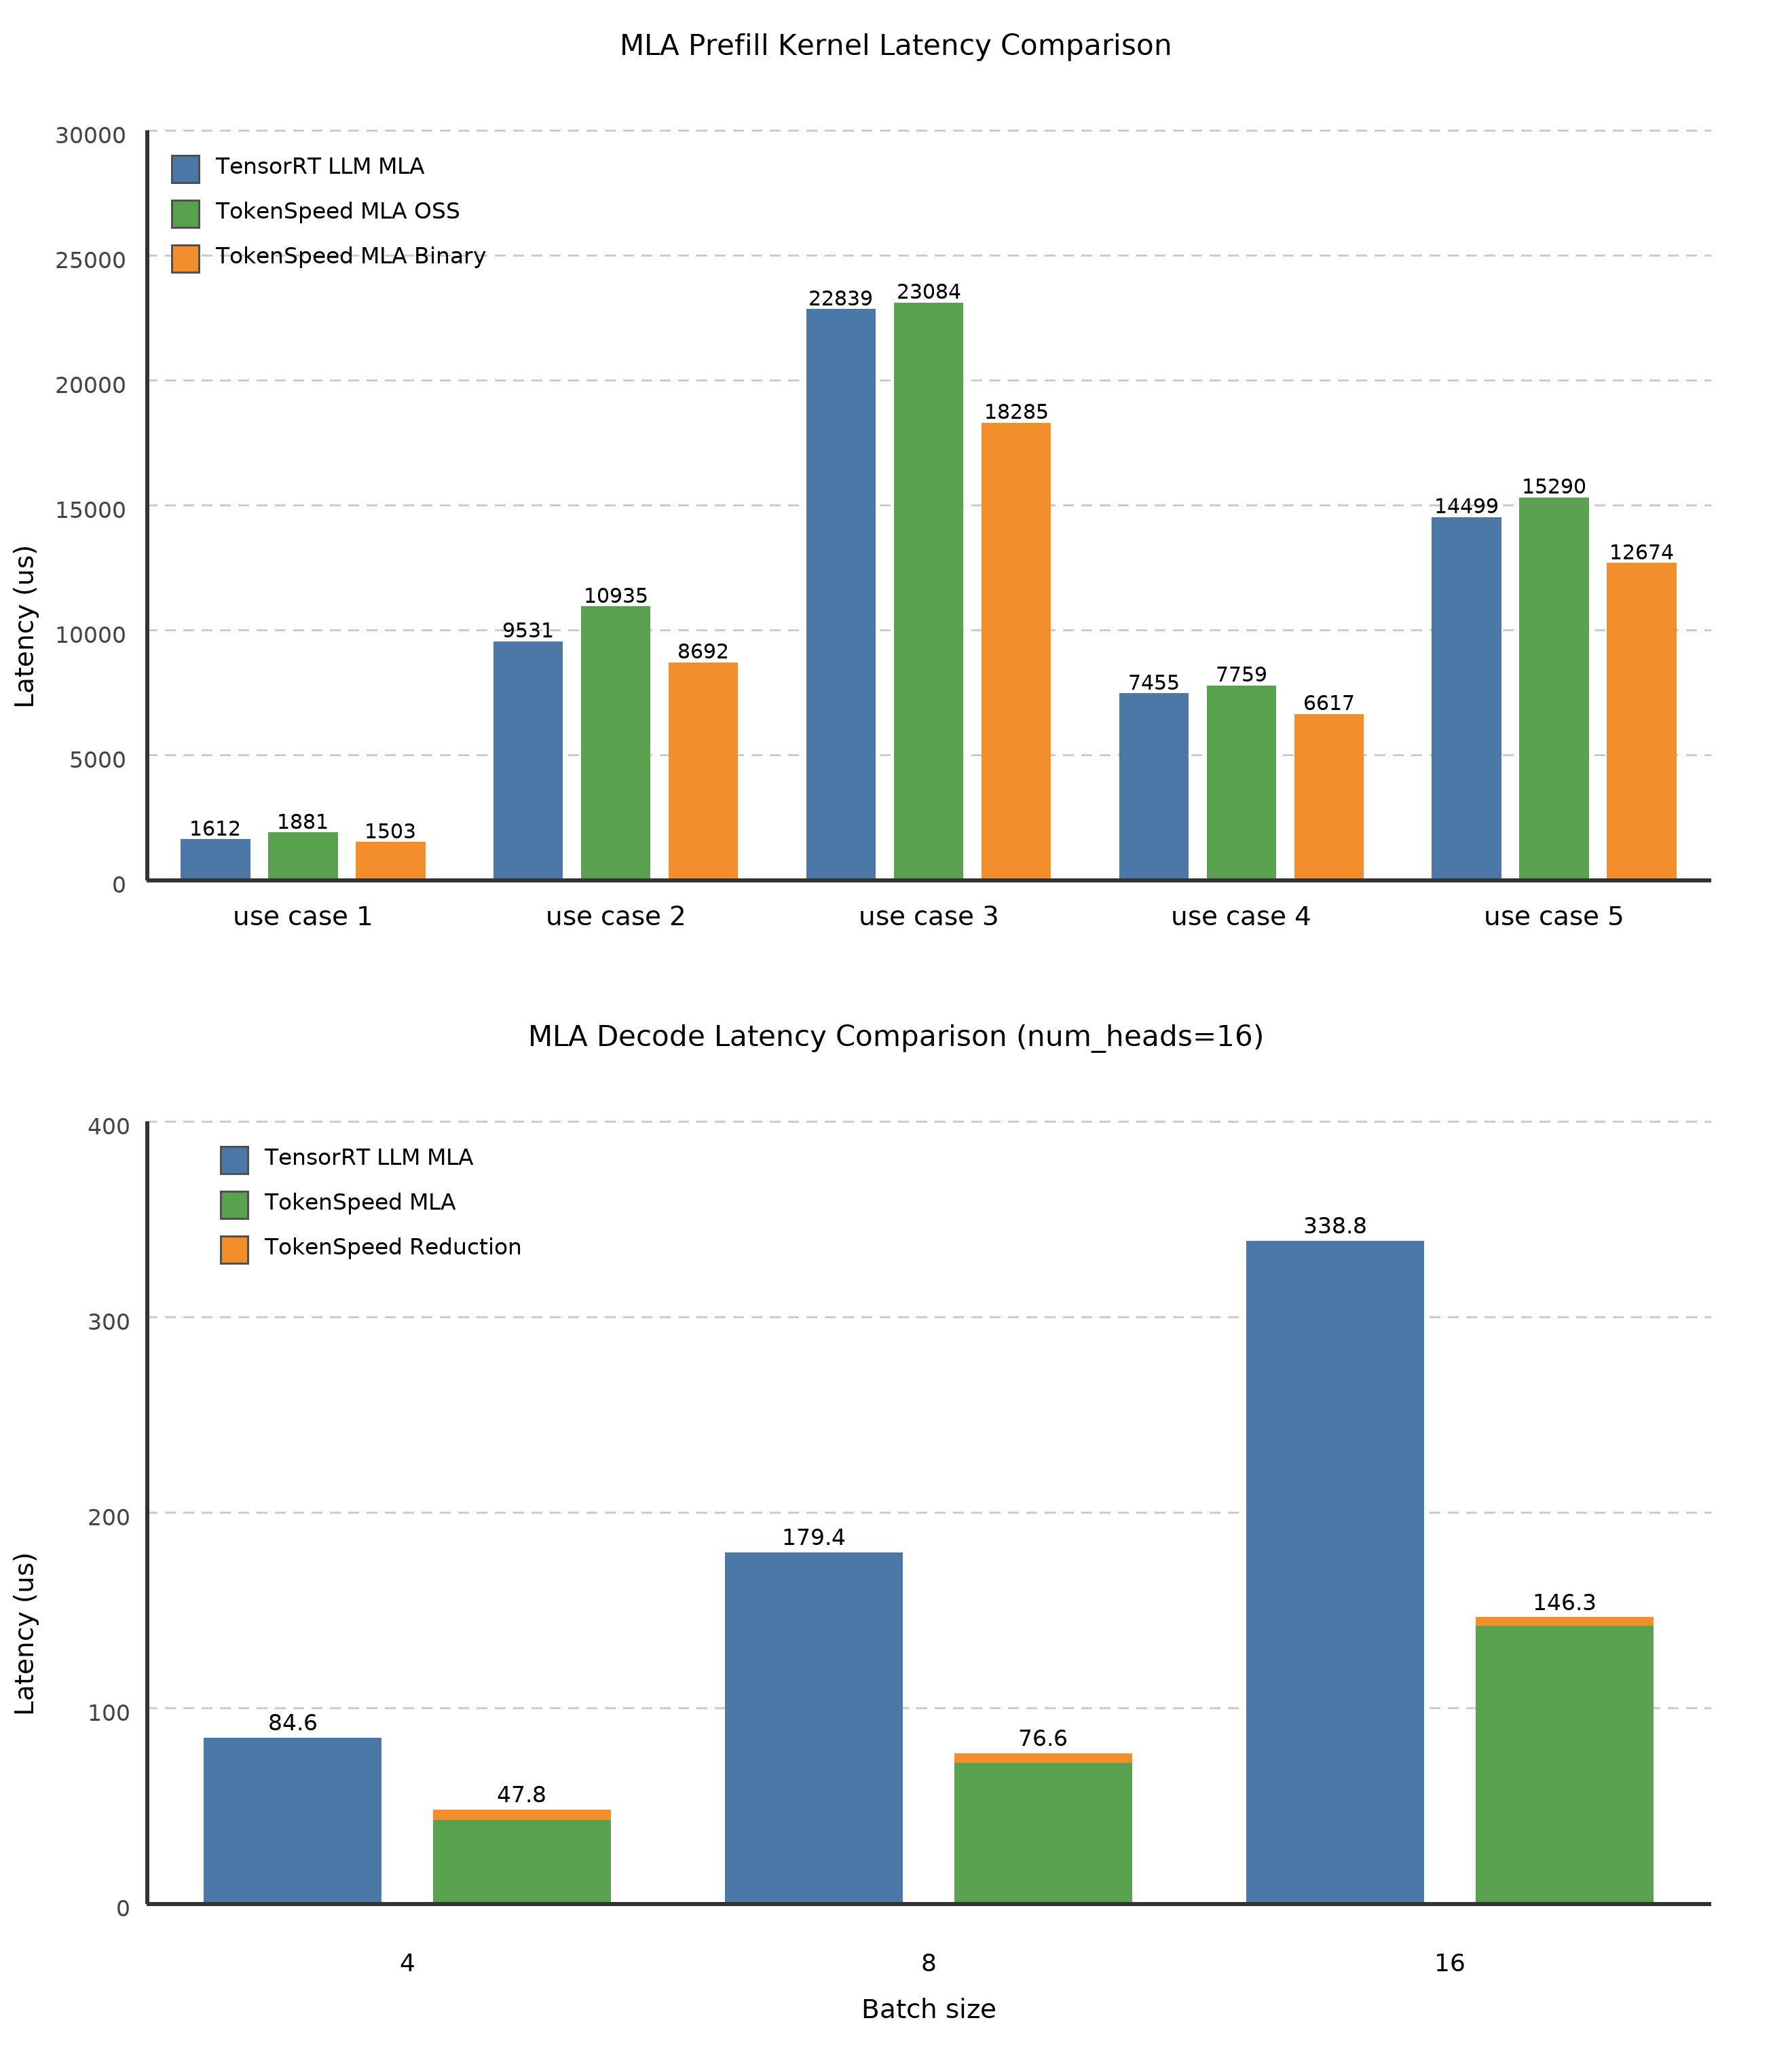
我们的核心优化之一是 TokenSpeed MLA。下图将 TokenSpeed MLA 与 TensorRT-LLM 的 MLA 进行了对比,后者是目前 NVIDIA Blackwell 平台上的当前 SoTA。我们优化的二进制版本预填充(prefill)内核利用 NVIDIA 内部参数微调了 softmax 实现,在代码智能体面临的五种典型预填充工作负载(带长前缀 KV cache 的 prefill)上全面超越了 TensorRT-LLM 的 MLA。解码内核将查询序列轴并入 head 轴,以更好地填充 BMM1 的 M tile,从而提升 Tensor Core 利用率。结合其他优化,在典型的带有投机解码(speculative decoding)的解码工作负载上(batch size 为 4、8 和 16,含长前缀 KV cache),延迟相比 TensorRT-LLM 几乎减半。
致谢
TokenSpeed 由 NVIDIA DevTech、AMD Triton、Qwen Inference、Together AI、Mooncake、LongCat、FluentLLM、EvalScope、NVIDIA Dynamo 和 LightSeek Foundation 联合开发。[1]
我们非常感谢 TensorRT-LLM 的维护者,他们的工作为我们树立了衡量基准。包括 one-CUDA-graph 优化和前向传播优化在内的多项优化均受到 TensorRT-LLM 的启发。我们也感谢更广泛的开源推理社区——包括 Triton、FluentLLM、vLLM、EvalScope、FlashInfer、SGLang 等——不断突破生产级 LLM 服务能力的上限。TokenSpeed 运行时中的部分组件源自 FluentLLM 的上游血统,同时在调度器、建模层、内核栈以及 TokenSpeed MLA 方面进行了大量原创性工作,整个系统专为极速智能体推理进行了优化。
我们感谢 OpenAI、NVIDIA、AMD、Verda 和 Nebius 提供的算力支持。
引用
bibtex@misc{tokenspeed2026,
author = {{TokenSpeed Team}},
title = {{TokenSpeed}: A Speed-of-Light {LLM} Inference Engine},
year = {2026},
howpublished = {\url{https://github.com/lightseekorg/tokenspeed}}
}贡献者
共创者。 Enwei Zhu、Jiying Dong、Xipeng Li(NVIDIA)· Pengzhan Zhao、Kyle Wang、Lei Zhang(AMD)· Jiandong Jiang、Tuan Zhang、Minmin Sun(Qwen Inference)· Jue Wang、Yineng Zhang(Together AI)· Hongtao Chen、Mingxing Zhang(Mooncake)· Bo Wang、Fengcun Li(LongCat)· Xiangyang Ji、Yulei Qian(FluentLLM)。
核心运行时。 调度器——Yulei Qian、Fengcun Li、Bo Wang。算子(Kernels)——Lei Zhang、Pengzhan Zhao、Kyle Wang。建模——Yulei Qian、Xiangyang Ji、Jue Wang。MLA——Albert Di、Jiying Dong。文法与采样——Jue Wang、Weicong Wu。MoE——Hongtao Chen。VLM——Hongtao Chen、Fengcun Li、Bo Wang。
模型优化。 Kimi K2.5 光速优化——Enwei Zhu、Jiying Dong、Yue Weng、Albert Di。Qwen 3.6——Minmin Sun、Tuan Zhang、Jiandong Jiang。DeepSeek V4——Jiying Dong、Qingquan Song、Qiukai Chen、Yechan Kim、Hejian Sang。AMD 上的 GPT-OSS——Pengzhan Zhao、Kyle Wang。Minimax M2.7——Fan Yin、Jue Wang。
系统集成。 分布式运行时——Xuchun Shang、Teng Ma。投机解码(Speculative decoding)——Yue Weng。AsyncLLM 与 SMG——Simo Lin、Keyang Ru、Xipeng Guan。TensorRT-LLM 算子——Aaron Liu、Enwei Zhu。指标——Fred Wang。EvalScope 基准——Xingjun Wang、Yunlin Mao。Dynamo 集成——Yuewei Na、William Arnold。↩︎