
538小时「极脏」人类数据,真机不到1小时:港大让机器人学会拆快递、打胶枪、做冷饮

 如果给机器人看的训练视频,来自杂乱的家庭、繁忙的工厂和药房,相机还随着人的走动不断剧烈晃动,它还能从中学会精细操作吗?
香港大学 MMLab 团队最近的一项工作表明,这些看起来「不够干净」的数据,同样可以用于训练机器人。
近日,团队提出 EgoWild2Dex,直接利用 538.9 小时未经刻意编排的真实人类第一视角操作数据训练机器人。在每个下游任务使用不到 1 小时真机数据的情况下,机器人能够连续完成拆快递、使用热熔胶枪固定手办、制作冷饮等复杂双臂灵巧长时序任务,平均成功率达到 96.7%。
与其先把数据「清洗」成实验室里的样子,EgoWild2Dex 选择直接利用保留了视角晃动、复杂背景和长尾物体分布等真实因素的自然数据。
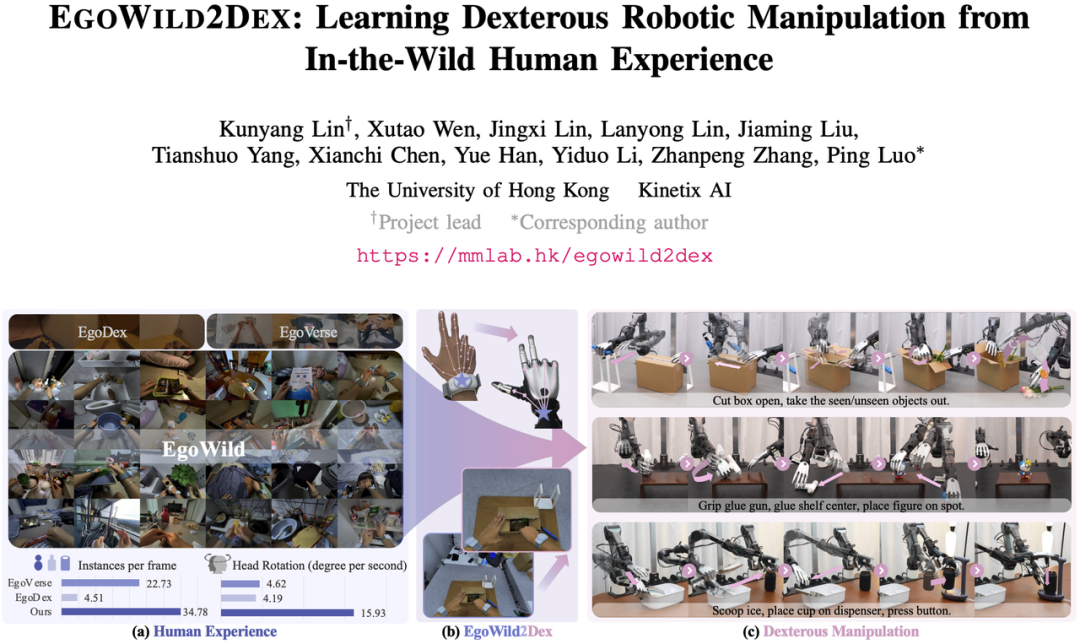
EgoWild2Dex 从真实世界第一视角人类经验中学习,并将这些经验迁移到双臂灵巧机器人,实现长时程复杂操作。
目前,该研究论文已在 arXiv 公开,项目主页也已上线。数据集、模型与代码计划后续开放。
项目主页:https://mmlab.hk/egowild2dex
论文链接:https://arxiv.org/pdf/2609.23755
机器人数据很贵,但人类经验无处不在
机器人学习长期面临一个现实问题:真实机器人数据太贵了。
让机器人学习复杂操作,往往需要数采人员在真实机器人上反复进行遥操作、采集专家数据并处理失败轨迹。一旦任务涉及双臂协同、工具灵巧使用、精细接触和长时序操作,数据采集成本还会进一步上升。而人类每天都在真实世界中执行海量操作:拆包、整理货物、装配零件、拿取工具、制作饮品…… 这些日常行为本身,就是现成的操作经验。
因此,越来越多研究开始尝试利用人类第一视角(Egocentric)数据帮助机器人学习。不过,此前不少数据集仍围绕预先设计好的任务,在相对受控的环境中进行采集。但受控环境里的数据,与机器人实际部署时遇到的场景仍有明显差距。
EgoWild2Dex 的做法更直接:不再要求人为地把数据「拍干净」,而是直接进入真实环境,记录人类原本就在做的事情。研究团队在家庭、工厂、药房、医院、超市、包裹站等场景中采集自然人类操作。这些视频没有刻意维持稳定视角,也没有尽量去除背景干扰。人在走路、低头、转身时,相机视角都会跟着剧烈变化。数据显示,EgoWild 中,每秒累计头部旋转角度平均达到 15.93°,每帧图像平均包含 34.78 个不同的物体实例。
按传统机器人数据采集的标准来看,这批数据确实相当「脏」。但这里的「脏」并非指标注错误或数据质量差,而是指它保留了真实世界本来的复杂性。
看似阻碍模型学习的「噪声」,如何成为机器人训练的关键资源?
利用人类数据训练机器人的第一个障碍,是人类与机器人之间的视角差异。
人类的第一视角相机通常安装在头部。人在执行任务时,会不断走动、转头、低头,因此画面具有非常强的动态变化。相比之下,机器人相机的视角往往更加稳定。如果直接把两种数据混在一起训练,模型实际上需要同时面对两套差异很大的视觉分布。
为此,EgoWild2Dex 提出了 GeoFormer(Geometric Transformer),一个轻量级、可微的几何变换模块。
简单来说,GeoFormer 会把「人在移动时看到的画面」,变换到更接近机器人相机的视角。
GeoFormer 学习人类第一视角与机器人视角之间的几何关系,并对画面进行动态变换,从而降低人类数据与机器人数据之间的视觉差异。这意味着,人类在采集数据时不需要为了适应机器人而刻意保持相机稳定。相比依赖精确相机标定、三维重投影和图像修复的传统 Project + Inpaint 流程,GeoFormer 对精确标定的依赖更低,处理速度提升了 21.9 倍,视觉对齐效果也更好。
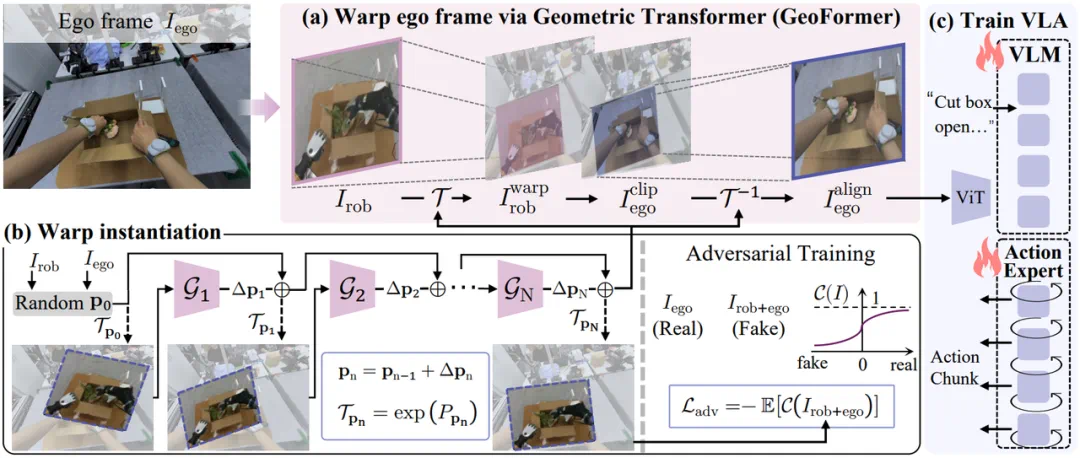
GeoFormer 的视角对齐与训练流程。(a)视角对齐:预测机器人视角与人类第一视角之间的几何关系,并将人类观测对齐至机器人视角;(b)几何变换学习:通过多级预测逐步优化变换参数,并利用判别器监督生成更加自然的结果;(c)VLA 训练:将对齐后的人类数据与机器人数据共同用于策略训练
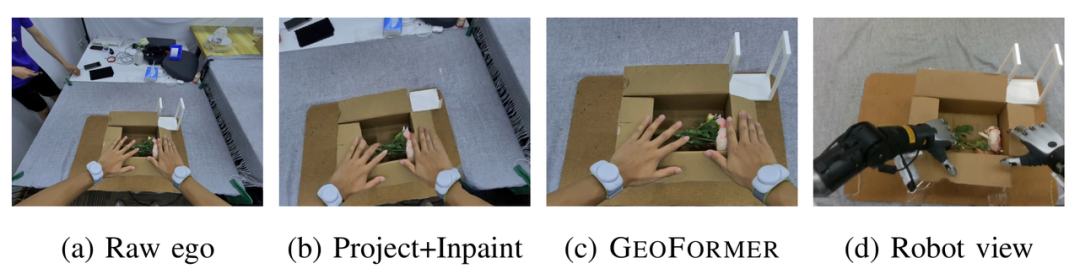
GeoFormer 将动态的人类第一视角观测对齐到更接近机器人相机的视角,从而缩小人类与机器人之间的观察差异
视角对齐之后,还需要解决人类动作与机器人动作之间的差异。
EgoWild2Dex 利用动作重定向(Retargeting)和逆运动学,将三类数据映射到统一的机器人原生动作空间:(1)自然环境下采集的人类第一视角数据(Ego);(2)在机器人视角下采集的手套演示数据(Glove);(3)真实机器人演示数据(Robot)。经过重定向后,三类数据可以使用统一的机器人动作表示,共同参与策略训练。
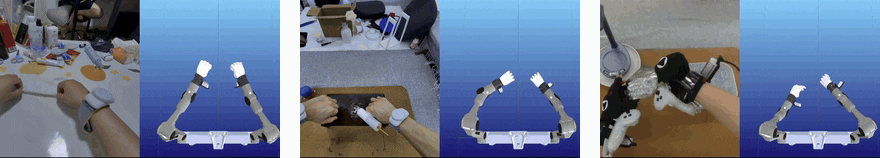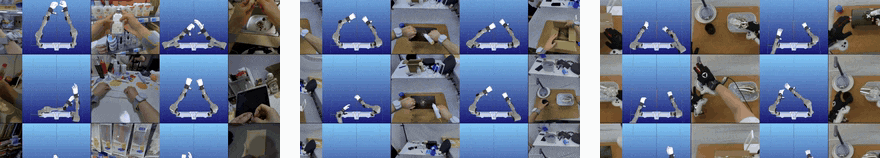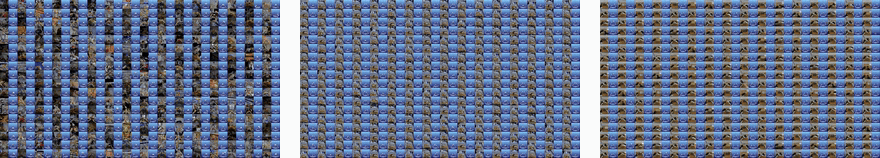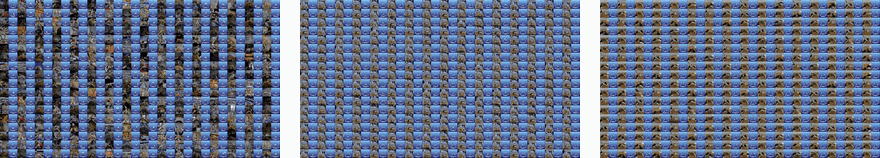
将开放场景人类第一视角数据、下游任务相关的人类第一视角数据,以及机器人视角下的手套演示数据,映射到统一的机器人原生动作空间
在完成视觉和动作空间的对齐之后,EgoWild2Dex 采用了一套渐进式的人机联合训练范式(Progressive Human-Robot Training)。整个训练分三步:先用大规模人类数据预训练,再加入任务相关数据,最后用少量真机数据精调。
1. 开放式预训练(Human-to-Robot Learning):首先,模型利用大规模 In-the-Wild 人类第一视角数据进行预训练。这一阶段并不要求数据全部来自机器人最终需要执行的任务。VLA 模型由此接触更多场景、物体和操作方式,学习通用的视觉与操作先验。
2. 人机协同训练(Human–Robot Co-training):接下来,模型进一步加入与下游任务相关的 Ego 数据、手套演示数据,以及少量真实机器人数据。借助统一的动作空间,人类提供的广泛经验开始与具体机器人任务建立对应关系。
3. 真机精调(Robot-Domain Refinement):最后,再利用少量真实机器人示范和恢复轨迹对模型进行微调。这一阶段主要用于进一步适应真实机器人中的物理接触、动力学和执行误差。每个下游任务使用的真机数据不到 1 小时。
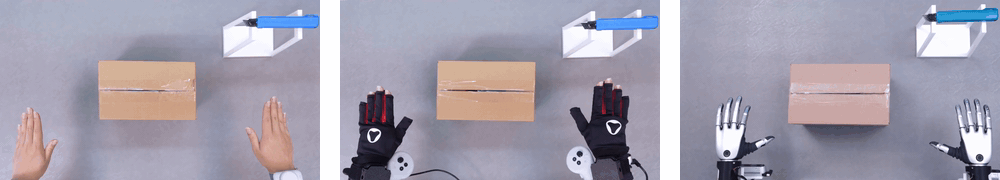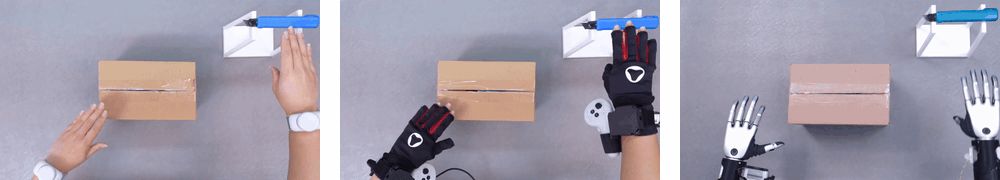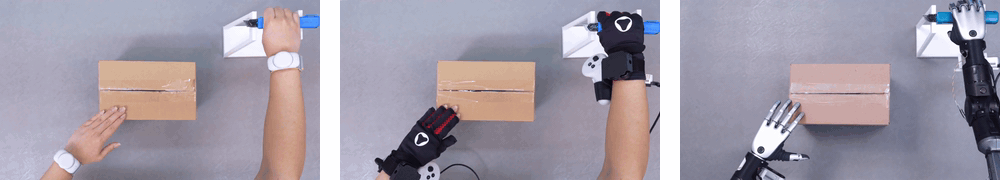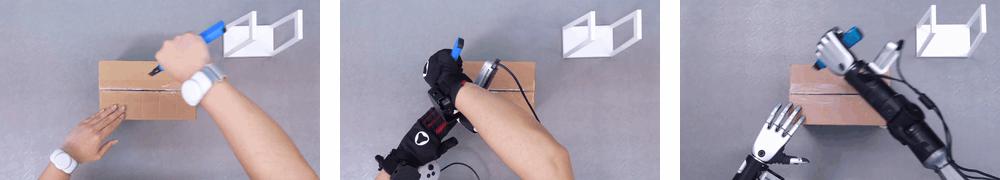
Ego 数据、手套数据和真机数据
研究团队同步推出了大规模「极脏」的真实人类第一视角数据集 EgoWild。该数据集包含 538.9 小时的操作数据,覆盖约 17.9 万个操作片段、12.6 万条独立任务描述和 1282 个物体类别。这里的「脏」并非指错误标注或低质量数据,而是指数据没有刻意回避真实环境中的复杂因素。EgoWild 直接在家庭、工厂、药房、医院、超市、包裹站等场景中采集,保留了相机运动、复杂背景、长尾物体分布和自然的人类操作流程。EgoWild 不仅提供了丰富的语言标注,还包含全身人体姿态、手部关节等细粒度标注,并将操作行为划分为原子动作、动作指令和技能指令三个层级。此外,数据处理流程还针对手部动作识别、人体滑步等问题进行了专门优化,为模型学习提供了更高质量、更完整的监督信息。
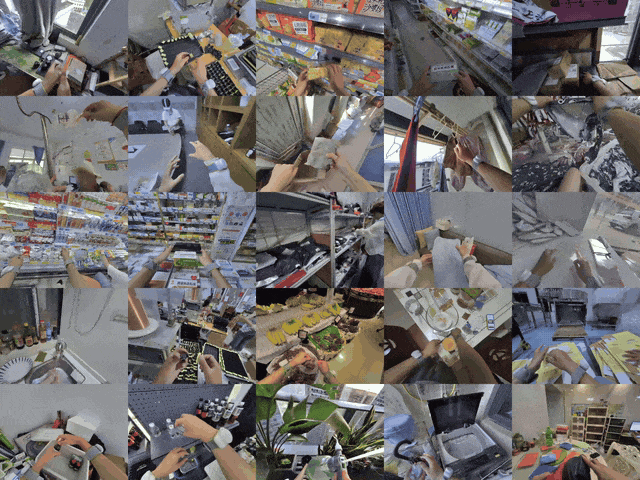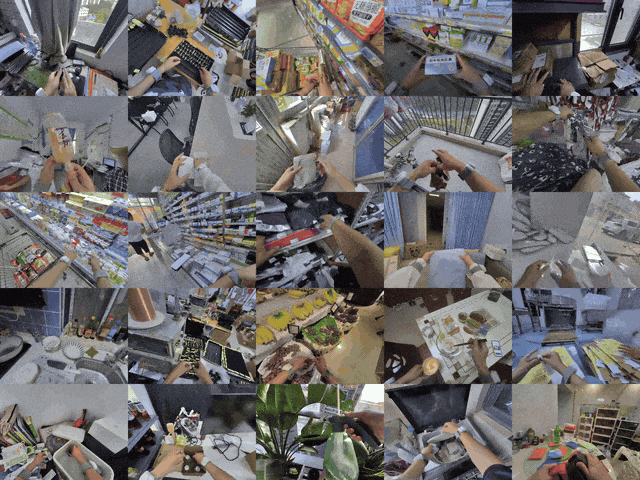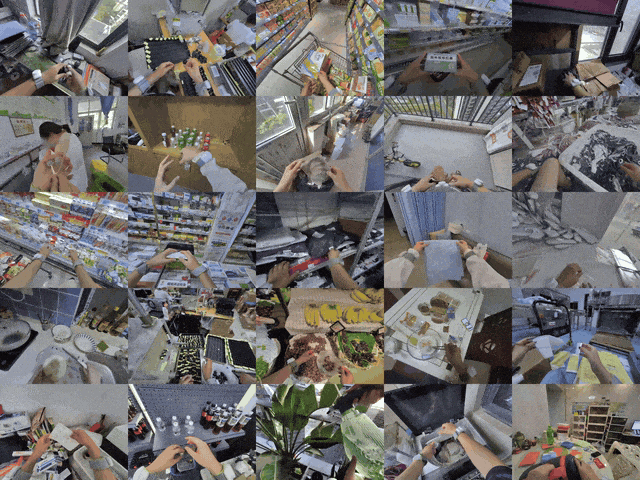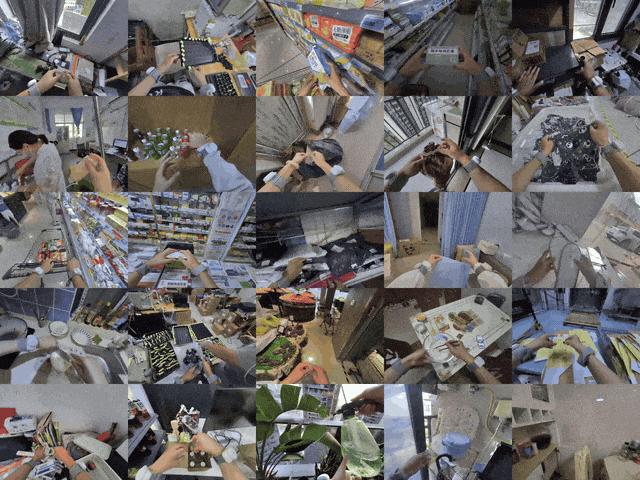
EgoWild 记录家庭、工厂、药房、医院、超市等真实环境中的自然人类操作,保留动态视角、复杂背景和多样化的操作流程
实验验证
在真机实验中,研究团队测试了三个复杂的长时序双臂操作任务:「使用美工刀划开胶带并开箱」、「使用热熔胶枪固定摆件」以及「使用铲子铲冰并制作冰饮」,模型实现了 96.7% 的平均任务成功率,并在实验中展现出应对外界扰动、恢复任务执行的能力。在开箱拆快递任务中,面对训练时未见过的物体,研究团队还测试了模型面对训练时未见物体时的零样本泛化能力,平均成功率为 33.3%。此外,研究还将该框架从松灵 Piper 机械臂迁移到另一种机器人机械臂 Tianji Marvin Pro 上,展示了方法迁移到不同机器人本体的可行性。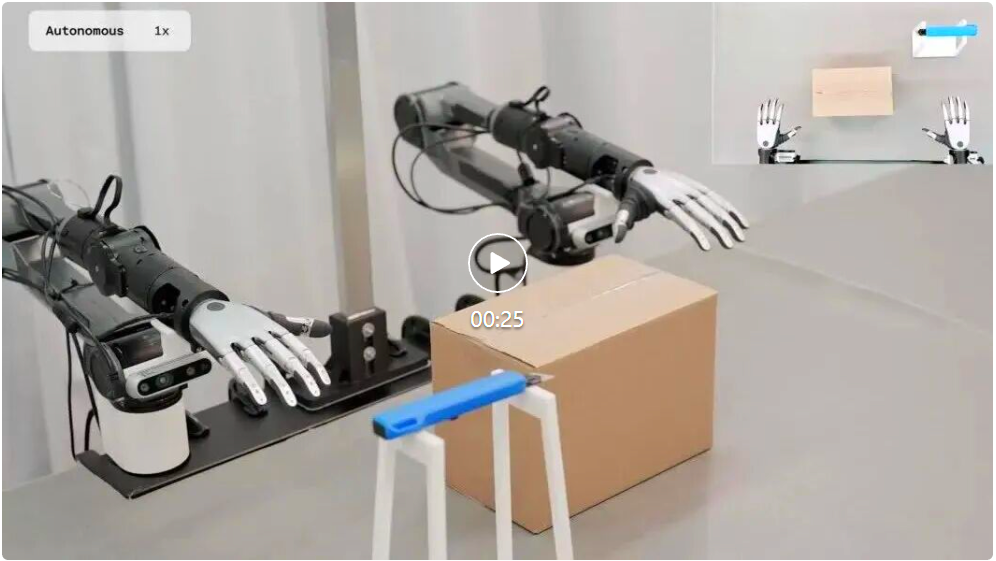
连续完成抓取工具、切开胶带、打开箱盖并取出物体等多个子任务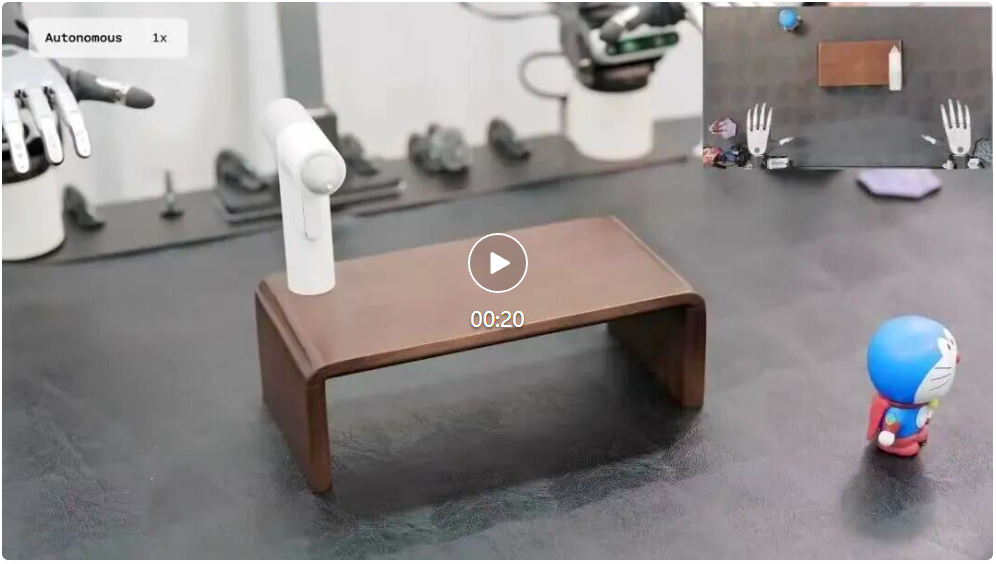
双手协同操作胶枪与摆件,完成对准、施胶、抓取和固定等连续精细操作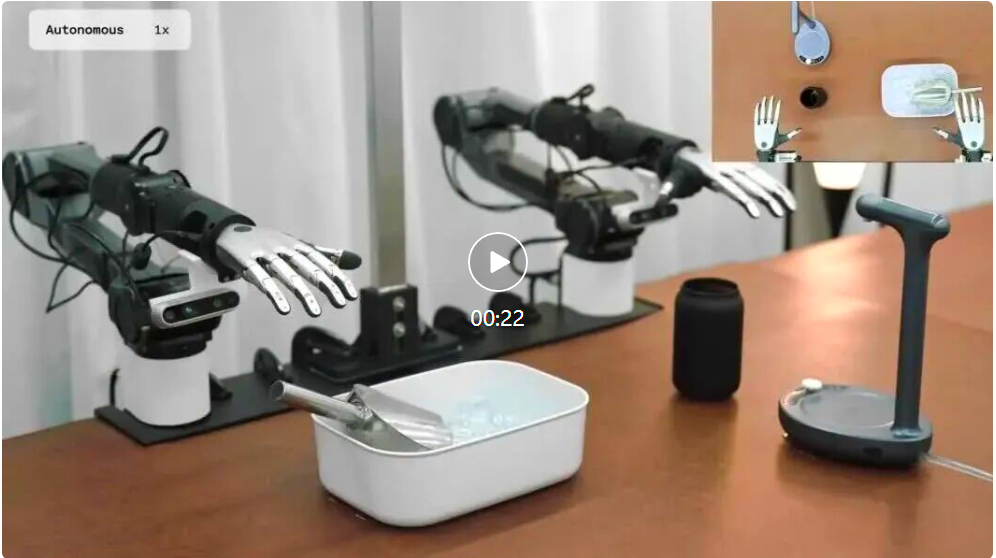
完成舀冰、倒冰、持杯、对准出水口和接水等多阶段双臂操作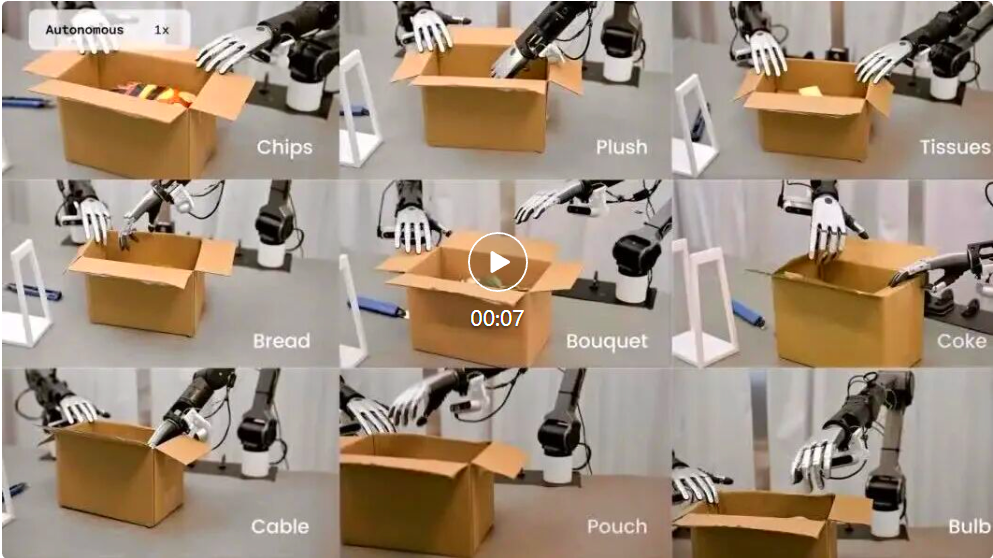
面对训练中未见过的箱内物体,机器人仍能尝试完成抓取与取出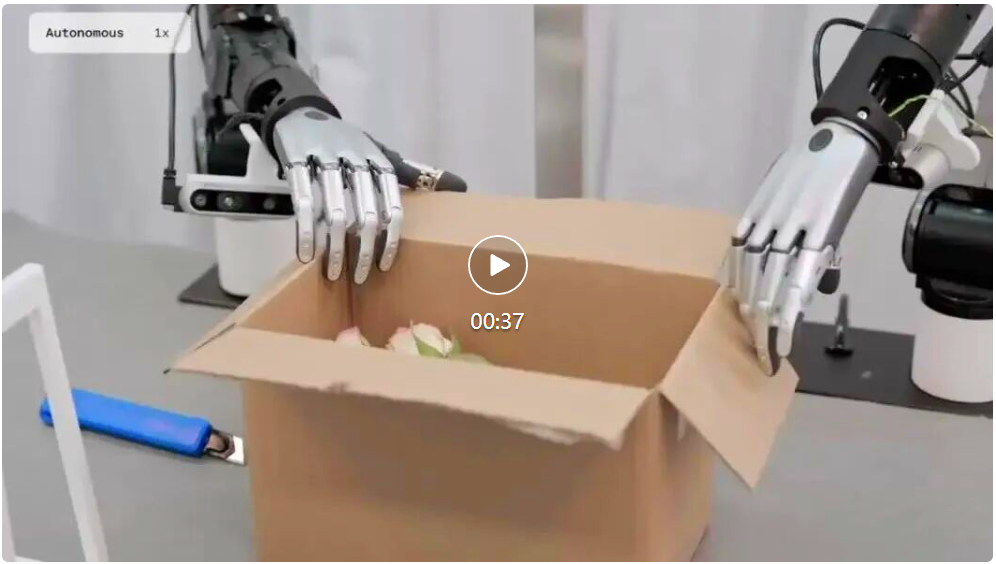
任务执行受到扰动后(手指卡住、人类把花重新放回去),机器人能够根据当前状态调整动作并继续完成后续操作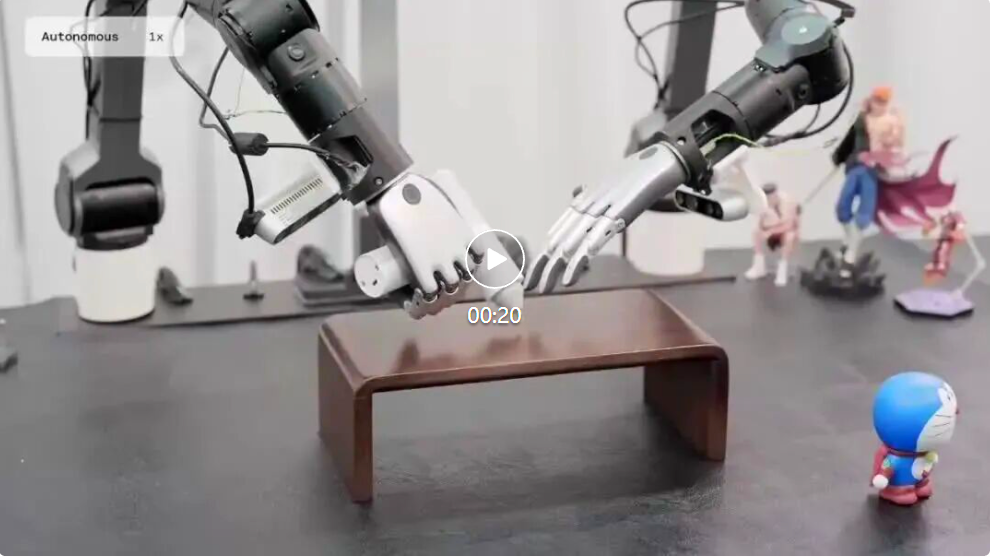
当抓住的摆件被拿走后,机器人能够重新调整手和手臂,并再次完成抓取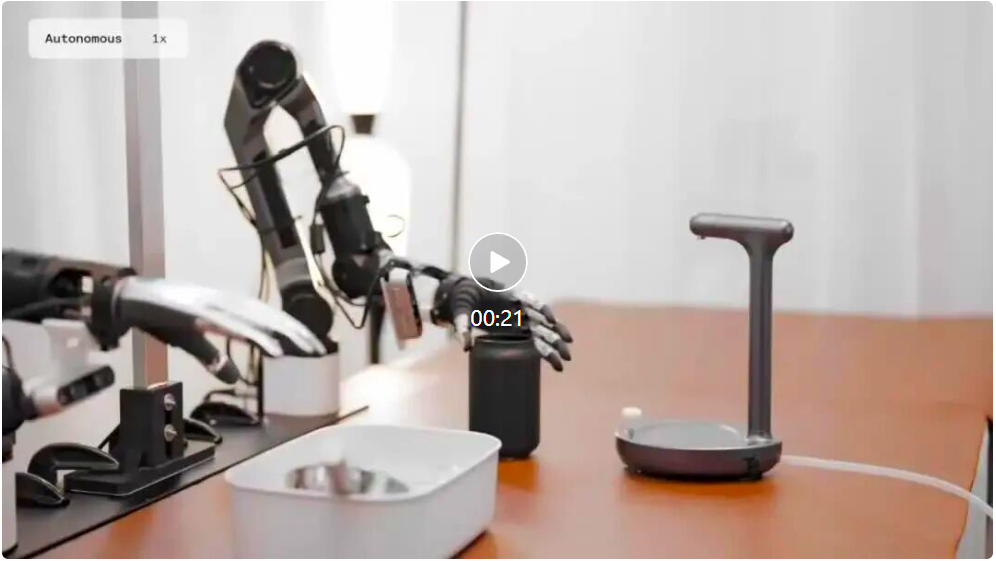
面对杯子被人为拿走的干扰,机器人能够重新抓取杯子并继续完成任务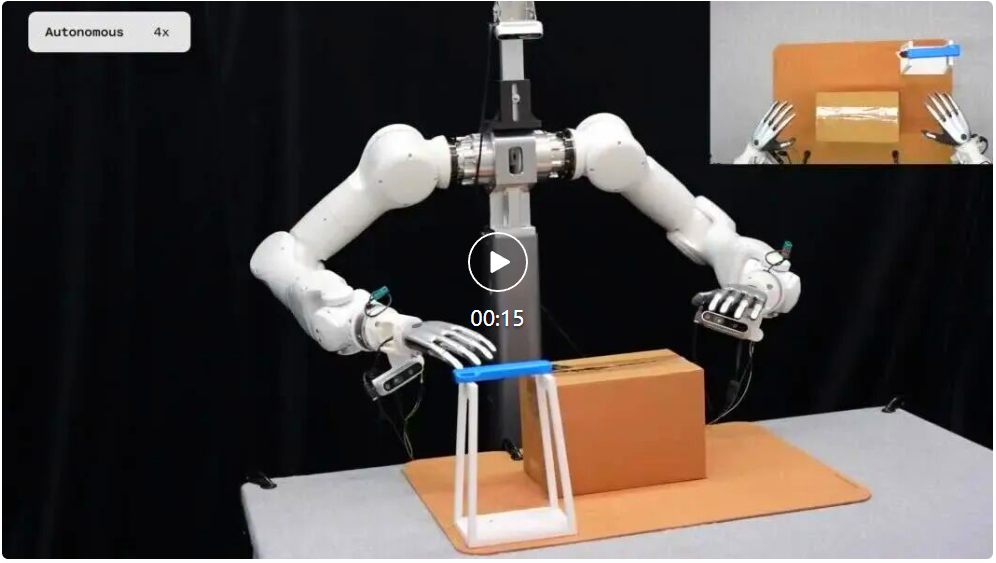
EgoWild2Dex 进一步从 Piper 机械臂迁移到 Tianji Marvin Pro
总结与展望
EgoWild2Dex 最值得关注的地方,或许不是某一个具体任务的成功率,而是它对机器人数据来源的拓展:除了昂贵的真机演示,未经刻意编排的人类日常操作,也可以成为机器人训练的数据来源。
当然,从第一视角人类视频到可稳定执行的机器人策略,中间仍然涉及视角、本体、动力学等多重差异。但如果这类数据能够被更有效地利用,机器人可利用的数据规模有望大幅扩展。
EgoWild2Dex 只是这一方向的初步探索。我们期待未来的机器人能够真正从人类日常经验中学习,在复杂多变的真实世界中不断适应、积累与进化。