
用 Claude 设计更高效的量子线路
用 Claude 设计更高效的量子线路
2026年10月16日
量子计算机若要在有限的硬件上运行实用的算法,离不开精心设计的线路。我们向 Claude 提供了八个此类线路的纯文字描述,涵盖化学、优化、物理模拟和数论领域,并配备一个自动评估器来检查和打分每个设计。在基本独立工作的条件下,Claude 找到了超越已发表最优线路的设计,某些情况下提升达一个数量级甚至更多。这类改进能大幅降低实用应用所需的量子资源,因此实用的量子计算机可能比之前预期的更早到来。
这项工作由 Andi Gu 主导,是 Anthropic STEM Fellows 项目的一部分,由 Anthropic 量子物理学家 Alek Kemeny 担任导师,并与 Susanne Yelin(哈佛大学)和 Mikhail Lukin(哈佛大学及 QuEra Computing)合作完成。在 arXiv 上阅读完整论文。
经典计算机用取值为 0 或 1 的比特存储信息,量子计算机则不同,它用量子比特(qubit)存储信息。量子比特可以由单个原子、超导电路或光粒子构成,利用叠加等量子现象——即量子系统可以同时处于多个状态的组合——以独特的方式处理信息,有望让化学、材料科学和数论等领域的某些难题变得可解,即使这些问题对传统计算机来说过于困难。
目前学界造出的量子计算机只有几百到几千个量子比特,远不足以运行许多有望超越经典计算机的实用算法。而且这些量子比特对环境噪声极为敏感,热量、振动甚至宇宙射线都可能造成干扰。微小的扰动就能改变量子比特的状态,这些小误差不断累积,最终导致计算机给出错误答案。
鉴于量子比特和计算时间都是稀缺资源,研究人员一直在努力重新设计量子算法,以使用更少的量子比特并在更短的时间内完成计算。一个典型的例子是模拟 FeMoco(铁钼辅因子),它位于固氮酶的核心,是细菌将空气中的氮气转化为氨气的酶。理解 FeMoco 的运作机制有助于科学家设计更好的工业催化剂——即制造商用于加速化学反应的物质。
2017 年,研究人员估算,一台量子计算机需要大约 50 万亿个 Toffoli 门来计算 FeMoco 的基态能量。基态能量对应于分子最稳定的构型,化学家需要这一数值来预测 FeMoco 的反应特性。(与普通计算机类似,量子计算机通过对量子比特施加一系列简单操作——即量子门——来工作。其中,Toffoli 门是运行成本最高的门之一,因此统计 Toffoli 门数量是估算计算耗时的标准方法。)
通过一系列算法改进,所需的门数量已降至约 3.4 亿,减少了大约 150,000 倍。这意味着,在一台拥有约 300 万个物理量子比特的未来机器上,仅需数小时即可完成计算。1
这些性能提升主要源于对执行计算的电路进行重新设计,而非硬件本身的改进。由于 Claude 在优化经典算法方面表现尤为出色,我们很想看看,如果仅提供电路计算目标的自然语言描述,它是否也能对量子算法进行类似的优化。
Claude 非常适合这项任务,原因主要有三。首先,量子算法以量子电路形式实现。电路由一系列门(如上文提到的 Toffoli 门)序列构成。关键在于,这些电路可以用代码描述,因此我们能利用 Claude 的编程能力,将电路设计视为普通程序进行编写、运行和迭代优化。其次,我们重点优化的这类(相对常见的)量子算法易于验证正确性:每个输入对应一个确定的输出,传统计算机即可校验。这意味着我们可以用外部评估程序来验证 Claude 提出的方案。最后,我们能为 Claude 设定一个明确且客观的优化指标:所用量子比特数乘以门数量,该指标可作为电路运行耗时的代理指标。
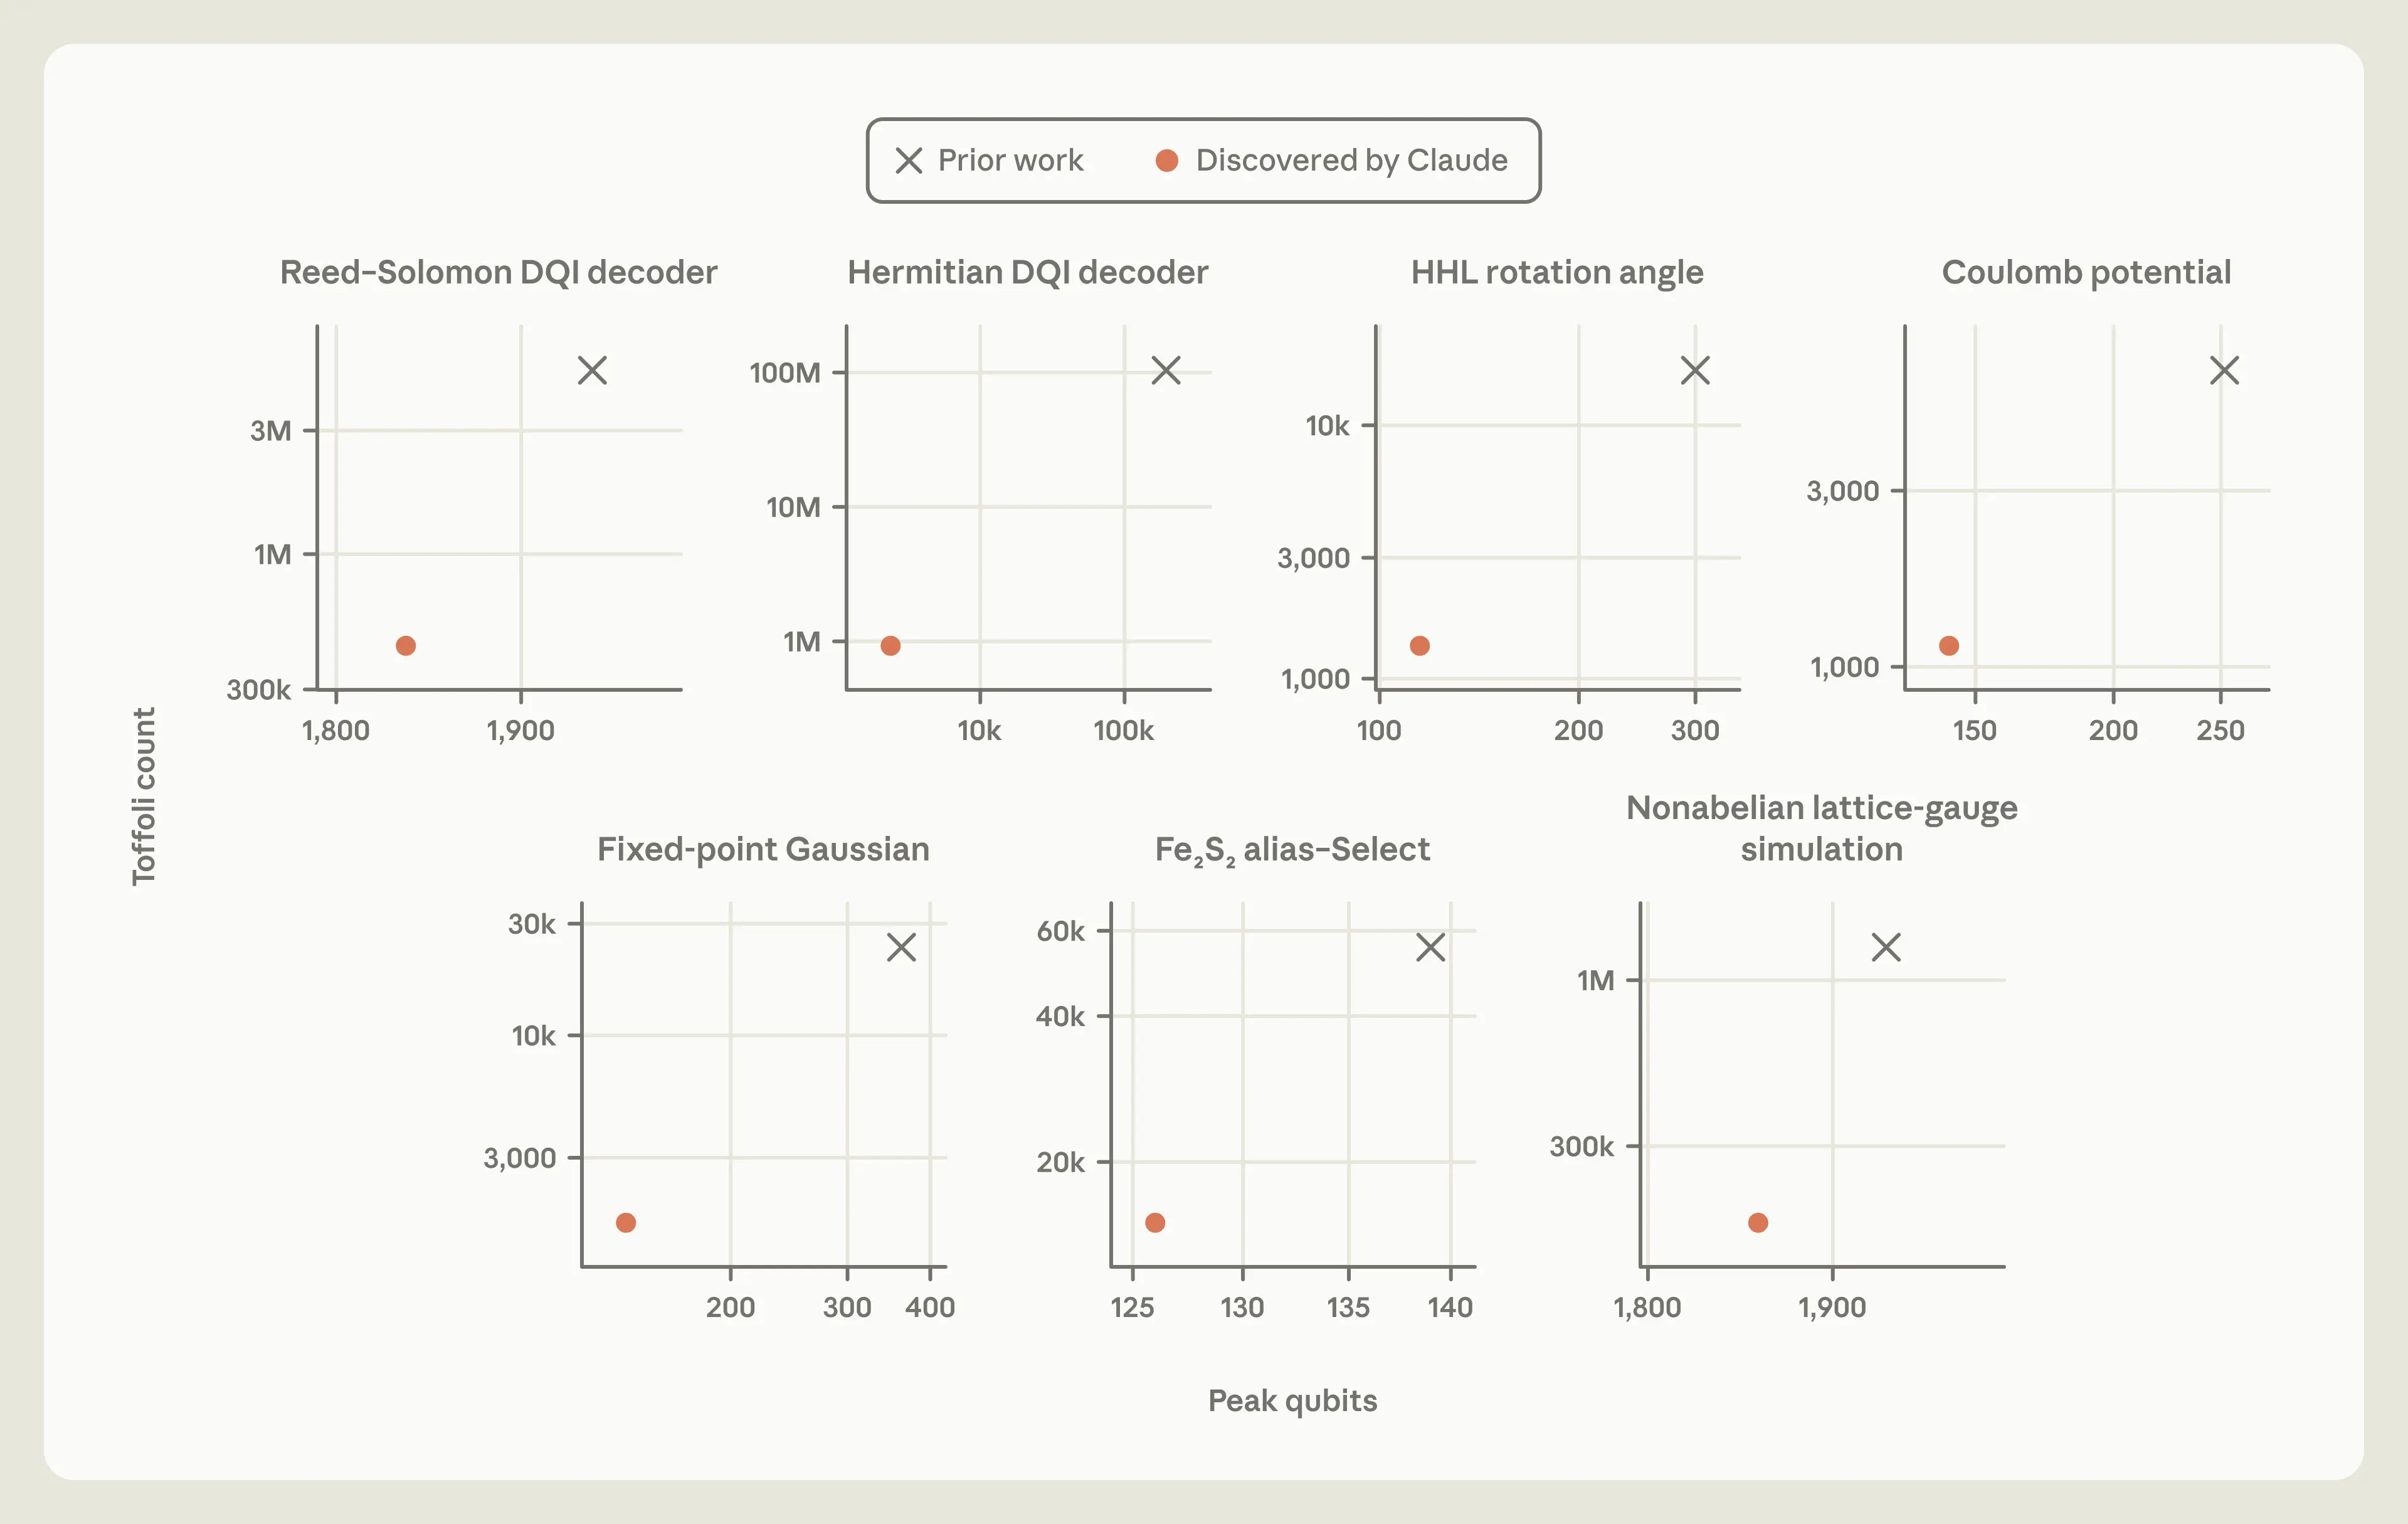
我们发现,Claude Mythos 5 能够成功在闭环中工作:提出电路设计,接收评估程序的反馈与评分,并据此优化下一轮方案,全程无需人工干预(见图 1)。在化学、优化、量子模拟、数论及数值计算领域的八种计算原语(即大型量子算法的基础例程)上,Claude 发现了新颖的设计,其量子比特数和门数量均少于此前已发表的最优算法(见图 2)。
在每种情况下,改进都源于对问题本身结构和数学特性的新见解,而非对现有设计的微调。例如,在为硫化铁分子模拟编译电路时,Claude 发现该分子的对称性和重复结构意味着部分结果只需计算一次即可复用,无需对系统每个部分重复计算。在另一些案例中,它发现现有电路包含昂贵组件,这些组件仅用于处理极罕见的输入,于是 Claude 重新设计了电路,移除了这些冗余部分。
下文将介绍 Claude 的两项发现。第一,一种执行模数倒数的新方法。模数倒数是椭圆曲线计算中代价最高的算术步骤。第二,将一种主流量子优化算法中成本最高的步骤降低了约 12 倍。
这些结果表明,AI 如今已经能够帮助重新设计量子电路,而这正是让量子算法运行得更快、更容易的关键一步。更快的电路设计,意味着量子计算机有望解决的那类问题——从设计新药、更好的电池,到寻找更清洁的化肥生产方式——能更早变为现实。
一种新的可逆算法
设计量子电路需要面对两个普通编程中没有的约束。第一个是量子电路无法像普通程序那样进行“如果……那么”的判断。普通程序可以检查一个值,然后只执行两段代码中的一段;但量子计算机同时运行在多个输入的叠加态上,其中一部分会走第一段代码,另一部分会走第二段,因此电路每次运行都必须同时包含两者的操作。
第二个约束是量子电路不能丢弃信息。普通程序用完临时数据后可以覆盖或删除;而在量子计算机中,这类中间信息无法直接抹去,因为量子电路的每一步都必须是可逆的。把信息留在原地也不行——残留的临时数据会污染最终结果。唯一的丢弃方式是通过反向执行生成它的计算来“退计算”(uncompute),代价是额外的 gate。这两个约束使得量子电路在运行时间和 qubit 数量上都远比经典电路昂贵。
这段约束迫使我们必须在空间(即量子比特数量)和效率(即运行时间)之间做出艰难的权衡。在一种极端情况下,量子电路一旦用完中间结果就立即将其清除。这释放了量子比特资源,但如果后续还需要这些结果,电路就必须重新计算,从而增加门操作数量并延长运行时间。在另一种极端情况下,电路会保留中间结果直到不再需要。这避免了重复劳动,但可能需要占用更多的量子比特。 正是这种复杂性,使得量子电路设计成为检验 Claude 能力的绝佳场景。电路可以用常规代码编写,但要优化它们,模型需要在与普通编程截然不同的多重约束条件下进行推理。 第一道难关:模逆元 我们交给 Claude 的第一个任务是点加法,这是通过数学曲线(椭圆曲线)上两个点的运算得出第三个点的规则。点加法是椭圆曲线离散对数问题量子算法的核心步骤:给定一个起点及其自身累加 $n$ 次后的结果,反推 $n$ 的值。对于大规模椭圆曲线,普通计算机无法在可接受的时间内解决此问题,但足够强大的量子计算机可以做到。 这类算法会反复执行点加法(包括反向操作),且加法操作占据了量子比特和运行成本的大头。这类“易正向计算、极难逆向推导”的问题,正是早期展示量子计算机相对于经典计算机具有指数级加速优势的经典领域。因此,点加法已成为该领域的标准基准测试之一。这对 Claude 来说是一项严苛的挑战,因此我们要求它探索点加法究竟需要最少多少量子比特,以及最少多少门操作。 我们给 Claude 提供了一段简短的说明。其中阐明了点加法的数学规则,并解释了评估器如何检查每个提议电路的正确性,以及如何根据其使用的量子比特数和门数进行评分。我们还指示 Claude 并行探索多种方法。在极少人工干预的情况下(仅限于初始说明和偶尔提示其拓展思路),Claude 工作了 53 个小时,最终找到了一个全新的解决方案。 Divsteps 的内存需求点加法的大部分开销来自一个称为模逆元的步骤。椭圆曲线运算使用达到固定上限后循环回绕的数字。模逆元就是循环版本下的除法:给定整数 a,求解满足 ax ≡ 1 (mod p) 的 x。普通计算机可以使用一种名为 divsteps 的方法高效执行该操作。Divsteps 从一对数字开始,通过多轮迭代反复简化它们。在每一轮中,divsteps 检查当前数字对,并根据条件交换、相加、相减或减半。在此过程中,它仅保留足以在最终生成模逆元的必要信息。
尽管 divsteps 在传统计算机上表现出色,但由于上述可逆性约束,它尚未转化为实用的量子电路。各迭代步骤中具体选择了哪种操作的记录——称为分支信息——属于传统程序可以随时丢弃的临时工作数据。相比之下,量子电路必须保留该记录,以便计算能够反向执行。因此,直接量化的 divsteps 版本被迫累积长长的分支信息历史,这需要额外的巨大数量 qubit 进行存储。
Claude 如何绕过内存瓶颈
Claude 认识到这种 divsteps 方法在量子电路领域前景广阔,前提是如何规避存储完整历史的需求。它提出了一个想法:也许根本不需要存储记录。Claude 推理,通过仔细检查每次迭代后的数字对,可能直接推断(或“解码”)出分支信息。本质上,数字本身就在保存记录。这样一来,电路反向运行时无需额外的 qubit。
为了验证这一想法,Claude 探索了若干用于执行解码的简单候选规则。这些早期规则在小规模测试案例中有效,但当 Claude 在 256 位数字的全尺寸问题上测试时,它们失败了。
随后 Claude 尝试了一条更理论化的路线。它不再靠猜规则再逐一测试,而是从数学上探究 divsteps 为何如此运行。它证明了关于该迭代过程的一系列结论,其中包括几条新的代数恒等式,并由此推导出一个精确的解码公式,能从数值对中正确还原分支信息。为了验证这个公式,Claude 先做了大规模数值模拟,又用 Lean 对结论进行了形式化证明。验证全部通过后,Claude 得出了首个无需存储分支历史的 divsteps 可逆实现。一族设计方案
解码虽然节省 qubit,却要付出时间代价。于是 Claude 进一步寻找哪些情况下存储分支信息反而比解码更划算。通过调整“存储还是解码分支信息”的阈值,Claude 得出了介于两个极端之间的一族新设计。与之前最小的设计相比,其中一种电路 qubit 数量多 12%,但门数量减少了 17 倍。更广泛地说,这批新设计拓展了 Pareto 前沿,提供了以往不具备的 qubit 数量与运行时间组合(见表 1)。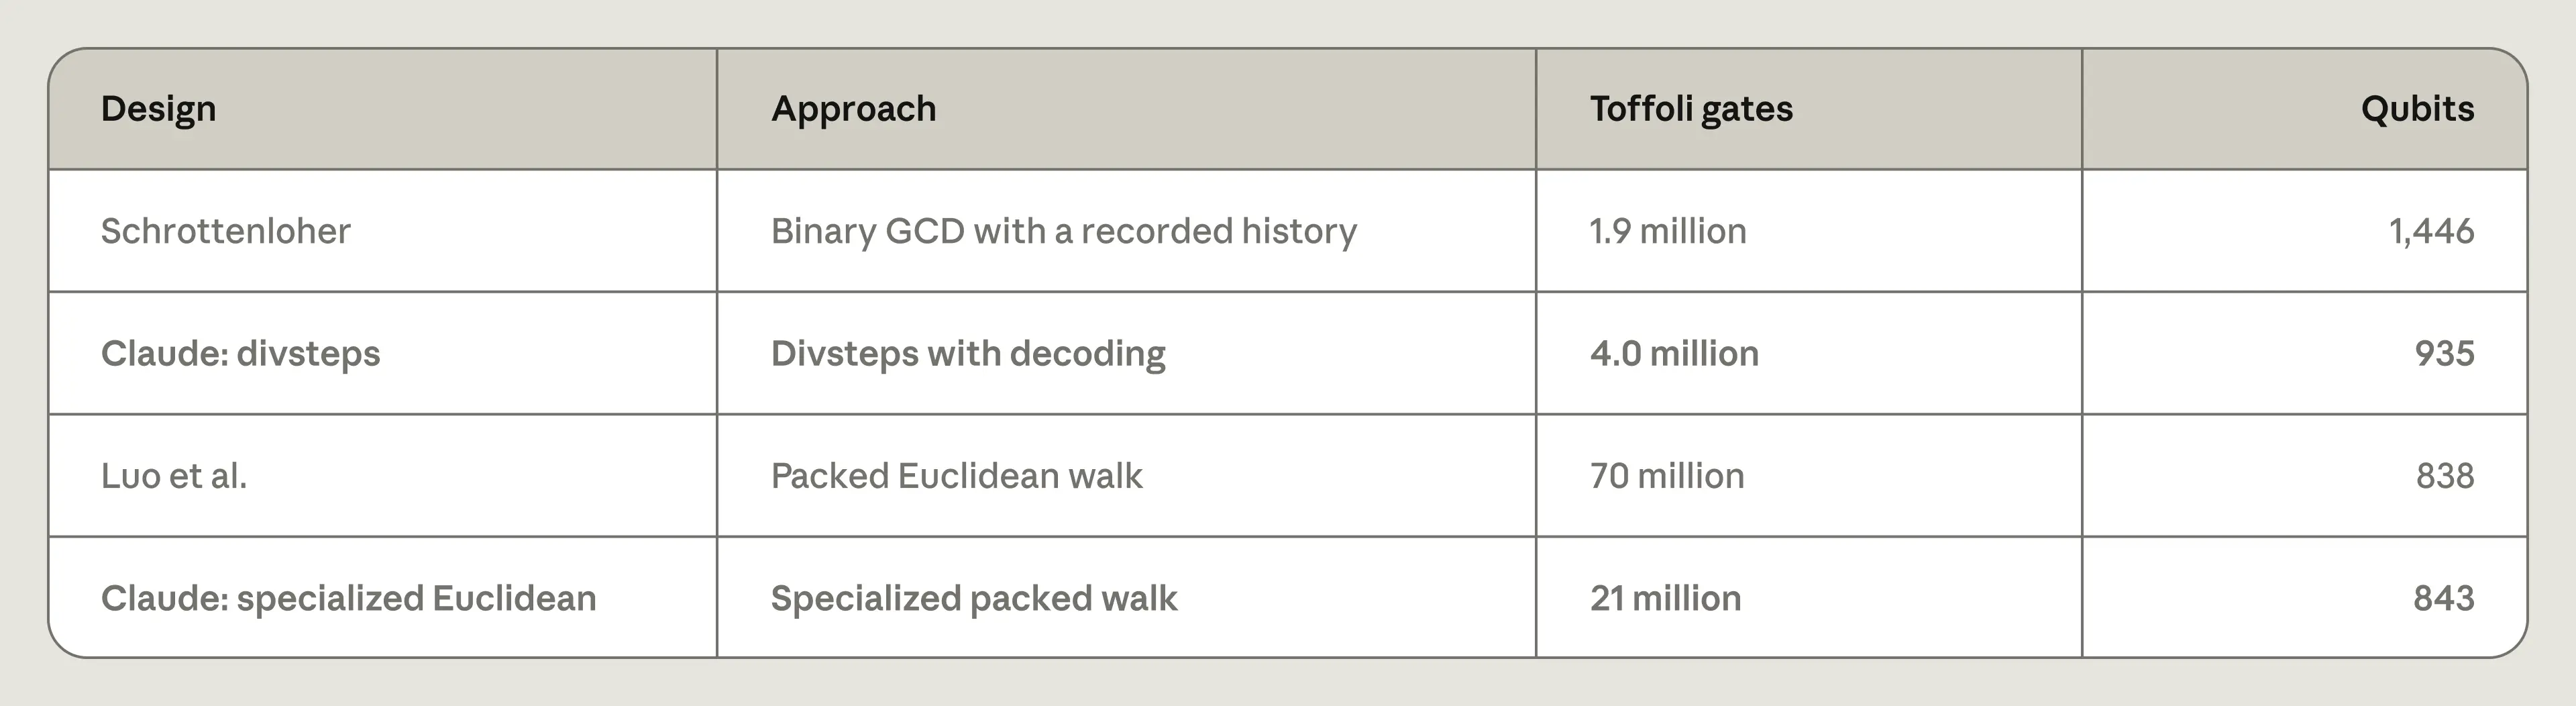
优化一个量子优化器
优化问题广泛存在于调度、物流、材料设计等各类任务中,其核心是在一组相互冲突的约束条件下,找出尽可能满足多数约束的解。针对这类问题已提出许多量子算法,但多数相比传统计算机只有有限或不确定的优势。解码量子干涉(Decoded Quantum Interferometry,DQI)是最有希望实现超多项式量子加速的候选之一——这种优势会随问题规模扩大而迅速拉开。量子计算机完成计算后,测量其量子比特只会得到一个结果——这是从叠加态所含的多种可能性中随机选出的一个。DQI 的工作原理是制备一种量子态,使好的解比差的解更有可能被读取出来。实现这一点需要使用纠错解码器,从一份紧凑的摘要中恢复出一份简短的“错误”列表。这是算法中最耗时的步骤。因此,如果我们能开发出更快的解码器,就能让 DQI 跑得更快。
更高效的量子解码器
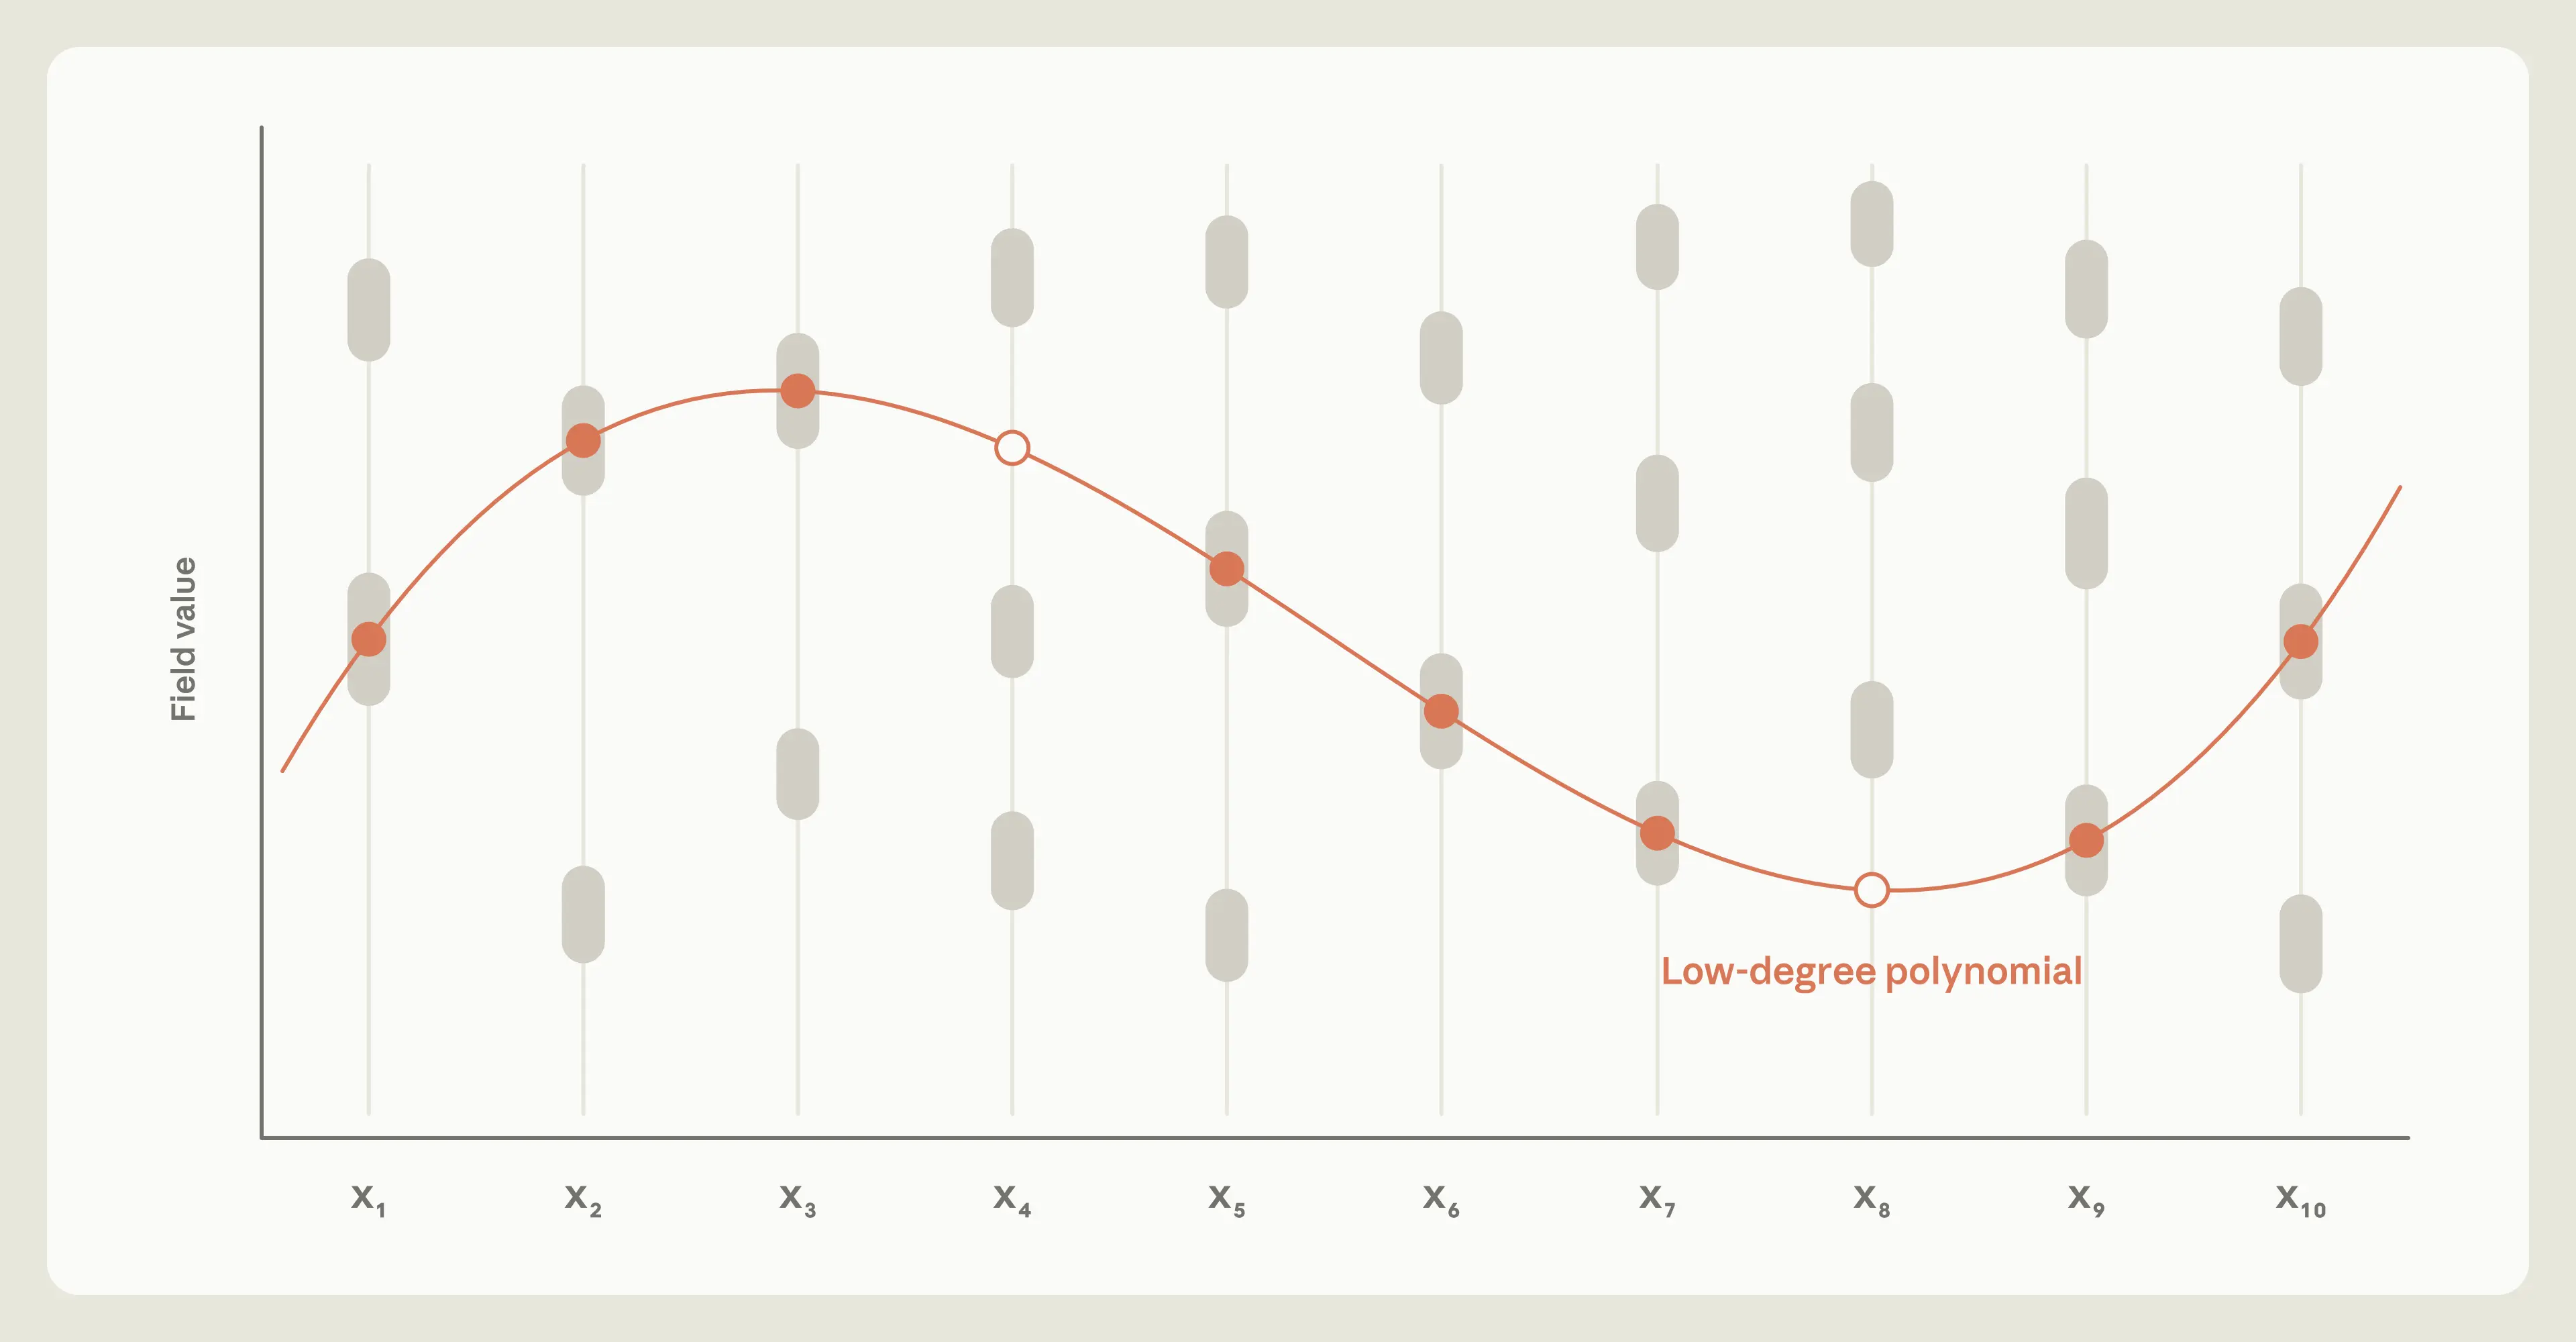
提出 DQI 的研究人员在一个名为“最优多项式交点”(Optimal Polynomial Intersection, OPI)的问题上验证了该方法。OPI 是曲线拟合问题的一种网格版本(见图 3)。想象一个网格,每个位置 x 下都有若干可接受的 y 值。目标是找出一条简单曲线(即低次多项式),使其尽可能多地穿过这些可接受区域。DQI 使用一种特定的解码器——Reed–Solomon 解码器——来求解这个优化问题。
Reed–Solomon 解码从上述提到的错误紧凑摘要(即“综合征”/syndrome)开始。解码器的任务是据此推断数据中哪些位置发生了错误,以及具体的错误内容。此前最先进的量子电路使用扩展欧几里得算法来处理这些综合征,该算法由一系列除法和交换操作组成,其步骤数量和顺序取决于具体的输入。在这里,量子电路的约束再次显现:普通程序可以为不同输入走不同的执行路径,但量子电路需要同时处理多个输入,必须用一套固定的门序列来应对所有情况。为此,先前的设计不得不将计算拉伸到远超单个输入所需轮数的迭代轮次,并且每一轮都要执行所有操作,即使其中许多操作并不必要。
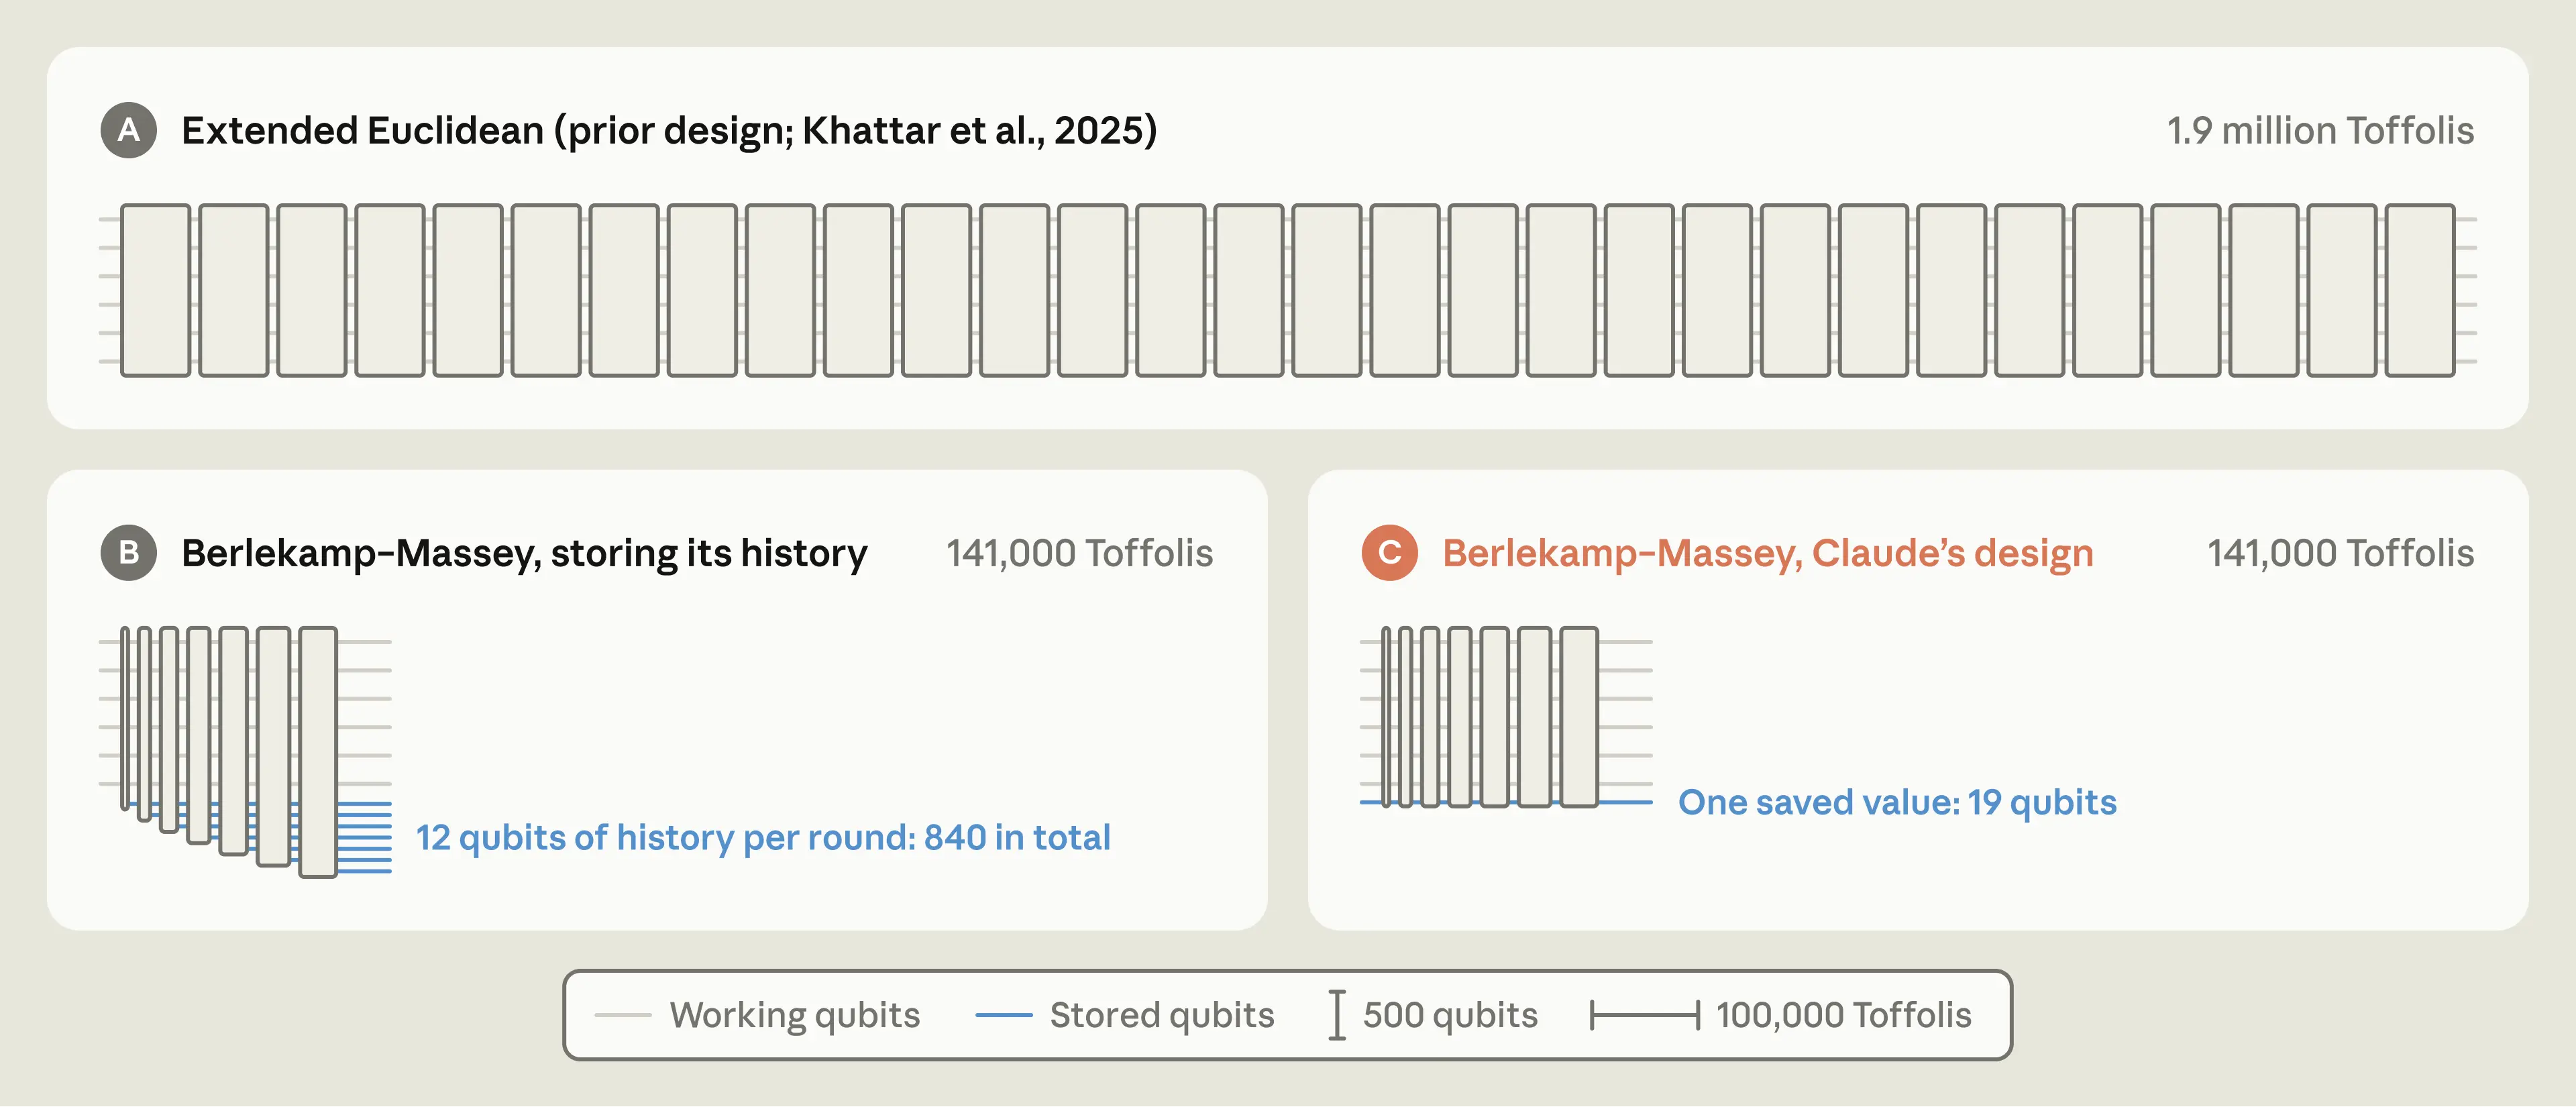
在 Frontier等超级计算机上运行DQI算法解一道OPI问题需要三个月,而在未来量子计算机上只需约一小时,大部分时间都耗在里德-所罗门解码上。因此,我们请Claude设计一个更高效的量子解码电路。Claude很快发现扩展欧几里得算法不适合量子电路,于是改用贝莱坎普-梅西算法——该算法逐一读取伴随(误差摘要),逐步推导最简单规则来预测列表中每个数值。规则一旦确定,即可揭示误差。与扩展欧几里得算法不同,贝莱坎普-梅西法每轮执行相同类型的操作且轮数固定,更契合量子电路的单一固定门序列,为Claude提供了高效基础。 切换至贝莱坎普-梅西法后,电路不再需针对不同输入走不同路径,但可逆性带来新挑战:每轮计算出的临时值只能短暂存在,且不能直接删除——后续需能恢复这些信息。若完整存储将成本过高,于是Claude沿用divsteps的思路:从电路当前状态重建大部分信息,避免存储,仅少数例外值需额外保存。如果按最坏情况预留足够内存——即 35 轮中都出现异常值——需要 665 个 qubit。Claude 没有这么做,而是写了一个高速模拟器,运行 4.03 亿次采样解码来统计这些异常实际出现的频率。结果几乎所有运行最多只需要保存一个值。于是 Claude 的电路只预留了一个保存值的空间,即 19 个 qubit。大约万分之一的运行会超出这个限制而失败,但这远低于任务允许的错误率。这些改进用少量固定的 qubit 和门取代了大块的最坏情况预留(图 4)。
综合这些优化,decoder 的门数量相比 Google 之前的方案减少了 12 倍。提升来自三个层面的重新设计:换一种方法(用 Berlekamp–Massey 解码替代扩展欧几里得算法)、换一种电路架构(重建临时值而不是存储它们)、换一种资源预算(精确测量电路实际需要多少内存和计算)。任何单项改动都不足以奏效,但组合起来,它们让 DQI 最昂贵的步骤便宜了一个多数量级。
我们的收获
科学上的进步,往往源于让理论构想落地为实际可用。其中一个关键途径,就是把原本被认为不切实际的过程变得足够快、足够便宜,从而具备执行条件。量子电路设计就是一个典型例子:上文提到的将 FeMoco 估算值降低 15 万倍的工作,多个研究团队花了八年才完成,而每一个步骤通常都意味着数月的工作量。相比之下,Claude 的椭圆曲线设计成果,则源于一次长达 53 小时的单次运行。
我们的结果表明,AI 能够辅助电路设计工作,生成使实用量子计算更接近真实硬件能力的实现方案。若 AI 能够加速这一过程,实用的量子计算或可更早到来。
尽管 Claude 在这些任务上表现亮眼,我们也观察到一些局限。在早期实验中,Claude 天生偏于保守。它反复质疑看似可行的改进方案,有时还会对已获充分验证的结果进行双重乃至三重复核。这种谨慎在某些时刻确有价值:例如,它促使 Claude 编写 Lean 证明来验证其 divsteps 设计。但这也体现为一种倾向,即更偏爱既有且广为人知的方案,而非更新的思路。
我们采取了两个措施来缓解这一问题。其一,我们的设置要求 Claude 提出若干种本质不同的方案,并并行推进。其二,我们偶尔也会提示 Claude 拓宽搜索范围。这些干预成功引导 Claude 去追求更富雄心的想法。例如,椭圆曲线的成果并非来自对既有设计削减门数,而是源于探索一种此前无法实现的可逆模数逆运算方法,进而推导出使其落地的所需数学结果。一旦想出这一想法,Claude 便自主完成了方案的开发、实现与正确性验证。
电路设计只是构建实用量子计算机的一个环节。由于量子比特极其脆弱,机器在运行过程中还必须能够自我检测并修正错误,而这又依赖于众多其他组件,从纠错码、快速解码器到硬件控制,无一不相关。这些组件彼此影响,但为了管理复杂度,通常还是各自独立设计。其中许多组件具备与电路设计类似的特性,而这类特性恰恰是 Claude 擅长的领域:设计可以代码化,可验证正确性,还能通过成本指标量化评估。