
Reflection 开源 501B 参数 MoE 模型 Beam:可自主部署、定制与扩展
Reflection 开发的 Beam 模型现已上线 Hugging Face!这是美国新实验室 Reflection 发布的首个模型,且为开源。它是一款混合专家(MoE)模型,拥有 501B 参数(每 token 激活 23B 参数),支持文本输入,上下文窗口达 100 万 token,并以 Apache 2.0 协议发布。
Beam 专注于编程和代理(agentic)应用场景。它面向希望在自有硬件、基础设施或云环境中部署前沿规模模型,并针对自身用例进行定制的团队。Beam 附带一个基于 Rust 的专用开源推理框架,可充分发挥模型性能。
Beam 提供原生 Transformers 实现,并支持 vLLM 和 SGLang 等下游库。我们与 Reflection 团队合作,为你提供推理、监督微调(SFT)和强化学习(RL)方案,助你基于该模型构建所需应用。除了对 Transformers、SGLang 和 vLLM 的首日支持外,本文还将展示如何运行 Beam、如何进行后训练,以及我们基于它构建的成果。
核心要点
- 501B 参数 MoE 大语言模型,每 token 激活 23B 参数。共 52 层,每个 MoE 层含 256 个专家,每 token 路由 8 个。
- 文本输入输出,上下文窗口达 100 万 token。
- 检查点格式:BF16、FP8 以及 NVFP4
- 支持跨轮次保留上下文的推理能力(
preserve_thinking),以及使用专用语法的工具调用。模型支持五种推理强度:“low”、“medium”(默认)、“high”、“xhigh” 和 “max”。- Tokenizer 中包含响应模板。
- 支持 DFlash2 推测解码草稿模型。
- 首日支持库:Transformers、SGLang、vLLM。支持使用 Miles 进行全参数强化学习。
- 附带 基于 Rust 的自定义框架。
- Apache 2.0 协议。
基于 Beam 构建
Reflection 将为使用 Beam 的最佳项目颁发 10,000 美元 Hub 积分奖励。你只需创建项目并在 Hub 上分享即可:
- 你可以使用 Spaces 构建一个基于 Beam 模型的演示
- 可以针对你喜欢的硬件做量化
- 可以为你感兴趣的问题生成合成数据集
- 可以为 Beam 构建(或与 Beam 协作)一个 RL 环境
- 可以对 Beam 做基准测试并分享结果
- 也可以给我们带来惊喜!
如果你用 Beam 做出了什么作品,把它分享到 Hub 上就有机会赢取 $10,000。你只需构建一个 Space、模型或数据集仓库,并分享到 模型仓库页面。我们会收集所有链接,评选出最佳作品,并将积分发放到你的 Hub 账户。
Beam 是什么?
Beam 是一个纯文本模型,专为长上下文(100 万上下文长度)推理和 agentic 任务打造。它是一个稀疏 MoE 模型,每个 token 只由网络中的一小部分参数计算,因此能以小模型的速度运行,同时保留大模型的容量。
注意力机制
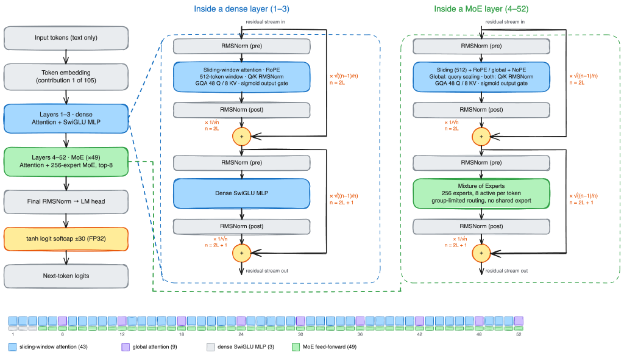
解码器共有 52 层,隐藏层大小为 5,120。大多数层采用对前 512 个 token 的滑动窗口注意力;每六层有一层全局注意力,最后一层也 attend 全部上下文,因此共有 43 层滑动窗口层和 9 层全局层。
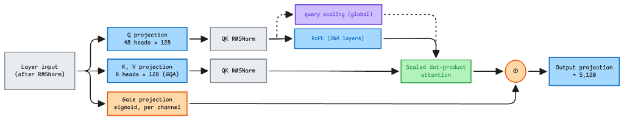
注意力模块内部(两类层均如此)
两类层对位置信息的处理方式不同。滑动窗口层使用 RoPE,因为在短窗口内相对位置最为重要。全局层不使用任何位置编码,而是将每个 query 乘以一个随可见 token 数量缓慢增长的缩放因子 (1 + (pos + 1) / 2048) ** 0.1。它的作用类似温度参数:随着上下文变长,softmax 能保持精度而不会趋于平坦。实现中称之为 scalable-softmax query scaling。
注意力机制采用分组查询注意力(Grouped-Query Attention),配置为 48 个查询头和 8 个键值头,并对查询和键应用 RMSNorm。通过从层输入计算出的学习型 sigmoid 门控,在输出投影前对每个头的每个通道进行缩放。
混合专家(MoE)
前 3 层使用稠密的 SwiGLU MLP。其余 49 层则将其替换为包含 256 个专家的混合专家(Mixture-of-Experts, MoE)模块,每个专家均为中间层大小 2,560 的 SwiGLU MLP,参数量约为 39M。这些专家占据了模型总参数量的 98.4%。
路由器遵循 DeepSeek-V3 的组限制方案。它使用 sigmoid 对全部 256 个专家进行评分,将其分为 8 组(每组 32 个),保留评分最高的 4 组(依据每组前两名得分之和排名),然后在这些组中选取前 8 名专家。Beam 使用了与 DeepSeek-V3 相同的组大小,但没有共享专家。专家输出通过归一化的路由权重进行组合,并乘以 2.5 的缩放系数。
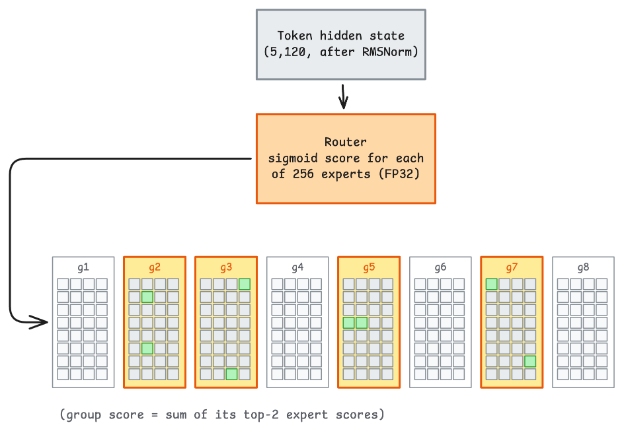
每个 token 仅激活 8 个专家,因此模型在处理每个 token 时计算量仅涉及约 23B 参数。所有 256 个专家都保留在内存中,因此部署时需要 501B 模型的内存空间,但运行速度却相当于 23B 模型。BF16 检查点在 safetensors 格式下约 1 TB。NVFP4 检查点将大部分参数以 4 位精度存储,专为 NVIDIA Blackwell GPU 设计,部分参数保留为 BF16 以保证精度。Hub 上还提供了 FP8 检查点,非常适合 Hopper 和 Ampere 系列芯片。
如果想自行部署 Beam,可以参考下方的 vLLM 或 SGLang 配置方案。
残差流
残差连接是该架构最显著的特征。标准 Transformer 以权重 1 将每个子层的输出添加到残差流中,导致残差流随深度增加而增长。
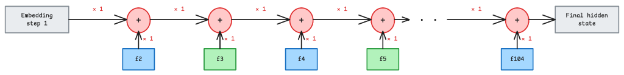
Beam 将输入嵌入视为第 1 步。在第 k 步,它以权重 1/sqrt(k) 累加子层输出,并以权重 sqrt((k-1)/k) 保留现有残差流。两个权重的平方和为 1,确保残差流从第一层到最后一层保持恒定尺度。经过全部 104 次累加后,每个子层输出和输入嵌入在最终隐藏状态中都具有相同的权重。
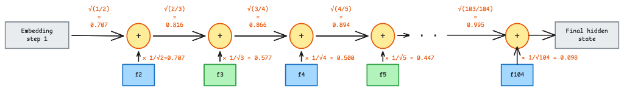
每个子层在前后均执行归一化,最终 logits 通过 ±30 的 tanh 软截断(softcap),并在 FP32 下计算。实现中明确规定了以下部分在 FP32 中计算:路由器、SwiGLU 乘积、归一化层、RoPE、query 缩放以及软截断。
长上下文(Long Context)
混合注意力机制在处理长上下文时表现优异。每层为每个 token 缓存 2 × 8 个 KV 头 × 128 维 = 2,048 个数值。若全部 52 层都保留每个 token,缓存将每 token 增长 208 KiB。实际上,仅 9 个全局层保留整个序列,而 43 个滑动窗口层各持有固定的 512-token 窗口且不再增长。因此,缓存每 token 仅增长 36 KiB,约为朴素策略的六分之一。
| 上下文长度 | 若 52 层均为全局 | Beam |
|---|---|---|
| 32K tokens | 6.5 GiB | 1.2 GiB |
| 128K tokens | 26 GiB | 4.6 GiB |
| 完整上下文 (1M) | 208 GiB | 36.08 GiB |
上述数值基于每序列、BF16 精度,并使用 transformers 动态缓存。
基准测试结果
以下是 Reflection 团队提供的不同精度级别下的基准测试结果。
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| 代理编程 / 终端(Agentic Coding / Terminal) | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| 推理 | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE(不用工具) | 36.0% | 36.0% | 34.8% |
| HLE(使用工具) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| 工具调用 / 搜索 | |||
| AutomationBench - 仅公开部分 | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| BrowseComp(带上下文管理) | 76.8% | 76.7% | 75.6% |
| DeepSearchQA(带上下文管理) | 80.5% | 79.6% | 81.1% |
| 通用能力 | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience(指数)- 仅公开部分 | 10.8 | 8.8 | 9.8 |
硬件要求
部署该模型最实用的方式是使用 NVFP4 检查点,它保留了 BF16 检查点的大部分质量。NVFP4 将部分权重存储为 4 位,从而将 501B 参数在 BF16 格式下占用的 1 TB 空间缩减至约 280 GB。Blackwell 架构的 GPU 原生支持 NVFP4,但 H200 等早于 Blackwell 的 GPU 则无法支持。对于非 Blackwell 架构的 GPU,建议选用 FP8 检查点。
单块 B200 拥有 180 GB 的 HBM3e 显存,两块 B200(360 GB)虽然能容纳 Beam 的权重,但留给激活值和 KV 缓存的空间非常有限。建议规划使用四块 B200(720 GB),这样可以留出充足空间以支持长上下文和并发请求。你也可以在完整的 8 卡 B200 节点上部署,或使用两块 288 GB 的 B300,甚至 8 卡 RTX Pro 6000。如果没有 Blackwell 硬件,可以使用 Inference Providers(无服务器架构)来测试 Reflection。
推理支持
Beam 在 transformers、SGLang 和 vLLM 中提供了首日支持。
Transformers
请安装最新版本的 transformers。
pip install -U "transformers>=5.20.1"
运行 Beam 最简单的方法是使用文本生成流水线(text-generation pipeline):
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflection/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
流水线会返回完整的对话历史。最后一条消息即 Beam 的回复,已经过响应模板解析。
若需更底层的控制,可使用 AutoModelForCausalLM 和 AutoTokenizer。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflection/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
对话(Chat)
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
Beam 的 tokenizer 内置了响应模板。parse_response 会读取该模板,将原始输出解析为消息字典,其中推理过程、最终答案及任何工具调用分别存储在独立的字段中。这种方式避免了通常用于分割推理、答案和工具调用的正则表达式。由于解析规则随 tokenizer 一同提供,解析出的结构与 Beam 训练时生成的格式保持一致。聊天模板可以预写助手回复的一部分,解析器需要看到这些内容。
工具调用
完整的工具调用示例def get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
调用 parse_response 时也需传入 tools。Beam 以自定义的 XML 风格语法内联写入工具调用参数,因此单纯的 7
多 GPU 与多节点
Beam 的配置中定义了专家并行方案。专家并行会把每个 expert 放到一个设备上,而 Attention、稠密层、embedding 和 LM head 则在每个设备上都保留一份副本,共 8B 参数,BF16 下约 16 GB。通过 DistributedConfig 加载模型:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), ep_size=int(os.environ["WORLD_SIZE"]), tp_plan={}
    ),
)
用 torchrun 在 16 块 H200 上启动脚本,每块 GPU 承载 78 GB 权重。如果只用 8 块,每块要装 139 GB,在 141 GB 的 H200 上就装不下了。注意设备数必须能整除专家数(256)。
vLLM
Beam 在 vLLM 中实现了首日支持。下面的命令以 16 路张量并行(两台 8x H200 节点)部署 BF16 checkpoint,并暴露 OpenAI 兼容 API:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
想要更快的生成速度,可以加上 DFlash2 投机解码。小型 drafter 模型一次最多前瞻提议 15 个 token,Beam 在一次前向传播中同时验证这些 token,因此每步可以接受多个 token。代价是为 drafter 多付出一点显存:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
上面两条命令都会启动 OpenAI 兼容服务器,任何 OpenAI 客户端只需指向 http://localhost:8000/v1 即可。更多部署配置请参考 vLLM 的 Beam 部署方案。
SGLang
Beam 同样在 SGLang 中实现了首日支持。我们推荐配合 DFlash2 投机解码部署,下面两条命令均已开启。在 Blackwell 上,NVFP4 checkpoint 只需 4 块 B300 即可装下:
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
在 Hopper GPU 上,请改用 8 张 H200 运行 FP8 检查点。只需修改三个参数:检查点路径、张量并行大小(由 4 改为 8),以及注意力后端(由 trtllm_mha 改为 fa3,因为 trtllm_mha 需要 Blackwell 架构):
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
推理服务提供商
Beam 已上线 Hugging Face 推理服务提供商,目前由 Baseten、Fireworks 和 Together 提供支持,更多服务商即将加入。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
推理端点
我们已为您配置好 Beam 的一键部署方案,可从推理端点目录中选择 FP8 或 NVFP4 版本进行部署,也可以使用 hf 命令行工具安装:
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
测试详情
我们分享了 Reflection 在五个任务上对 Beam-501B-A23B 的实测结果,每个任务分别在低、高推理强度下各运行一次。这些属于直观体验评估,而非标准化基准测试。如果你计划使用 Beam,这是初步测试其性能的好方法,可以让你了解它在具体用例中的表现,并清晰看到它的优势与短板。
下方是所用提示词及 Hub 输出记录的概览。完整的输入、输出、API 调用、任务数据、评分标准和对话记录均在这个公开的 Hugging Face 存储桶中。
| 类别 | 提示词说明 | 低推理(token 数) | 高推理(token 数) |
|---|---|---|---|
| 多步工具调用 | 处理订单 ORD-742:比较库存、预订情况、附加费及到达日期;预订价格最低的合格仓库。 | ✅ 544 | ✅ 811 |
| 长上下文代码检索 | 根据三个完整的源文件,推导 Click 命令配置及两次调用结果;引用六个实现符号。 | 🔴 1,613 * | ✅ 5,007 |
| 沙箱终端任务 | 检查并修复 CSV 账本 CLI;修复所有 bug,保留测试,运行测试及 CLI 检查。 | ✅ 582 | ✅ 1,548 |
| 数学推理(AIME 风格) | {1, …, 16} 中有多少个 8 元素子集的总和能被 17 整除?请给出证明。 | 🟠 829 † | ✅ 2,809 |
| 结构化输出 | 把一份乱序的修订日志转换成严格的 JSON 格式:合并补丁、处理取消操作、null 值、日期、货币和总额。 | ✅ 1,040 | ✅ 2,088 |
* Low 的长上下文回答中,所有代码行为和全部六个来源引用都正确。但回复格式不符合解析器要求,这部分属于提示词不够明确。
† Low 给出了正确答案,但漏掉了要求提供的论证过程。High 则给出了正确的单位根证明,并经过独立审阅。
别只听我们说,亲自翻翻这个 bucket,改成你自己的用例,把 Beam 推到极限吧。
对 Beam 做后训练
你可以针对自己的用例对 Beam 进行微调。下面分享几个 TRL 和 Miles 的示例,帮你上手监督微调和强化学习。
用 TRL 做 SFT
让 Beam 适配自己的数据,最快的路径就是用 TRL 的 SFTTrainer 做监督微调。为了控制显存占用,我们用 PEFT 训练 LoRA adapter,而不是更新全部 501B 参数:
我们用 TRL 的 SFTTrainer 给 Beam 设定了一个简单目标:让它用用户指定的语言进行推理。我们在 Multilingual-Thinking 数据集上用 LoRA 微调,只训练一小部分 adapter 权重,基础模型保持冻结。
整套配置结合了加载时的模型分片、专家并行、FlashAttention 4 和序列打包。LoRA SFT 可以在单节点 8 张 B300 GPU 上运行,吞吐约 19,000 tokens/秒;对应的 H100 配置则需要四个节点。
在 Multilingual-Thinking 上训练一个 epoch 后,Beam 在 16 个保留测试提示中全部 16 个都能用指定语言推理,而基础模型只有 3 个。这个小型评测衡量的是语言遵从性,而非推理本身的正确性。
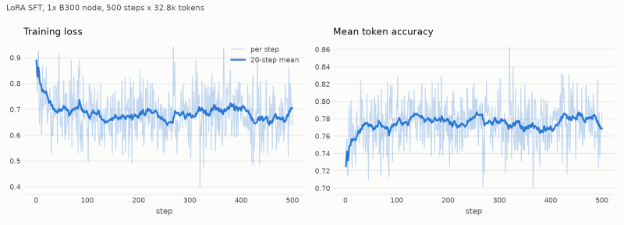
在 open-r1/Mixture-of-Thought 推理子集上,使用单台八卡 B300 节点进行的另一轮 500 步训练中,训练损失(左)与平均 token 准确率(右)。这些训练指标来自官方 TRL 示例 PR。
基于 Miles 的 GRPO
Reflection 和 RadixArk 制定了一套方案,使用 Miles 框架以 BF16 精度对模型进行 GRPO 训练。你可以更新全量参数,也可以使用 LoRA 训练适配器并保持基础权重冻结。其中,Megatron 负责训练,SGLang 负责生成 Rollout,Miles 则在每次更新后将新权重发布到 Rollout 引擎。我们已审查过该方案。
| 工作负载 | 参考配置 |
|---|---|
| 推理/评估,BF16 | 每引擎 16x H200 |
| 全参数 GRPO,BF16(Miles) | 96x H200:64 卡用于训练,32 卡用于 Rollout。或者 64x H200 共置。 |
| LoRA GRPO,BF16(Miles) | 32x H200:16 卡用于训练,16 卡用于 Rollout。 |
| 全参数 GRPO,BF16,128 token 上下文(Miles) | 48x H200:32 卡用于训练,16 卡用于 Rollout。这是 Reflection 和 RadixArk 在真实 checkpoint 上首次验证的配置。 |
该方案在 DAPO-Math-17K 上运行 GRPO,并在 AIME25 上进行评估。构建镜像,下载数据,并将任务提交到由十二个 8x H200 节点组成的 Ray 集群:
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Rollout 过程中的具体步骤如下:
采样: 向模型输入 32 个提示(prompt),每个提示生成 8 个响应。两个 SGLang 引擎负责 Rollout,每个引擎使用 16 张 GPU。
评分: 将方括号内的答案与标签进行比对,并对接近长度限制的响应施加轻微惩罚。
更新: 对全部 256 个样本执行单步优化。采用截断重要性采样的组相对优势,不施加 KL 散度或熵惩罚。
并行训练: 采用 8 路张量并行、8 路专家并行和 8 路数据并行,结合序列并行与完全重计算。
优化器: Adam,学习率恒定 1e-6。梯度使用 BF16,主权重使用 FP32,动量使用 BF16。优化器状态通过节点本地 NVMe 流式传输,因此每个训练节点需要 2 TB 的临时存储空间。
评估: 每 5 次 rollout 在 AIME25 上评估一次,每题生成 8 个样本。每 20 次 rollout 保存一个检查点。
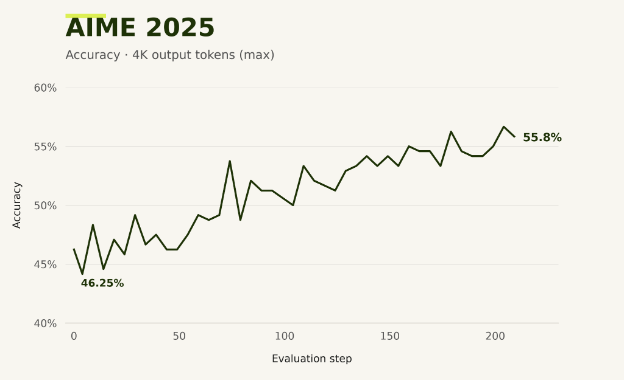
下一次 rollout 的生成与当前轮次的训练同时进行,因此响应内容滞后一个更新步。添加 --resume 可从最后保存的检查点继续训练。execute-colocate 在 8 个节点上运行相同配方,所有 GPU 轮流承担训练和推理任务。
使用 LoRA 训练
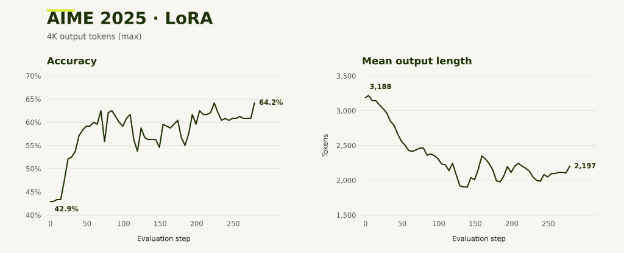
也可以在 4 个 8 卡 H200 节点上运行 LoRA GRPO:16 张 GPU 用于训练,16 张用于生成 rollout。该配方在保持基础权重冻结的同时,训练 Beam 的 Attention、密集 MLP 和专家层的秩 16 适配器。仅适配器权重通过 SGLang 同步,且优化器状态保留在 GPU 内存中,从而无需将优化器状态卸载到 NVMe。
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
使用 Beam 构建:演示案例
如果你基于 Beam 构建了应用,请在 Hub 上分享,有机会赢得 10,000 美元奖金。你只需构建一个 Space、模型或数据集仓库,并在 模型仓库页面 上分享即可。为了激发灵感,以下是我们构建的一些示例。
让 Beam 构建原生的本地 macOS 应用
在 Hugging Face,我们喜欢那些能在硬件上原生运行的开放、本地化模型,但在 Mac 上开发原生应用并不容易!看看 Beam 能不能帮上忙。
我们让 Beam 开发一个原生 MacOS 应用,把语音转成文字,并直接粘贴到光标所在位置。我们希望用 MLX 充分发挥 Mac 的 Metal 性能,并使用 Parakeet 模型来实现高质量的语音转文字。
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
我们使用 Beam 搭配 Pi coding harness 构建了这款原生 macOS 菜单栏应用的初始版本,通过 MLX 运行 Parakeet。已保存的运行记录包含后续的追问提示;最终源码还包含之后用 Codex 修复的内容。上面的提示词是构建需求的精简版。
你可以在这份 trace 中查看 Beam 在 pi 里构建该应用的完整 agent 轨迹。如果想试试这个 demo,可以下载源码,或阅读安装说明。
Hey Beam, how do you scale on multiple agents?
我们想看看 Beam 是否能通过将编程任务拆分给多个 agent 来加速进度。我们将 Beam 与开源的 Pi 编码 agent 配对,并对比了三种配置:1. 单个 agent 独立工作;2. 五个持久同伴通过共享 Git 仓库协作;3. 一个主 agent 将任务委派给异步子 agent。测试框架运行在 Hugging Face jobs 上,推理通过 Reflection 的平台 API 进行。
在任务方面,我们使用了 ProgramBench:agent 必须根据编译后的可执行文件和文档重新创建程序,但无法查看源代码或评估器的测试用例。每种配置都拥有相同的 800 万 API token 上限和每任务两小时的求解器限制,该限制在所有 agent 间共享。我们保存了实现快照,并使用 ProgramBench-Tests 数据集 中的固定隐藏测试套件进行评估。
我们的得分-延迟图展示了通过测试的平均比例。时间轴使用模型 token 的固定参考速率加上实测工具时间,而非实际流逝时间。我们最初运行了五个任务。当前图表显示的是事后选定的子集:jq、xsv、FIGlet 和 hexyl;ripgrep 被从所有三种配置中排除,因为对其保存产物进行评分耗时过长。发布的结果保留了所有 15 个原始 episode。
你可以在 Trackio 仪表盘 中检查运行详情,浏览发布的结果数据,并复用测试框架。
嘿 Beam,为我的代码库微调一个决策模型!
决策模型目前非常流行,因为它们速度快且适用于许多实际场景。当 Beam 在 Pi 中的配额用完后,我们开始训练和评估一个用于开发人员事件分诊的自定义决策模型。
我们想验证一下,编码 Agent 能否将事故分诊策略转化为一个小型、快速的决策模型。任务要求是读取开发者事故报告,确定责任团队、事故严重程度,以及是否需要立即呼叫相关人员。使用 Unsloth 对 Qwen3.5-0.8B 进行微调,使其能够直接对这些决策选项进行打分。 首先,工作流构建了一个包含 2.3k 条事故记录的综合数据集,按事故集群划分,用于训练、校准和测试。我们在 Science Slurm 集群的一台 H100 80GB 上训练了 LoRA 适配器及决策头,采用 4-bit 骨干网络,训练了三个 epoch。 作为基线,我们未对模型进行任何适配,直接提供完整的分诊策略和工单(不附带示例),要求模型以 JSON 格式生成三项决策。在同一批 320 个合成测试工单上,微调后的决策模型在 76.25% 的案例中三项答案全部正确,而零样本提示法仅为 4.69%。平均工单延迟从 1,218.06 ms 降至 102.58 ms,加速了 11.9 倍。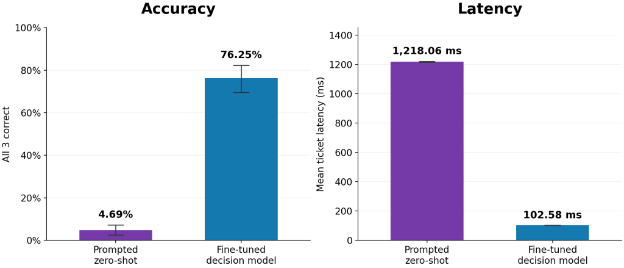 如果你想亲自尝试这个实验,可以查看包含数据、代码、检查点和结果的artifact bucket。