
Google Antigravity 加速抗菌肽研发
抗生素耐药率不断攀升,新型抗生素的研发迫在眉睫,但寻找新疗法的过程往往漫长且耗费大量人力。借助 Google Antigravity——我们的智能体开发平台——这一流程变得更加高效。
Google Antigravity 提供了一款面向科学研究的智能体工作台,赋能生物学家快速发现、结构评估并筛选出有潜力的靶点,将过去在多个数据库间分散进行的搜索压缩至单次会话中完成。该平台还能帮助研究人员利用 ProtNLM——一个基于氨基酸序列预测生物功能的模型——快速扫描 UniProt 数据库中数以百万计的、此前未被表征的蛋白质。
本技术指南展示了生物学家如何利用 Google Antigravity 发现一种新型抗菌肽候选分子,该分子在预测中显示出针对呼吸道感染相关病原体的活性。目前,文中识别出的这一先导化合物正在接受湿实验验证。
发现新型抗菌肽
抗菌药物耐药性的上升是当今最严峻的全球公共卫生危机之一,预计到 2050 年,全球每年可能因此新增约 1000 万例死亡。为避免这一局面,我们急需开发新的疗法。抗菌肽(AMPs),特别是细菌素,为传统抗生素提供了有前景的替代方案。抗菌肽在进化过程中形成了针对竞争细菌基本弱点(从细胞包膜到关键细胞内机制)的机制,这使得病原体更难产生耐药性。
基因组和宏基因组测序技术的指数级增长,使全球数据库填入了数十亿条天然氨基酸序列。这一庞大的自然数据池已催生了广泛使用的细菌素,如 Nisin,以及近期通过基因组挖掘取得突破性成果的新分子,如 Darobactin、Dynobactin 和 Lariocidin。
然而,其中许多蛋白序列仍深藏于蛋白质数据库中未被注释的“暗物质”区域。由于这些序列与已知蛋白缺乏相似性,其具体功能至今尚未明确。例如,全球最具权威性的蛋白序列与功能信息公共数据库 UniProt,收录了数百万条功能未知的序列,这些数据直接源自基因组测序项目。
为填补这一空白,Google 研发了 ProtNLM(蛋白质自然语言模型,Protein Natural Language Model)。这是一款深度学习模型,专为直接解读氨基酸序列底层的进化“语法”而训练。该模型能够直接基于原始蛋白序列预测生物功能,从而为数百万条此前未命名的 UniProt 条目补上高置信度的功能标签。
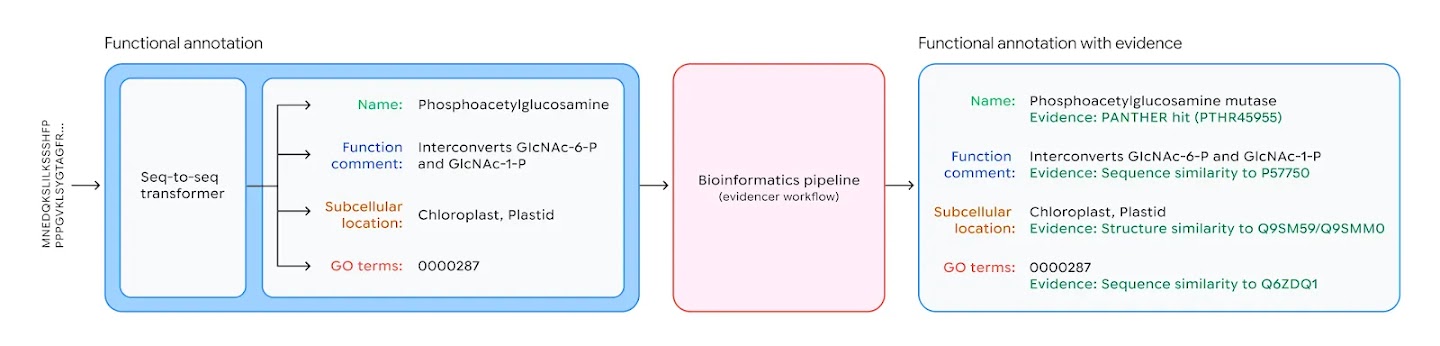

ProtNLM 流程概览:该流程将原始氨基酸序列转化为 UniProtKB/TrEMBL 未审阅条目的自然语言生物注释。除关键词外,系统的功能注释范围还涵盖蛋白名称、功能描述、亚细胞定位及 GO 术语。
协同智能
科学发现很少是一步到位的:要找到可行的候选蛋白,需要人类直觉和反复迭代,不断纳入新的实验证据。在 Antigravity 中,研究人员和 AI 智能体首先设定一个明确的生物学目标:在 Streptococcus pseudopneumoniae 中寻找并计算验证新型 AMP。在多轮交互中,研究人员把控科学策略——决定提出哪些问题、收集哪些证据——而智能体则承担繁重的工作,包括跨数据库检索、结构分析和文献综合。
Slide 1 of 6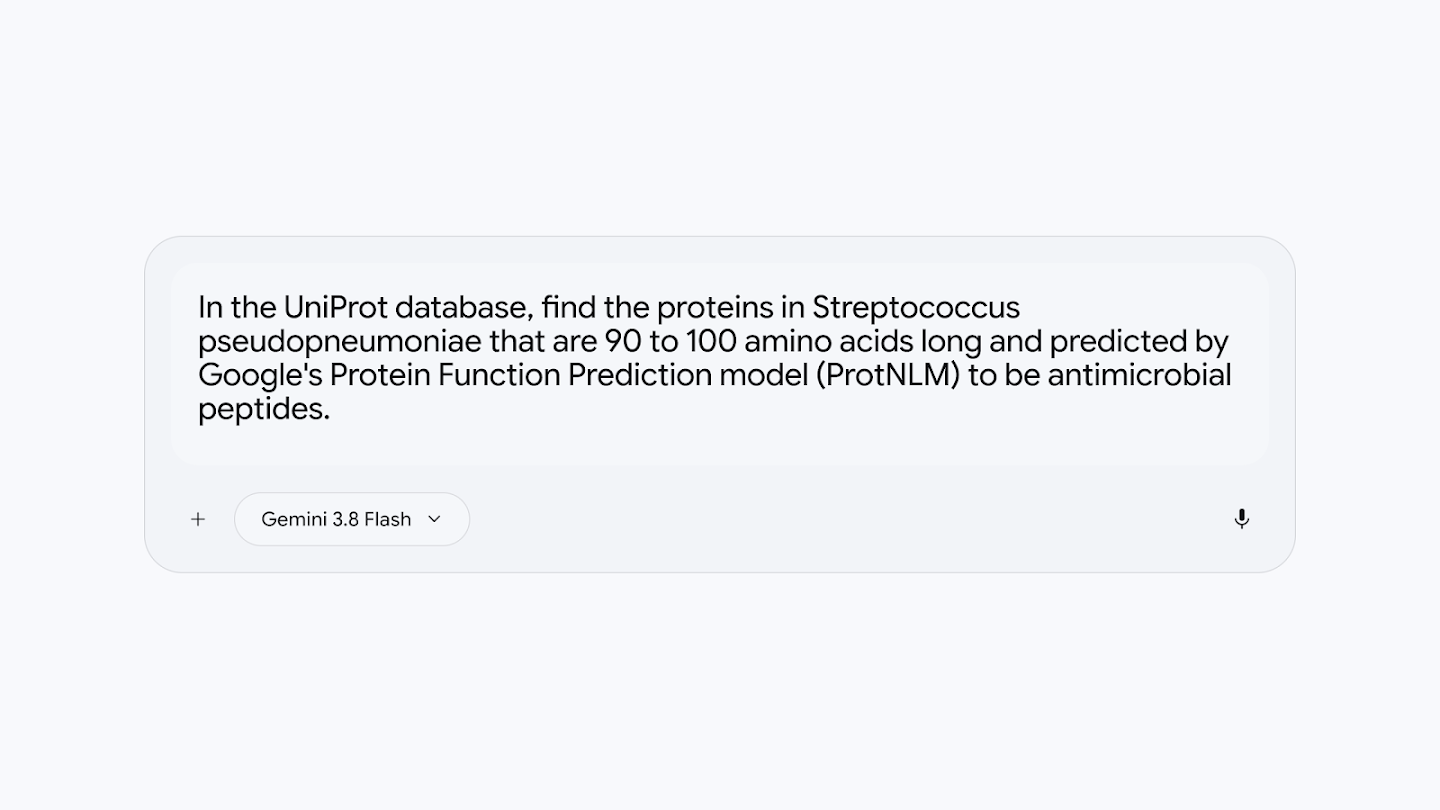
在海量搜索空间中导航:
智能体查询数据库,从数百万条记录中筛选出少数值得关注的候选。这里,智能体找到了一个来自 Lactococcin 972 家族、长度为 97 个氨基酸的细菌素(Uniprot ID:A0A0U0D591)。
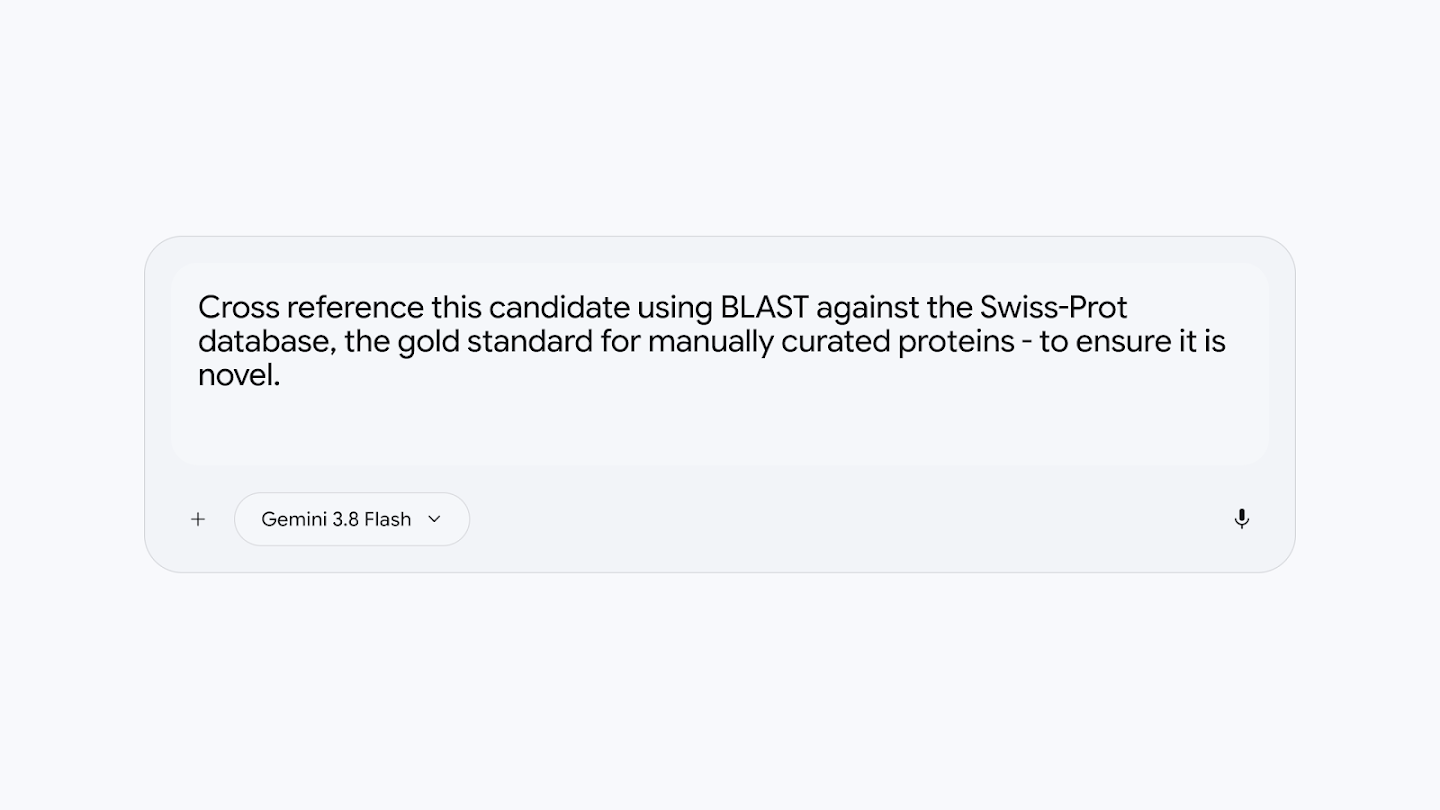
验证发现的新颖性:
为了验证这一发现的 novelty,研究人员引导智能体通过 EMBL-EBI NCBI-BLAST 服务,将候选序列与 Swiss-Prot 中的审编知识进行比对,确认该肽段在人工审校的蛋白质中没有有意义的序列同源物。
基于三维蛋白质结构的推理:
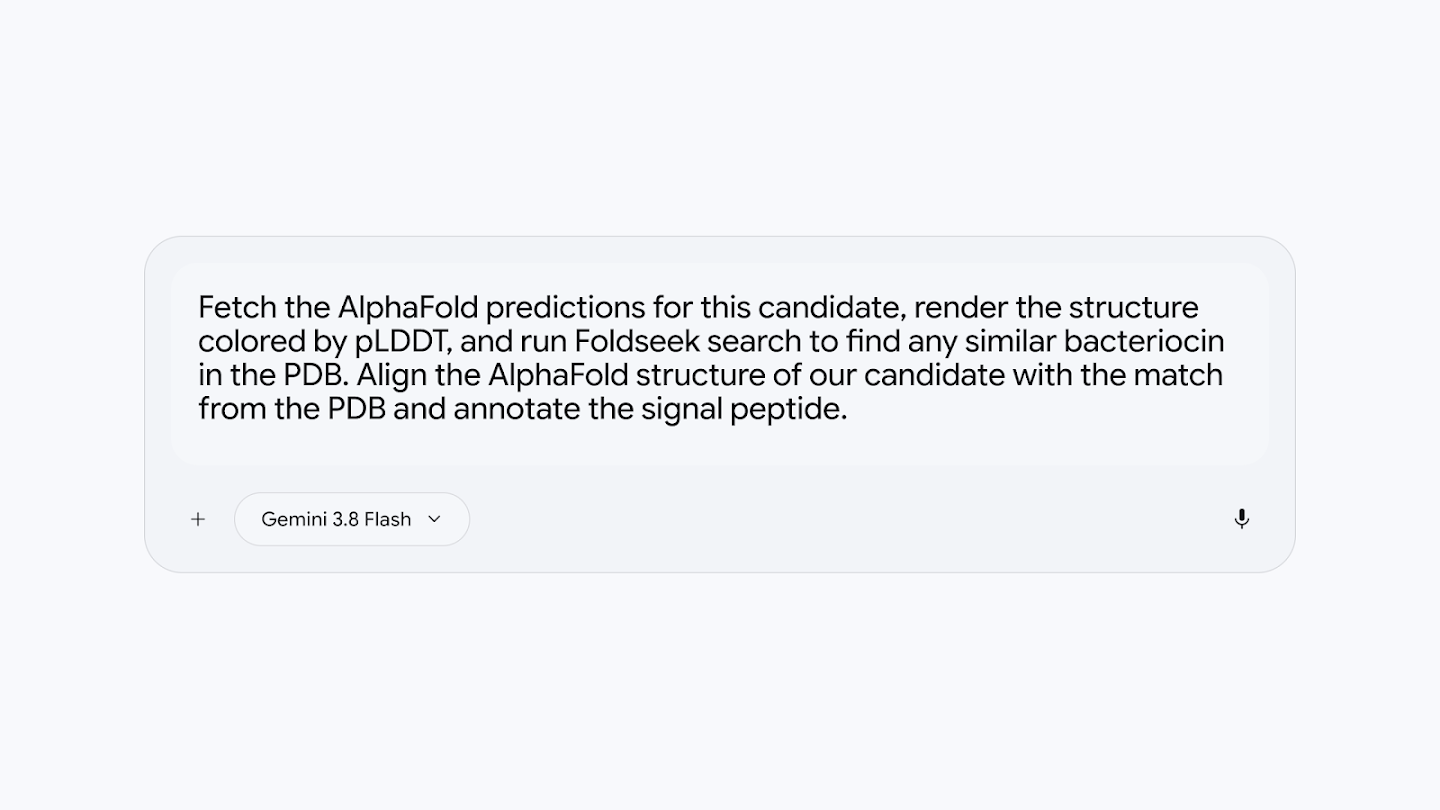
研究人员将分析引导至结构证据。代理从 AlphaFold 蛋白质结构数据库中检索候选分子的三维模型,将其与实验测定的结构进行比对,以识别远缘同源蛋白,并对齐模型以评估相似度。在此,结构证据证实了 ProtNLM 的预测,显示该候选分子的折叠方式与实验测定的细菌素高度匹配。Antigravity 中的结构查看器使得这种结构分析可以在同一界面中无缝完成。


解读基因周围的生物学语境:
该智能体不仅关注分子本身,还审视其基因组环境,通过推理判断周边机制是否支持 AMP(抗菌肽)假说。检查两侧基因时,它发现了一个引人注目的模式:我们先前未表征的候选序列位于一个紧密偶联操纵子上游,紧邻一个 ABC 转运蛋白渗透酶及其潜在伴侣 ATP 结合蛋白,旁边还标注了一个细菌素和 XRE 转录调控因子。这提供了有力的上下文证据,表明它是功能正常的细菌素系统的一部分。


基于文献构建机制假说:
通过查阅现有文献,该智能体提出分子可能的作用机制及靶标病原体。在本例中,现有证据显示其作用机制针对细菌细胞分裂,且预测其活性谱覆盖多种耐药病原体。

生成实验方案:
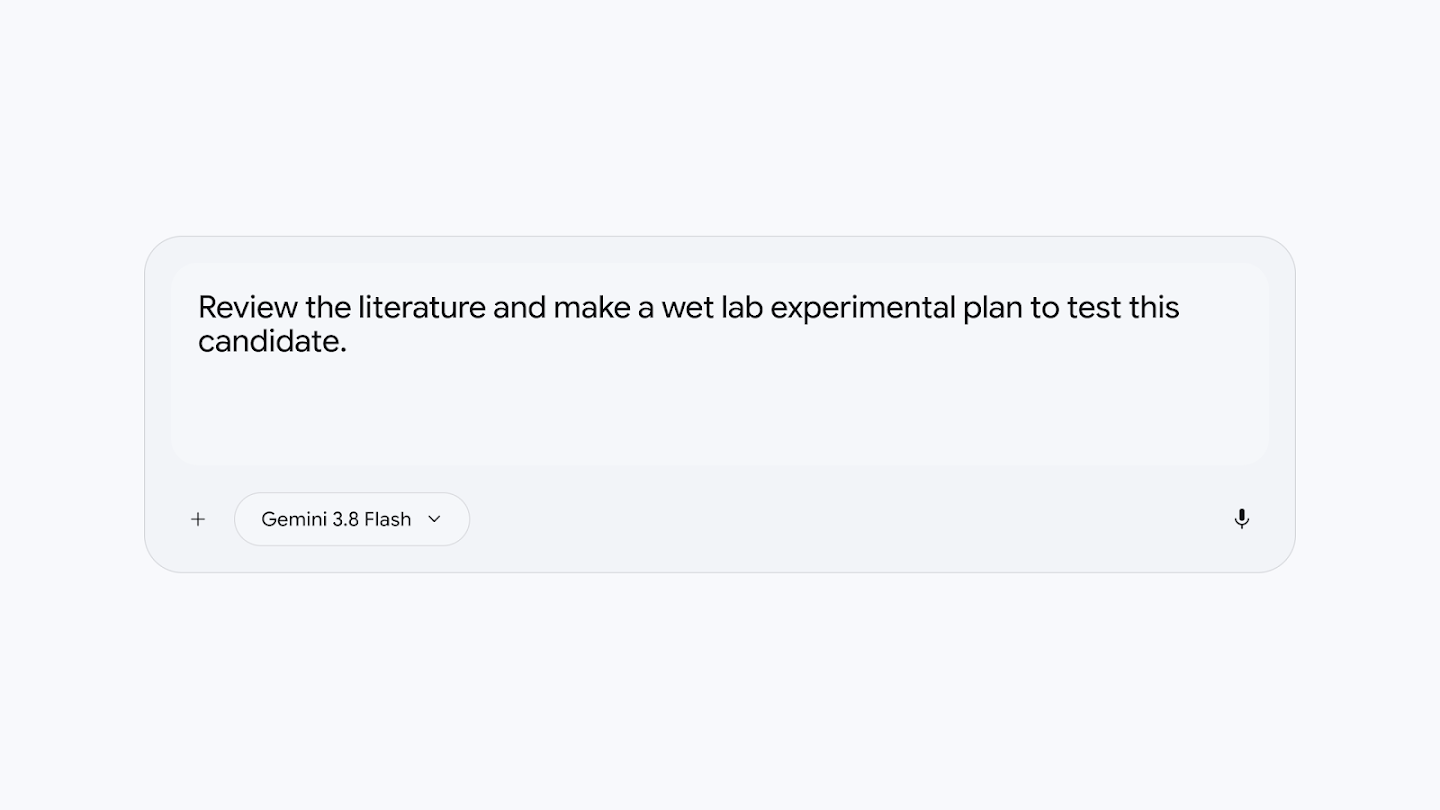
最后,agent 将其计算机模拟的发现转化为一份可执行的实验方案,涵盖蛋白表达、抗菌药敏试验、靶点结合验证和体外毒性测试,打通了从计算预测到湿实验之间的鸿沟。这一步已经启动:这个候选分子,以及通过同一流程发现的其他几个候选分子,目前正在湿实验室验证中,实验结果将是对 agent 分析的最终检验。 我们在本次演示中找到的候选分子有结构和基因组证据支撑,具备生物学上的合理性,但仍需湿实验验证。它的意义在于大幅降低了日常生物学研究的门槛——把原本需要数天的碎片化数据库筛选,变成了一次协作会话。虽然这次会话只聚焦于 Streptococcus pseudopneumoniae 的一小段氨基酸序列,但研究者可以把对话引向任何方向,比如加入新的筛选条件、尝试不同的序列长度,或者瞄准其他重点病原体。把搜索范围从人类共生菌扩展到环境微生物乃至更广,科学家就能引导 agent 在 UniProt 中大规模发现新型 AMP 候选分子。共享 3D 画布,实现交互协作
蛋白质的三维结构有助于我们理解其生物学功能,而在空间中观察候选分子的预测折叠形态至关重要。为了在同一个工作空间里提供这种端到端流程,我们推出了 Biomolecular Structure Viewer——一个直接嵌入 Antigravity 的 3D 可视化工具。 研究者与 agent 基于共享的视觉状态协作。当 agent 从 AlphaFold Database 或科学家自己的预测中获取结构时,它可以动态操控查看器,比如高亮关键功能区域,以可视化方式解释自己的假设。关键是,这种感知是双向的:研究者高亮特定残基、在结合口袋上标注笔记等操作,也会同步回传给 agent。研究者只需在 3D 空间中标记一个感兴趣的区域,然后提问,例如“这条 β-折叠可能会如何影响 Lipid II 的结合?”,agent 就能立即基于科学家正在查看的确切结构上下文进行推理。Antigravity 内的生物分子结构查看器展示了候选细菌素的 AlphaFold 预测结构,为研究人员与智能体提供了一块共享的 3D 画布,用于检查和标注功能区域。
加速科学发现
以往,获取上述工作流程中展现的洞察,需要依赖碎片化且高度专业化的软件:编写自定义脚本来查询数据库,手动将文件导出到 3D 建模程序,管理互不连通的基因组工具,并与多位专家协作设计湿实验。由于湿实验验证仍属资源密集型环节,前期将搜索范围收敛至高置信度线索至关重要。利用 Google Antigravity,研究人员能够高效探索庞大的生物搜索空间,同时借助领域特定模型获得精准的蛋白质功能预测。
Google Antigravity 在同一平台上执行这种端到端的科学推理。这让科学家能将更多时间投入评估高质量假设、在实验室开展实验以及解决研究挑战。
致谢
我们感谢以下团队成员的贡献:Maria Gabriela Cardoso、Victoria Johnston、Lexi Walker、Gena Hong、James King、Richard Green、Filip Radlinski、Artem Sobolev、Michael V. LeVine、Ruijie K. Zhang、Zachary Wu、Luca Schulz、Amy Danson、Tristan Oliver Kwan、Ryan Krueger、Oleg Kovalevskiy、Doug Fritz、Yunhan Xu、Sebastian Nowozin
在 Google Antigravity 中探索科学工作流
