
Jev 如何决定下一个浏览器动作
本文介绍 Jev 接入 rtrvr 的整体方案、真实的浏览器任务、测试结果,以及其中的取舍。
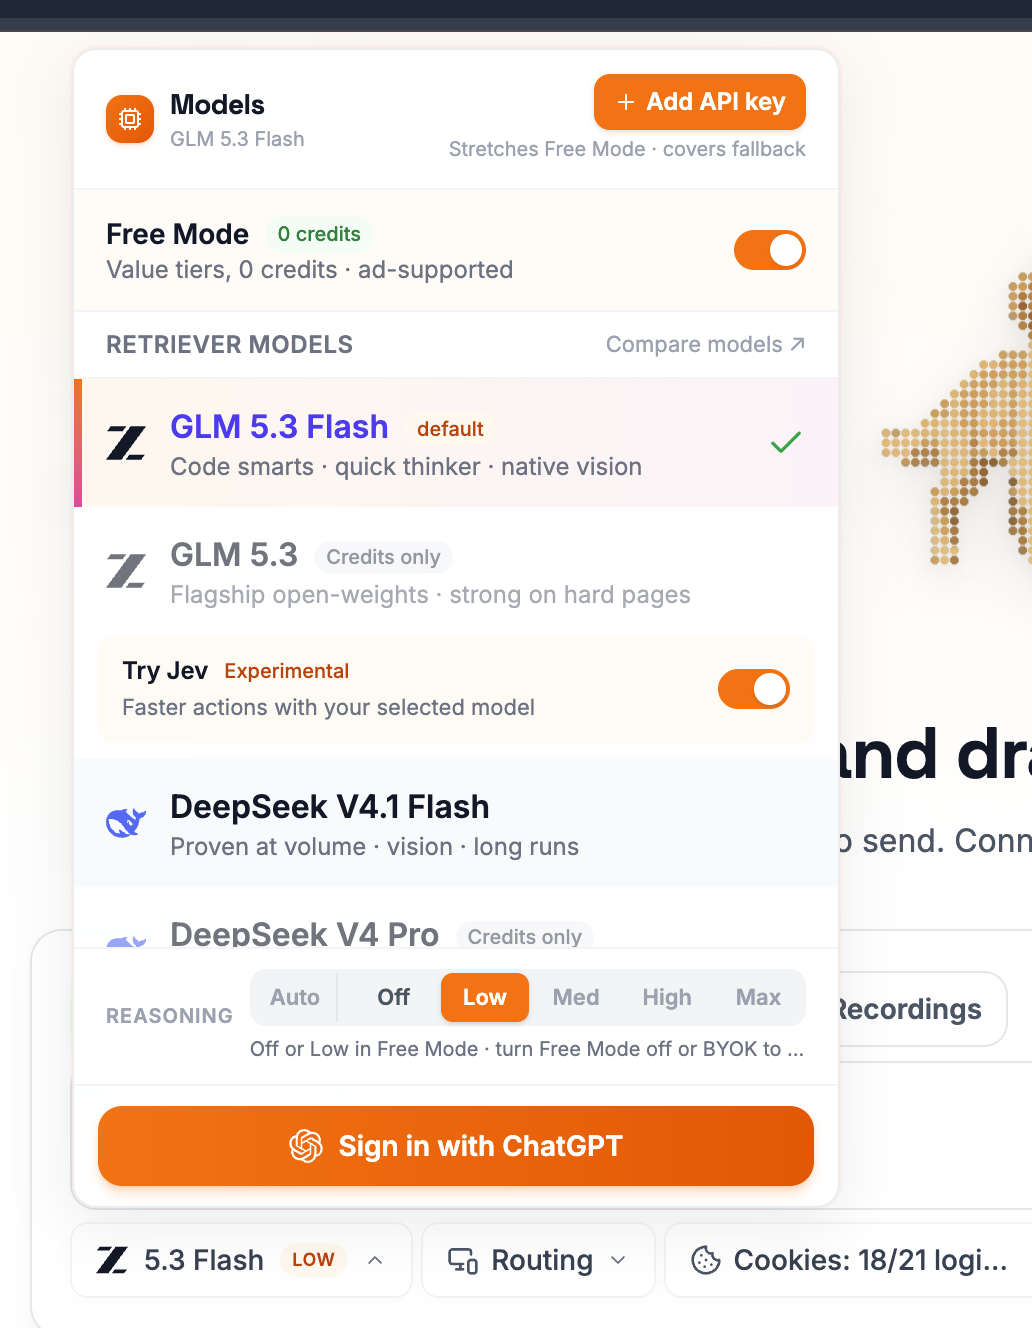
 rtrvr 中的 Jev
在 LinkedIn 上发一条消息需要好几个步骤:找到对方的资料页、输入消息、点击发送、确认消息已发出。规划器可以提前写好这套流程,但每一步,浏览器 agent 仍要从当前页面中选择一个具体动作。
为此,我们在 rtrvr (Retriever AI) 中接入了 TypeSafe 专为结构化决策设计的模型 Jev,由它来做这些选择。GLM 继续负责制定计划,以及需要生成代码或文本的步骤。Jev 接收当前页面状态和可用动作列表,每个动作的工具参数都已预先填好。
在本地 LinkedIn 和 Amazon 测试中,启用 Jev 后运行时间分别缩短了 31% 和 43%,但成本也分别增加了 38% 和 51%。基线使用的是便宜的 GLM Flash,而对大页面打分带来的开销,超过了 GLM 调用上省下的钱。
下文将介绍我们如何把 Jev 接入浏览器循环、它的选择效果如何,以及后续可以改进的地方。
如何启用 Jev
打开 Chrome 扩展的侧边栏,或访问 rtrvr.ai Cloud。点击输入框旁的模型名称,开启 Try Jev(标注为 Experimental 实验功能)。保留你原本选用的模型即可,Jev 会与它协同工作。
1 点击输入框旁的模型名称。
2 开启 Try Jev。
1 点击输入框旁的模型名称。
2 开启 Try Jev。
截图中的 Jev 处于开启状态。它默认关闭,Free Mode 和付费套餐均可使用,无需单独的 TypeSafe API key。Private Mode 下不可用。如果扩展里看不到这个开关,请升级到 37.9.0 或更高版本,然后重新打开侧边栏。
关于当前控制项、故障排查方法及视频演示,请参考 Jev 设置指南。已发布的集成版本保留了 Planner 的完整 Prompt,且未启用 Jev 评分。对于超大的动作请求,仍可选择在决策前使用 Score。以下测量数据来自早期实验;我们尚未对该变更重新进行基准测试。
尝试可验证的任务
先从一个小型的 网站数据采集任务 或基于文档自动填写的 练习表单 开始。这两份指南均包含 Prompt、输入参数及参考结果。在执行更大任务或允许提交前,请检查输出结果。
交互式 Free Mode 提供带有每日额度的支持 AI。下文中的供应商成本估算基于记录的实验运行数据;这并非使用免费套餐产生的账单。
使用 Jev 任务运行更快
我们测试了两个日常浏览器任务:向指定联系人发送 LinkedIn 消息,以及将两件商品加入 Amazon 购物车。购物请求允许选择任意 30 美元以下的优质洗发水及任意规格的 Tide Pods。流程不包含结账。
两种配置均使用 rtrvr harness:每个任务分别在 关闭 Jev 和 开启 Jev 的情况下各运行一次。所有四次运行均使用通过 GMI 调用的 GLM 5.3 Flash 作为生成模型,并采用相同的本地扩展版本。Jev 解析至 jev-1.13.0。
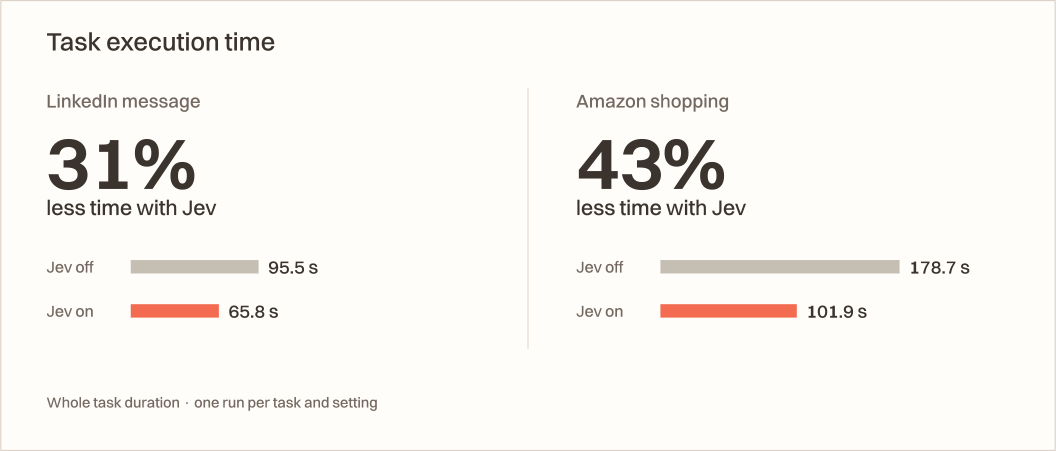
这些是 Planner 整个调用过程的耗时,包括浏览器操作和等待时间。基线测试最先运行。由于实时页面和生成的计划存在差异,Amazon 任务选择了不同的商品并使用了不同的确认路径。这是四次观察性运行结果,并非对 Jev 在所有浏览器任务中速度提升幅度的受控估算。
GLM 规划任务;Jev 选择浏览器动作
Jev 返回类型化的决策。它不生成执行开放式浏览器任务所需的代码或文本。其三种问题类型允许我们请求不同的决策:
| 原语 | 回答 | 有用的浏览器代理问题 |
|---|---|---|
| 选择 | 单一选项、选项概率及置信度 | 应执行哪个给定的动作? |
| 评分 | 有序评分标准上的预期位置、概率及置信度 | 此页面区域与当前步骤有多相关? |
| Noul | “是”的概率 | 给定的证据是否满足此要求? |
这些运行使用了选择和评分。未发生 Noul 调用。
我们的 代码即计划循环 保持不变。GLM 编写了流程。当流程调用 act 时,我们的浏览器代理会接收一个受限目标,例如查找联系人资料或将洗发水加入购物车。
我们的代码根据观察到的控件构建菜单:点击此元素、输入此确切消息、选择此下拉值。Jev 选择了其中一项。它不会臆造元素 ID、编写消息或组装新的工具参数。
TypeSafe 将输入称为状态。我们提供了当前目标、页面内容、最近的执行结果以及可用于该动作的确切值。问题定义了需要做出的决策。状态可以是结构化数据或文本。
每个动作都始于当前页面状态
小型请求直接交给选择处理。大型请求先进行一次并行评分,随后对选定的页面区域及其可用动作进行一次选择调用。如果步骤需要生成或修复,现有模型会继续处理。显式的委托选项允许 Jev 选择该路径。
预算覆盖的是整个序列化请求:目标、历史、问题、页面内容和操作选项。我们把 96,000 字节的请求大小和 28,000 估算输入 token 作为运行上限,同时最多允许四个 Score 请求并行。这些是我们自己设的预算,并非 TypeSafe 的确切上下文限制。有一次请求估算为 27,771 个 token,实际报告的原生输入 token 是 30,139,可见估算器需要留出余量。
上下文选择保留的信息,要足以识别正确的人或商品、理解失败的操作,以及判断任务是否已经完成。
在两次辅助运行中,全部 50 次 Jev 调用都返回了评估结果。其中 11 次是 Choice 调用:7 次选择了浏览器操作,4 次选择了委派。rtrvr 执行了全部 7 次选定的操作。这些交接来自 Jev 主动选择委派,而不是 API 故障。
三次委派选择带来了最终的完成回答。比如洗发水那次操作,在加入洗发水后就结束了,它不负责下一件商品。随后规划器以 Tide 为目标发起了另一次 act。
剩下的一次交接发生在那次 Tide act 的开始。它的指令中已包含一个 Amazon 搜索 URL,但我们的 Jev 菜单没有直接的 URL 导航能力。GMI 使用了那个 URL,然后 Jev 在新页面上继续选择操作。也就是说,GMI 用的是菜单之外的能力,而不是从菜单里挑出更好的候选。在未来的版本中,已知 URL 可以直接走导航工具。
每次 Jev 操作的概率与置信度
我们接受排名最高的有效操作,而不设置固定的概率或置信度截断阈值。rtrvr 仍会检查工具参数,以及该操作是否指向当前页面。当 delegate 排名第一时,现有模型会接管控制权。
对于每个被选中的操作,我们记录了其概率、Choice 回答的置信度,以及主要的竞争选项:
| 选中的操作 | 概率 | 置信度 | 竞争选项 |
|---|---|---|---|
| 打开联系人资料 | 0.85 | 0.83 | Delegate: 0.08 |
| 输入消息 | 0.55 | 0.53 | 另一个输入候选项: 0.34 |
| 点击发送 | 0.95 | 0.94 | Delegate: 0.04 |
| 打开洗发水 | 0.22 | 0.20 | 另一次点击: 0.13; delegate: 0.14 |
| 将洗发水加入购物车 | 0.97 | 0.97 | Delegate: 0.02 |
| 打开 Tide Pods | 0.22 | 0.21 | 另一次点击: 0.21; delegate: 0.20 |
| 将 Tide Pods 加入购物车 | 0.98 | 0.97 | Delegate: 0.02 |
多个选项可能达成相同目标
“加入购物车”有明确的胜者。但选择产品则没那么确定:两款产品的胜出概率均为 0.22。对于洗发水,第二名是 delegate,概率为 0.14,差距为 0.08。对于 Tide,另一次点击的概率为 0.21,差距仅为 0.01。
洗发水的置信度为 0.20,Tide 的置信度为 0.21。竞争更激烈的场景,其置信度反而略高。置信度与领先于下一个选项的幅度是不同的度量指标,因此记录这两项指标很有帮助。另一个输入候选项也有显著的概率,为 0.34,而胜者的概率为 0.55。
这些替代方案并未经过测试和标注。仅凭概率无法断定它们是错误的。其中一些可能是同样有效的产品或等效的控制项。更好的评估方式是对所有主要候选项进行判定,将等效操作分组,并测量置信度是否能预测实际错误。设置截断阈值可能会拒绝有用的操作,也可能会拒绝错误的操作;这些例子无法告诉我们阈值应设在何处。
每个 Choice 答案都对应一个置信度值,该值源自其选项分布。每个选项都有一个概率。这两个数值都无法证明网站已接受该操作。TypeSafe 在其置信度文档中解释了这一区别。
在自信选择后检查页面
LinkedIn 的发送操作说明了原因。Jev 以0.95 的概率和 0.94 的置信度选择了发送。浏览器操作结果报告“无可观察影响”。rtrvr 读取更新后的页面后,Jev 进行了委托。GMI 随后报告,带有时间戳的确切消息已出现在对话线程中,任务在不再重复发送的情况下完成。我们未独立捕获该线程的最终截图。
两次 Amazon 加入购物车操作均显示浏览器操作成功。总体而言,所选操作符合任务要求,交接过程也符合分工。这些例子太少,不足以确立模式或设定阈值。我们需要更多带有评估结果的数据,包括对竞争操作的检查,以了解概率、置信度或选项间的差距是否能帮助预测错误。然后我们就能判断设定阈值是否真正改进了智能体,还是仅仅增加了不必要的交接。
Jev 为页面区域打分以选择相关上下文
大型页面可能包含数百个与当前目标无关的链接和控件。Jev 的Score 原语会为每个页面区域的相关性评分。我们的测试框架使用这些分数来选择传递给 Choice 的区域和可用操作。保留的页面文本保持原样,包含识别目标、理解失败和确认完成工作所需的信息。
在 Amazon 洗发水搜索页面上,Score 和我们的选择规则将菜单从591 个操作减少到 82 个。在下一个产品页面上,这一数字从513 降到了 55。
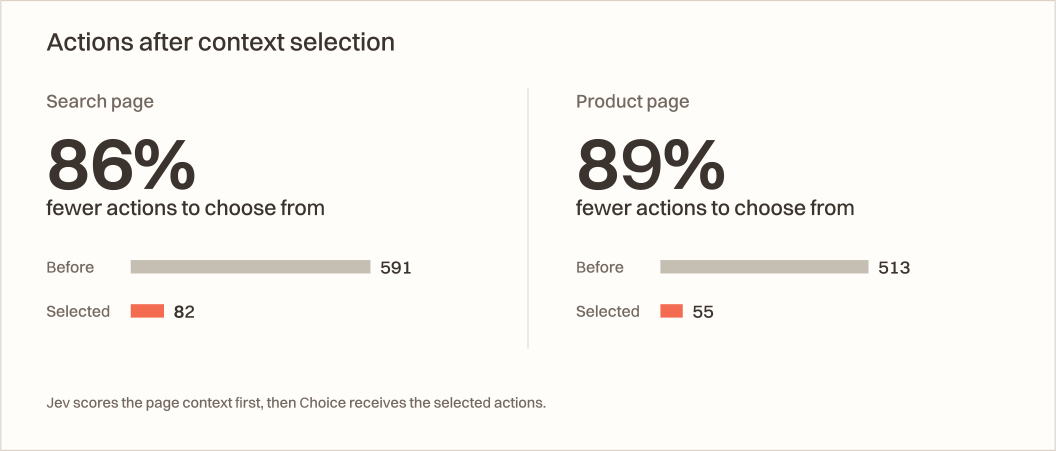
按观察数据量加权计算,在被采纳的上下文选择中,保留的源数据字节数在 LinkedIn 上下降 90.0%,在 Amazon 上下降 69.4%。全部十次上下文选择均覆盖了完整区块。
这个降幅只针对送入 Choice 的内容。Score 本身需要先读取被过滤的原始材料,所以这并不等于总体 token 节省。
Jev 的上下文评分推高了总推理成本
对页面区块进行评分本身需要调用模型。在这些测试中,这部分额外开销超过了减少 GLM 调用所省下的成本。
GMI 调用在 LinkedIn 上从 7 次降到 4 次,在 Amazon 上从 8 次降到 5 次。辅助运行额外增加了 39 次 Score 调用和 11 次 Choice 调用。Choice 请求每次耗时 165–367 毫秒,不含评分、页面抓取和浏览器执行时间。Score 占 Jev 预估成本的 78.7%。
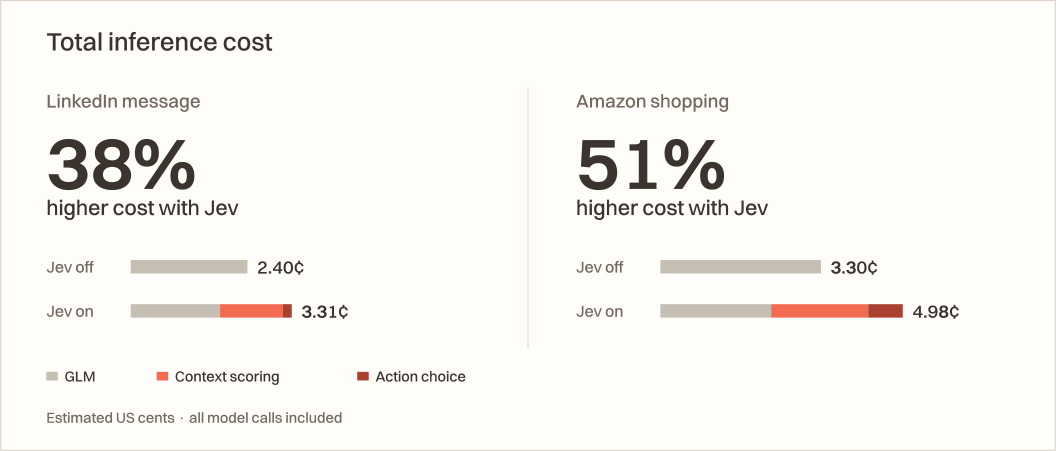
| 任务 | Jev 关闭:总计 | Jev 开启:GLM | Jev 开启:Jev | Jev 开启:总计 |
|---|---|---|---|---|
| $0.02398 | $0.01835 | $0.01473 | $0.03308 | |
| Amazon | $0.03298 | $0.02275 | $0.02704 | $0.04978 |
LinkedIn 上有一次规划器上下文选择特别浪费:执行了四次 Score 请求,结果保留的上下文却太多,最终我们还是用了原始提示词。Amazon 上的那次选择虽被采纳,但只删减了 21.3% 的源数据字节。既然下一个模型反正会收到几乎相同的上下文,就不该花钱去评分页面。
缓存的 GLM 输入成本低于 Jev 输入
我们通过 GMI 使用了GLM 5.3 Flash,一个开放权重模型。以下是估算运行成本时采用的配置费率,以每百万 token 的美元计:
| 模型 | 未缓存输入 | 已缓存输入 | 输出 |
|---|---|---|---|
| GLM 5.3 Flash / GMI | $0.075 | $0.015 | $0.25 |
| Jev | $0.042 | 未使用单独费率 | 估算中不计输出费用 |
Jev 的输入费率比 GLM 未缓存输入低 44%,但却是缓存费率的2.8 倍。基准测试还拥有更高的缓存命中率:在 LinkedIn 上,输入 token 为 192,000 对 81,472;在 Amazon 上,为 261,376 对 81,472。GMI 调用次数减少并未带来成比例的美元节省。
作为价格参考,Anthropic 列出的 Claude Opus 5 为每百万输入 token $5,每百万输出 token $25。替换这种调用要昂贵得多。本实验未运行该模型。来源:Anthropic 模型定价。
在替换更高价的前沿模型调用时,Jev 可能省钱。这仍是关于完整工作流的假设:评分开销、缓存使用及模型行为都会改变账单。
在此,rtrvr 关闭 Jev 时成本更低;开启 Jev 时完成更早。两种配置均未在两项上双双胜出。低成本开放权重模型使这一权衡的成本端要求很高;Jev 最明显的观察到的优势在于速度。
未来工作
1. 为当前任务选择合适的技能
rtrvr 已具备技能框架。一个网站可能有多个复杂工作流,各自服务于不同目标。仅匹配领域不足以告知应加载哪个技能。
Choice 的一个 promising 后续用途是选择合适的现有技能:
- 代码根据网站、可用性、权限和所需输入筛选技能。
- Jev 查看当前目标、页面状态以及剩余技能的紧凑描述:各技能的作用、适用场景及承诺的结果。
- Choice 选择一个技能,或在无合适项时委派。框架为规划器加载所选技能的完整指令。
- 规划器执行该动作,测试框架校验结果。组合、新代码编写和修复工作仍由规划器负责。
一次路由决策可以指导多个浏览器动作。这或许是比让 Jev 在每次点击前重新阅读大页面更高效的做法。只要目标和相关页面状态依然有效,该选择便可保持不变;当任务阶段改变或执行失败时,再重新评估。
Jev 的技能选择属于未来工作,本次运行未使用。
2. 预处理上下文并保持相关内容聚合
当前的分块器已能保留完整的源代码行并恢复结构祖先节点,并非简单地按 Token 数量截断页面。但基于行的大小限制仍可能将产品卡片、表单或对话拆分到不同区域。
下一版本应保留这些单元:
- 按子树分区。将产品的名称、价格、变体和操作保留在一起。递归拆分过大的子树时,保留其父级路径和稳定的元素 ID。记录所有源范围,以防尾部内容丢失。
- 在代码中预处理。在保持含义不变的前提下,合并等效控件和重复样板代码。即使某些区域评分较低,也要确保身份信息、故障情况和完成证据可用。
- 打包更少但更饱满的请求。不仅要考虑页面文本,还要预留共享状态和问题开销的预算。仅发送必要的批次,执行一次有界并行的 Score 流程,随后进行一次 Choice 调用。并行处理可以节省时间,但本身并不能节省 Token。
- 仅复用有效工作。缓存的评分必须匹配区域、目标、问题及相关周围状态。出现新错误或完成迹象时,需要做出新决策。当廉价的大小检查表明提示词缩减空间有限时,跳过评分。
3. 评估何时接受选择或委托处理
目前我们接受排名最高的有效动作。要评估该策略,我们需要带有结果标签的任务,包括前两个动作差距微小的情况。随后,我们可以对比接受获胜者与将不确定步骤交给规划器处理,衡量完成度、额外调用次数、延迟和成本。任何阈值都应基于这些结果得出。我们还应检查,将等效控件分组是否能使排名更易于解读。
Noul 可以针对页面状态回答具体的检查问题,比如某个必填表单值是否存在。它返回的是一个概率,而不是如何修复计划的解释。我们会把它放在能用这种检查替代现有工作的位置;每次操作后都多一轮审查只会增加延迟。
我们会分别测试 skill 路由、上下文预处理和验收策略,以两种顺序重复执行可比较的任务。这样就能看出哪个改动起了作用,以及它是否保住了最终结果。
需要多次重复运行才能衡量收益
脱敏后的数据文件包含每次调用的耗时和成本估算、token 用量、菜单大小、上下文覆盖率以及最高的 Choice 概率。页面正文、消息文本、账号 ID、凭据和私有的操作参数均未包含在内。
实验于 2026 年 9 月 16 日在本地运行。成本基于提供商上报的用量和上文配置的费率,涵盖所有记录在案的 Jev 调用。这些只是估算值,并非账单或公开的价格承诺。浏览器基础设施、其他工具、credits 以及针对特定账户的调整都不在统计范围内。不同提供商的 token 分开统计。
Jev 于 9 月 17 日在 Cloud 和扩展 37.9.0 版本中发布。正式发布的版本包含更多改动,此处未重新跑基准测试。
耗时数据来自扩展中单调递增的 planner 调用计时器,不包含 planner 启动前的准备工作。重叠的提供商调用区间在模型墙钟时间里只计一次。四次调用均报告完成,没有失败的模型提供商请求,也没有缺失的用量记录。
Amazon 两次运行选中了不同的合格商品,验证方式也不同:baseline 打开了购物车,而辅助运行则读取了"已加入购物车"页面。两次运行之间 LinkedIn 消息内容发生了变化。最终结果来自模型的回答,没有提供独立的截图和受控的购物车重置记录。每种配置只跑一次、baseline 先行、页面状态不断变化、缓存使用情况不同,这些都限制了对比的严谨性。
我们会保持同样的分工:GLM 编写并修复计划,Jev 从页面当前可用的操作中选择,rtrvr 执行操作并读取更新后的页面状态。下一步是减少重复的上下文读取,然后验证这样能否在更低成本下保住省下的时间。