
NVIDIA Nemotron 3.5 Super VL:多模态推理驱动专业化智能体
全天候运行的智能体正在承担越来越长、越来越复杂的企业工作流。一个请求可能涉及阅读文档、跨多个来源核对信息、遵循公司政策,还要调用多个工具。
NVIDIA Nemotron 3.5 Super VL 正是为这类专业工作流打造的开源、可定制多模态模型。它采用 1200 亿参数的 mixture-of-experts (MoE) 架构,每个 token 仅激活 120 亿参数,在模型能力与推理效率之间取得了平衡。
在单张 GPU 上,与同规模的其他开放模型相比,该模型在智能体任务上的吞吐量最高可提升 5 倍。
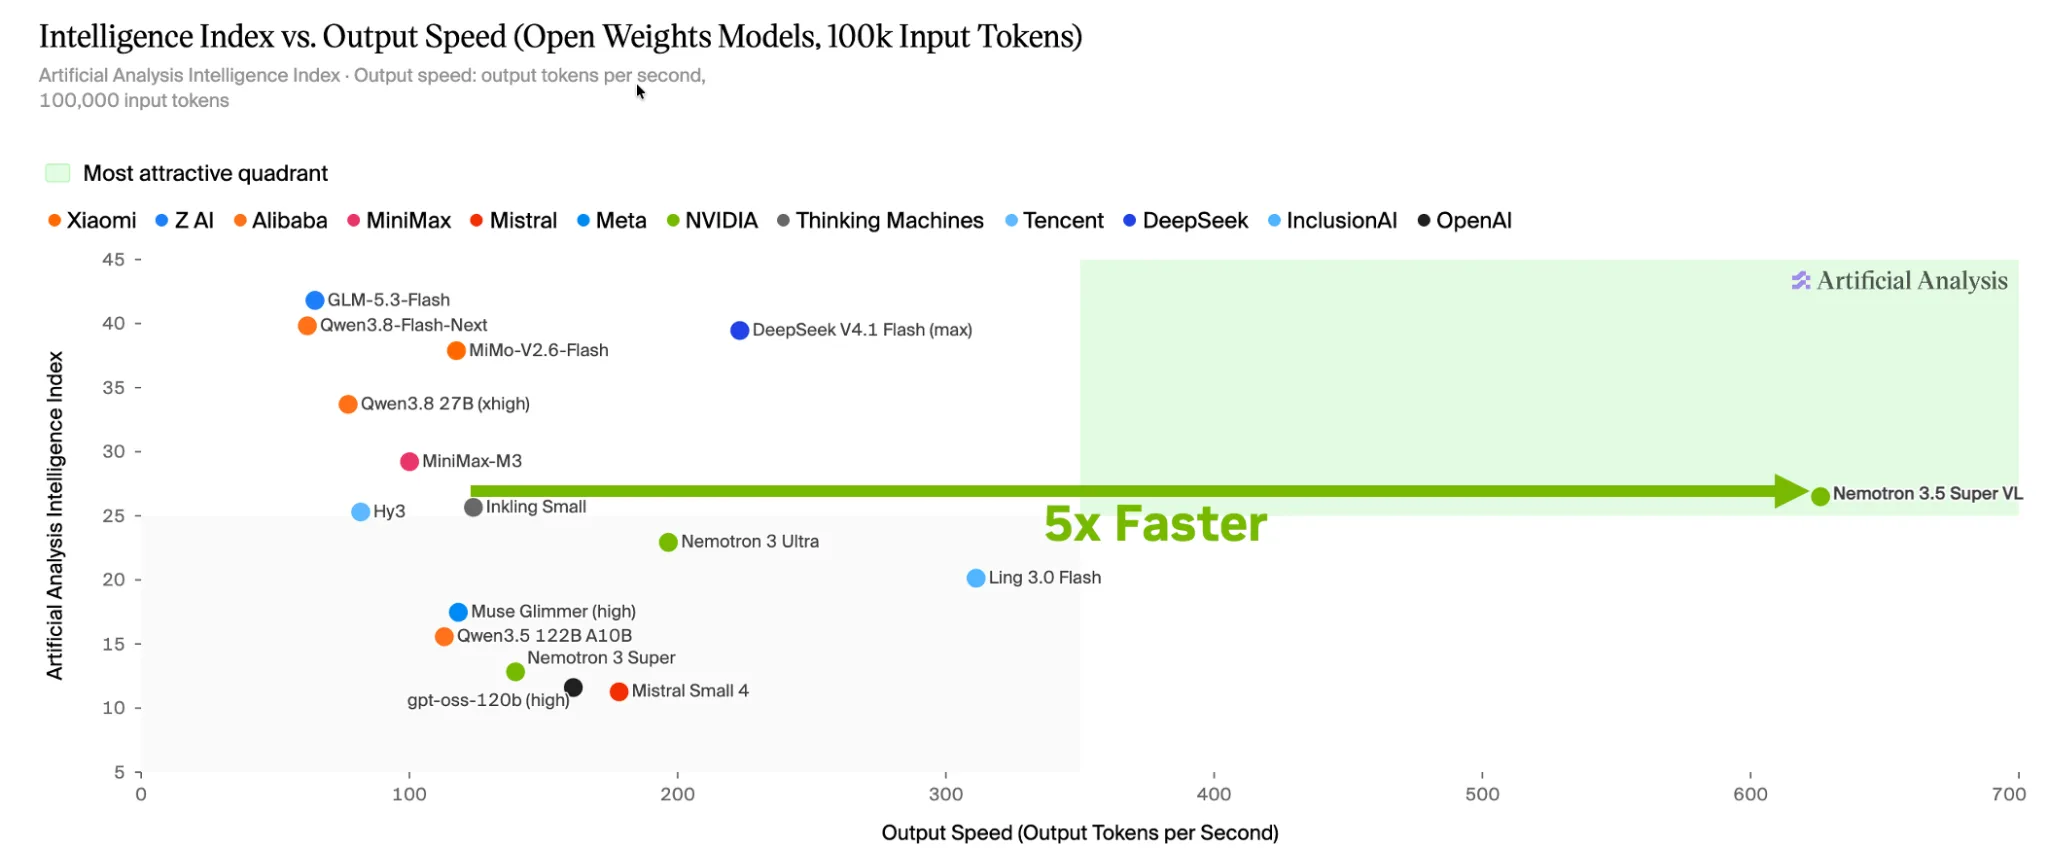
该模型集推理、指令遵循、工具调用能力于一身,并能理解文本、图像、文档和视频。由于这些能力合并在一个模型中,团队无需分别部署文本模型和视觉语言模型,也不用在两者之间传递任务上下文。
开发者可以使用 NVIDIA NeMo,基于自己的数据、工具、政策和工作流对 Nemotron 3.5 Super VL 进行后训练。本文将介绍如何基于这一模型构建专业化的企业智能体,并解析其背后的训练与推理技术。
为什么选择 Nemotron 3.5 Super VL 来构建专业智能体?
Agent 需要同时理解自己的任务和所处的运行环境。客服 agent 要遵守公司的退货政策;研究类 agent 需要跨资料来源串联证据;文档类 agent 则要解读表格、图表和页面布局。
Nemotron 3.5 Super VL 将推理与视觉理解结合,覆盖多种 agent 工作流,包括:
- 编程:测试和验证代码、分析错误并推荐修复方案。
- 网页调研:跨网站搜索、串联信息并验证答案。
- 文档智能:从表格、图表和页面布局中提取信息,生成摘要和报告。
- 网络安全:发现安全漏洞、对威胁进行分类分级,以确定修复优先级。
- 视频理解:为搜索、内容审核和事件分析提取信息。
在多模型系统中,Nemotron 3.5 Super VL 负责需要推理、工具调用以及文本和视觉理解协同的专用多步骤工作。NVIDIA Nemotron 3.5 Lightning 等较小的模型处理高并发的文本任务,而 NVIDIA Nemotron 3 Ultra 等前沿模型则负责复杂的规划与编排。
基于领域数据、工具和策略定制 Nemotron 3.5 Super VL
专用 agent 必须了解组织的运作方式。领域术语、工具接口、操作流程和策略要求,都决定着 agent 能否顺利完成任务。
从网络安全、金融到医疗健康等行业的组织,正在对 Nemotron 3.5 Super VL 进行后训练,使其在生产工作流中的准确性和效率超越前沿模型。例如:
- AI 数据与技术公司 Scale AI 为媒体娱乐公司 Skydance Corporation 的自动化供应商信贷处理业务对 Nemotron 3.5 Super VL 进行了后训练。该工作流的推理成本将降低 40 倍,延迟降低 5 倍。
- 金融运营平台 Ramp 利用它把收据图片转换为包含商户信息、日期和支付数据的结构化 JSON,预计吞吐量最高可提升 50%,延迟降低至原来的 1/10。
- AI21 和 Alice 基于 Nemotron 3.5 Super VL 进行后训练,用于威胁情报与漏洞分析,准确率提升了 41%。
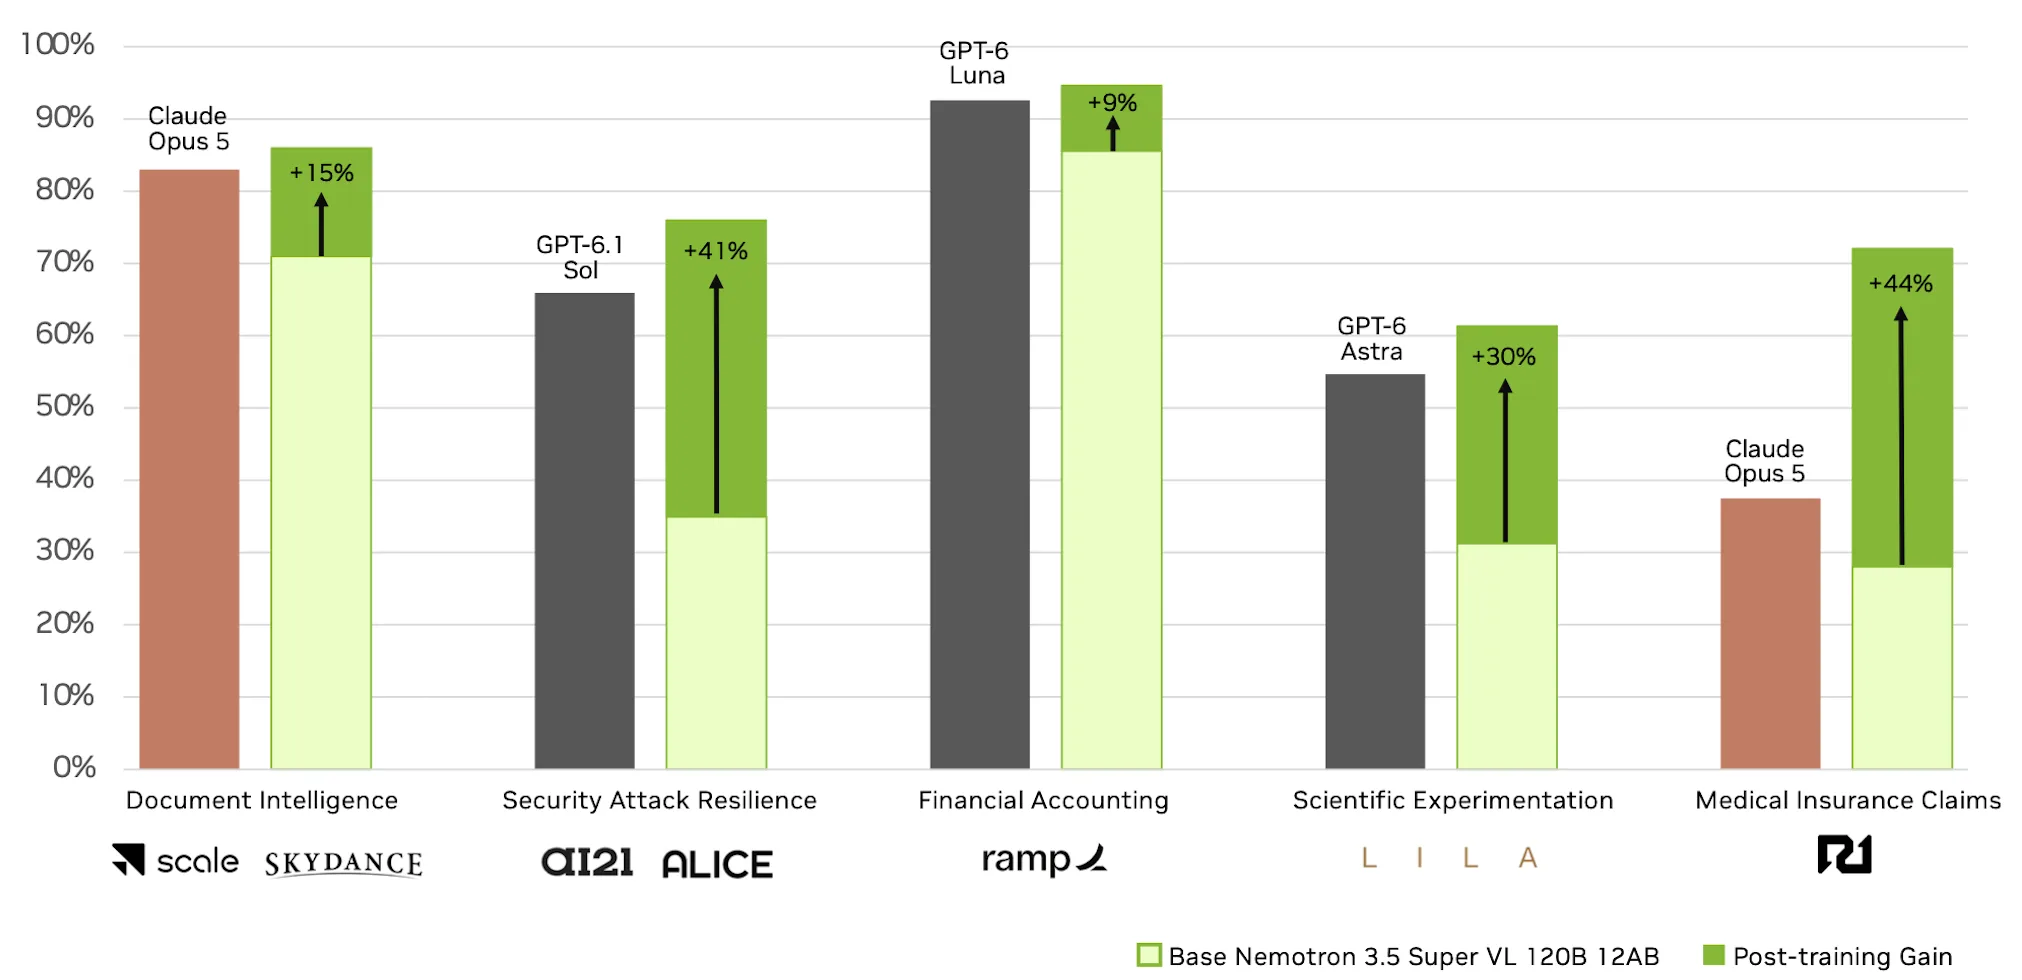
团队可以使用 NVIDIA NeMo 开源库对模型进行后训练,以满足这些需求。开发者可以借助 NVIDIA NeMo AutoModel 进行监督微调(SFT)和低秩适配(LoRA),让模型学会特定领域的行为;再通过强化学习(RL)提升模型在贴近组织实际工作流的 agentic 环境中的表现。
与 Nemotron 3.5 Super VL 一同发布的还有 NVIDIA 在 Hugging Face 上的开放数据集,涵盖 agentic 工具调用与对话数据、金融推理与工具调用数据集、指令遵循与聊天数据、长上下文转换与翻译数据、公平性数据,以及 40 个视觉语言数据集。这些数据集可作为专有数据的补充,用于 SFT 和 RL。
在多模态数据方面,可以先从 NeMo Data Designer 的资源入手,了解图表问答和长文档理解。还可以探索 NVIDIA NeMo RL 和 NVIDIA NeMo Gym,用于强化学习和基于环境的评估。
企业可以在本地、数据中心或云端等受支持的环境中适配和部署该模型的开源权重,以满足自身的基础设施和数据需求。定制化资源请参考 GitHub 上的 Nemotron 3.5 Super VL 使用手册。
在同一个工作流中融合文本与视觉理解
Nemotron 3.5 Super VL 将文本、图像、文档和视频理解能力与推理、指令遵循相结合,能够基于这些输入回答问题。
其视觉训练涵盖图表、表格、光学字符识别(OCR)、多页文档和视频理解。模型采用两阶段 SFT 流程分别训练语言和视觉组件,融合了视觉证据与推理、对话、安全、长上下文数据以及 agent 轨迹数据。
在文档智能场景中,同一个模型可以解读一张图表,将其与文档中其他位置的表格关联起来,并对两者进行总结。开发者可以根据自己的文档和评估标准定制这一工作流。
通过 NeMo Data Designer 生成的多样化训练数据,帮助模型更好地理解复杂图表。在图表推理基准 CharXiv 上,该模型得分为 80.8%,而 Nemotron 3 Nano Omni 为 63%;配合 Python 代码解释后更是达到 84%。想了解具体方法和经验教训,可以阅读图表理解深度解析以及开源图表问答流水线。
该模型的构建得到了 Nemotron Coalition 各成员组织的支持与技术协助。例如,Perplexity 提供的高质量数据集帮助改进并简化了模型的 mid-training 过程;Prime Intellect 提供的环境则助力构建出更强的教师模型。
Nemotron 3.5 Super VL 同时也是 OCRBench v2 排行榜上排名靠前的开源模型之一。
在各类 agent 任务中的准确率与效率
针对 Nemotron 3.5 Super VL 的评估覆盖 Hermes、LangChain、OpenClaw、OpenCode、Pi、Codex 和 Claude。除编码任务外,各 agent harness 提供商还会用自有的评测来测试广泛的 agent 任务。在 Hermes Bench 和 LangChain 行为评测中,Nemotron 3.5 Super VL 的得分均高于 Nemotron 3 Ultra。
| 模型 | Hermes Bench | LangChain Evals |
|---|---|---|
| Nemotron 3 Ultra | 56.33% | 84.3% |
| Nemotron 3.5 Super VL | 63.44% | 87.05% |
对于全天候运行的智能体来说,效率决定了部署能完成多少工作。吞吐量、token 用量、工具调用次数,以及得出正确结果所需的步骤数,都会影响任务的完成时间。
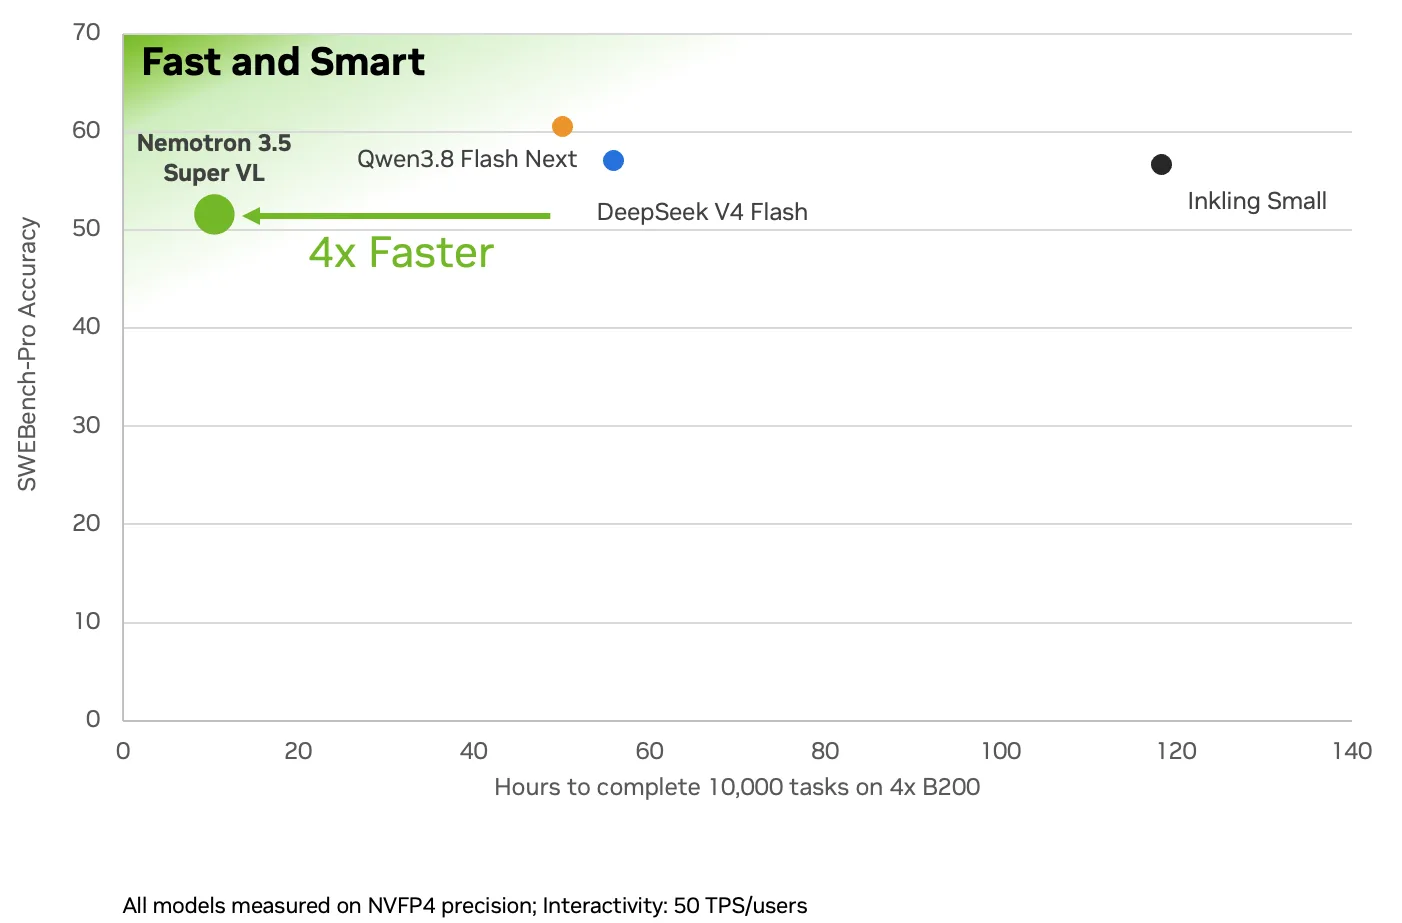
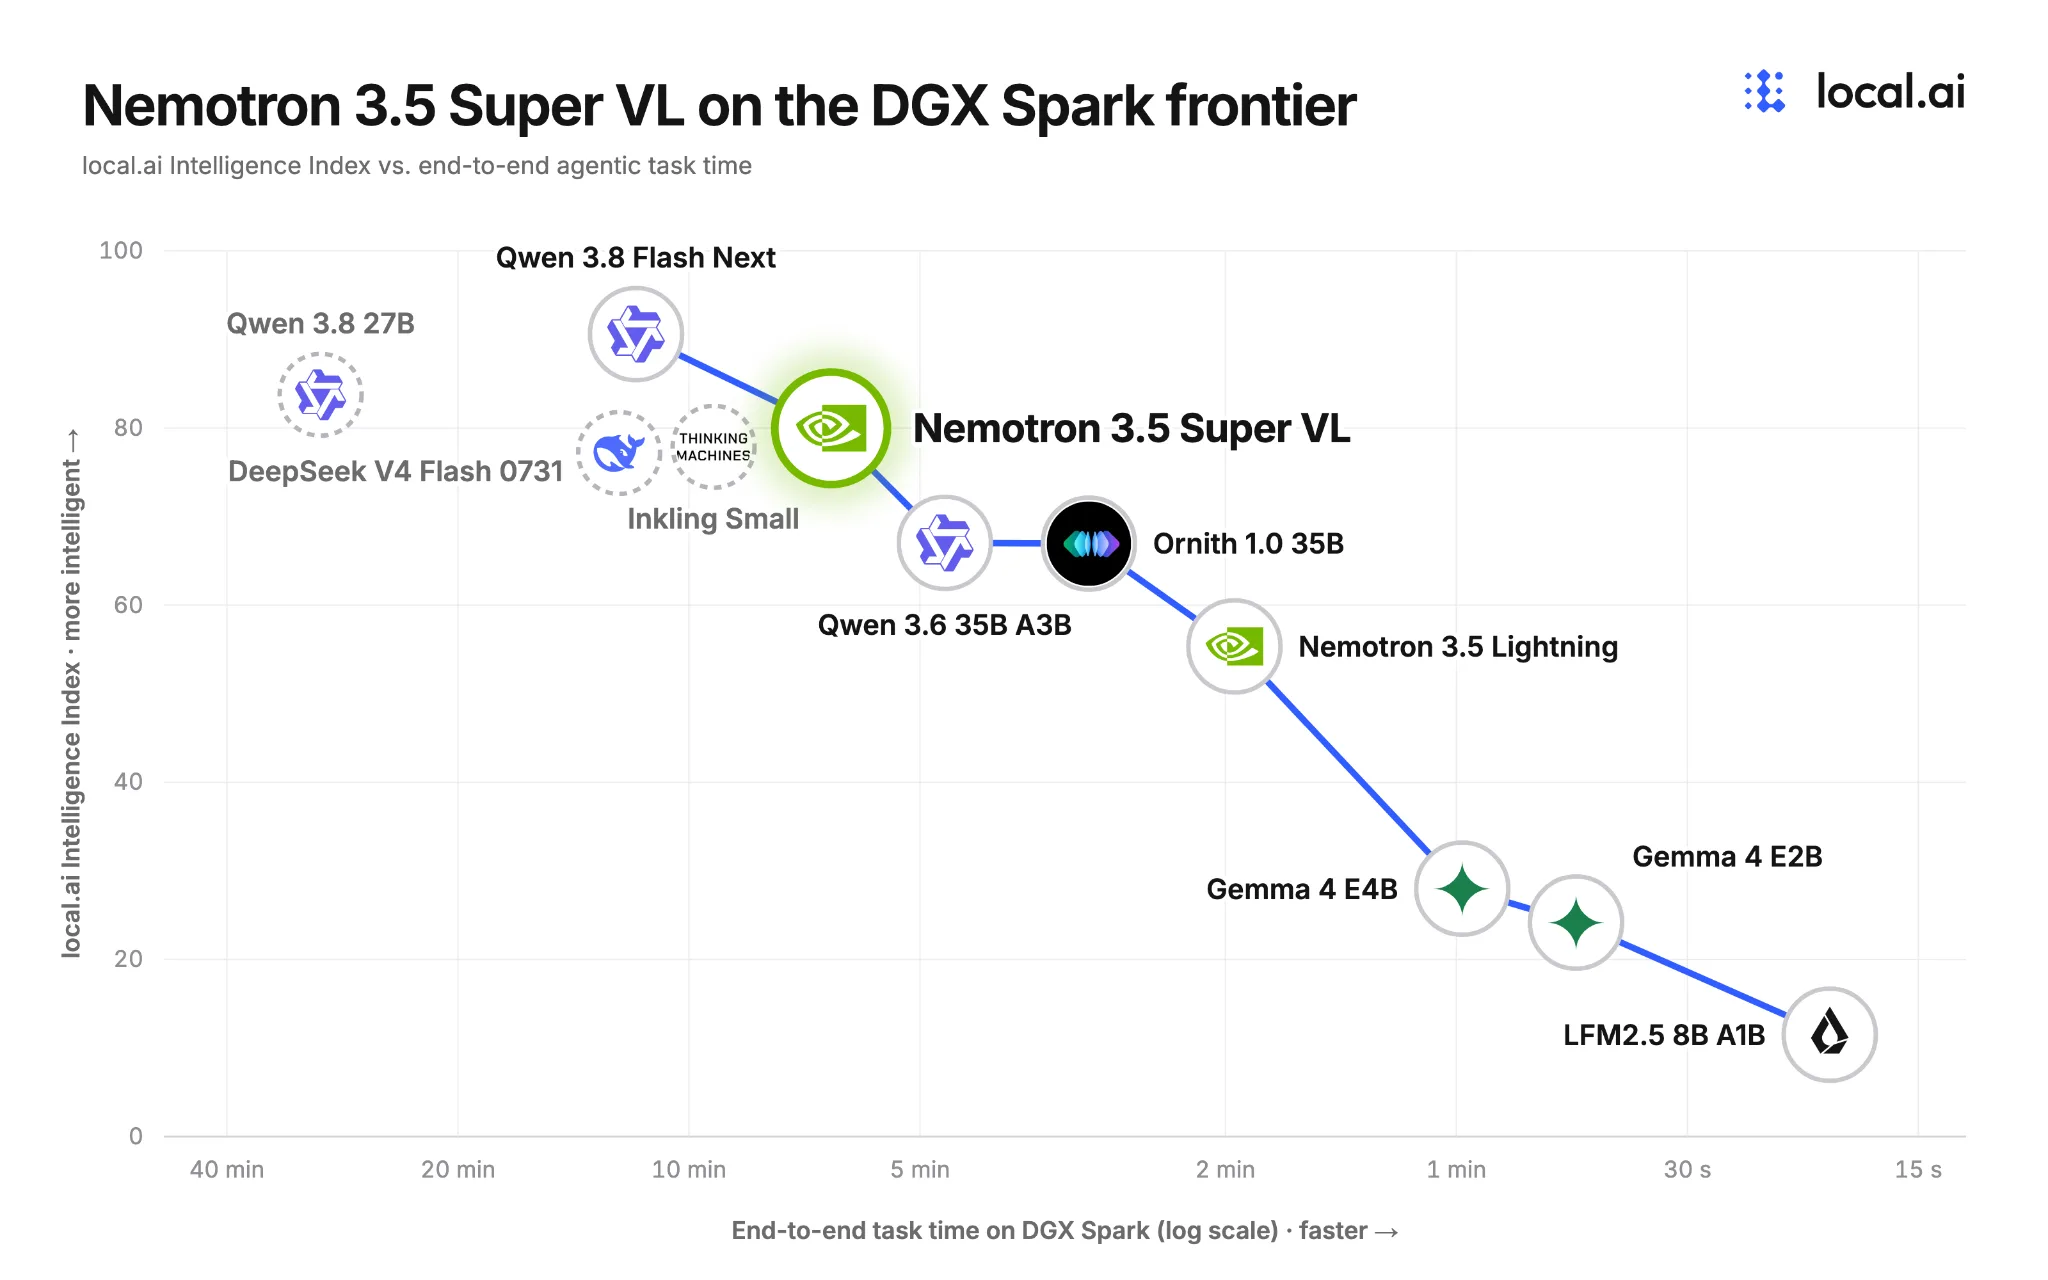
该模型还针对在 NVIDIA DGX Spark 上本地运行做了优化。EXO Labs 的独立评测显示,Nemotron 3.5 Super VL 在准确率与任务完成时间之间处于 Pareto 前沿。
Nemotron 3.5 Super VL 的内部架构
该模型建立在强大的基座之上,采用混合架构、投机解码、上下文复用和混合精度等技术,减少 Agent 反复调用带来的推理开销。
打造强大的基座模型
Nemotron 3.5 Super VL 由 Nemotron 3 Ultra 蒸馏而来。Ultra 的代码能力,加上蒸馏过程中使用的 SkewReverse 损失,共同提升了代码生成准确率。
在后训练阶段,多教师在线策略蒸馏(MOPD)融合了来自文本和视觉领域多个专业教师的指导。模型先生成回复,再由教师从视频推理与追踪、视觉工具使用以及人类对齐等维度进行打分。
在 Agent 行为、代码仓库和软件工程任务样本上的额外训练,进一步提升了模型在 Agent 任务上的表现。在多种评测设置下,Nemotron 3.5 Super VL 在 SWE-bench 和 Terminal-Bench 上都超越了 Nemotron 3 Super。
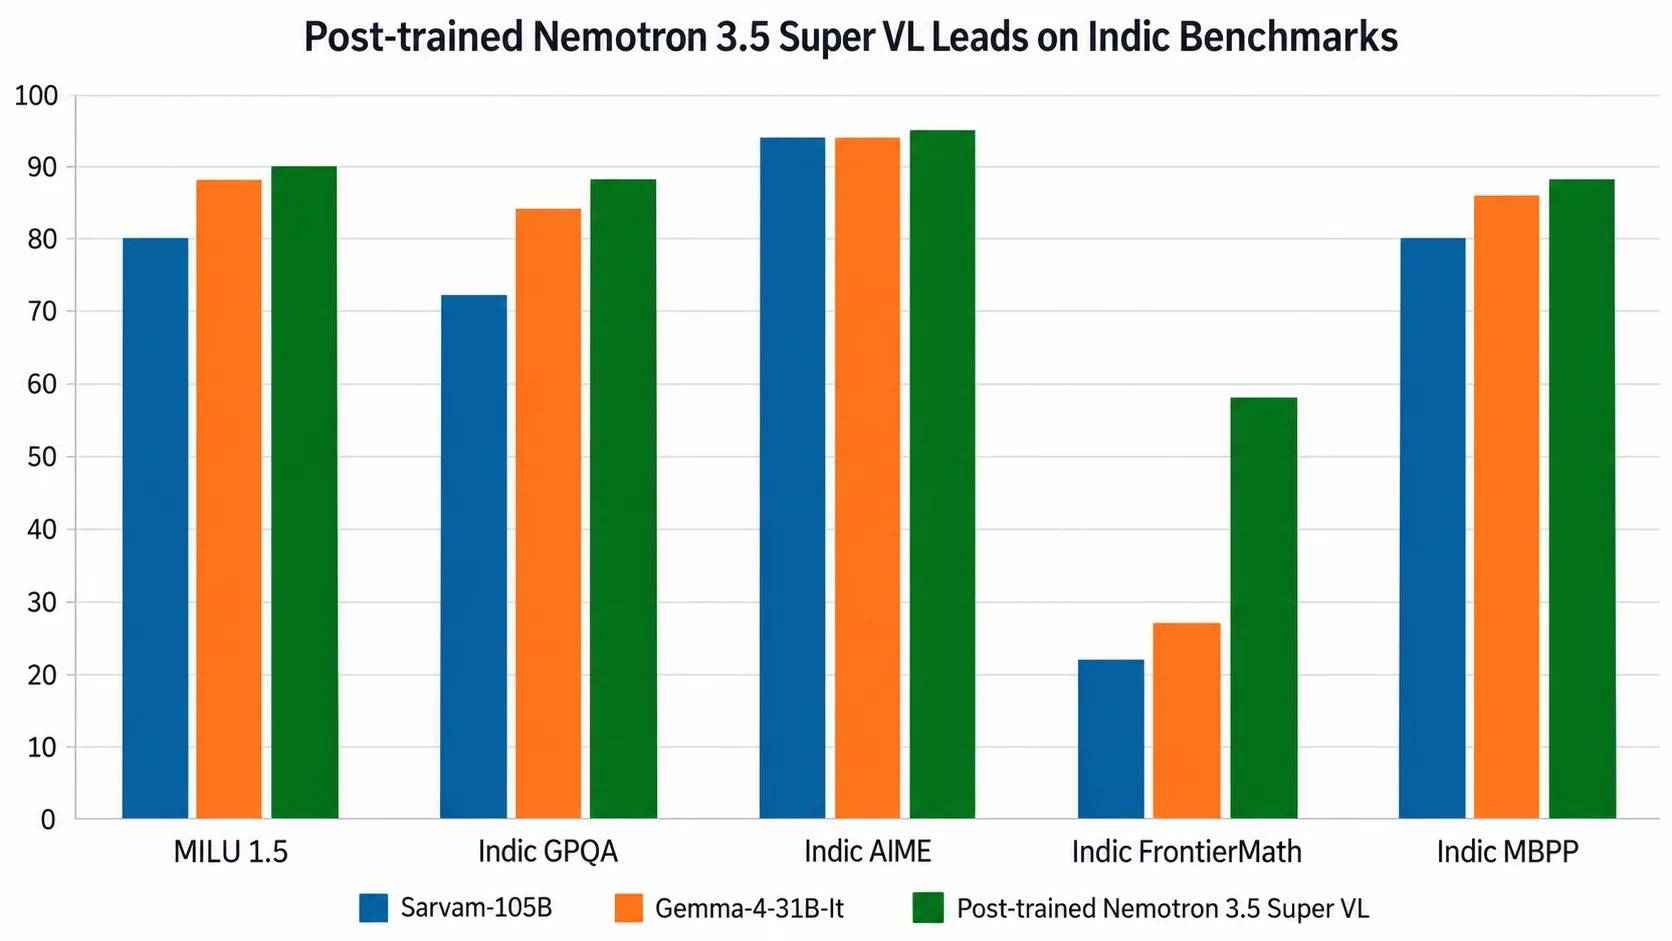
基于高质量自然数据和合成数据的持续预训练增强了印度语系语言能力,也为后训练后的整体得分提升打下基础。这一阶段新增了 10B 个印度语系 token,来自 Nemotron-pretraining-Indic-v1 的 12 种语言子集以及自然的印度语系文本。
NVIDIA 正在发布完整数据集,涵盖 22 种印度语言、约 2.8T 个 token,由 NVIDIA 与 IIT Madras 及其 AI4Bharat 实验室共同开发。以下结果均基于后训练后的 Nemotron 3.5 Super VL。
LiLiCorr:开放的投机解码技术
LiLiCorr 改进了并行投机解码:它对整份草稿中的候选 token 进行联合评估,捕捉独立 token 预测容易遗漏的依赖关系。一个轻量级网络只需一次前向计算即可得出兼容性评分,生成更连贯的草稿,最终仅剩一个开销很低的顺序选择步骤。
在 DGX Spark 上,LiLiCorr 是配合 Nemotron 3.5 Super VL 做低延迟推理时推荐的起草模型。与不做投机解码相比,token 生成速度最高可提升 2.3 倍。
NVFP4 与混合精度
该模型使用 NVIDIA Model Optimizer 进行训练后量化和量化感知蒸馏(QAD)。NVFP4 方案在 NVIDIA Blackwell 架构上采用 4 位权重和激活值。同一检查点也可以在非 Blackwell 平台上以 4 位权重加 16 位激活值运行,对敏感组件则单独选择精度。
NVFP4 让模型更小,QAD 则帮助它在更低精度下保持准确率。QAD 过程中,量化模型会学习对齐原始 BF16 模型的输出,从而缩小量化带来的精度差距。QAD 还支持用 NVFP4 而非 FP8 存储 KV cache,同时依然达到精度目标。由于 QAD 在训练阶段完成,不会增加推理开销。Multi-token prediction
Multi-token prediction(MTP)让 Nemotron 3.5 Super VL 内置一个起草器,可以一次提出多个 token,供主模型在单次前向传播中验证。一次接受多个 token,减少了生成回复所需的计算密集型验证步骤。 专门的 MTP 强化训练阶段进一步让起草器与最终模型对齐。Context reuse across agent turns
Agent 会反复把系统指令、工具定义和对话历史传回模型。Prefix caching 可以复用这些共享输入的计算结果。 该模型的服务优化同时保留了 attention 缓存和 Mamba 循环状态。额外的 Mamba 检查点减少了为 speculative decoding 恢复输入所需的重放,而内部检查点机制则避免了 prompt 处理过程中额外的模型前向传播。Simplify production deployment with NVIDIA NIM and NVIDIA Dynamo
NVIDIA NIM 将模型与优化过的推理引擎、经过验证的配置以及面向云和数据中心部署的标准 API 打包在一起。NIM 持续获得安全、功能和性能更新。企业用户可通过 NVIDIA AI Enterprise 获得支持。立即开始使用 NIM。 NVIDIA Dynamo 支持多种分布式推理优化,以提升吞吐并降低延迟,包括 KV-cache 感知路由、KV cache 管理和分离式服务(disaggregated serving)。 在 16 张 NVIDIA B200 GPU 上以每用户每秒 50 token 的速度运行时,结合会话亲和性的 KV 感知路由和 KV cache 卸载可支持多达 8 倍的用户数,同时将首 token 延迟降低 85%。开始使用 Dynamo 部署方案。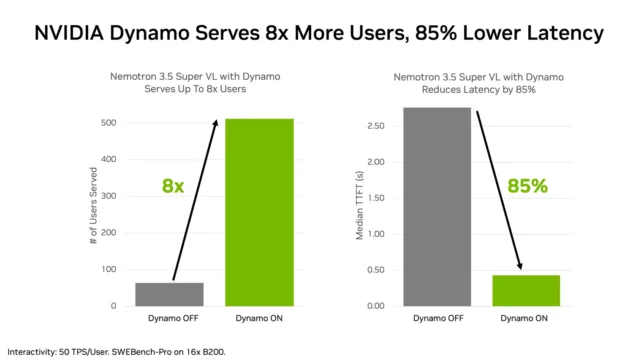
开始使用 Nemotron 3.5 Super VL
构建具备多模态推理和工具调用能力的专用 agent。针对特定工作流定制模型,然后部署到受支持的环境中。
本次发布包含 base、post-trained 以及 NVFP4 量化版本的 checkpoint,并附带了训练方案、数据和强化学习环境。
模型详情请参阅 Nemotron 3.5 技术报告,部署说明请查看 Hugging Face 或 ModelScope。如需托管模型访问,请参见 OpenRouter。
合作伙伴生态
合作伙伴为 Nemotron 3.5 Super VL 提供面向领域特定工作流的定制与部署支持。
查看合作伙伴: 后训练- AfterQuery
- AgileRL
- AI21
- Alice
- Applied Compute
- Baseten
- Bespoke Labs
- Databricks
- distil labs
- Fastino Labs
- Fireworks AI
- Handshake
- Mercor
- Mindbeam
- ms-swift
- Multiverse Computing
- Prime Intellect
- Reasonable
- River AI
- Scale AI
- Thinking Machines Lab(Tinker)
- TNG
- Trajectory
- Actual Computer
- Canonical
- Exo
- LM Studio
- Ollama
- SGLang
- Unsloth
- vLLM
- Amazon SageMaker JumpStart
- Google Cloud Gemini Enterprise Agent Platform
- MSFT Foundry
- OCI Enterprise AI
- HCLTech
- Infosys
- Tata Consultancy Services
- Dell
- HPE Services
- Red Hat