
Anthropic Scion深受Mononoke启发
前往 Hacker News 或 Lobsters 讨论。
昨天,Anthropic 描述(存档链接)了他们的版本控制系统 Scion 如何使用“派生数据”(derived data)这一概念来优化 Blame 等操作的效率:

而在 2022 年,我在 Oxide 的申请材料中曾描述过我帮助构建的版本控制服务器 Mononoke 如何使用“派生数据”概念来优化 Blame 等操作的效率:
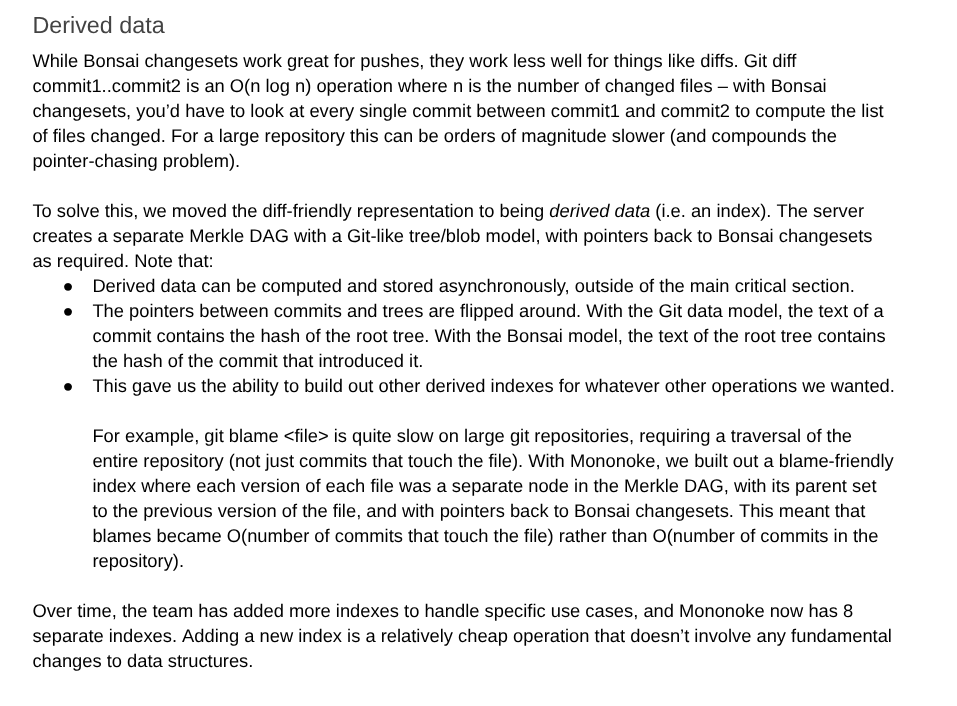
我觉得这种模仿程度已经远超“有相似洞见”的范畴了1。Sapling 只被轻描淡写地归功于“来之不易的经验”,Mononoke 更是只字未提,这几乎算是抄袭了。这篇文章给读者的印象是 Claude 设计了这一切,但现实是,我们 Meta 的这支(非常出色的)团队早在近十年前就提出了这些洞见,而 Claude 只是忠实地照搬应用。(当然,Mononoke 和 Sapling 也参考了不少前人工作,从 Google 的 SrcFS 到数据库里的 write-ahead log。)
我非常高兴,团队在 2017-18 年提出的愿景如此强大且持久——当你逆流而行时,总会对自己做的是天才之举还是疯狂之举感到些许不确定。我认为 Mononoke 的设计经受住了时间的考验。需要明确的是,Anthropic 借鉴 Mononoke 的设计并无不妥。(这正是我们开源的一部分原因——通过传播优秀思想造福人类。)
但随着 LLM 在辅助设计新系统中发挥越来越大的作用,它们很可能会大量参照现有设计。Mononoke 是开源的,并且存在于每个 LLM 的训练集中。如果你询问Opus 5.5 或 GPT-6 Astra(感谢Matthew Fowle)关于先前已有技术(prior art)的问题,它们都会立即指出与 Mononoke 的相似之处。
为先行者署名变得比以往更容易,也更为重要。不再有借口了。
关于一个具有相似洞察但在许多关键设计点上存在显著差异的系统示例,请参阅 Vicent Marti 为 Cursor 撰写的博客文章。↩︎