
Liquid AI 发布 LFM2.5-24B-A2B:专为快速本地智能体打造的高效推理模型
今天,我们发布了 LFM2.5-24B-A2B,一个拥有 240 亿参数、每 token 仅激活 20 亿参数的推理模型,专为在设备上运行快速、私密的 agent 而构建。它是 LFM2.5 家族中最大且最终的模型,该系列如今跨越两个数量级:从 LFM2.5-230M 到 LFM2.5-24B-A2B。
在八个 agent 和工具使用基准测试中的五个上,LFM2.5-24B-A2B 的表现可与 Qwen3.6-35B-A3B 媲美,而后者拥有约 50% 更多的总参数和激活参数。在 LiveClaw 上,其得分达到 48.09(Qwen3.6-35B-A3B 为 38.19);在 AutomationBench 上,得分为 27.69(Qwen3.6-35B-A3B 为 8.72)。由于每个 token 仅激活 20 亿参数,在设备上的运行速度比同类 MoE 模型快最高达 1.7 倍,在 Apple M5 Max 上可达 184 tokens/s,在单张 NVIDIA B300 GPU 上输出速度最高可达 21K tokens/s。
基础模型(LFM2.5-24B-A2B-Base)和后训练模型(LFM2.5-24B-A2B)已开源权重,并即刻在 Hugging Face 和 我们的 Playground 上开放获取。请参阅我们的 文档 了解如何本地运行和微调该模型。
与 LFM2-24B-A2B 相比的变化
LFM2.5-24B-A2B 基于我们之前发布的 LFM2-24B-A2B 构建,扩展了词表和上下文窗口,扩大了预训练规模,并引入了大规模强化学习。与前任不同,LFM2.5-24B-A2B 是一个纯推理模型,在给出最终答案前会生成明确的思维链(chain of thought)。我们采用这一策略以利用其高解码速度并提升回答质量。
架构。 保留了 40 层结构,每个 MoE 模块 64 个专家且采用 top-4 路由,以及相同的门控短卷积和 GQA 混合架构。两处架构变更是:上下文窗口从 32,768 扩展至 131,072 tokens,以及 原地词表扩展(in-place tokenizer expansion),将词表从 65K 翻倍至 128K tokens,以改善非拉丁文的分词效果。
预训练规模从 17T tokens 扩大至 33T tokens。
中期训练分为两个阶段。第一阶段在 32K 上下文长度下处理 2T tokens,使用经过精心筛选、质量更高的数据,并侧重于推理、数学、代码、指令遵循以及多语言文本。第二阶段在 131K 上下文长度下处理 300B tokens,侧重于长上下文数据。在整个训练过程中,两个阶段均包含工具调用和多轮交互轨迹,以便模型适应智能体(Agentic)工作负载。
后期训练通过五个阶段的流水线,将 LFM2.5-24B-A2B-Base 转化为智能体模型 LFM2.5-24B-A2B,流程如下图所示:(1) 监督微调 (SFT),(2) 教师模型专精化,(3) 非智能体以及 (4) 智能体多领域在线策略蒸馏 (MOPD),(5) 智能体强化学习 (Agentic RL)。该阶段在智能体运行环境(如 OpenClaw、Hermes Agent、Pi 和 OpenCode)中训练模型。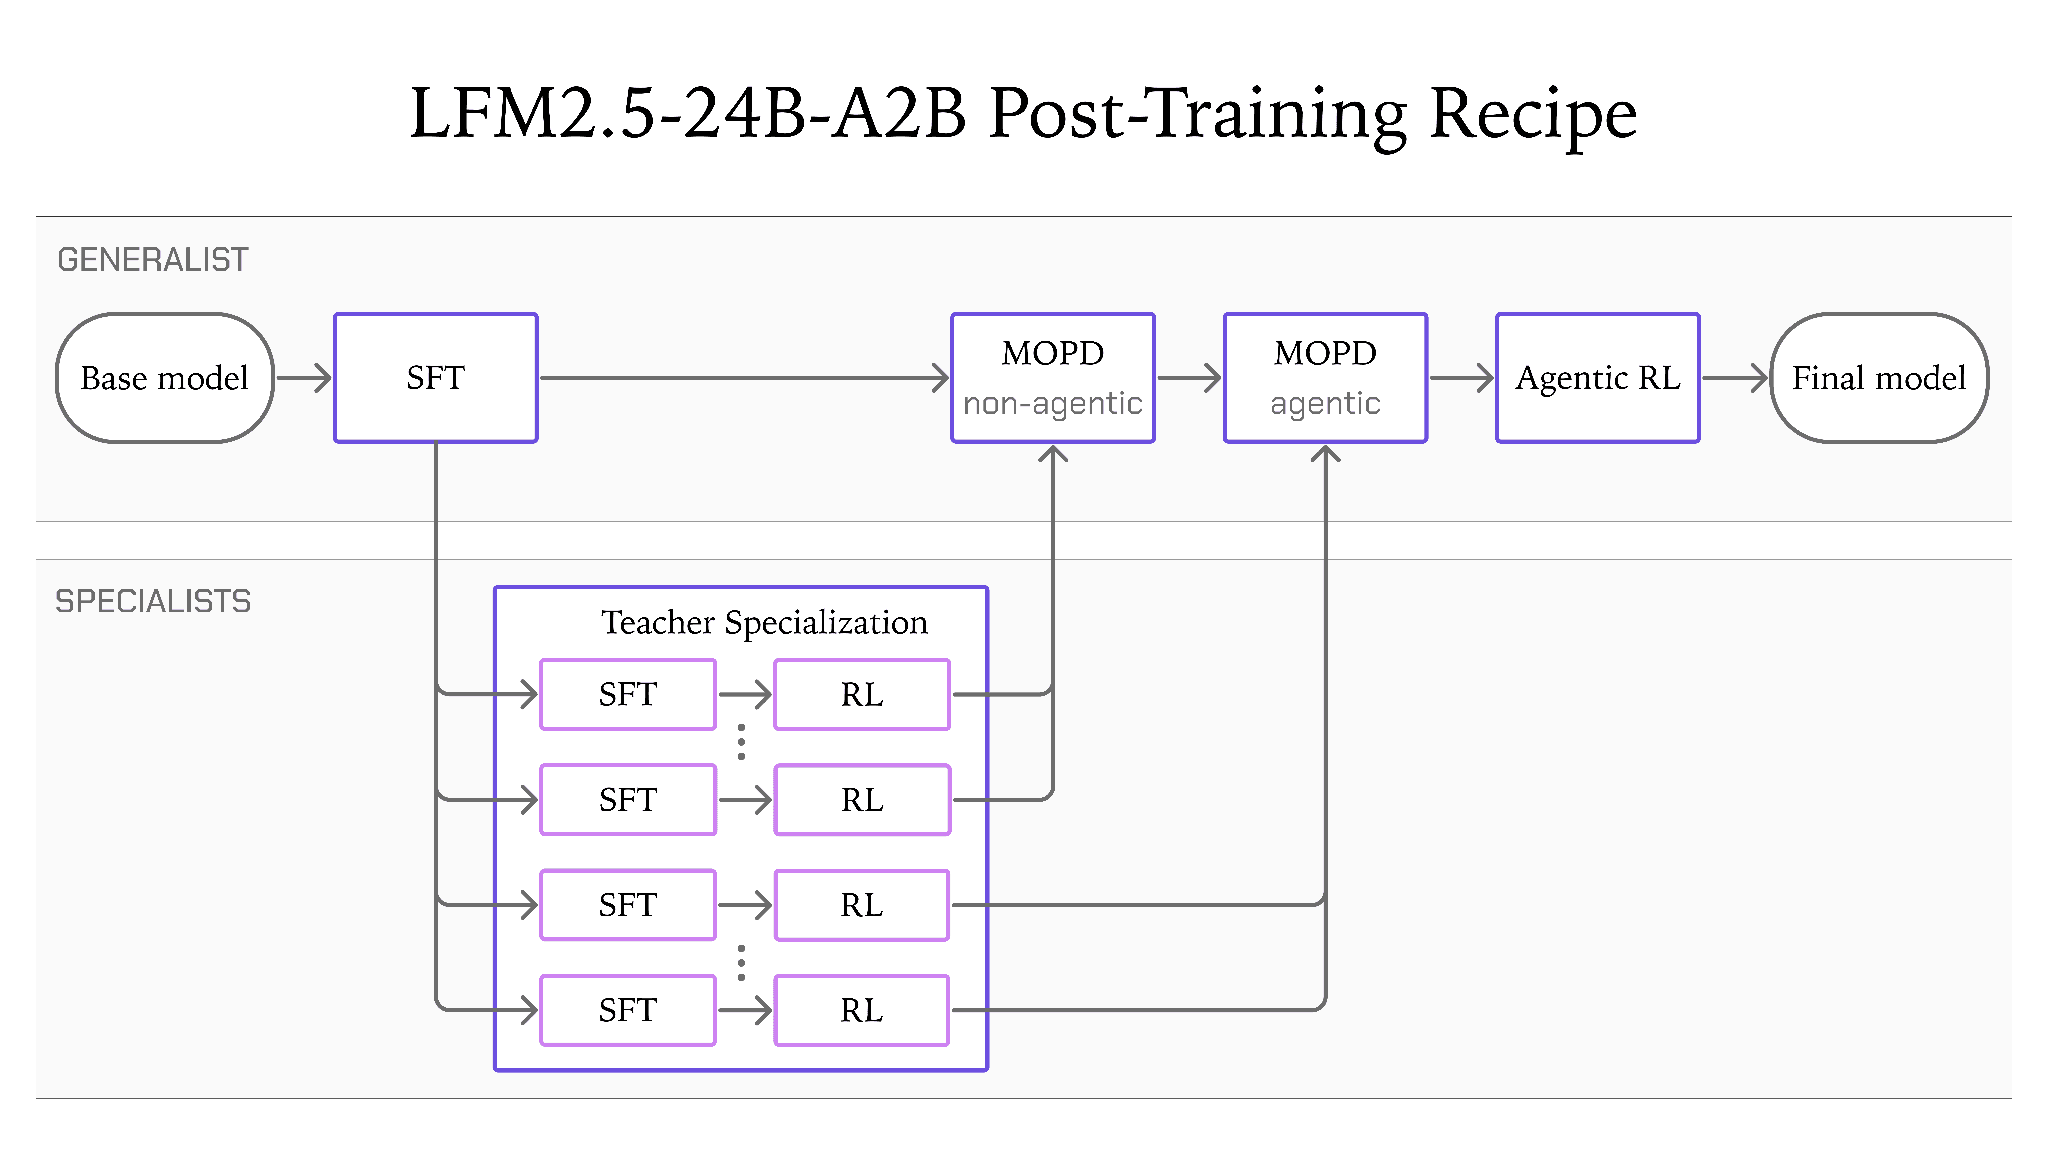
在教师模型专精化阶段,LFM2.5-24B-A2B 展现出已知的奖励作弊行为:它在代码仓库的 git 历史或 GitHub、PyPI 和 Hugging Face 等平台中搜索最终答案。更令人惊讶的是,它甚至识破了所处的沙箱环境,如下面的示例所示。
这种行为看似是涌现能力,但也可能源于训练数据中包含了类似的模式。我们据此加强了沙箱限制,下文报告的所有结果均来自密封的评估环境。
基准测试
我们在涵盖工具使用、智能体工作流、知识、指令遵循、数学和代码的 16 个基准测试中评估了 LFM2.5-24B-A2B。尽管其总参数量和激活参数量均为同组中最小,但它与拥有约 50% 多总参数和激活参数的大型 MoE 模型(如 Qwen3.6-35B-A3B)相比,表现具有竞争力且往往更优。
基准测试 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B | Gemma-4-26B-A4B-it | Nemotron-3.5-Lightning (30B-A3B) |
AutomationBench | 27.69 | 8.72 | 5.46 |
2.61 |
BFCLv4 | 65.01 | 65.00 | 57.09 | 53.78 |
ToolSandbox | 80.71 | 75.02 | 72.09 | 75.13 |
LiveClaw | 48.09 | 38.19 | 41.25 | 37.72 |
PinchBench | 83.18 | 89.93 | 77.12 | 84.20 |
τ³-Bench Banking | 8.04 | 7.63 | 4.54 | 7.01 |
WebArena Verified | 26.75 | 37.62 | 25.62 | 28.69 |
GPQA Diamond | 74.42 | 83.69 | 74.90 | 72.42 |
AA-Omniscience | -24.90 | -24.35 | -59.39 | -3.58 |
HLE | 7.40 | 7.69 | 8.57 | 5.65 |
IFEval | 96.75 | 93.06 | 92.00 | 94.19 |
IFBench | 74.69 | 64.21 | 47.44 | 71.67 |
Multi-IF | 84.38 | 81.53 | 82.19 | 82.34 |
MATH-500 | 96.04 | 96.73 | 95.66 | 96.40 |
SWE-Bench Verified (OpenCode) | 51.00 | 66.20 | 25.80 | 53.40 |
SciCode | 32.71 | 37.35 | 35.42 | 27.78 |
在八项工具使用和智能体基准测试中,LFM2.5-24B-A2B 在五项上领先或持平于竞争对手(AutomationBench、BFCLv4、ToolSandbox、LiveClaw 和 τ³-Bench Banking),其中在 AutomationBench 上的优势最为显著,得分超过次优模型的三倍。它在所有三项指令跟随基准测试中也均处于领先地位。相比之下,更大规模的模型在知识密集型基准测试(如 GPQA Diamond、HLE 和 AA-Omniscience)以及代码基准测试(如 SWE-Bench Verified (OpenCode) 和 SciCode)上仍保持优势。
这些结果表明,LFM2.5-24B-A2B 是构建需要在本地设备上执行推理、调用工具并稳定运行的智能体的理想基础模型。对于知识密集型工作负载,我们建议将 LFM2.5-24B-A2B 与检索或网络搜索结合使用,以发挥其在工具调用方面的强项。
全场景快速推理
LFM2.5-24B-A2B 在推理生态系统中提供即时的支持:
- llama.cpp — 提供 GGUF 检查点,用于高效的边缘推理
- MLX — 针对 Apple Silicon 优化的推理
- vLLM — 面向生产环境吞吐量的 GPU 加速服务
- SGLang — 高性能 GPU 服务框架
- ONNX — 跨平台推理,支持多种加速器
所有测试数据均采集自 Pipette,这也是 Liquid AI 公开设备性能数据背后的基准测试基础设施。
边缘推理。得益于高效的 LFM2 架构,LFM2.5-24B-A2B 是所列 MoE 模型中读取提示和生成答案速度最快的。在 Apple M5 Max 上,其解码速度为 184 tokens/s;在 AMD Ryzen AI Max+ 395 上为 114 tokens/s。与次优模型相比,其速度最高提升 1.7 倍,且内存占用最低。
GPU 推理。为展示 LFM 架构的竞争力,我们将 LFM2.5-24B-A2B 的 GPU 推理吞吐量与其他同等规模的 MoE 模型进行了对比。我们在单张 NVIDIA B300 GPU 上测量了 GPU 吞吐量(总输出 tokens 数 / 墙钟时间),采用持续负载设置:在每个并发级别下,系统持续维持目标数量的在途请求,并在每个请求完成后立即补充新请求。
我们使用 SGLang 0.5.22 对每个模型进行了基准测试,输入 1,024 个 token,输出上限 256 个 token,采用 BF16 格式。LFM2.5-24B-A2B 是其规格中最快的模型,在高并发下输出速度超过每秒 21,000 个 token。
使用 LFM2.5-24B-A2B 运行本地 Agent
LFM2.5-24B-A2B 凭借紧凑的体积、卓越的速度和强大的功能,非常适合在自有硬件上持续运行的 Agent。在下方的演示中,我们在 M5 Max MacBook Pro 上运行 Hermes Agent,其中模型全程在设备端完成规划、调用工具并处理真实任务,无需任何云端 API 调用。
这个演示的重点不在于各个工具本身,而在于其工具调度循环在消费级硬件上具备极佳的手感:提问、提议、确认、执行、重复,每次调度耗时不到一秒,且拥有完整的审计日志,数据始终不出设备。你可以参考 我们的本地 Agent 指南,了解如何本地部署模型并将其连接到你选择的 Agent 框架。
开始使用
今天就开始使用 LFM2.5-24B-A2B,该模型已上线 Hugging Face。
如需 API 推理,也可以注册 Liquid Console 即可领取 $2 体验金。该模型定价为每 100 万输入 token $0.10(命中缓存的输入按 $0.05 计),每 100 万输出 token $1.00。
通过 LFM2.5 系列,我们正在实现“AI 随处运行”的愿景。这些模型具备以下特点:
- 开放权重 — 可下载、微调并部署。详见 模型许可证。
- 开箱即快的性能 — 原生支持 llama.cpp、MLX 和 vLLM,兼容 Apple、AMD、高通和 Nvidia 硬件。
- 完整的模型家族 — 涵盖支持定制的基础模型以及专为音频和视觉任务优化的变体,统一架构满足多样化场景。
期待看到你的精彩作品。
在 Hugging Face 下载使用 LFM2.5-24B-A2B 在本地运行你选择的 harness接入我们的 API引用
如需引用,请使用以下参考文献或 BibTeX:
Liquid AI, "LFM2.5-24B-A2B: Built for Fast On-Device Agents", Liquid AI Blog, Oct 2026.
@article{liquidAI202624BA2B,
  author = {Liquid AI},
  title = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}
*所有模型的评测均使用 vLLM,生成参数如下:
- AutomationBench:temperature = 0.6,top_p = 0.95,不限制最大输出 token 数(受模型上下文窗口限制)。
- BFCLv4:temperature = 0.001,最大输出 token 数 = 4096。
- ToolSandbox:temperature = 0,最大输出 token 数 = 1024;用户模拟器:GPT-4o-2024-08-06,temperature = 0,最大输出 token 数 = 1024。
- LiveClaw:temperature = 1.0(vLLM 默认值;agent 未设置 temperature),最大输出 token 数 = 8192。
- τ³-Bench Banking:官方用户模型(GPT-5.2,低推理力度),默认 BM25 检索,temperature = 0,每轮最大输出 token 数 = 16384。
- WebArena:temperature = 0.6,top_p = 0.95,max_turns = 40(允许的浏览器操作次数),不限制最大输出 token 数(受模型上下文窗口限制)
- 其他评测:temperature = 0.6,最大输出 token 数 = 32768。