
解析 Intel 的 EMIB 与 Foveros 先进封装路线图
先进封装技术已成为高端 CPU 和 GPU 设计的重要组成部分,Intel 几乎所有高性能客户端及数据中心 CPU 都依赖于其嵌入式多芯片互连桥(Embedded Multi-die Interconnect Bridge,EMIB)和 Foveros 技术。那么,这两种先进封装方法接下来会如何演进?在预测它们未来走向之前,先回顾一下当前的现状。
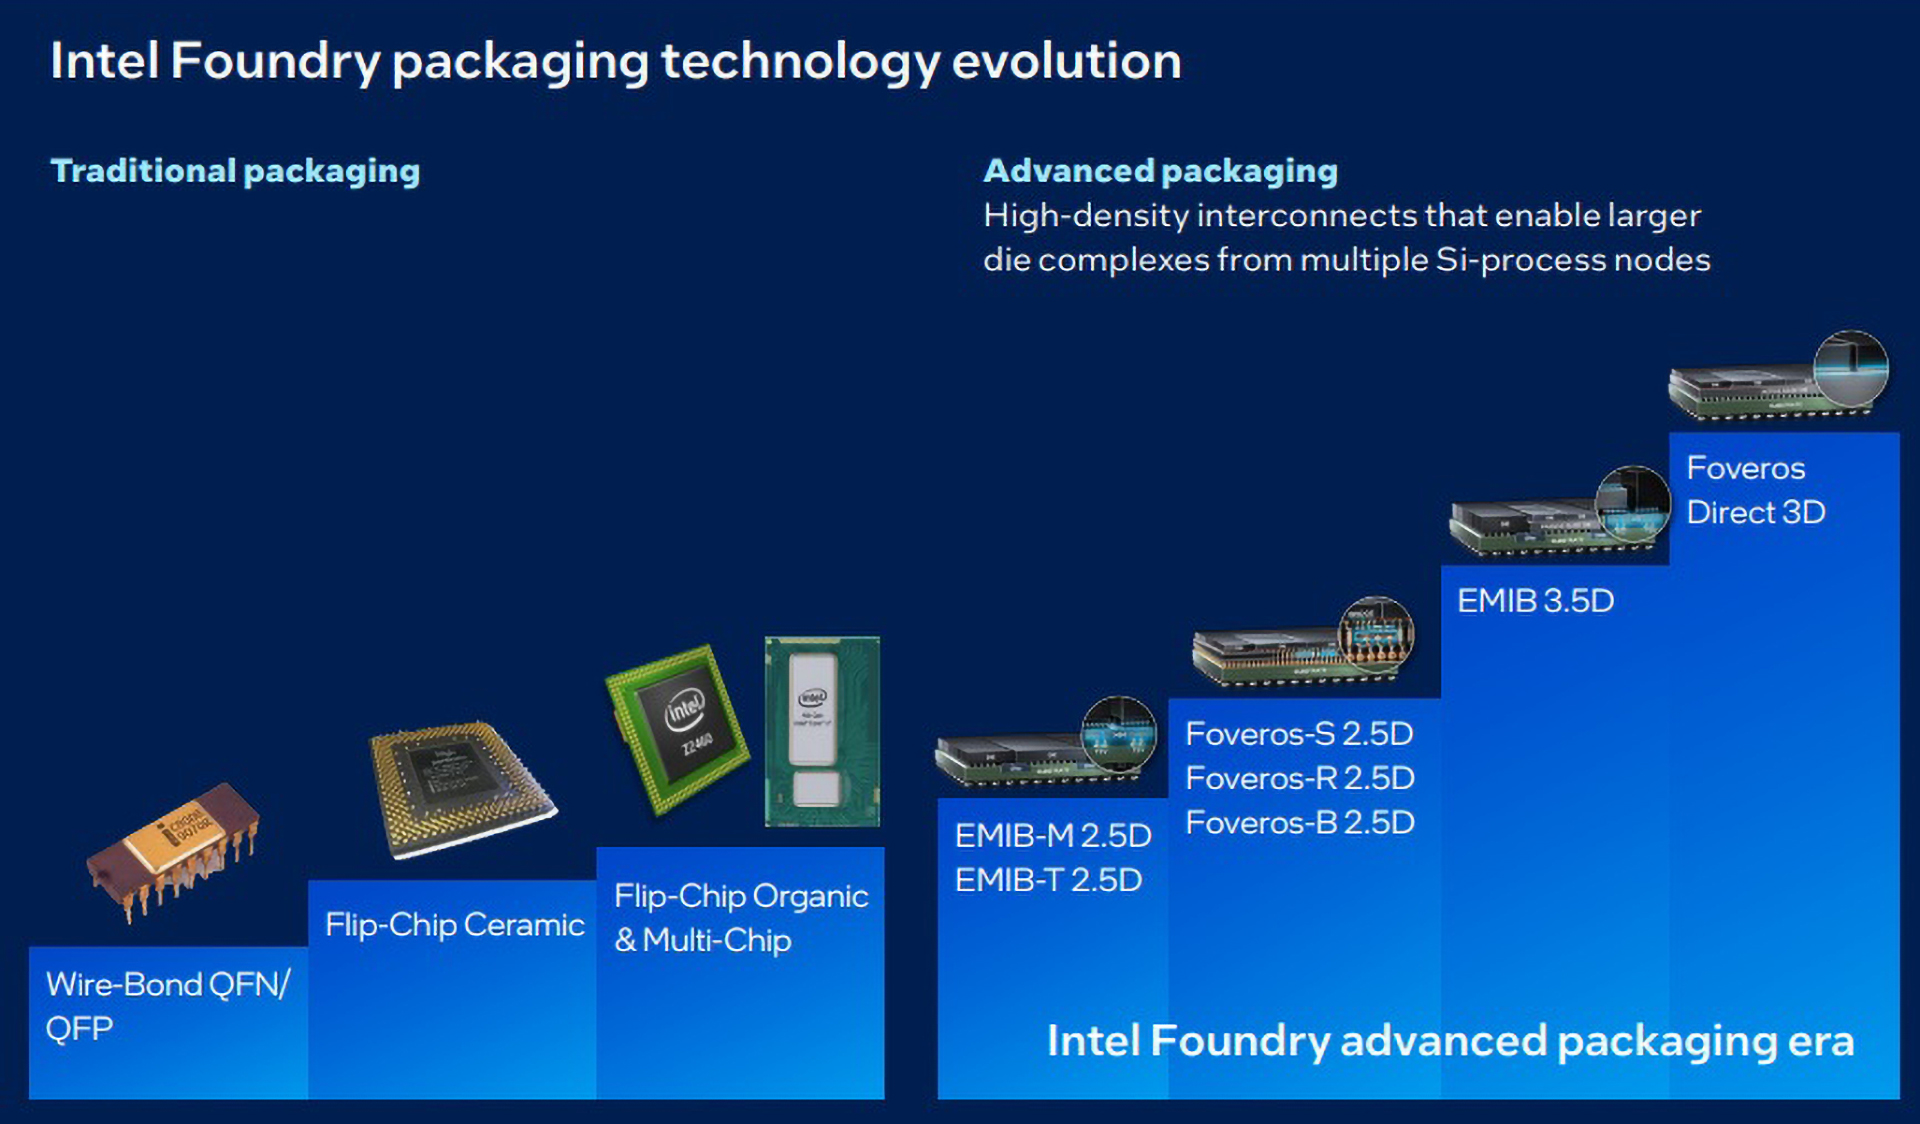
虽然 Intel 的先进封装故事始于 2017 年的 Kaby Lake-G CPU 和 Stratix 10 FPGA,但当时先进封装技术还远不如今天这般热门。然而,Intel 及其同行一直在不懈推动技术发展,因此 Intel 是最早于 2020 年公布多芯片处理器详细发展路线图的公司之一,该路线图涉及 2.5D 和 3D 集成技术——即 EMIB 和 Foveros。在最初 10nm 工艺遭遇挫折后,公司明确表示,多芯片策略是以可预测的周期和经济高效的方式提升性能与功能特性的可持续途径。尽管我们确实不能断言 Intel 的多芯片项目全都取得了成功,但可以肯定的是,近年来 Intel 推出的大部分客户端及数据中心 CPU 产品都采用了多芯片架构,并依赖 EMIB 和 Foveros 先进封装技术。
实际上,随着 Intel 先进封装路线图的演进,EMIB 和 Foveros 不仅变得更精密以应对高端需求,同时也变得更简单以覆盖成本敏感的产品。这对封装组合的另一个特点是,它们不再像是两种基本独立的技术,而是常常相互配合,并与 Intel 未来的制程技术相辅相成,成为其未来产品的关键构建模块。最终目标是结合 EMIB 和 Foveros Direct 3D,打造出相当于 12 个光罩面积的 SiP(系统级封装),但 Intel 还没走到那一步,所以我们先来看看现状以及即将到来的进展。
Intel 的 EMIB 自 2017 年进入大规模量产以来已经发生了巨大变化。它最初只是一种相对简单的方法,无需使用昂贵的硅中介层就能连接相邻的 chiplet,如今已发展成为一项精密的封装技术,不仅用于数据中心处理器,还将用于支持 12 倍光罩面积的大型 AI 加速器——配备数十个硅桥、超过 24 组 HBM 堆栈以及先进供电方案。
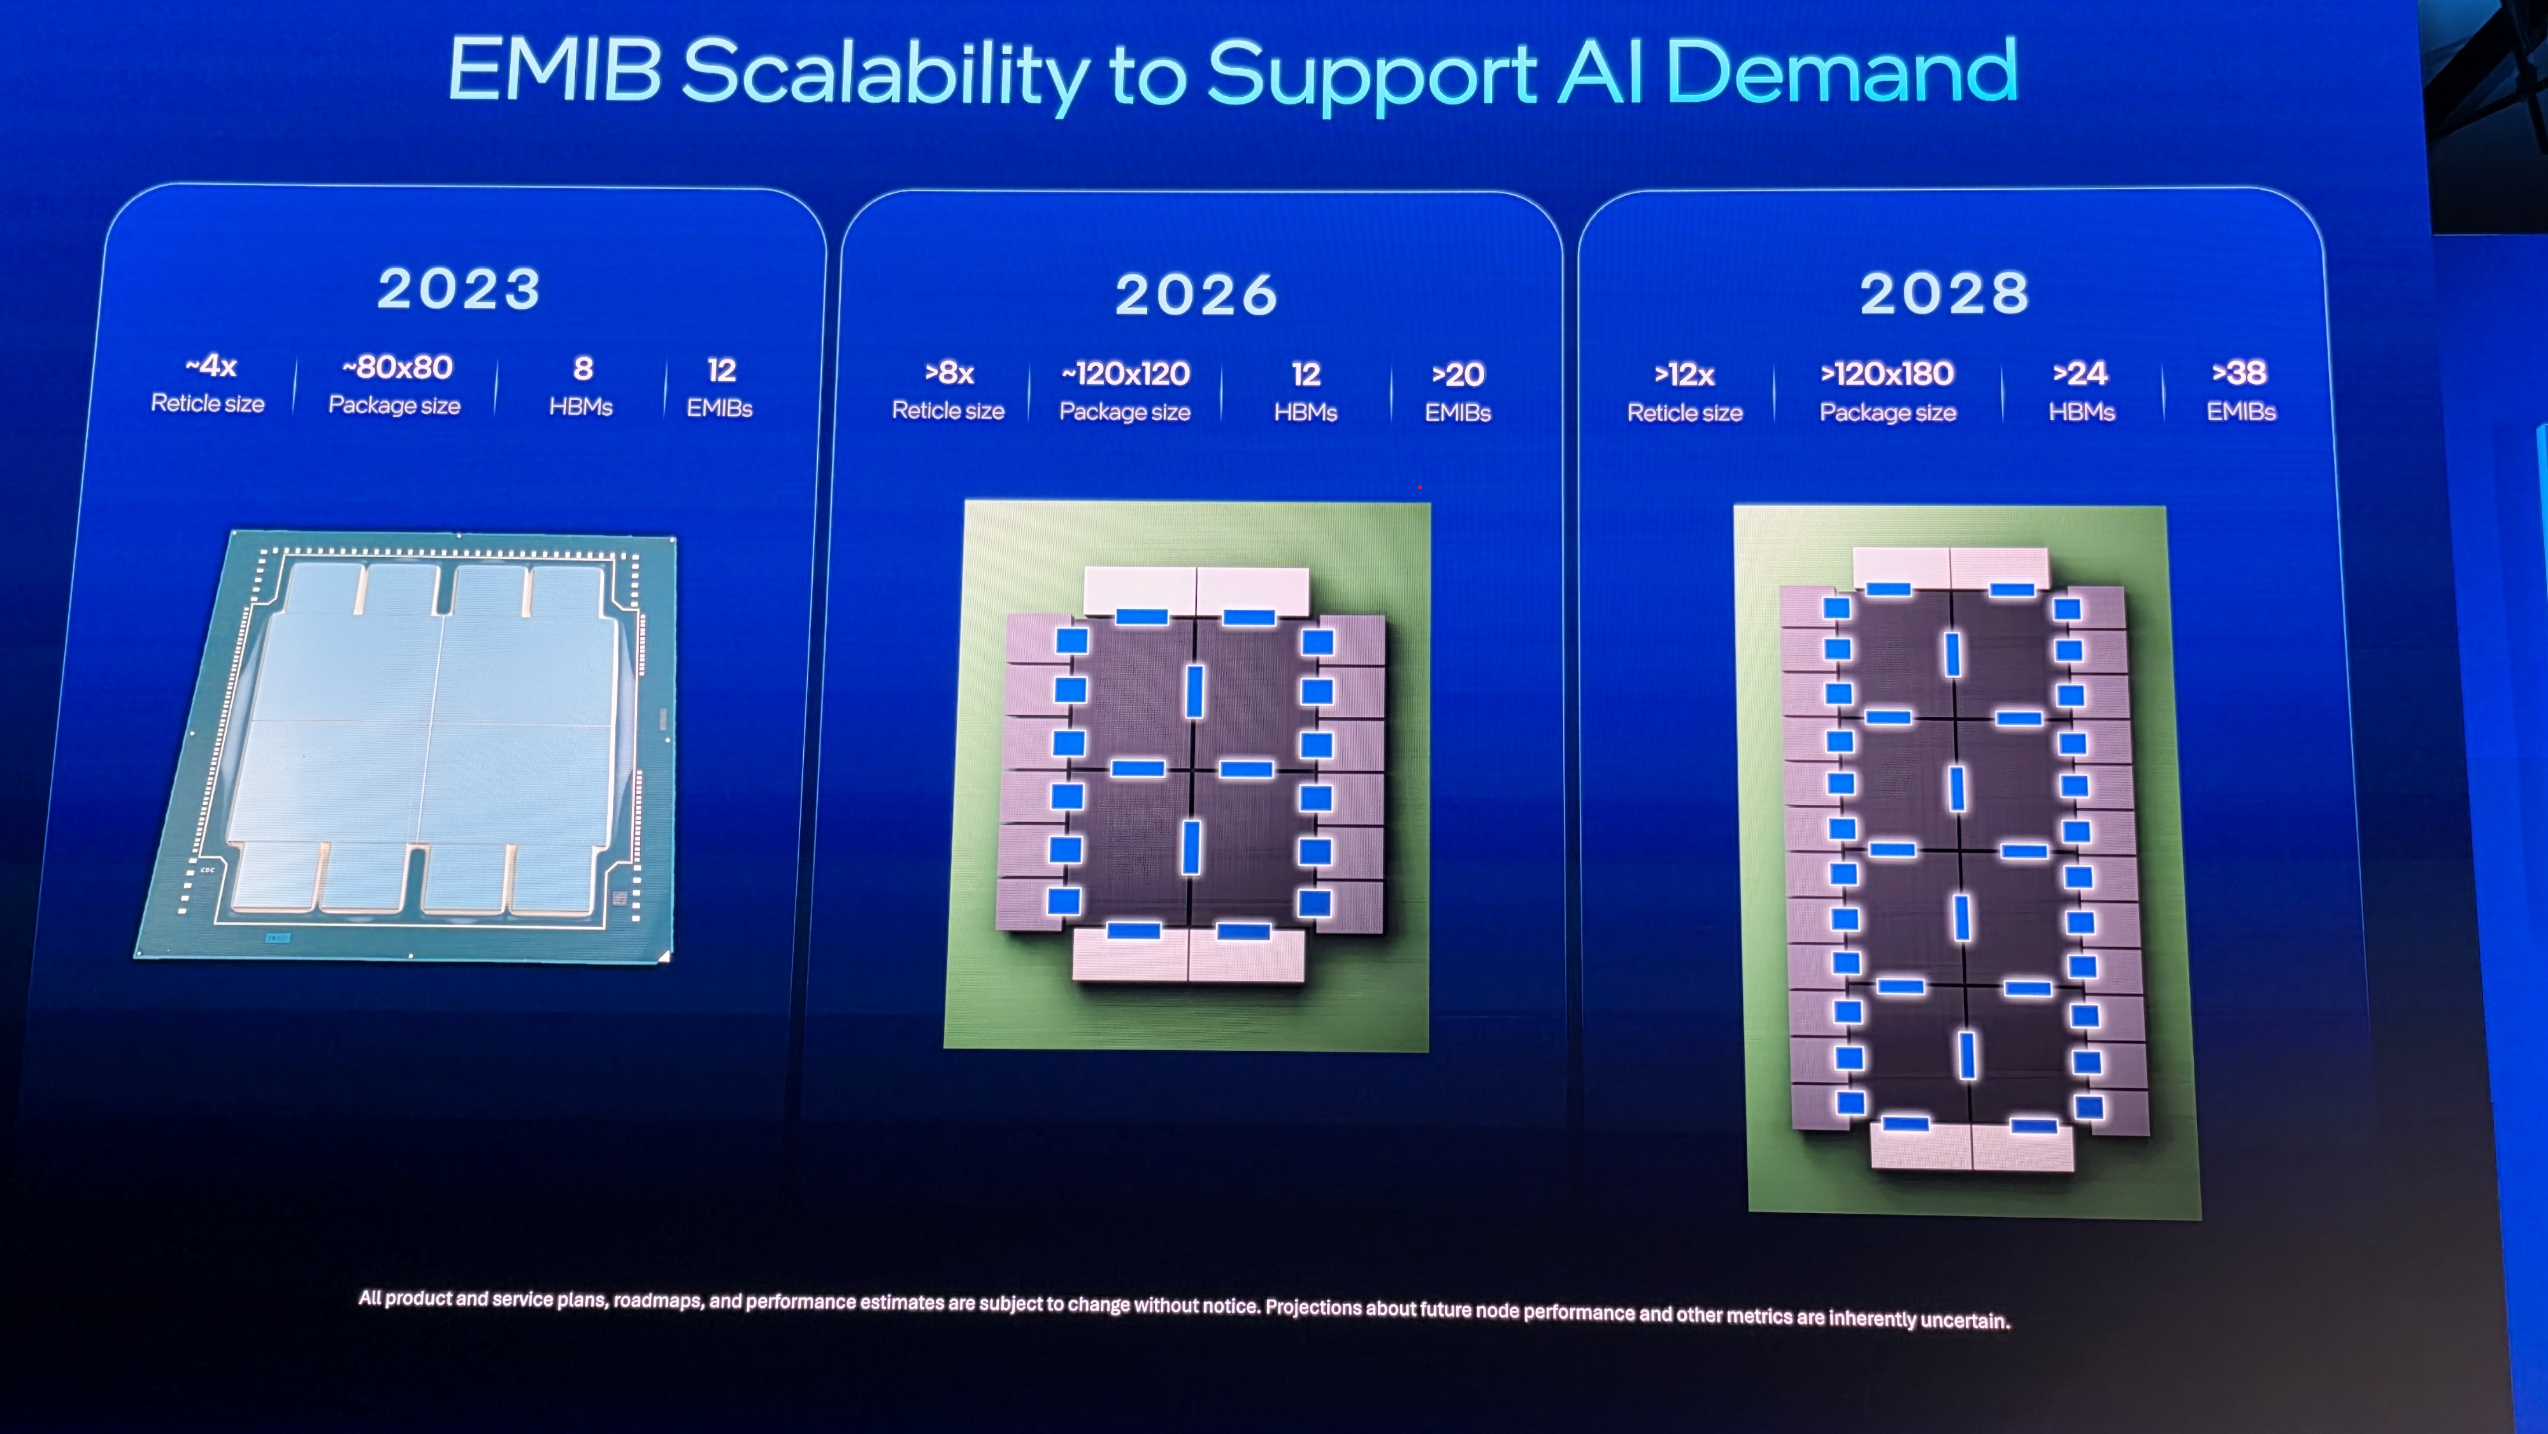
EMIB 诞生近十年,其基本理念始终未变:Intel 不再把计算和内存 die 放在大型硅中介层上,而是只在需要高密度 die 间互连的地方,将微小的硅桥嵌入有机封装基板中(试着找出那些硅桥!)。这样既减少了硅材料的用量,又让封装的其余部分可以使用传统的基板布线和较宽松的 bump 间距。早期 EMIB 采用 55 µm 的第一层互连(FLI)bump 间距,随后 Intel 将其降至 45 µm。Intel 最近的路线图显示,这一间距将进一步缩小到 36 µm 左右,最终达到 25 µm,从而大幅提升 chiplet 边缘可容纳的连接数量(即 shoreline 密度)。
除了缩小 FLI 凸点间距和提升互连密度外,英特尔还在桥接芯片上增加了功能。EMIB-M 在桥接芯片中集成了金属-绝缘体-金属(MIM)电容器,以改善供电并抑制计算裸片附近的电压波动。更新的 EMIB-T 进一步引入了硅通孔(TSV),使电力可以垂直穿过桥接芯片,无需绕行更长的路径。对于多千瓦级的系统级封装(SiP)和 HBM4 级内存子系统而言,电流密度和电源完整性都是主要封装约束,因此这一改进变得愈发关键。 Swipe to scroll horizontally| Row 0 - Cell 0 | EMIB 第一代 |
EMIB 第二代 |
EMIB-M |
EMIB-T |
EMIB-T evo |
EMIB-T 玻璃基 |
凸点间距 |
55 µm |
45 µm |
45 µm ~ 36 µm |
45 µm ~ 36 µm |
25 µm |
<25 µm |
桥接芯片数量 |
6 |
12 |
>20 |
>38 |
? |
? |
凸点密度 |
330 mm^2 |
494 mm^2 |
494 => 772 mm^2 |
494 => 772 mm^2 |
1600 mm^2 |
1600 mm^2 |
C2C 功耗 |
0.5 pJ/bit |
0.3 - 0.5 pJ/bit |
0.25 pJ/bit |
0.25 pJ/bit |
? |
? |
TSV |
- |
- |
- |
+ |
+ |
+ |
裸片规模 |
2X reticles |
4X reticles |
8X reticles |
12X reticles |
? |
panel |
HBM 堆叠 |
4 |
8 |
12 |
24 |
? |
? |
电容 |
- |
- |
MIM |
MIM |
MIM (?) |
MIM (?) |
基板 |
有机材料 |
有机材料 |
有机材料 |
有机材料 |
有机材料 |
玻璃 |
封装尺寸(毫米) |
50 × 50 |
80 × 80 |
120 × 120 |
120 × 180 |
? |
240 × 240 (?) |
年份 |
2017 - 2023 |
2023 |
2024 - 2026 |
2028 |
? |
2030+ |
这类 SiP 结构不仅复杂,而且物理体积庞大。因此,英特尔的 EMIB 技术不断演进,以支持更大尺寸的设计。首先,更精细的 FLI 间距提升了对构建大型 SiP 所需的互连密度的要求。其次,EMIB-M 解决了大型处理器带来的电源完整性问题,例如英特尔的 Xeon 6 "Granite Rapids"。再次,EMIB-T 简化了电源布线,降低了阻抗,并减少了噪声。随着 UCIe 的高速版本(32 GT/s 及以上)逐渐普及,这一点将变得愈发重要。英特尔在 EMIB 技术上的持续研发,使该公司得以从本世纪初 80×80 mm 封装的 4 倍光罩面积 SiP,过渡到如今 120×120 mm 封装中接近 8 倍光罩面积的 SiP,未来还将支持更大尺寸的 12 倍光罩面积 SiP,并置于 120×180 mm 封装中。
长远来看,英特尔计划将更小间距的 EMIB 技术与玻璃芯基板相结合。与有机材料相比,玻璃具有更佳的稳定性,并能减少翘曲,这对封装尺寸急剧膨胀尤为重要。玻璃很可能成为 EMIB 的最大技术突破之一,因为它将在性能和尺寸等多个方向带来提升。
```
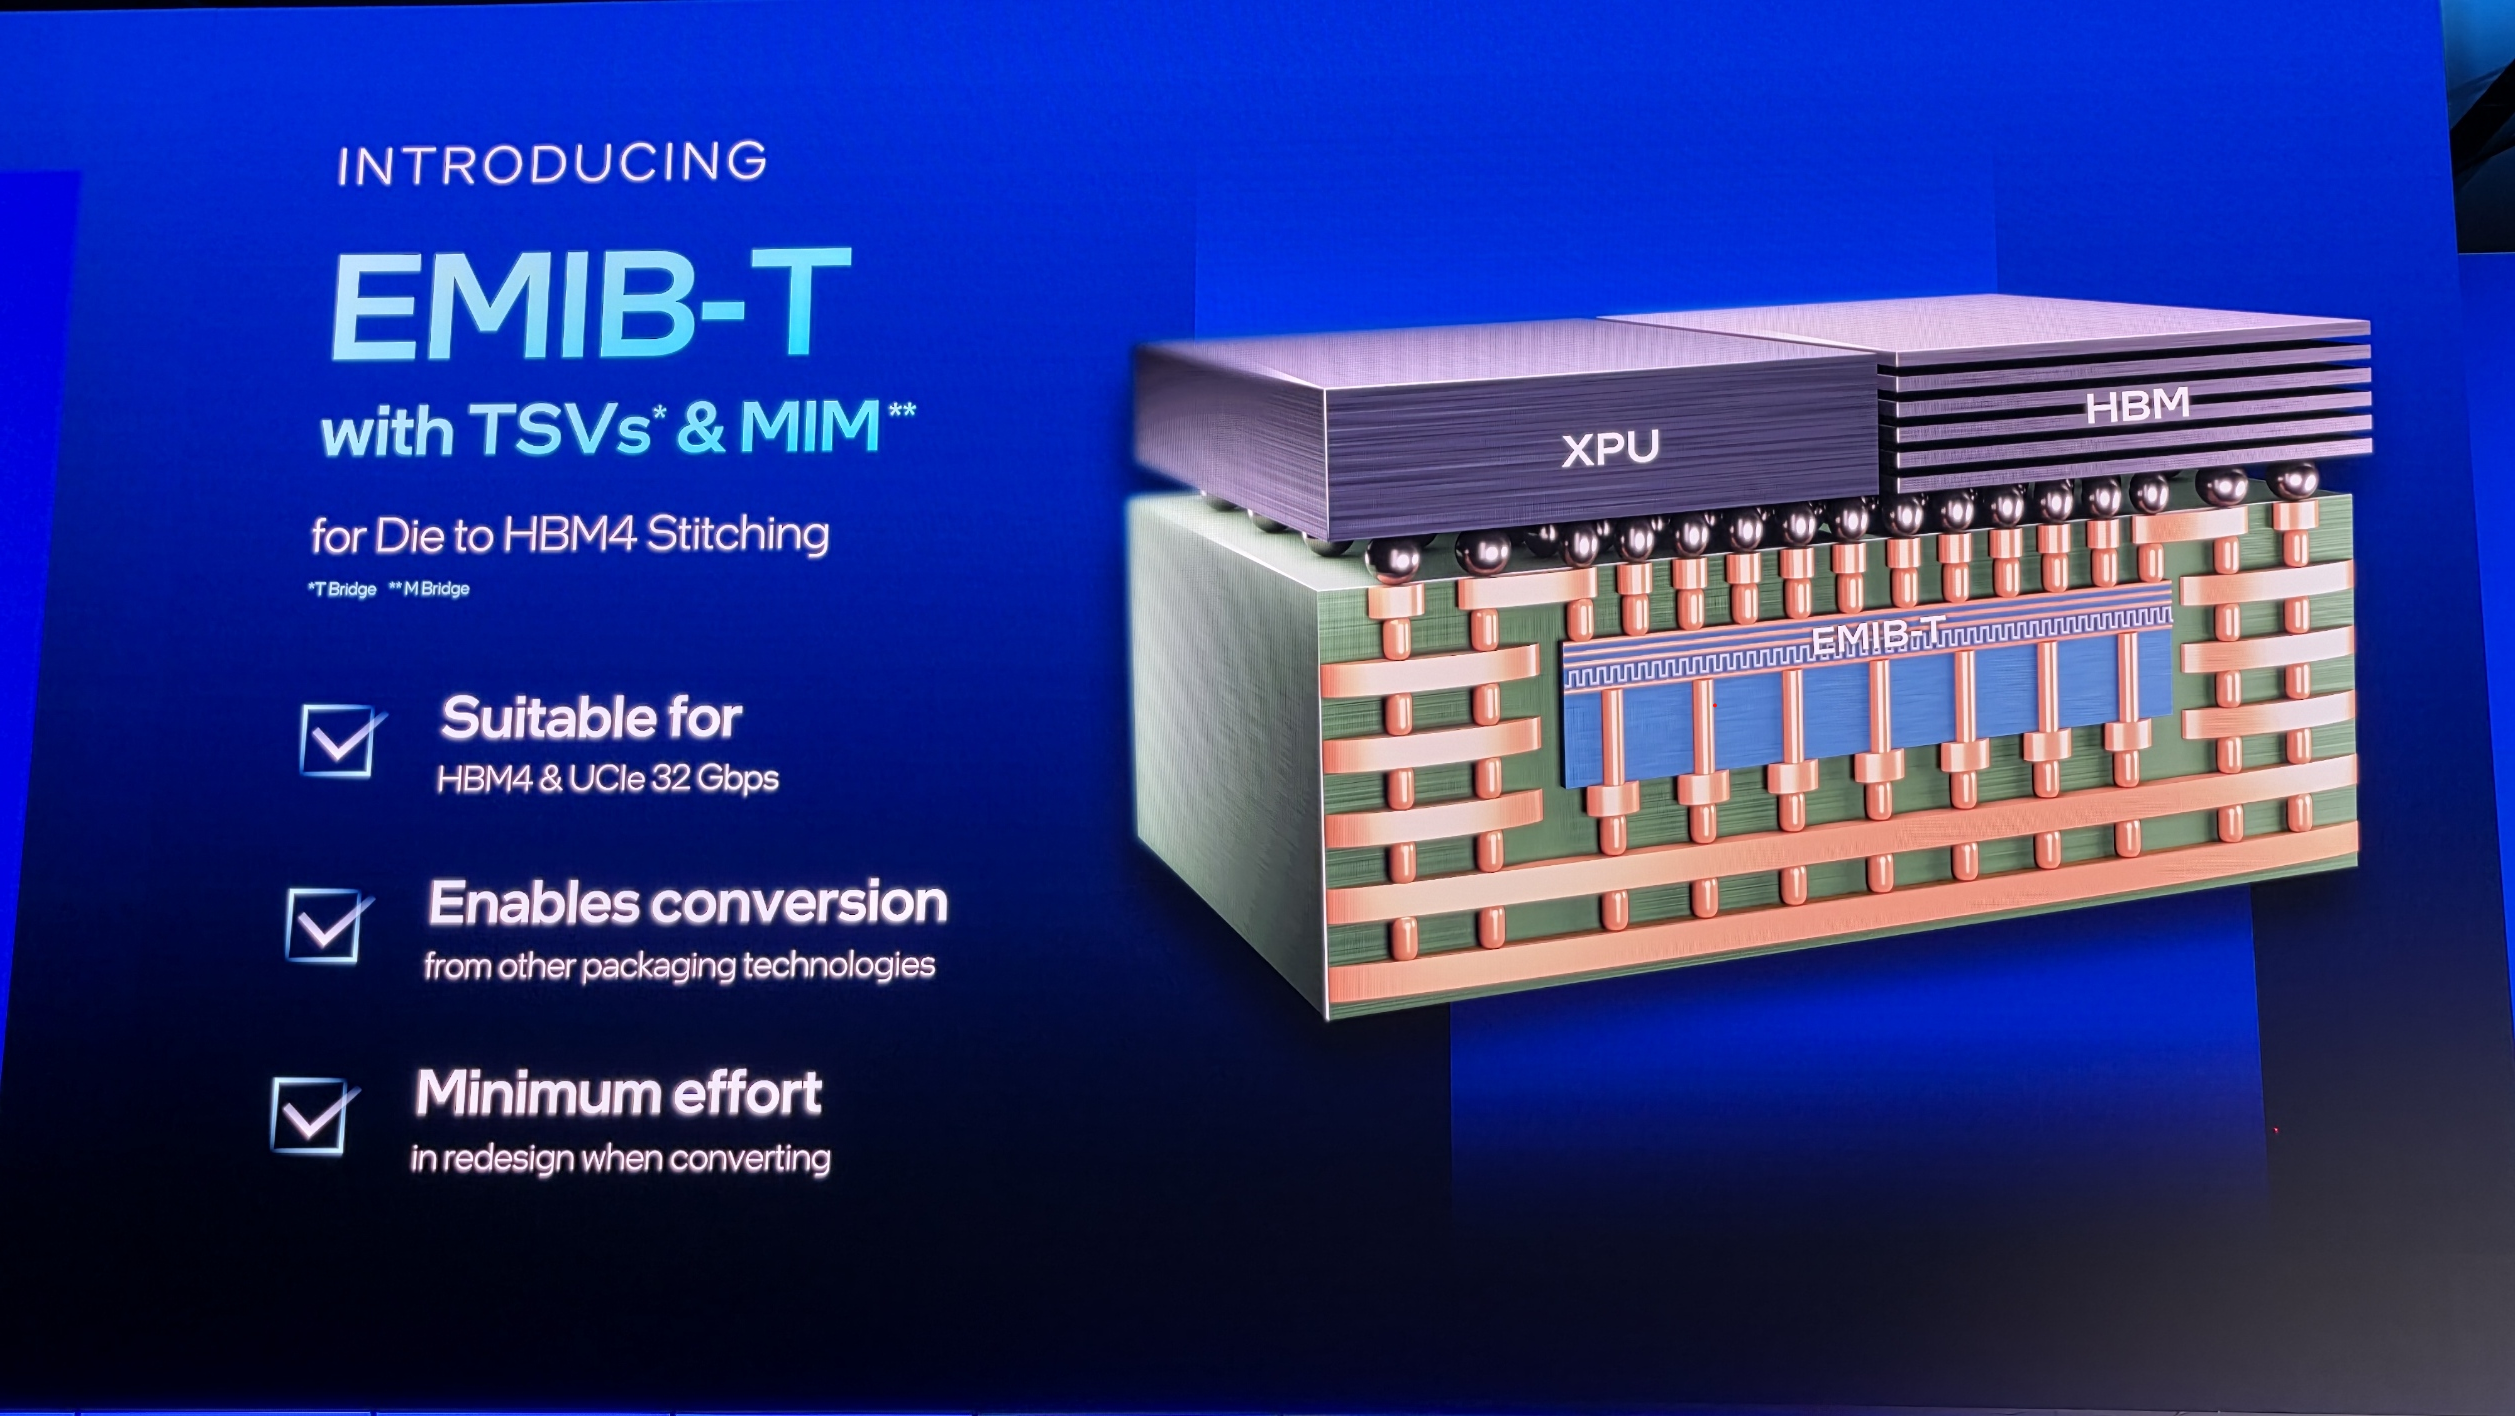
Intel 表示,EMIB-T 正按计划在 2027 年实现量产,良率和可靠性均达到目标。如果一切顺利,EMIB 将从硅中介层的替代方案,逐步成长为 Intel Foundry 打造大规模 AI 系统的关键技术之一。
“客户对 EMIB-T 的兴趣持续高涨——这项技术极具吸引力,能够为先进 AI 芯片方案提供当前主流产品无法实现的能力,”Intel 首席执行官 Lip Bu Tan 在 2026 年 8 月的财报电话会议上表示,“EMIB-T 的订单积压不断增长,良率和可靠性均已达标,我们正专注于将该技术提升到大规模、高质量量产,以支持客户在 2027 年的产品放量。”
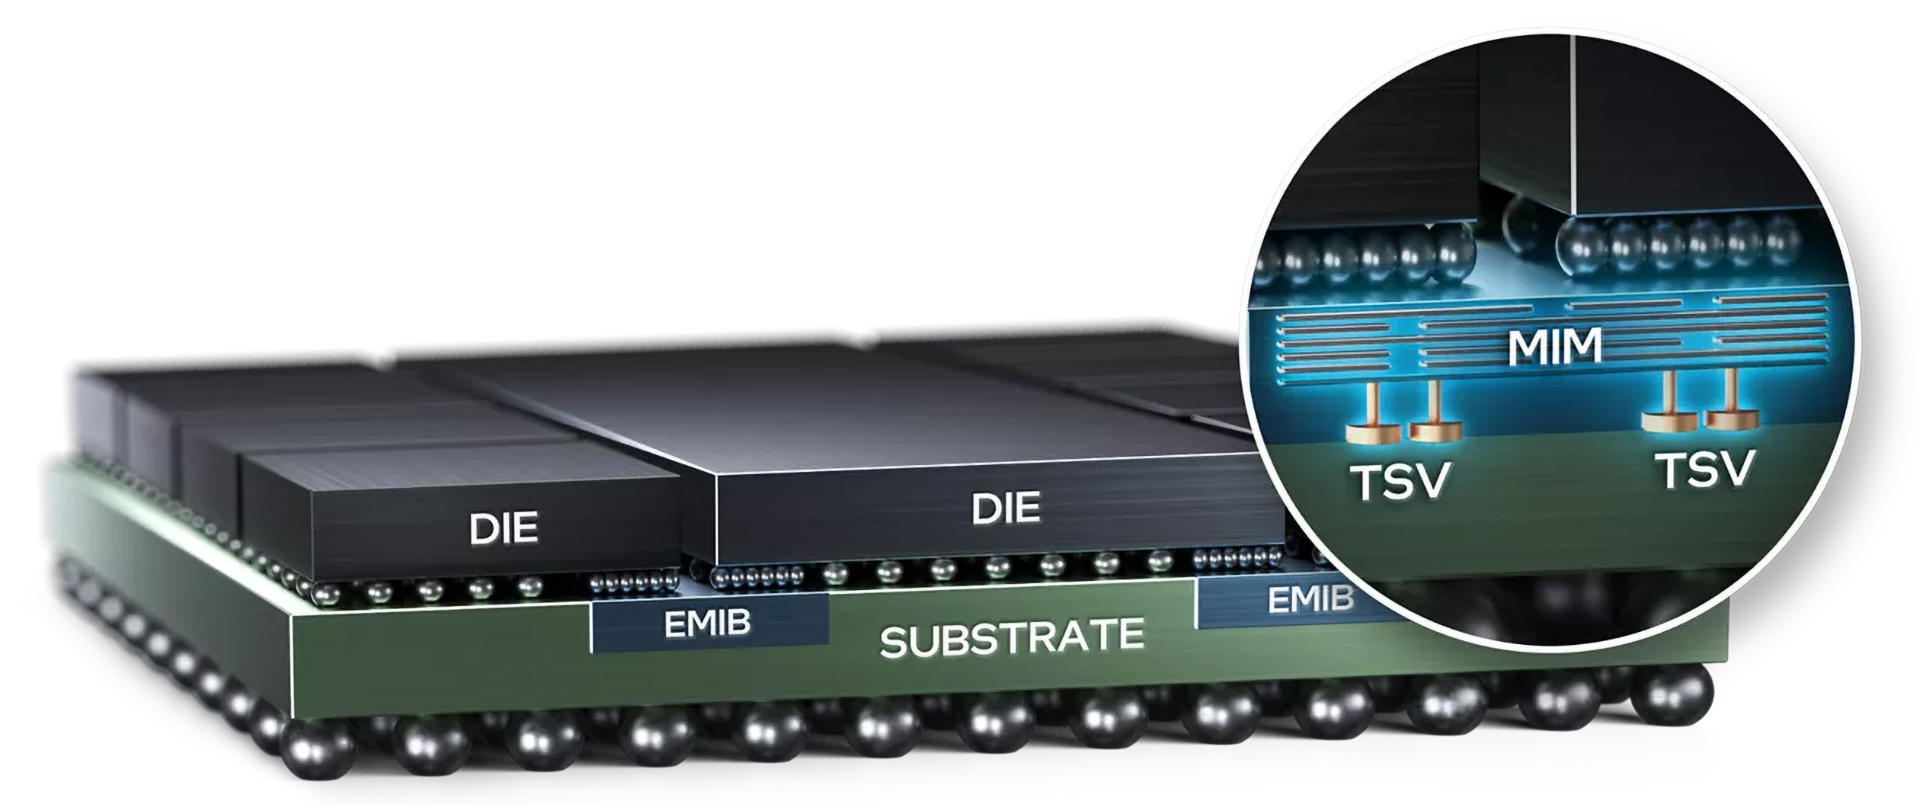
Intel 正在多个方向同时扩展 EMIB 的能力:更精细的互连间距、更多桥接、更大的基板、更高密度的供电、更快的内存接口,以及规模大幅提升的 SiP。Intel 将 EMIB 定位为一种高性价比的先进封装技术:在有机基板中通过局部硅桥实现逻辑芯片之间以及逻辑芯片与 HBM 之间的连接,而不需要像 TSMC CoWoS-S 那样使用大面积硅中介层。同时,有些应用更适合大型刚性中介层或柔性有机重布线层中介层。为覆盖这些场景,Intel 的 Foveros 产品线包含 Foveros-S、Foveros-R 和 Foveros-B,分别对应 TSMC 的 CoWoS-S、CoWoS-R 和 CoWoS-L 封装技术。
Foveros 2.5D:丰富的封装方案
Intel 的 Foveros 封装技术最早于 2019 年随 Lakefield 处理器以芯片叠层的形式问世,如今已发展成一个覆盖 2.5D 和 3D 集成的技术家族,应用范围从成本敏感的客户端处理器一直延伸到大型 HPC 和 AI 系统。
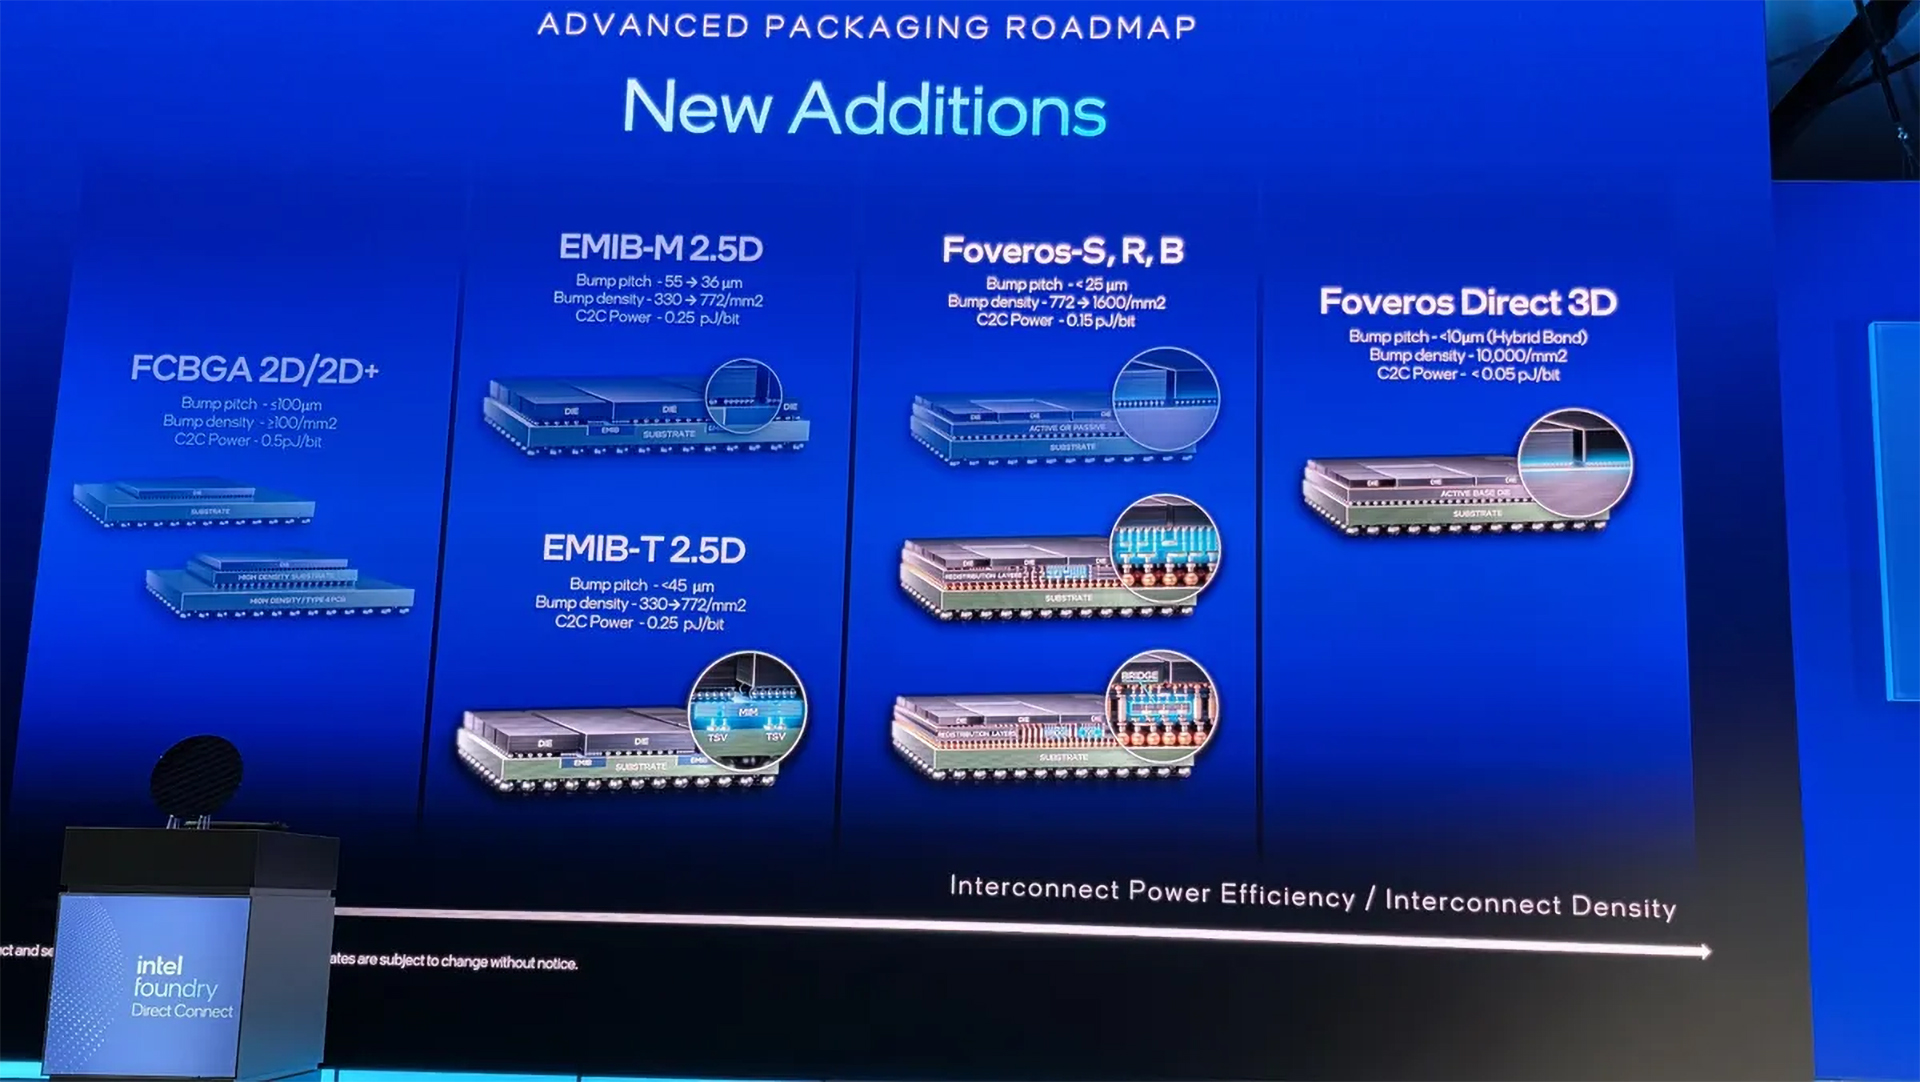
初代 Foveros 技术采用基于 22FFL 的主动硅基底片(interposer),配备硅通孔(TSV)并通过面对面键合技术连接主动芯片。Intel 的 Lakefield 和 Ponte Vecchio 采用主动基底片和 36 µm 微凸块间距,而 Meteor Lake、Arrow Lake 和 Panther Lake 的实现则使用被动基底片,间距同样为 36 µm。自 2019 年至 2023 年引入具备主动和被动基底片的 Foveros 以来,Intel 也多样化发展 Foveros,以应对不同的成本和集成需求。2025 年中发布的最新 Foveros 2.5D 路线图——其中提及具有相似特性的 -S、-R 和 -B 变体——将 Foveros 的能力大幅推向了其原始设计之外的领域:其目标为 25 µm 以下的间距、凸块密度从每平方毫米 772 个增加到 1,600 个,以及 0.15 pJ/bit 的芯片间互连功耗。
Swipe to scroll horizontally| 第 0 行 - 单元格 0 | Foveros-S |
Foveros-R |
Foveros-B |
凸块间距 |
36µm => 25µm => <25µm |
36µm => 25µm => <25µm |
36µm => 25µm => <25µm |
混合键合 |
- |
- |
- |
局部桥接 |
- |
- |
是 |
凸块密度 |
772-> 1600/mm^2 |
772-> 1600/mm^2 |
772-> 1600/mm^2 |
芯片间功耗 |
0.15 pJ/bit |
0.15 pJ/bit |
0.15 pJ/bit |
TSV |
- |
- |
? |
芯片复杂度 |
4 倍光罩 |
RDL 限制 |
桥接限制 |
HBM 堆栈 |
8(?) |
取决于中介层尺寸 |
取决于中介层尺寸 |
电容 |
- |
Row 9 - Cell 2 | ? |
基板 |
有机基板 |
有机基板 |
有机基板 |
封装尺寸(mm) |
? |
? |
? |
年份 |
2019 |
2027 |
? |
目前,最先进且已实现量产验证的 Foveros 2.5D 技术是 Foveros-S。该封装技术将多个 chiplet 置于硅中介层上,当前支持最大四个 reticle 尺寸的封装,略低于 TSMC CoWoS-S 提供的规格(最大可达 5.5 倍 reticle 尺寸)。由于 Foveros-S 本质上是 2019 年初代 Foveros 的演进版本,Intel 称其自 2019 年起已进入量产是合理的。未来,Foveros-S 将在多个方向继续演进,包括封装尺寸扩大、互连密度提升以及互连能效优化。
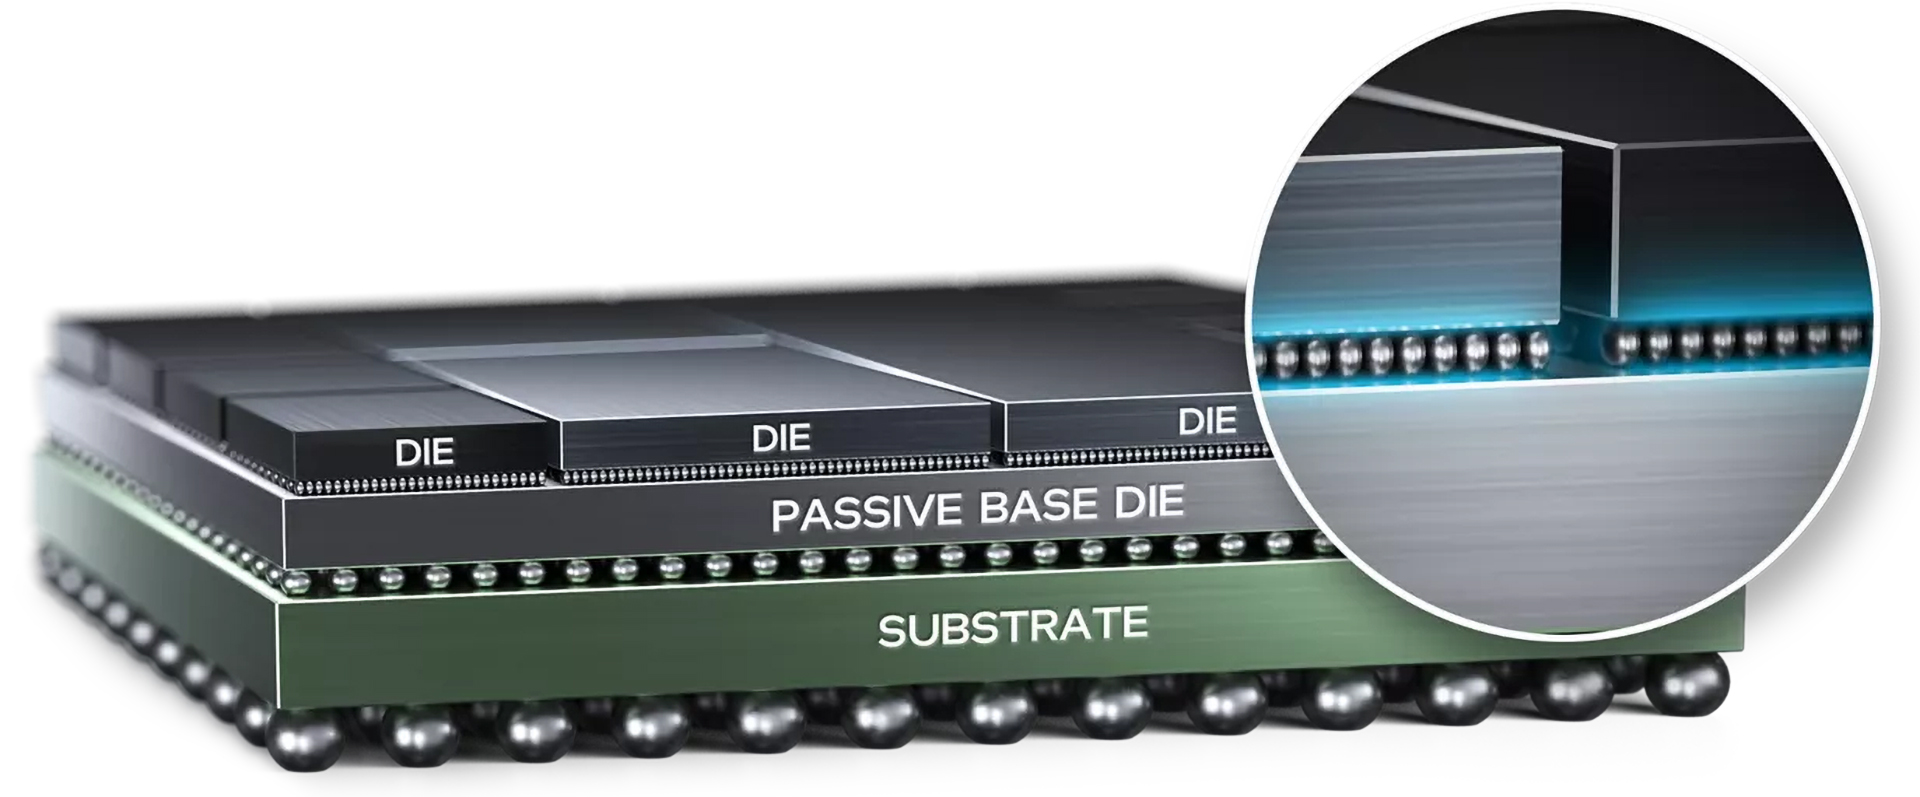
Foveros-R 彻底去除了硅中介层,采用扇出 RDL 技术以优化成本与互连密度。Intel 表示,该方案最多可集成三层 RDL。其设计旨在平衡成本与互连密度,并通过 UCIe 实现来自不同供应商的 chiplet 异质集成。与 Intel 当前 Foveros 2.5D 家族中的其他技术类似,Foveros-R 采用 36 µm 微凸块间距,同时支持 25 µm 以下间距,凸块密度可从 772/mm² 扩展至 1,600/mm²,芯片间互连功耗降至 0.15 pJ/bit。Intel 预计 Foveros-R 将于 2027 年具备量产条件。
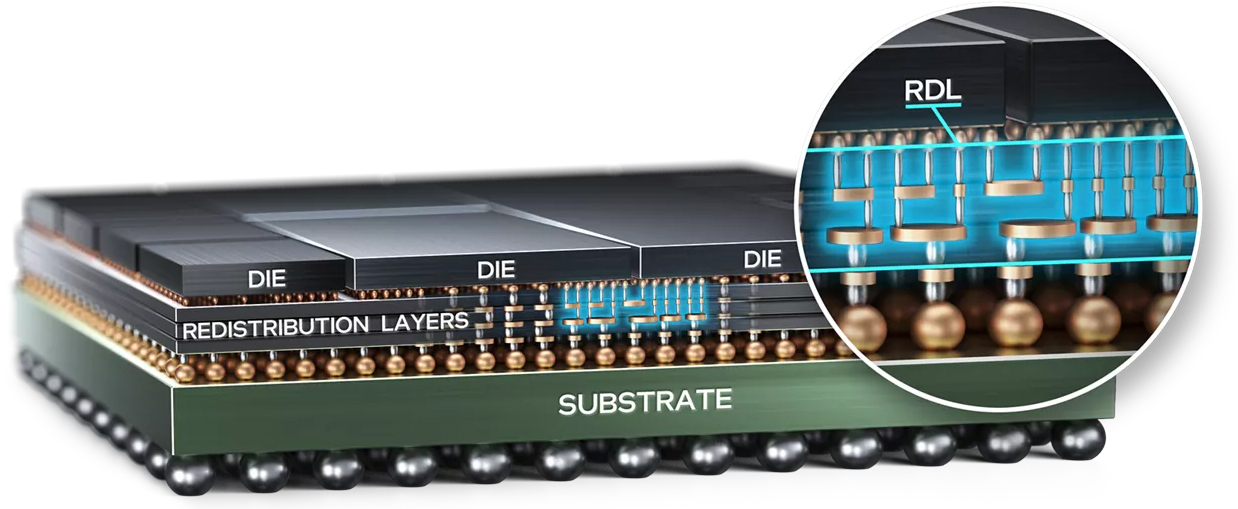
Foveros-B 则将这一概念进一步扩展到规模更大、更复杂的 AI/HPC 设计上。该技术不再依赖完整硅中介层,而是将 RDL 与局部有源或无源硅桥相结合,只在需要的地方提供高密度连接。这让 Intel 在纯 RDL 方案与大型硅中介层之间多了一个中间选项,同时也直接对标台积电的 CoWoS-R。
需要指出的是,Intel 并没有明确说明 Foveros-B 使用的是 EMIB 桥,但考虑到两者微凸点间距相近,加上未来计划采用有源局部硅桥,Foveros-B 的硅桥很可能与 EMIB-M 和 EMIB-T 十分接近。如果 Foveros-B 确实能用上 EMIB 桥,未来的 Foveros-B 设计还可以集成缓存拆分、集成稳压器(IVR)或 MIM 电容。
在互连密度和功耗方面,Foveros-B 官方标称支持 25 µm 以下的凸点间距,凸点密度最高可达 1,600/mm²,芯片间互连功耗为 0.15 pJ/bit。不过,Intel 尚未公布 Foveros-B 的量产时间,具体规格仍需拭目以待。
有了 EMIB 和 Foveros 2.5D 产品线,Intel 已经能够覆盖相当广泛的应用场景,但其封装扩展的脚步并未停下。除了 EMIB 和 Foveros 2.5D 带来的 2.5D 横向扩展之外,Intel 还可以借助 Foveros 3D 和 EMIB 3.5D 封装技术将 chiplet 垂直堆叠起来。
Foveros Direct 3D:铜互连,无需凸点
与存在了几十年的简单封装堆叠不同,高密度互连的 3D 堆叠本质上是把多个独立 die 融合成同一颗紧耦合芯片的组成部分,从而提升带宽、降低延迟、减少互连功耗并缩小封装面积。其难点在于:要在 die 之间制造成千上万条极其精细的连接,同时保证良率、供电、信号完整性,以及——或许最关键的——把热量从埋在堆叠内部的芯片中散出去。
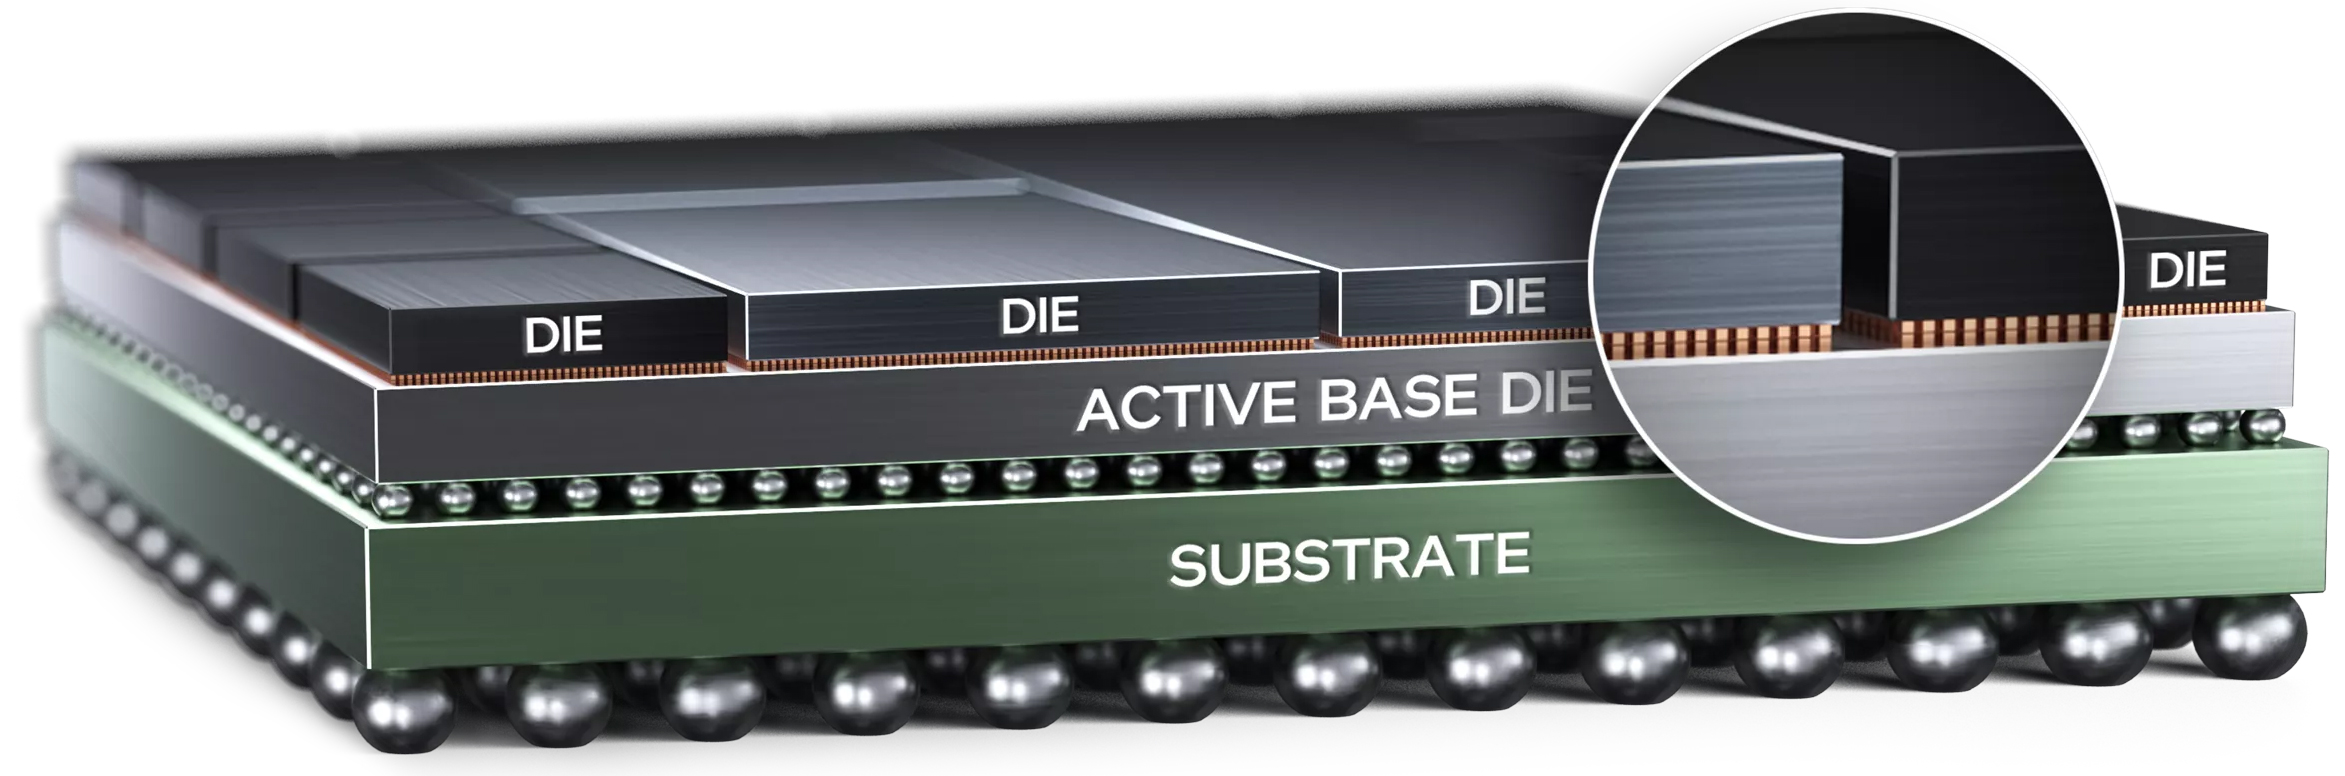
Foveros 路线图在架构上最跨跃的一步是 Foveros Direct 3D,它将互连方式从传统的微凸块(microbump)升级为铜对铜直接混合键合。微凸块无法无限缩小,因为焊料凸块需要维持足够的尺寸才能保证良率和可靠性,而且焊料本身还会引入额外的电阻和寄生效应。Foveros Direct 3D 彻底去掉了焊料,直接将一个 die 上的铜焊盘与另一个 die 上的铜焊盘进行键合,这使得互连间距可以低于 10 µm,比传统微凸块技术细至 10 倍。
Swipe to scroll horizontally| Row 0 - Cell 0 | Foveros Direct 3D 第一代 |
Foveros Direct 3D 第二代 |
键合方式 |
铜-铜混合键合(无焊料) |
铜-铜混合键合(无焊料) |
间距 |
9 µm(公开宣称“亚 10 µm”) |
3 µm |
焊盘密度 |
约 12,300/mm²(Intel 称 >10,000) |
超过 100,000/mm² |
片间功耗(C2C) |
<0.05 pJ/bit |
未公开(预计同级或更低) |
基座 Die |
有源 |
有源 |
TSV |
支持(位于基座;18A-PT 增加穿透 TSV) |
支持 |
基座电容/附加组件 |
MIM 电容;Clearwater Fores 增加 LLC + IVR |
MIM 电容;Clearwater Fores 增加 LLC + IVR |
HBM 堆叠 |
无直接限制——通过 EMIB 3.5D 连接 |
无直接限制——通过 EMIB 3.5D 连接 |
Die 组合 |
若与 EMIB 3.5D 混用,组合由后者决定 |
若与 EMIB 3.5D 混用,组合由后者决定 |
基板 |
有机基板(若采用 EMIB-T 玻璃工艺则后续转用玻璃) |
有机基板(若采用 EMIB-T 玻璃工艺则后续转用玻璃) |
封装尺寸 |
跟随 EMIB 3.5D(约 80×80 mm → 120×180 mm) |
跟随 EMIB 3.5D(约 80×80 mm → 120×180 mm) |
年份 |
2026 |
更晚 |
Intel 声称 Foveros Direct 3D 可提供小于 10 µm 的键合节距、高达 10,000 个/mm² 的互连密度,以及低于 0.05 pJ/bit 的芯片间互连功耗。这种高密度连接缩短了堆叠芯片间的信号路径,提升了带宽,降低了延迟,并减少了数据传输所需的能耗。除了电气性能优势外,直接键合还在芯片间形成了更连续的热路径,Intel 表示这比传统封装散热效果更好。随着垂直堆叠逻辑芯片使功率密度大幅飙升,这一特性至关重要。
Intel 的 Foveros Direct 3D 键合接口支持面对背(face-to-back)和面对面(face-to-face)堆叠方式。此外,Intel 还介绍了芯片对晶圆(chip-to-wafer)以及晶圆对晶圆(wafer-to-wafer)的键合方案。
如 Intel 展示的基于 Foveros Direct 3D 的系统级封装(SiP)原理图所示(Intel 已确认),该技术比单纯将一个逻辑芯片堆叠在另一个之上要灵活得多。该方法支持不同尺寸的芯片、多层堆叠,并可在单个 SiP 中集成采用不同制程工艺制造的芯片。
Intel 的 Xeon 6+ 'Clearwater Forest' 处理器是首款量产使用 Foveros Direct 3D 铜键合将 Intel 18A 计算小芯片挂载到有源基板上产品。该 CPU 采用第一代 Foveros Direct 3D,铜键合节距为 9 µm。与此同时,Intel 计划将其第二代 Foveros Direct 3D 的键合节距缩小至 3 µm。作为对比,TSMC 2023 年的第一代 SoIC 支持 9 µm 节距(AMD 的第二代 3D V-Cache 即采用此版本),而进入量产的最新一代产品键合节距为 6 µm。TSMC 预计 到 2029 年将 SoIC 互连节距缩小至 4.5 µm。
EMIB 3.5D:全方位一体化
最后,Foveros 和 EMIB 并非只能各自独立使用。Intel 可以将 Foveros 2.5D 或 Foveros Direct 3D 与基板内嵌的 EMIB 桥接结合,组成所谓的 EMIB 3.5D,用来打造它的终极产品。在这种架构中,Foveros 在单个 chiplet 组件内部提供高密度的局部 2.5D 或 3D 互连,而 EMIB 则在这些模块之间提供高带宽的水平连接,本质上是用更小的 SiP 搭建出一个庞大的系统级封装。Intel 表示,这些 SiP 既可以完全相同以便扩展性能,也可以各不相同以实现不同功能。
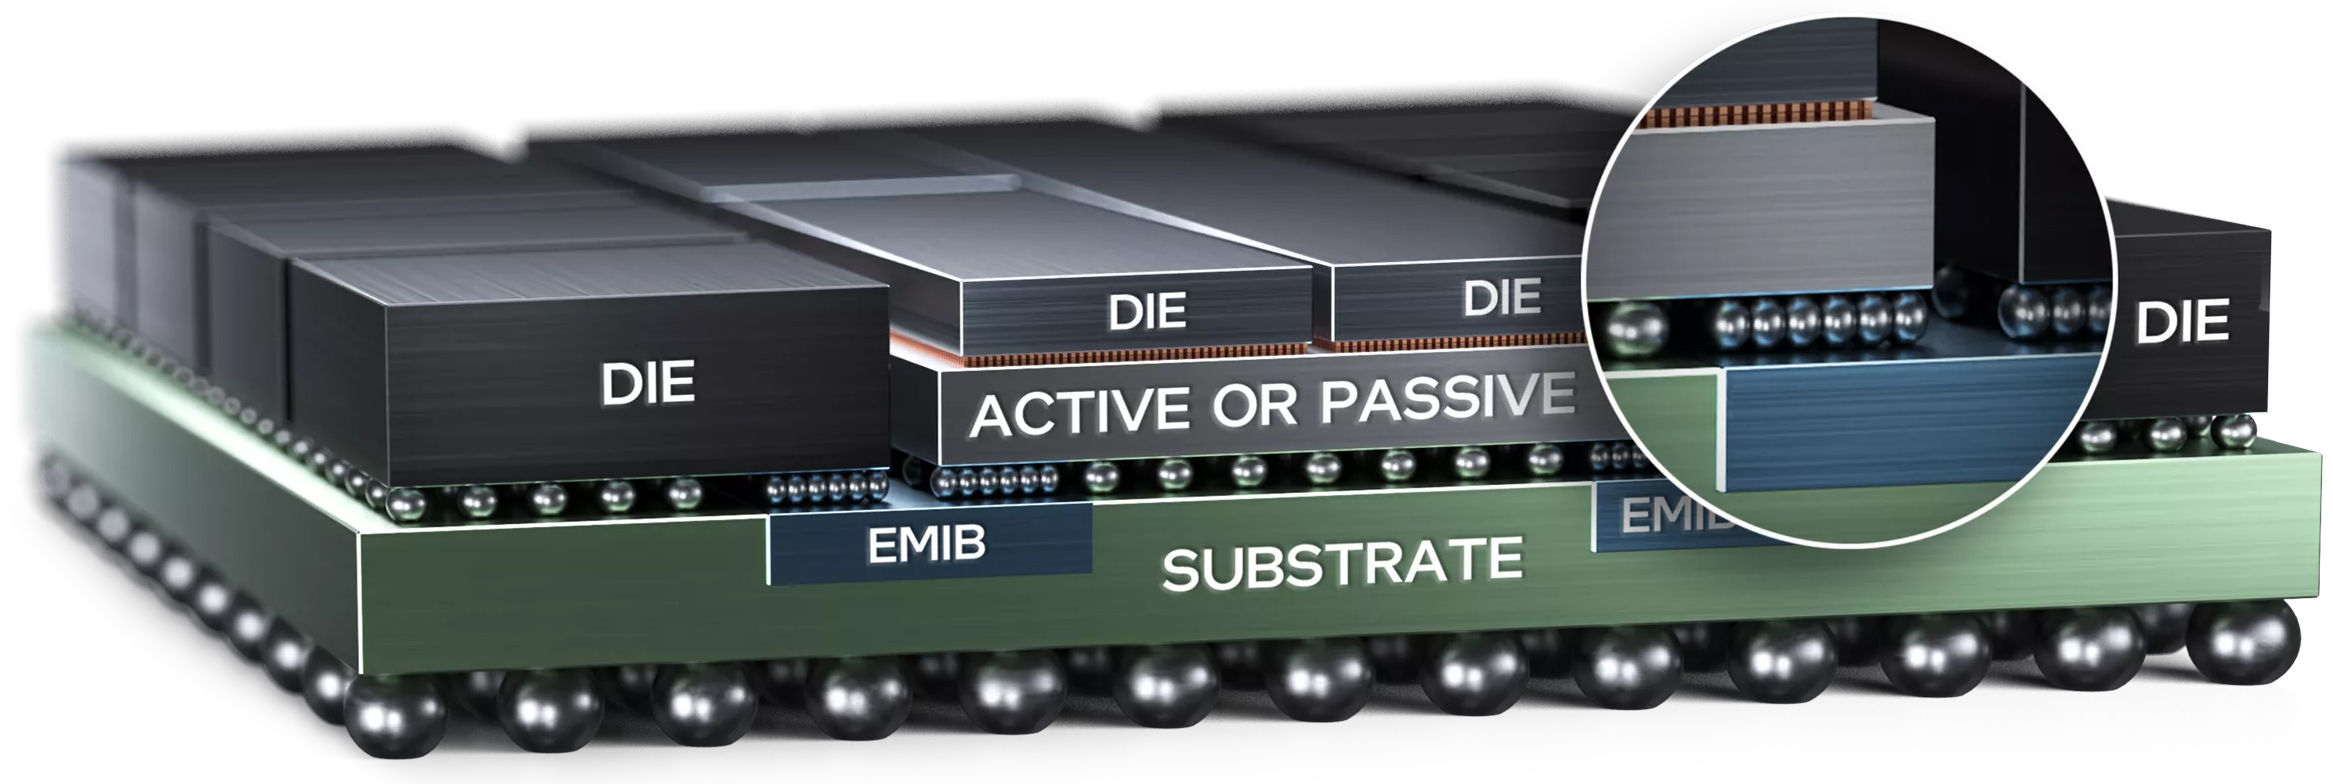
EMIB 与 Foveros 的结合尤其有价值,因为它让 Intel 无需把整个系统放在一块巨大的硅中介层上,就能同时实现横向和纵向的扩展。Intel 称,EMIB 3.5D 能达到的总硅片面积远超现有基于硅中介层技术的承载能力。Intel 首次使用 EMIB 3.5D 打造了 Ponte Vecchio 计算 GPU,集成了 47 个采用五种制程工艺制造的 active tile,晶体管数量超过 1000 亿。虽然 Intel 的 Data Center GPU Max 算不上大获成功,但它确实展示了 Intel 先进封装技术的实力。
左右滑动查看表格| Row 0 - Cell 0 | EMIB 3.5D(Foveros) |
EMIB 3.5D(Direct 第一代) |
EMIB 3.5D(Direct 第二代 + EMIB-T) |
垂直互连方式 |
焊料微凸点 |
Cu–Cu 混合键合 |
Cu–Cu 混合键合 |
垂直互连间距 |
36 µm |
9 µm |
3 µm |
垂直互连密度 |
828 /mm²(Intel) |
>10,000 /mm²(Intel) |
未公布 |
能耗 |
~0.15 pJ/bit |
<0.05 pJ/bit |
未公布 |
水平互连方式 |
EMIB 第一代 |
EMIB 第二代 |
EMIB-T |
横向间距 |
55 µm |
45 µm |
45 → 36 → 25 µm |
横向能耗 |
~0.5 pJ/bit |
0.25 pJ/bit |
0.25 pJ/bit |
基底裸片 |
有源 |
有源 |
有源 |
TSV |
Foveros 基底 |
Foveros 基底 |
基底 + EMIB-T |
HBM |
经 EMIB 连接(PVC: 8) |
可选(CWF: DDR) |
经 EMIB-T 连接(12 → >24) |
桥接器(示例) |
11(PVC) |
12(CWF) |
>20 → >38 |
封装 |
~80 × 80 mm |
Xeon 模块 |
120 × 120 → 120 × 180 mm |
产品 |
Ponte Vecchio |
Clearwater Forest |
待定 |
年份 |
2022 |
2026 |
后续 |
展望未来,EMIB 3.5D 架构若能与 Foveros Direct 3D 结合,潜力将更加显著。通过同时采用这两项技术,Intel 能够利用极高密度的垂直铜对铜连接构建紧密耦合的计算模块,并通过 EMIB 在横向上将多个模块互连,从而在垂直和水平两个维度上扩展复杂处理器。然而,出人意料的是,Intel 决定不在下一代 Xeon "Diamond Rapids" 处理器中采用 EMIB 3.5D:该 CPU 使用 Foveros Direct 3D 实现垂直集成,而横向互连则采用 UCIe-S 连接。
多裸片方案暂搁置
虽然 Intel 的 EMIB 和 Foveros 技术最初分别旨在服务不同类型的扩展,但该公司正将其演变为互补平台,以支持复杂处理器的水平和垂直扩展。
EMIB 正迈向更细的互连间距、垂直供电、玻璃基板,以及超过 12 个光罩尺寸且搭载 24 个以上 HBM 堆栈的封装。与此同时,不断扩展的 Foveros 家族覆盖了从 2.5D 集成到超密集 Foveros Direct 3D 混合键合的全链条。事实上,Foveros Direct 3D 已能实现小于 10 µm 的铜对铜连接,并正朝着更精细的间距发展。
另一方面,EMIB 3.5D 将垂直堆叠的模块与横向 EMIB 互连相结合,从而构建出适用于终极 AI 和 HPC 场景的大规模异构系统级封装,而无需使用巨大的硅中介层。
值得注意的是,目前英特尔缺乏晶圆级系统(system-on-wafer)平台,无法支持类似 Cerebras WSE 或 Tesla Dojo 的晶圆级处理器。不过,这一现象可以理解:当前此类技术的需求过于有限,且未来未必会有显著增长。