
Meta生成式广告模型GEM:扩展中心模型与计算引擎以构建前沿广告AI
去年,我们发布了 GEM——业界规模最大的推荐系统(RecSys)基础模型。GEM 确立了 Meta 首个受 LLM 启发的广告推荐范式,带来了显著的性能提升。在此基础上,我们的下一步目标是利用下一代硬件,进一步扩展计算能力与智能迁移,并将该能力拓展至 Meta 整个广告生态。这涵盖数十个界面与目标,实现从认知、考虑到转化的全流程无缝优化。
2026 代 GEM 正从 Facebook、Instagram、Reels 等各领域的独立优化,转向单一的中心基础模型。它学习来自 Meta 所有广告平台的数据与信号,在 LLM 级计算下弯曲了扩展曲线,并通过后训练技术(允许更大的延迟预算,无需实时评估所有广告候选项)实现更强的广告主效果——所有这些都在一个效率显著提升的训练栈上完成。结果是:在所有界面和漏斗阶段同步提升广告表现,并更深入地理解用户需求,从而更精准地匹配广告。
GEM 在 Meta 各广告界面和目标上实现了 18.9% 的转化率提升和 12% 的广告点击率(CTR)提升,并在过去一年中,为 Facebook、Instagram 及站外转化中的定向用户分别带来 5.8%、4.1% 和 1.6% 的转化提升。这些增益覆盖了漏斗上层的界面和漏斗深层的优化目标,为广告主带来更强的回报。

GEM 在以下四个领域推进推荐系统的前沿:
1. 弯曲扩展曲线,支持 2.5 倍模型复杂度
挑战:实证扩展定律表明,在使用 Transformer 模型架构时,模型性能可随计算、参数和数据规模的增加而可预测地提升。然而,由于推荐系统面临海量异构特征和分布漂移,其模型并未在 Transformer 架构下展现出类似的扩展特性。
解决方案:我们构建了一套类 LLM 架构的模型 Kunlun,并与最新一代 GPU 硬件协同设计,让更大、更深的模型在成本上大幅优化,同时支持基于用户互动历史的长上下文学习。在我们目前最大规模的预训练中,模型复杂度较早期版本的 GEM 增长了 2.5 倍,并呈现出类似 LLM 的 scaling law。这一规律与前沿 LLM 一致:更大的容量和更长的上下文会在排序质量上带来涌现式提升,并直接转化为业务成果。
2. 从 GEM 到用户侧模型的高效智能传递
挑战:以这个规模实时提供模型服务成本极高,还会推高延迟,损害用户体验和广告主 ROI。
解决方案:通过结构化表征和最先进的后训练技术 LoopFM,我们把 GEM 的内部表征和序列历史记忆传递给下游模型。借助计算共享,加上上一版本部署的知识蒸馏,智能传递效率翻倍,却不增加任何计算成本或延迟。我们还引入了弹性预计算技术(Solaris),进一步收割上游模型带来的收益。
3. 以 Meta 广告规模驱动大规模跨场景、跨领域学习,加速中央计算引擎
挑战:Meta 的应用覆盖数十个场景——Facebook、Instagram、Reels、Stories 等,每天有 36 亿人至少使用其中一款应用。过去,每个场景和优化目标都有各自独立的预测系统。随着平台场景和目标不断增多,要同时提升所有广告效果也变得越来越难。
解决方案:GEM 通过中央基础模型加速单一统一的计算引擎,跨所有场景(包括 Facebook 和 Instagram)、跨所有关键广告主目标(从站外转化到移动应用安装)联合预测点击和转化。在数据充足的点击任务上学到的通用表征,可以迁移到数据稀少的转化任务上。配合零成本数据混合和领域专家框架的新训练方案,这种异构的大规模学习变得可行,规模可预期,可靠性也更高。
4. 总训练算力提升 4 倍,同时在数千张 GPU 上将端到端训练效率翻倍
挑战:在数千张 GPU 上训练大规模 RecSys 基础模型,需要对算力、并行策略、通信和内存进行精细编排。目前数据中心 GPU 及其软件栈主要针对 LLM 负载进行了优化,而推荐系统负载的数据特性截然不同,使得在规模扩大时保持高 GPU 计算利用率极其困难。
解决方案:我们与最新的 GPU 硬件及 Meta 的训练集群协同设计,开发了低精度的自定义内核和全新的 5D 并行策略,并结合基础设施优化了模型架构,使其能高效扩展至数千张 GPU。端到端训练效率提升至模型 FLOPS 利用率(MFU)的 20%-25%,总训练算力提升 4 倍,从而支持 GEM 在 Meta 内部以 LLM 级别进行训练(完整技术细节请参阅我们的配套博客 Training GEM at LLM Scale)。
规模法则:借助 Kunlun 在前沿规模下弯曲扩展曲线
GEM 引入了一种新的类 LLM 模型架构——Kunlun。与上一代版本(Interformer)相比,Kunlun 在同等计算扩展下实现了 2 倍的性能提升。Kunlun 围绕以下创新设计:
- 通过无缝交织终身序列建模与可扩展的推荐专用交叉交互,标准化并统一了架构框架。
- 通过与最新一代硬件的深度协同设计引入可扩展架构,在几乎不降低模型质量的情况下减少了计算量。
- 创新了高效的序列扩展机制,结合离线序列基础设施处理更长的用户交互上下文。

用于推荐系统扩展的高效架构
GEM 的 Kunlun 架构通过支持超长的用户序列和大规模的用户-物品交互特征,有效突破了前沿训练规模下推荐系统的扩展瓶颈。在以下技术讨论中,我们将特征分为两类:非序列特征(如用户人口统计信息、广告内容表征)和序列特征(由事件序列组成,每个事件包含一组特征)。
该架构带来三项基础创新:
1. 标准化与统一的架构框架
我们在 LLM 风格架构的基础上进行改进,以更精准地捕捉推荐系统模型的独特特性,具体包括异构特征和数据动态。
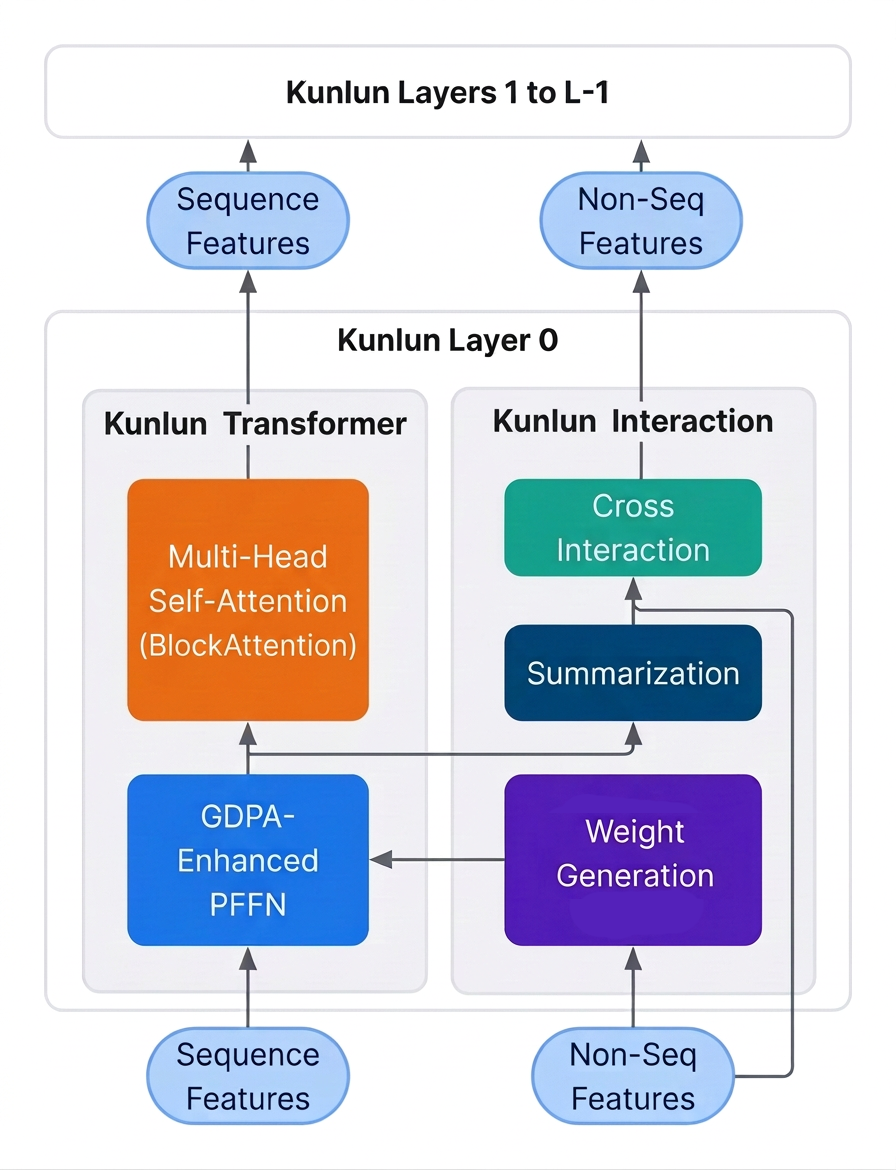
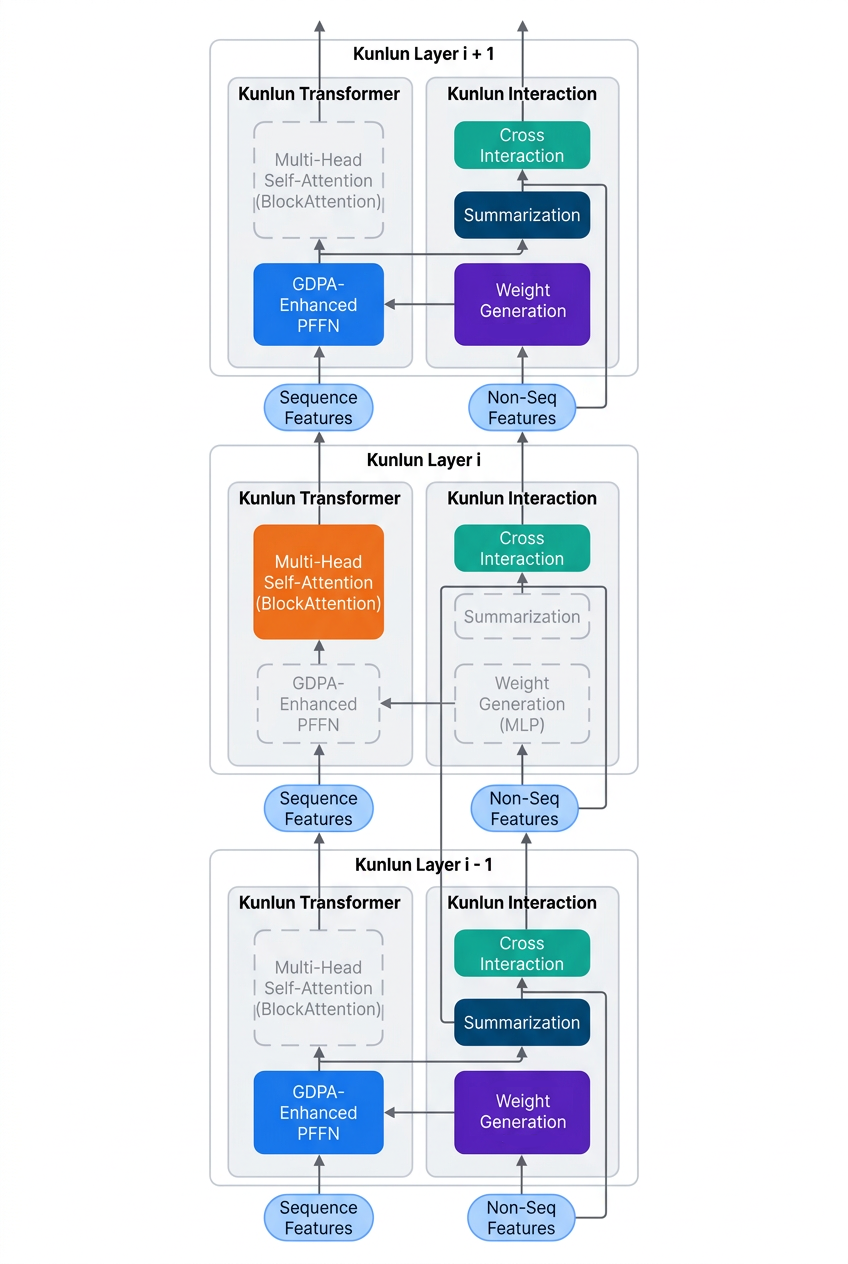
每一层包含:
- 注意力机制:定制化注意力和前馈网络,以适应数据动态,捕捉用户行为中的长程依赖模式。
- 摘要组件:简化并增强摘要架构,从序列中提取关键用户洞察,有效连接序列与非序列结构。
- 交叉交互:扩展至混合专家(Mixture-of-Experts, MoE)式设计,实现对序列特征与非序列特征之间复杂交互的大规模建模。
2. 通过深度协同设计实现可扩展架构
我们与最新一代硬件进行架构协同设计,使其能够高效地扩展深度和宽度:
- 通过块注意力降低计算复杂度:用块对齐的稀疏注意力替代全自注意力,将复杂度相对于窗口大小从二次方降至线性方,并仅使用窗口大小为块大小倍数,对内核更友好(无需处理非完整块)。
- 通过架构重构实现组件统一:引入逐样本前馈网络(pFFN)以适应传统的逐样本分布 FFN。我们通过 广义点积注意力(Generalized Dot-Product Attention, GDPA) 将 pFFN 组件重构为注意力操作,将模型中大量的类注意力操作统一为单个 GPU 内核,从而加速训练,前向传播速度最多提升 2 倍。
- 通过 Expert Parallelism 实现可扩展的交叉交互:我们的交叉交互组件采用类 MoE 的可扩展框架,使用模型-专家并行,让每张 GPU 并行处理一部分专家子网络。
3. 高效序列扩展的创新设计
我们引入了专门的组件设计,让超长序列在计算上变得可行:
组件跳跃连接(CompSkip):这一计算跳跃机制选择性地激活各层中的序列模块,输出仅通过残差连接传递。基于“网络在重新激活后能快速恢复”这一假设,通过有选择地停用特定组件,我们在质量几乎无损的情况下将 FLOPS 降低了 43%。
序列统一(OneSeq):我们在事件特征聚合之后,按时间顺序选择性地统一用户序列。这样即使各个事件具有异构的结构和特征,也能由单一的统一序列层来处理长序列。系统中存在多个用户序列来源,各自的事件特征不同。例如,购买序列中的事件用广告 ID 和账号 ID 描述,而帖子序列中的事件用作者和对象 ID 描述。由于事件特征集合不同,无法在数据源层面直接统一,因此需要灵活的序列统一方案,在利用大尺寸张量运算最大化 GPU 效率的同时,尽量减少算子碎片化。
 |
 |
超长序列为何重要
新架构让超长序列成为可能。GEM 在生产环境中将长互动上下文长度扩展了 2 倍,并进一步具备扩展至 25 倍的能力,展现了前沿规模下的基础设施实力。在此过程中,我们发现:
- 预测质量随序列长度呈幂律关系。这种关系可预测,且在不同序列长度下保持一致。
- 更大规模的模型从更长序列中获益不成比例,形成正向循环:扩大算力使模型更大,从而使更长序列更有价值;扩展序列长度提升模型精度,又为投入更多算力提供依据。
- 两种扩展规律相互强化,为突破单纯增加算力的瓶颈提供了投资方向,可进一步优化整体扩展曲线。
后训练:规模化知识迁移
基座模型的价值取决于其智能向数百个垂直模型迁移的效率,这些垂直模型负责实时广告投放。GEM 通过中心大脑带来的深层历史记忆,以结构化表征革新推荐系统的后训练,在知识蒸馏之外实现了 2 倍的迁移效率提升。此外,部分领域专用的基座模型引入了异步计算,以将知识迁移至垂直模型。
规模化结构表征
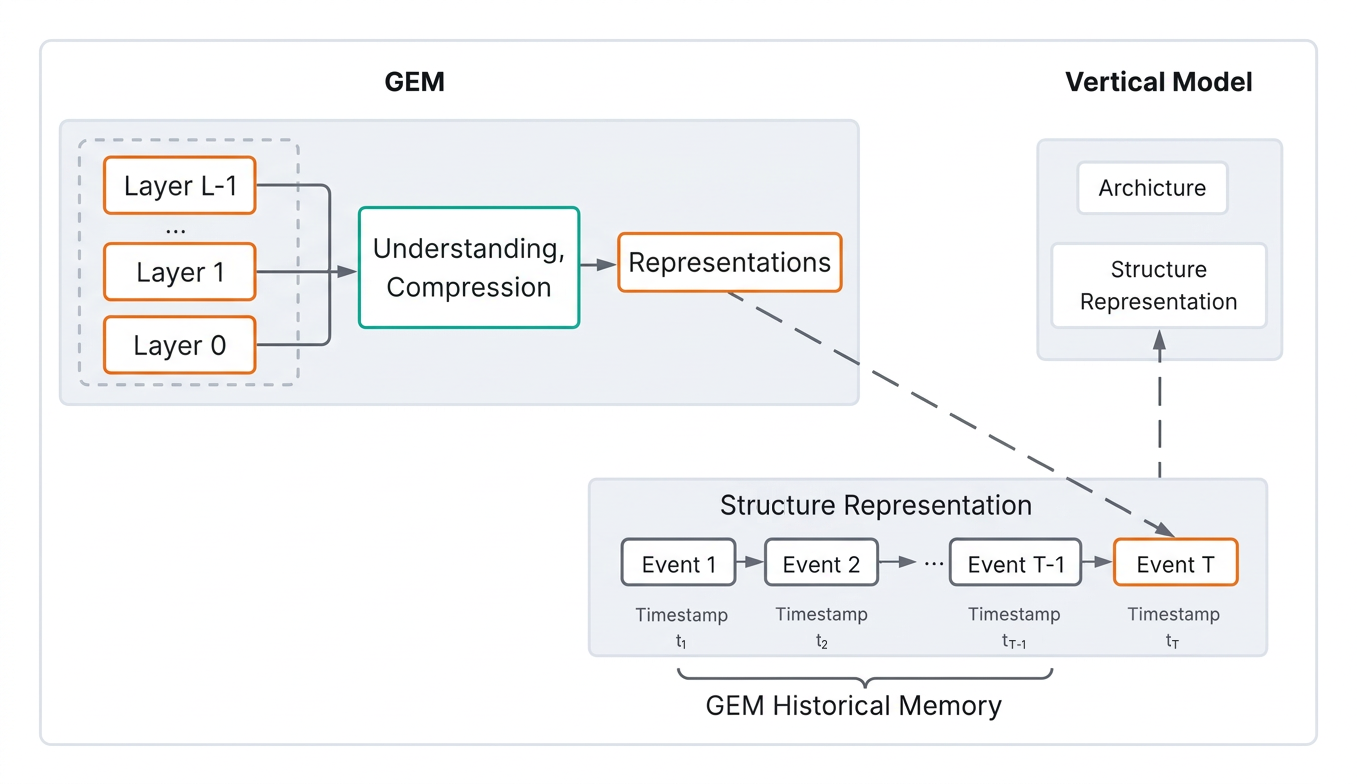
知识蒸馏虽有效但带宽有限:下游模型在每个训练过程中仅能获取 GEM 智能的压缩视图。为克服这一局限,我们引入预计算的结构化表征(如 LoopFM),用于理解和压缩基座模型中中心大脑的信息,将其转化为紧凑表征,并借助深层历史记忆进行结构化组织。这使得下游模型能够学习来自中心大脑的长上下文。系统主要包含以下组件:
- 理解并压缩智能:将 GEM 的智能压缩为紧凑表征,这些表征源自关键层,用于全面描述基座模型处理的事件(或数据)。
- 深层历史记忆结构化:将该用户的紧凑表征与基座模型此前为同一用户生成的表征结合,构成顺序上下文窗口,通过 GEM 的记忆捕捉用户在各端面和流量中的意图动态。
- 长上下文智能学习:下游模型在推理和训练期间,通过专用架构学习带有长历史上下文的结构化表征。
表征生成过程是预先计算好的,并与生成软标签的计算共享,用于知识蒸馏。这种方式无需额外消耗基础模型的成本。
面向新鲜预测的投机式预计算
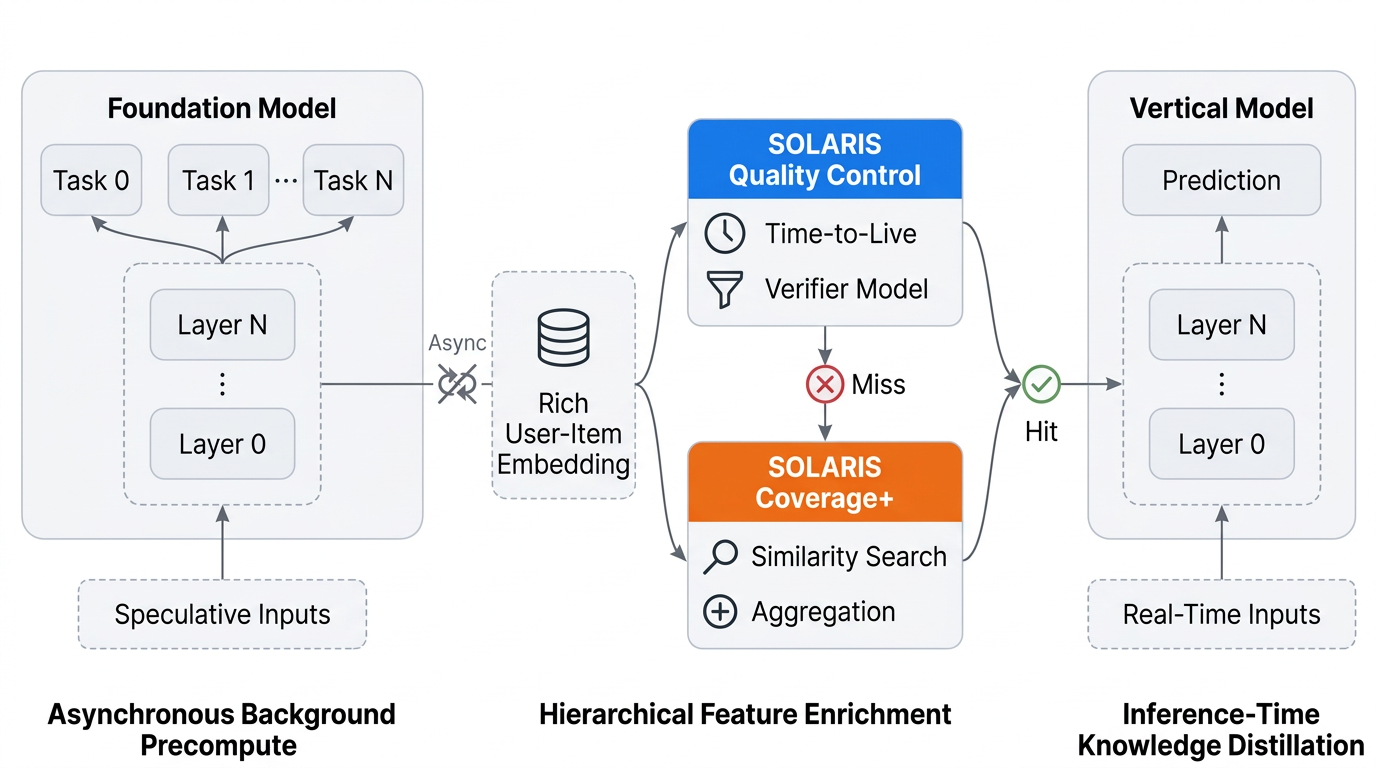
Solaris 通过预计算让知识传输保持更新状态:它在垂直模型推理需要用户-广告表征的前一刻,就从 GEM 获取该表征。由于在实时广告请求中评估大规模模型成本过高,Solaris 选择提前行动:它投机性地预计算未来请求大概率会用到的用户-广告对的基础模型嵌入,并在服务热路径上按时送达。下游模型因此能获取准实时的基础模型智能,而不受延迟限制。借鉴 LLM 服务中的投机解码思路,Solaris 通过系统中以下几个主要组件协同工作:
- 交付新鲜运行时知识:直接生成用户-广告嵌入,让垂直模型获得准实时、点对点的知识,了解特定用户针对确切广告候选的可能行为。
- 在请求前进行投机式预测:当多级排序将实时请求筛选至头部广告候选时,Solaris 通过异步后台任务,用基础模型评估这些用户-广告对。计算过程没有延迟预算限制,具备弹性算力,且能捕捉丰富知识。
- 分层扩展覆盖率:当无法获取精确的用户-广告嵌入时,系统不会直接丢弃,而是进行降级处理。它会使用同一广告组内该用户近期嵌入的聚合值,或借用行为相似用户的嵌入。
大规模跨域优化:优化跨触点与漏斗
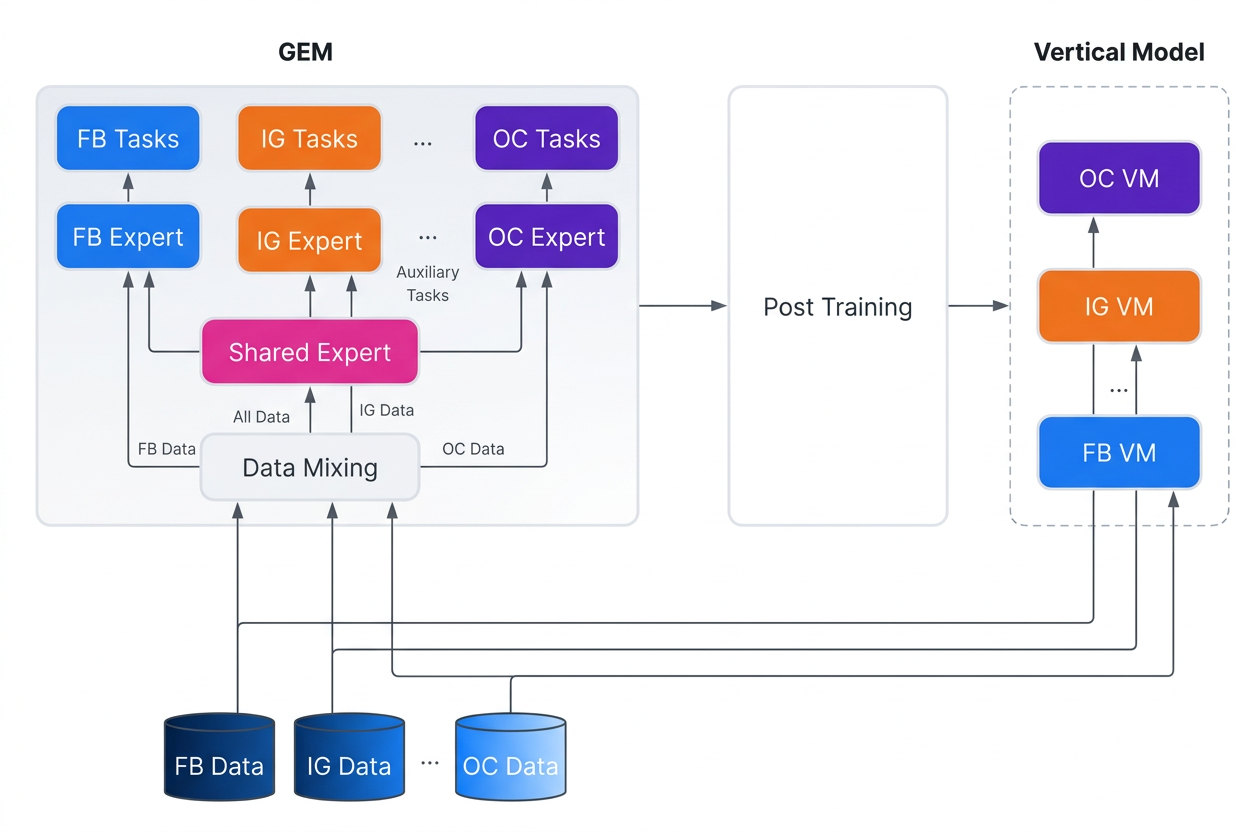
我们进一步用 Meta 海量规模的广告数据训练了 GEM,涵盖全部展示场景(如 Facebook 和 Instagram 的 Feed、Reels/视频)以及深漏斗优化目标(如站外转化、移动应用安装)。GEM 驱动了首个同时预测所有场景 CTR 和主要优化目标转化率(CVR)的联合优化模型。在此之前的系统里,每个场景、每个预测目标都是各自独立的。这意味着跨平台的互动模式可以直接用于理解各广告场景下的转化行为(如购买)。GEM 由此成为 Meta 各广告场景推荐的核心模型和计算引擎。
与使用静态数据的 LLM 不同,推荐系统模型需要应对数据的动态性和新鲜度,以及不同场景和流量之间的分布差异。为克服这些挑战,GEM 率先构建了一套大规模跨场景、跨领域统一的训练方案:
零成本数据混合策略:引入虚拟数据加载机制,从不同数据管道组合中加载数据,无需真正合并数据,也不会产生额外的存储开销。它能灵活适应当前广告生态——下游模型仍在基于特定场景或流量数据训练。我们还设计了数据配比机制,在离线和在线训练中让混合比例贴近实时接收的真实数据流顺序,从而缓解领域切换带来的不稳定,以及对近期领域数据的过拟合。
领域专家框架:一个共享专家学习所有领域的统一表示,而各领域的专属专家捕捉场景特有的模式。每个领域专家既能利用跨领域共享知识,也能利用自身的专业知识。这些专家构建在 Kunlun 架构框架之上。
高效训练 LLM 规模的推荐系统模型
GEM 现已在数千块最新一代 GPU 上以 LLM 规模进行训练。目前的数据中心 GPU 及其软件栈主要针对 LLM 工作负载进行了优化,而推荐工作负载由于具有独特的数据特征以及丰富的用户与广告信号交互模式,其特性存在根本差异。这使得在训练 GEM 这一规模的底层推荐模型时,极难实现高 GPU 计算利用率。
我们通过端到端 MFU(E2E MFU)来衡量训练效率,该指标可分解为两个因子:E2E MFU = 本地 MFU(计算效率) × 扩展比率(扩展效率)。本地 MFU(计算效率)衡量单块 GPU 计算单元的利用率——即工作负载运行性能接近硬件理论上限(Roofline)的程度。扩展比率(扩展效率)衡量当任务分布在数千块 GPU 上时,单 GPU 性能保留的比例。这种分解至关重要,因为它允许我们将计算效率和扩展效率视为相关但独立的优化问题,并分别为其配备专门的优化技术。只有同时解决这两者,才能最大化端到端 MFU。
我们通过互补的计算效率与扩展效率创新克服了这些挑战:
- 计算效率:通过定制化的推荐内核库——如 Jagged Flash Attention (JFA)、GDPA、Block-Attention 等——以及针对推荐工作负载优化的混合超低精度训练(包括 MXFP8 Attention 和 MLP)实现。这些技术专为利用最新一代 GPU 架构而设计。
- 扩展效率:采用拓扑感知的 5D 并行策略与无流式多处理器(SM)密集型通信——针对稠密参数使用 2D FSDP 加专家并行,针对稀疏参数使用完全分片的 2D 模型并行——并与 Meta 的多层级网络架构协同设计,以降低通信开销。
最终成果:在过去 12 个月中,我们将 GEM 的端到端训练效率翻倍,MFU 提升至 20-25%,同时将总训练 FLOPs 扩展了 4 倍。在 LLM 与推荐系统交叉领域训练基础模型是一个协同设计问题,而非单纯的软件或硬件问题。这一 2 倍的效率提升源于对软件栈每一层优化措施的细致考量——内核、精度、并行度、网络及内存必须协同推进。
完整的技术细节,请参阅我们的配套博客文章:GEM 训练:高效训练 Meta 的 LLM 级广告推荐模型。
推荐系统基础模型的未来
展望未来,我们计划将 GEM 扩展到学习 Meta 全平台数据,从而捕捉文本、图片和视频领域内的有机互动与广告互动行为。我们正在向 LLM 级别的长上下文迈进,赋予模型对更长跨度互动背景进行推理的能力。这将显著提升广告相关性,帮助广告主更高效地触达精准受众。
我们将继续在更大规模的计算集群上扩展 GEM,开启新的规模化机遇。我们正在引入 AI 驱动的优化手段,如生态增强和架构协同设计,以加速后续演进。这些优化将随着硬件进步同步迭代模型架构,确保每一代新模型在同等计算成本下交付更高的智能。此外,我们将进化后训练范式,融入推理能力,以将更多智能转移给下游模型,进一步提升广告主表现和用户体验。
致谢
我们衷心感谢 Sandor Abad、Amit Anand Amlesahwaram、Carmen Au、Yasmine Badr、Balaji Balasubramanian、Habiya Beg、Ayush Bihani、John Bocharov、Raghav Boinepalli、Bopa Bovet、Mandeep Chadha、Shuo Chang、Dan Chanpuriya、Hansey Chen、Laming Chen、Ping Chen、Ruilin Chen、Wenlin Chen、Xian Chen、Jae-Woo Choi、Sagar Chordia、Cathy Cui、Yan Deng、Lisang Ding、Wentao Duan、Eric Falconer、Qi Fan、Xiaorui Gan、Nikhil Garg、Chenxiao Guan、Saket Gur、Brian Hansen、Rustam Hashimov、Bingjie He、Jack Hsueh、Yusuo Hu、Angie Huang、Qin Huang、Yuzhen Huang、Subodh Iyengar、Qinjin Jia、Shali Jiang、Qiang Jin、Pawel Kadluczka、Donghyun Kim、Santanu Kolay、Hairong Kuang、Peter Lamar、Seunghan Lee、Max Leung、Jazlyn Li、Mingda Li、Qianru Li、Chen Liang、Haowen Lin、Wei Ling、Boyang Liu、Rocky Liu、Serena Liu、Xi Liu、Xiaolong Liu、Xin Liu、Zikun Liu、Hank Lo、Kenny Lov、Anuj Madan、Shuby Mao、Paolo Massimi、Santosh Mohan、GP Musumeci、Jade Nie、Enes Palaz、Ke Pan、Sandeep Pandey、Jerry Peng、Tianshu Peng、Patrick Phelps、Oana Platon、Richard Qiu、Damian Reeves、Jason Rudy、Purbesh Sahoo、Ke Sang、Rikin Shah、Devashish Shankar、Jingyi Shen、Min Si、Vibha Sinha、Jake Siso、Matt Steiner、Bor-Yiing Su、Anamaya Sullerey、Musharaf Sultan、Chonglin Sun、Vivienne Sung、Qiuling Suo、Kevin Tang、Robert Tang、James Teng、Ritwik Tewari、Lei Tian、Sandeep Tiwari、Viral Vimawala、Ernest Wang、Kai Wang、May Wang、Zhaojin Wen、Rupert Wu、Xiaozhen Xia、Huaqing Xiong、Han Xu、Ivonne Xu、Jiayi Xu、Liangbei Xu、Hao Yan、Tak Yan、Angel Yang、Fan Yang、Jiyan Yang、Justin Yang、Wen-Chi Yang、Hongtao Yu、Li Yu、Zhichen Zeng、Hanbin Zhang、Jiasheng Zhang、Larry Zhang、Lei Zhang、Zhengyu Zhang、Feipeng Zhao、Qian Zhao、Hua Zheng、Jie Zheng、Peng Zhong、Jacky Zhou、Qinghai Zhou、Song Zhou、Zhehui Zhou、Rich Zhu、Wankun Zhu,以及参与 Meta 广告推荐系统中这个最大基础模型的开发与生产化落地的整个团队。